 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Always-On-Guidance vs. Situational Expertise: Ihre KI-Architektur neu strukturieren
Von Mirko Peters ·
Willkommen zurück beim Blog-Begleiter zu unserem Podcast. Im heutigen Beitrag tauchen wir tief in eine technische Hürde ein, auf die fast jedes Enterprise-Team nach dem Einsatz…
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
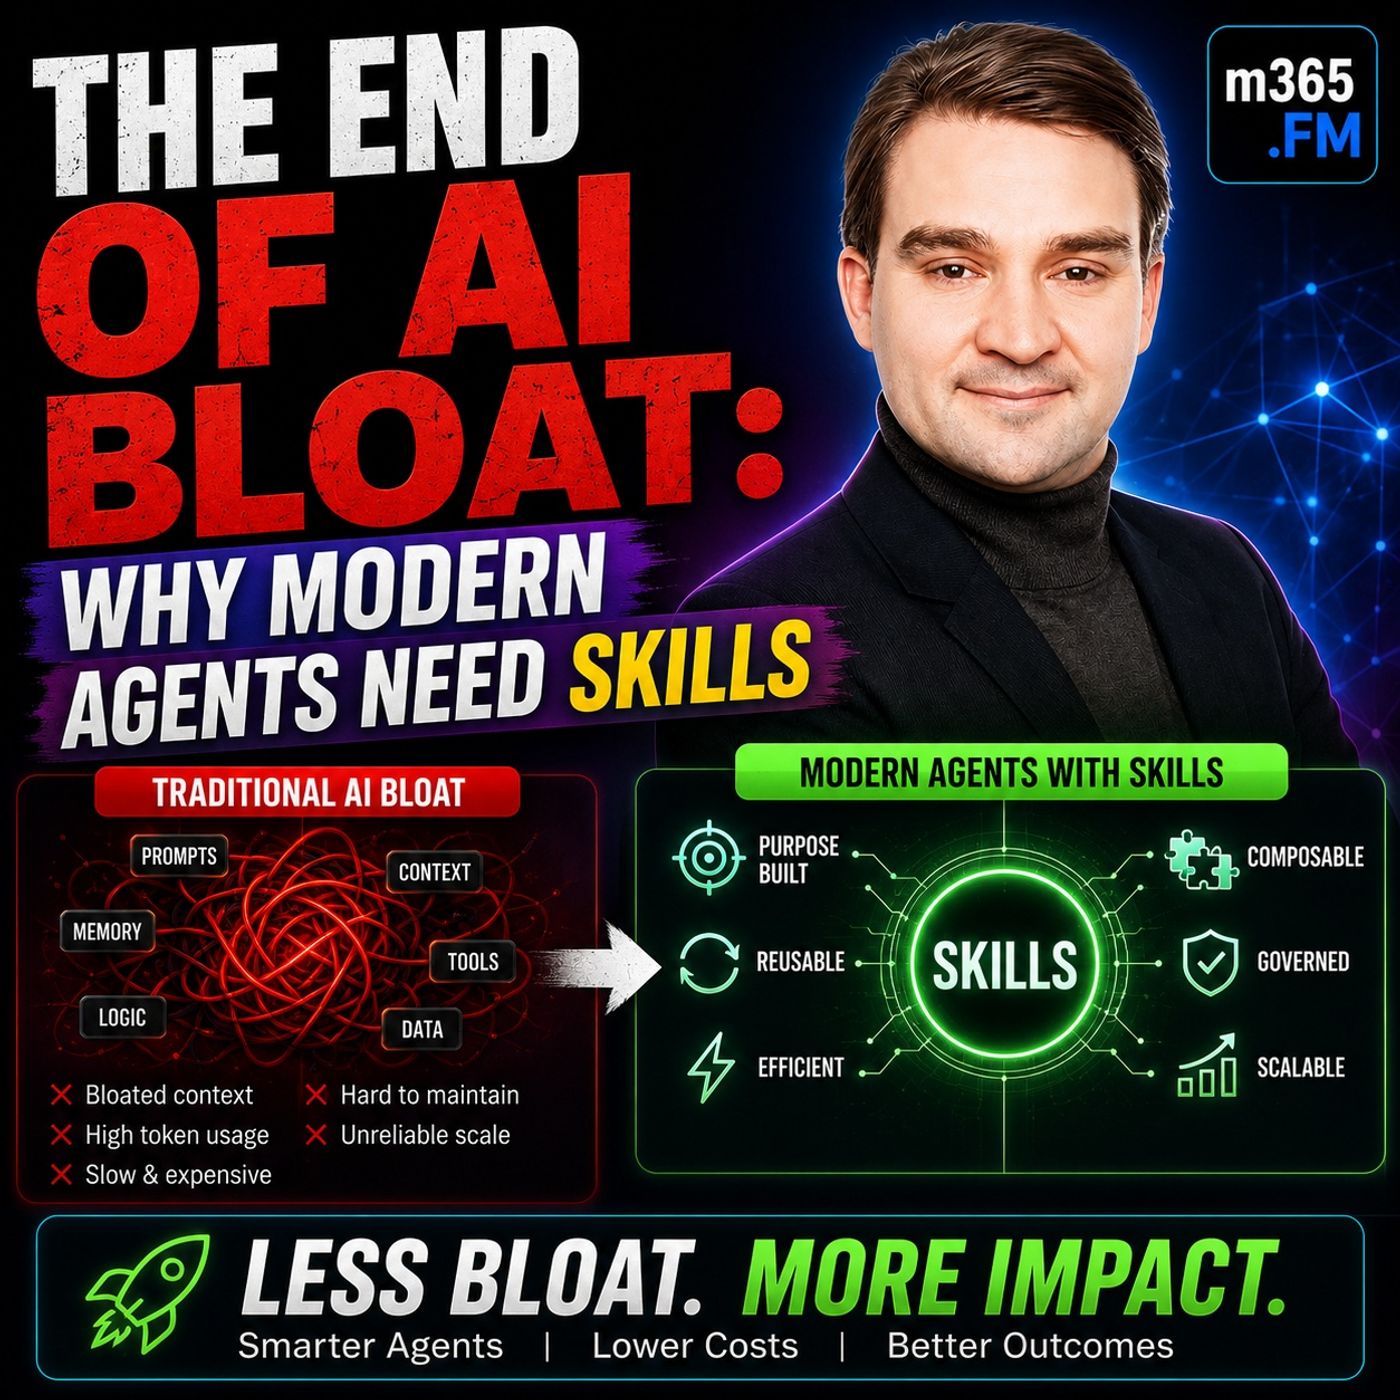
Willkommen zurück beim Blog-Begleiter zu unserem Podcast. Im heutigen Beitrag tauchen wir tief in eine technische Hürde ein, auf die fast jedes Enterprise-Team nach der Bereitstellung seiner ersten KI-Lösungen stößt. Sie bauen einen individuellen KI-Agenten, und zunächst wirkt er wie Magie. Er ist schnell, sehr präzise und reagiert ausgesprochen zügig. Doch drei bis sechs Monate später geschieht etwas Seltsames. Die Antwortzeiten schleppen sich dahin, die Betriebskosten steigen schleichend, und der Agent beginnt zu halluzinieren oder weicht von seinem vorgesehenen Verhalten ab. In vielen Organisationen ist es üblich, dem Problem mehr Rechenleistung zuzuweisen oder auf ein größeres Sprachmodell umzusteigen. Wie wir ausführlich zeigen, liegt das Kernproblem jedoch nicht am Modell selbst, sondern an der zugrunde liegenden Architektur Ihrer Prompts.
In diesem Beitrag zeigen wir, warum monolithische Prompts zu einer katastrophalen Verschlechterung des Kontexts führen, wie Sie universelle Kernverhaltensweisen von aufgabenspezifischen Workflows trennen und warum modulare Entwurfsmuster die KI-Landschaft in Unternehmen verändern.
Einleitung: Die versteckten Kosten monolithischer Prompts
Wenn Engineering-Teams konversationelle KI-Agenten zum ersten Mal prototypisieren, setzen sie in der Regel auf einen einzigen, umfassenden System-Prompt. Dieser legt fest, wer der Agent ist, wie er sprechen soll, welche Regeln er befolgen muss und wie er komplexe Randfälle behandelt. Das ist ein intuitiver Einstieg. Mit der Weiterentwicklung des Geschäfts wächst jedoch auch der Prompt. HR ergänzt neue Urlaubsrichtlinien, die Compliance-Abteilung führt regionale Vorschriften ein, und der Kundensupport fügt Erstattungsworkflows hinzu.
Ehe Sie sich versehen, schwillt Ihr System-Prompt auf Tausende Token dichter Anweisungen an. Jedes Mal, wenn ein Nutzer eine einfache Frage stellt, etwa nach den Bürozeiten, muss das KI-Modell jede einzelne Regel, Richtlinie und jeden Randfall des gesamten System-Prompts aufnehmen, verarbeiten und darüber schlussfolgern. Obwohl fünfundneunzig Prozent dieser Anweisungen für die Frage nach den Bürozeiten völlig irrelevant sind, muss das Modell sie trotzdem parsen. Diese versteckte Belastung für Rechenleistung und Schlussfolgerung nennen wir den „Context Tax“. Sie verändert die Leistungsmerkmale Ihres KI-Agenten im Laufe der Zeit grundlegend.
Der Context Tax und warum Agenten mit der Zeit an Leistung verlieren
Die Verschlechterung von Agenten im Produktivbetrieb ist erstaunlich vorhersehbar. Sie entsteht nicht, weil das zugrunde liegende Modell das Schlussfolgern verlernt hat. Sie entsteht, weil wir das aktive Kontextfenster des Modells mit kognitivem Rauschen überladen. Wenn Sie eine KI zwingen, bei jeder Nutzerinteraktion Berge unverwandter Prozessdokumentation zu durchforsten, geschieht gleichzeitig Folgendes:
- Der Token-Verbrauch steigt sprunghaft an und treibt damit die Inferenzkosten pro Anfrage direkt in die Höhe.
- Die Antwortlatenz steigt, weil größere Kontexte mehr Zeit zur Verarbeitung benötigen.
- Die Wahrscheinlichkeit von Halluzinationen wächst, weil das Modell Mühe hat, widersprüchliche oder irrelevante Anweisungen zu gewichten.
- Die Konsistenz des Schlussfolgerns sinkt, weil die Aufmerksamkeit des Modells auf zu viele konkurrierende Vorgaben verteilt wird.
Das System ist nicht weniger intelligent geworden; sein Denkpfad ist lediglich durch unnötige Daten ausgebremst worden. Um das zu lösen, müssen wir genau betrachten, wie wir Informationen innerhalb unserer Architekturen verteilen.
Always-On-Guidance vs. situative Expertise
Einer der wirkungsvollsten Denkansätze im modernen KI-Engineering ist, Ihre Systemanweisungen in zwei klar getrennte Kategorien zu unterteilen: Always-On-Guidance und situative Expertise.
Always-On-Guidance umfasst die universellen Leitplanken und Identitätsmerkmale, die bei jeder einzelnen Interaktion gelten müssen, unabhängig von der Absicht des Nutzers. Dazu gehören:
- Identität, Persona und Tonalität des Agenten
- Unternehmensweite Sicherheitsanforderungen
- Zentrale Compliance-Regeln und absolute Grenzen
- Standardformatierung und Ausgabepräferenzen
Situative Expertise dagegen ist vollständig kontextabhängig. Sie umfasst Informationen, die nur dann wertvoll sind, wenn ein bestimmtes Szenario oder ein bestimmter Workflow ausgelöst wird. Beispiele sind Onboarding-Protokolle für Lieferanten, Vorschriften zur Steuerberechnung, regionale Rückgaberichtlinien oder komplexe Verfahren zur Reaktion auf IT-Vorfälle.
In klassischen Architekturen werden beide Kategorien in einem einzigen, riesigen Prompt zusammengefasst. In einer modernen, neu strukturierten Architektur bleibt nur die dauerhaft gültige Anleitung permanent geladen. Alles Übrige wird in modulare Komponenten verpackt, die dynamisch geladen werden.
Aufbau eines Skills: Wissen für KI verpacken
Um die Context Tax zu eliminieren, brauchen wir einen Mechanismus, der situatives Expertenwissen außerhalb des primären Prompts speichert und nur bei Bedarf hinzuholt. Dieser Mechanismus ist der KI-Skill. Ein Skill ist nicht bloß ein Prompt-Schnipsel, sondern ein umfassendes, wiederverwendbares Paket aus aufgabenspezifischen Anweisungen und Ressourcen. Ein gut konzipierter Skill umfasst typischerweise:
- Klare Trigger-Beschreibungen, die dem Orchestrator signalisieren, wann der Skill relevant ist
- Strukturierte Verfahrensanweisungen zur Bearbeitung der Aufgabe
- Referenzdokumente, Formulare oder Richtlinienvorlagen
- Optionale Skripte oder API-Definitionen zur Ausführung von Aktionen
Im Zentrum dieses Pakets steht die zentrale Konfigurationsdatei, häufig als SKILL.md-Datei strukturiert. Diese Datei beschreibt den genauen Umfang, den Zweck und die Ausführungsschritte für genau diesen Wissensbereich. Indem Sie Wissen auf diese Weise modularisieren, entstehen saubere, wartbare Bausteine unternehmerischer Fähigkeiten, die sich unabhängig voneinander aktualisieren lassen, ohne die Stabilität des Kernagenten zu gefährden.
Klare Grenzen für das Reasoning festlegen
Die Modularisierung Ihres KI-Agenten in eigenständige Skills spart nicht nur Tokens, sondern schafft auch klare Grenzen für das Reasoning. Erhält ein Modell einen monolithischen Prompt, versucht es, jedes Problem gleichzeitig durch die Brille jeder Regel zu lösen. Mit Skills isolieren Sie hingegen den Reasoning-Bereich.
Wenn ein Benutzer etwa einen Beschaffungsworkflow startet, wird der Procurement-Skill geladen, und die Reasoning-Engine des Agenten konzentriert sich ausschließlich auf Einkaufsrichtlinien, Genehmigungshierarchien und Lieferantenvorgaben. Solange dieser Skill aktiv ist, bleiben unverwandte Regeln zu Steuerabzügen oder Personalrichtlinien außerhalb des aktiven Kontextfensters. Diese strikte Abgrenzung verbessert sowohl die Präzision als auch die Konsistenz der KI-Ausgaben deutlich und stellt sicher, dass sie spezialisierten Verfahren folgt, ohne durch andere Bereiche des Unternehmens beeinflusst zu werden.
Progressive Disclosure zur Effizienzsteigerung einsetzen
Wie verwalten wir diese Skills, ohne das System zu überlasten? Die Antwort liefert ein Entwurfsmuster namens Progressive Disclosure. Statt beim Start jede Anweisung und jeden Workflow zu laden, pflegt Ihr Agent einen schlanken Katalog, der nur die Namen und Beschreibungen der verfügbaren Skills enthält.
Sobald ein Benutzer einen Prompt absendet, läuft der Workflow in einer festen Reihenfolge ab:
- Der Orchestrator gleicht die Anfrage des Benutzers mit dem schlanken Skill-Katalog ab.
- Er ermittelt den Skill, der für das Szenario erforderlich ist.
- Das System lädt diesen einzelnen Skill dynamisch in das Kontextfenster.
- Der Agent führt die Aufgabe mit hoher Präzision aus.
- Nach Abschluss der Aufgabe wird der Skill entladen, und der Agent kehrt in seinen schlanken Grundzustand zurück.
Dieses Entwurfsmuster reduziert den Rechenaufwand deutlich, verringert die Latenz und hält die Betriebskosten im Griff. Gleichzeitig behalten Ihre Agenten Zugriff auf tiefgehendes, spezialisiertes Unternehmenswissen.
Fazit: Ihre KI-Architektur für die Zukunft neu aufstellen
Monolithische Prompts haben uns in den Anfangstagen der generativen KI-Experimente gute Dienste geleistet, doch Unternehmenseinsätze erfordern mehr Skalierbarkeit, geringere Latenz und höhere Zuverlässigkeit. Indem Sie allgemeingültige Anleitungen von situativem Expertenwissen trennen und auf modulare Skills mit Progressive Disclosure setzen, können Sie die Context Tax eliminieren, einer Verschlechterung der Agenten vorbeugen und robuste KI-Systeme aufbauen, die mit Ihrem Unternehmen mitwachsen.
Eine vollständige Aufschlüsselung dieser Architekturmuster, praxisnahe Implementierungsbeispiele und die Frage, wie diese Konzepte auf Plattformen wie Microsoft Copilot Studio, GitHub Copilot und Claude Code anwendbar sind, finden Sie in unserer passenden Episode: „The End of AI Bloat: Why Modern Agents Need Skills“. Hören Sie rein, abonnieren Sie uns und lassen Sie uns wissen, wie Sie Ihre KI-Agenten im Unternehmen strukturieren!