 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Governance für Daten in einem Microsoft Fabric Lakehouse: Architektur ohne schlaflose Nächte
Von Mirko Peters · · Aktualisiert
Governance für Daten in einer Lakehouse-Architektur in Microsoft Fabric, ohne schlaflose Nächte. Analytics mit einer robusten, beherrschbaren Lösung vereinfachen.
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
Kennen Sie diesen unangenehmen Moment in einer Besprechung, wenn jemand fragt: „Können wir belegen, woher diese Zahl stammt?“, und es im Raum still wird? Ich habe dieses Schweigen in Unternehmen erlebt, die „alle Daten“ hatten, aber keinen einzigen Nachweis. Lakehouses versprechen eine Plattform für alles: strukturierte Tabellen, unstrukturierte Dateien, Echtzeit-Datenströme und ML-Features. Dieses Versprechen hält jedoch nur, wenn Sie alles mit Governance steuern können, ohne Ihre Teams zu fesseln. Dieser Beitrag stützt sich stark auf die Studie „Data Governance in Lakehouse“ aus dem Stallion Journal vom Oktober 2024 (Shah & Jain). Ergänzend behandle ich die menschliche Seite: die Abkürzungen, die naheliegend erscheinen, die politischen Hürden, auf die Sie stoßen werden, und die einfachen Gewohnheiten, die Sie vor auditbedingter Panik bewahren.
8 überraschende Fakten zur Governance in einem Microsoft Fabric Lakehouse- Einheitliche Governance über alle Artefakte: Die Governance in Fabric gilt einheitlich für Lakehouse-Tabellen, Dateien, Notebooks, Pipelines und Dashboards. Damit lassen sich zentrale Richtlinien definieren, die sowohl Daten als auch Analytics-Artefakte umfassen.
- Automatische Erfassung der Datenherkunft: Für viele Vorgänge (Aufnahme, Transformationen, Notebooks und Dashboards) wird die Datenherkunft automatisch erfasst. Sie erhalten so nahezu in Echtzeit Transparenz über die Herkunft Ihrer Daten, ohne zusätzliche Instrumentierung.
- Integration von Sicherheit auf Zeilen- und Spaltenebene: Das Lakehouse unterstützt feingranulare Zugriffssteuerung auf Zeilen- und Spaltenebene, die zur Abfragezeit erzwungen wird. Der geregelte Zugriff folgt den Daten, unabhängig von der verwendeten Abfrage-Engine.
- Integrierte Datenklassifizierung und Vertraulichkeitsbezeichnungen: Fabric zeigt Datenklassifizierungen (sensible Informationstypen) an und lässt sich in Microsoft Purview-Vertraulichkeitsbezeichnungen integrieren. So kann die Governance erkannte Klassifizierungen für die Durchsetzung von Richtlinien nutzen.
- Policy-as-Code für Kontrollen im Lebenszyklus: Governance-Richtlinien (Aufbewahrung, Qualitätskontrollen, Verschlüsselung, zulässige Compute-Ressourcen) lassen sich programmatisch formulieren und anwenden. Das ermöglicht eine automatisierte Durchsetzung über den gesamten Lebenszyklus des Lakehouse.
- Nahtlose Mandanten- und Arbeitsbereich-Isolierung: Das Governance-Modell von Fabric unterstützt die Isolierung mehrerer Arbeitsbereiche und mandantenbezogene Richtlinien. So können Sie Freigaben und Datenverschiebungen zwischen Projekten einschränken und dennoch kontrollierte Zusammenarbeit ermöglichen.
- Prüfbare Protokolle für Änderungen und Zugriffe: Alle governance-relevanten Vorgänge (Lese- und Schreibzugriffe auf Daten, Richtlinienänderungen, Rollenzuweisungen) sind prüfbar. Die Protokolle lassen sich mit Microsoft Sentinel und SIEM-Systemen integrieren und unterstützen so die Compliance-Überwachung.
- Governance-fähige Datenverträge: Fabric erlaubt das Erstellen von Datenverträgen und Schemata mit erzwungenen Kompatibilitätsprüfungen. Verbraucher erhalten so stabile, kontrollierte Schnittstellen zu den Lakehouse-Daten, und Produzenten können ihre Daten sicher weiterentwickeln.
1) Das Problem der „stillen Besprechung“: Warum Lakehouses Governance brauchen
Sie sitzen in einer Führungsrunde. Auf dem Bildschirm erscheint eine KPI, etwa Umsatzbindung, Wartezeit von Patienten oder Abwanderungsrisiko. Jemand fragt: „Woher stammt diese Zahl?“ Es wird still im Raum. Sie können weder den Datensatz noch die Transformation nachvollziehen, und Sie wissen nicht, wer die Logik in der Vorwoche geändert hat. In diesem Moment haben Sie kein Analytics-Problem, sondern ein Problem mit dem Vertrauen in die Daten.
Lakehouse einfach erklärt: ein Dach, zwei Versprechen
Ein Lakehouse ist eine praxisnahe Verbindung aus der Flexibilität eines Data Lake (alles speichern, schnell) und der Verlässlichkeit eines Data Warehouse (konsistente Tabellen, hohe Performance). Unter einem Dach können Sie strukturierte und unstrukturierte Daten verwalten, Echtzeit-Analysen durchführen und Machine-Learning-Workloads unterstützen. Gerade dieser „Alles-in-einem“-Nutzen ist der Grund, warum Ihre Strategie für die Lakehouse-Architektur von Anfang an Governance einschließen muss.
Warum Lakehouses den Bedarf an Data Governance verstärken
Lakehouses bewegen sich schnell: Datenströme in Echtzeit, häufiges Neutrainieren von Modellen und viele Teams, die gleichzeitig Dashboards veröffentlichen. Diese Geschwindigkeit vervielfacht das Risiko. Gemischte Datentypen und viele Werkzeuge erschweren es, den Überblick über Definitionen, Berechtigungen und Datenherkunft zu behalten. Wenn Sie eine Kennzahl nicht erklären können, hören die Stakeholder auf, dem Dashboard zu vertrauen, selbst wenn die Zahl korrekt ist.
- Echtzeitdaten erhöhen das Risiko inkonsistenter Snapshots und von KPIs, die sich ständig verändern.
- ML-Pipelines bringen neue Artefakte mit sich, die Sie steuern müssen: Features, Trainingsdaten, Modellausgaben und Drift-Signale.
- Mehr Nutzer (Analysten, Data Scientists, Produktteams) bedeuten mehr Zugriffswege – und mehr Möglichkeiten, Richtlinien zu umgehen.
Governance ist kein Papierkram – sie ermöglicht es Ihnen, sicher weiter auszuliefern
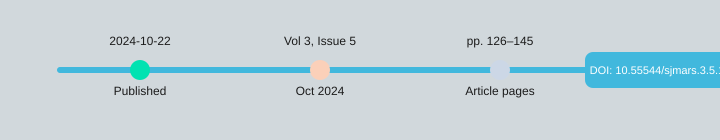
Die peer-reviewte Studie „Data Governance in Lakehouse“ aus dem Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), veröffentlicht am 22.10.2024 in Band 3, Ausgabe 5 (S. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), betrachtet Governance sowohl als strategische Notwendigkeit als auch als operatives Muss. Die Botschaft ist einfach: Governance schützt Sie bei der Einhaltung von Compliance-Vorgaben (DSGVO, HIPAA, CCPA), reduziert Risiken und sichert die Datenqualität und das Vertrauen der Stakeholder.
Samarth Shah: „In einem Lakehouse ist Geschwindigkeit ohne Governance keine Agilität – sie ist nur schnellere Verwirrung.“
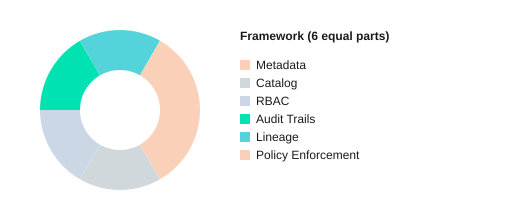
In der Praxis bedeutet Lakehouse-Data-Governance, dass Sie die Frage „Was bedeutet diese KPI?“ mit Nachweisen beantworten können: Metadaten, Katalogeinträge, Zugriffskontrollen (etwa RBAC), Audit-Trails und Lineage. Das ist kein Bürokratieaufwand. Es ist das System, mit dem Sie Analysen schnell liefern – ohne Gesetze zu verletzen oder Vertrauen zu verspielen.
| Metadatenelement | Wert |
|---|---|
| Veröffentlichungsdatum | 22-10-2024 |
| Ausgabe der Zeitschrift | Band 3, Ausgabe 5 (Okt. 2024) |
| Seiten | 126–145 |
| ISSN | 2583-3340 |
2) Wie „gute Governance“ aussieht, wenn Ihre Daten überall liegen
In einem Lakehouse liegen Ihre Daten nicht „an einem Ort“. Sie verteilen sich auf Tabellen, Dateien, Streams und ML-Features – oft auf Plattformen wie AWS, Snowflake oder Databricks. Gute Governance sorgt dafür, dass die Daten nutzbar und sicher bleiben, ohne Teams auszubremsen. Denken Sie an Leitplanken, nicht an Schranken: Sie ermöglichen Echtzeitanalysen und erfüllen gleichzeitig die Anforderungen von DSGVO, HIPAA und CCPA.
Die 6 Bausteine, die Sie tatsächlich umsetzen
- Metadatengesteuerte Governance: Definieren Sie Verantwortliche, Vertraulichkeit, Aufbewahrung und Qualitätsregeln in den Metadaten, damit die Kontrollen mit Datenmenge und Veränderungen mitwachsen.
- Best Practices für den Datenkatalog: ein durchsuchbarer Ort für Definitionen, Tags und vertrauenswürdige Datensätze – damit Menschen nicht mehr raten müssen.
- RBAC-Zugriffskontrolle: Rollen richten sich nach den Aufgaben (Analyst, Engineer, Klinikpersonal), nicht nach ad-hoc vergebenen Berechtigungen.
- Nachverfolgung der Datenherkunft (Data Lineage): Zeigen Sie, woher Daten stammen, wie sie sich verändert haben und wohin sie fließen.
- Audit-Trails: Wer hat auf was zugegriffen, wann, und was hat er getan? Das ist entscheidend für Untersuchungen und Audits.
- Durchsetzung von Richtlinien: automatisierte Prüfungen (Maskierung, Aufbewahrung, Freigaben), die standardmäßig laufen, nicht erst auf Anfrage.
Dokumentierte vs. durchgesetzte Governance (nur eine verhindert Vorfälle)
Dokumentierte Governance ist eine Wiki-Seite, auf der steht: „PII muss maskiert werden.“ Durchgesetzte Governance heißt, dass Ihr Lakehouse PII anhand von Metadaten-Tags automatisch maskiert, riskante Exporte blockiert und Zugriffe in Audit-Trails protokolliert. Die Forschung zu modernen Lakehouse-Governance zeigt, dass Automatisierung und Metadaten den manuellen Durchsetzungsaufwand und die Fehlerquote senken – weil die Plattform die Regeln konsistent anwendet.
Einheitliche Governance, wenn Sie Tabellen, Dateien, Streams und Features gleichzeitig verwalten
Sie brauchen eine zentrale Steuerungsebene, die über Batch-Tabellen, Dateien im Objektspeicher, Kafka-ähnliche Streams und ML-Feature-Sets hinweg funktioniert. Ist die Governance einheitlich, folgen dieselben RBAC-Zugriffskontrollen, Tags und Richtlinien den Daten. So bleiben Dashboards, Notebooks und Modelle abgestimmt und konform.
Kleiner Exkurs: Wie aus „einem gemeinsamen Datensatz“ 12 Versionen werden
Ohne Nachverfolgung der Datenherkunft wird ein Datensatz „customer“ in customer_v2, customer_clean, customer_final und „final_final“ kopiert. Bald streiten sich Teams über Zahlen, weil niemand belegen kann, welche Version welchen Bericht gespeist hat.
Shubham Jain: „Lineage entscheidet darüber, ob Sie ‚Ich glaube‘ oder ‚Ich kann es belegen‘ sagen, wenn jemand Ihre Zahlen hinterfragt.“
Selbstcheck in 5 Minuten
- Finden Sie für Ihre 10 wichtigsten Datensätze im Katalog den Verantwortlichen und das Vertraulichkeits-Tag?
- Steuern Rollen (nicht einzelne Personen) den Zugriff über RBAC?
- Können Sie eine KPI mithilfe der Lineage in weniger als 2 Minuten bis zu ihren Quellen zurückverfolgen?
- Beantworten Audit-Trails heute die Frage „Wer hat das angesehen oder exportiert?“
- Werden Richtlinien automatisch durchgesetzt (Maskierung, Aufbewahrung, Freigaben) statt manuell?
Jede Kontrolle zahlt auf ein Ergebnis ein: weniger Zugriffsvorfälle (RBAC + Richtlinien), schnellere Audits (Audit-Trails + Katalog) und sauberere Analysen (Metadaten + Lineage).
3) Die Zahlen, die Governance weniger nach „Overhead“ aussehen lassen
Wenn Governance nach „zusätzlichem Prozess“ klingt, helfen Ihnen die Ergebnisse des Papers, sie als messbaren betrieblichen Gewinn neu einzuordnen. Wenn Sie metadatengetriebene Governance mit Automatisierung und ML in einem Lakehouse anwenden, fügen Sie nicht nur „zusätzliche Kontrollen“ hinzu. Sie gewinnen Zeit zurück, verbessern das Vertrauen in Daten und senken das Compliance-Risiko auf eine Weise, die ein CFO nachverfolgen kann.
Metadatengetriebene Governance: ROI, den Sie auf einer Folie zeigen können
Die Studie nennt drei zentrale Ergebnisse, wenn Teams sich auf starke Metadaten, Katalogisierung, Datenherkunft (Lineage) und Zugriffskontrollen stützen:
- Bis zu 40 % höhere Governance-Effizienz
- 35 % höhere Datenqualität
- 92 % Erfüllungsquote bei GDPR- und HIPAA-Compliance (GDPR/HIPAA)
Konkret bedeutet dieser Effizienzgewinn von 40 % oft weniger manuelle Prüfungen, weniger Schleifen nach dem Motto „Wem gehört dieser Datensatz?“ und schnellere Genehmigungen für Zugriff und Freigaben. Ihr Backlog schrumpft, weil Routineprüfungen von Menschen auf Systeme übergehen, und Ihre Incident-Warteschlange wird kürzer, weil weniger Probleme in die Produktion gelangen.
Automatisierte Richtliniendurchsetzung: der Vorher-nachher-Vergleich, der die Diskussion verändert
Der eindeutigste Beleg für das Verhältnis von Aufwand und Nutzen ist der Wechsel von manuellen Kontrollen zur automatisierten Richtliniendurchsetzung:
- Zeit für die Durchsetzung von Richtlinien: 72 % → 28 %
- Fehlerquote: 45 % → 15 %
Das ist keine kleine Optimierung. Es ist der Unterschied zwischen Governance als Schranke und Governance als Leitplanke. Sie verbringen weniger Zeit damit, Ausnahmen nachzujagen, und mehr Zeit damit, sicheres Self-Service zu ermöglichen.
„Einheitliche Governance hält nur dann, wenn der Workflow einfacher ist als die Umgehungslösung.“ —Taylor, Singh, & Green (2021)
Akzeptanz in der Praxis: stark bei technischen Anwendern, schwieriger bei allen anderen
Die Usability-Werte waren bei Data Scientists, Business Analysts und IT-Administratoren hoch (4,2–4,7 von 5). Die Studie benennt aber auch eine häufige Lücke: Nicht-technische Anwender brauchen einfachere Oberflächen, klarere Begriffsdefinitionen und geführte Workflows. Wenn Sie die oben genannten Zahlen erreichen wollen, müssen Sie Budget für Enablement einplanen, nicht nur für Tools.
Kennzahlen auf einen Blick
| Kennzahl | Ergebnis |
|---|---|
| Verbesserung der Governance-Effizienz | Bis zu 40 % |
| Steigerung der Datenqualität | 35% |
| GDPR-/HIPAA-Compliance-Quote | 92% |
| Zeit für Richtliniendurchsetzung | 72 % (manuell) vs. 28 % (automatisiert) |
| Fehlerquote | 45 % (manuell) vs. 15 % (automatisiert) |
| Usability-Bewertung | 4,2–4,7 von 5 |
| Reduktion der Verarbeitungszeit | 25% |
4) Tools, Prototypen und die unbequeme Wahrheit der Implementierung
Was die Forschung konkret gemacht hat
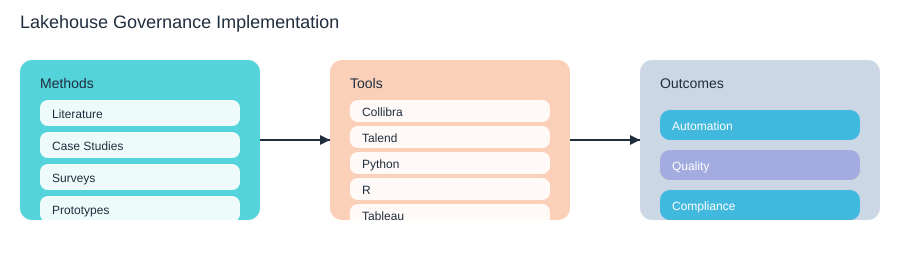
Die Stallion-Journal-Studie behandelte Governance nicht als Folienproblem. Sie nutzte vier Methoden, die Sie aus der täglichen Arbeit kennen: Sie wertete die Literatur aus (systematische Reviews), untersuchte Fallstudien aus der Branche, befragte Stakeholder und testete Prototypen. Der letzte Punkt ist wichtig, denn Lakehouse-Governance scheitert in den Lücken zwischen Richtlinie und Pipeline, besonders wenn Ihre Daten schnell eintreffen, sich häufig ändern und aus vielen Teams stammen.
Prototyp-Stack: was tatsächlich getestet wurde
In den Experimenten nutzte die Studie Collibra und Talend für Governance- und Integrationsmuster sowie Analysetools (Python, R, Tableau), um Usability und Ergebnisse zu validieren. Sie können diesen Ansatz übernehmen, ob Sie Databricks-Governance, ein Snowflake-Lakehouse oder eine breitere Cloud-native Daten-Governance mit Kubernetes, Docker, Kafka, Postgres, PySpark und Elasticsearch aufbauen.
Ein Rollout-Pfad zum Nachbauen (und ohne Chaos)
Der Erfolg einer Implementierung hängt von toolgestützter Governance und Ihrer Fähigkeit ab, mit Geschwindigkeit, Komplexität und begrenzten Ressourcen umzugehen. Eine praxistaugliche Reihenfolge ist:
- Mit Katalog und RBAC beginnen: Wenden Sie Best Practices für Datenkataloge an (klare Verantwortlichkeiten, Geschäftsbegriffe und „goldene“ Datensätze). Ordnen Sie danach Zugriffe über RBAC zu.
- Lineage ergänzen: Erfassen Sie vor- und nachgelagerte Auswirkungen, damit Änderungen Analysten oder Auditoren nicht überraschen.
- Durchsetzung automatisieren: Ersetzen Sie manuelle Genehmigungen wo möglich durch Policy-as-Code, mit Audit-Trails.
Harris & Nguyen (2020): „RBAC ist auf dem Papier einfach; es wird real, sobald Sie es Teams statt Jobtiteln zuordnen.“
Ihr täglicher Gegner: Geschwindigkeit und inkonsistente Datenströme
Hochfrequente Datenströme (etwa im Stil von Kafka-Streams) erzeugen „schema drift“, verspätete Ereignisse und doppelte Datensätze. Genau hier wirkt Governance oft unübersichtlich: Ihr Katalog besagt, dass ein Feld Pflichtfeld ist, doch der Stream liefert es nicht. Ihre Qualitätsregeln erwarten einen Zeitstempel, die Produzenten senden aber drei. Die Studie nennt das ein wiederkehrendes Hindernis, besonders wenn Teams unterbesetzt sind.
Tool-Wildwuchs: Wenn Systeme sich widersprechen
Achten Sie auf das klassische Split-Brain-Problem: Ihr Katalog zeigt, dass Dataset A „eingeschränkt“ ist, doch IAM-Gruppen erlauben weiterhin breiten Zugriff. Oder Ihre Databricks-Governance-Richtlinien stimmen nicht mit der Konfiguration in der Cloud-IAM überein. Betrachten Sie „eine einzige Quelle der Wahrheit“ als Designziel und nicht als Schlagwort.
| Entscheidungsrahmen | Halten Sie es einfach |
|---|---|
| Kaufen oder selbst bauen | Kaufen Sie für Katalog und Workflows; bauen Sie nur schlanke Konnektoren und Prüfungen selbst. |
| Ein Governance-Labyrinth vermeiden | Ein Katalog, ein Richtlinienmodell, minimale benutzerdefinierte Rollen, automatisierte Audits. |
5) Die größten Governance-Probleme (und wie Sie diese priorisieren)
Wenn sich Governance schwieriger anfühlt, als sie sein „sollte“, sind Sie nicht allein. In der Zusammenfassung der Forschung nennen 78 % der Organisationen die Herausforderung des Metadatenmanagements als wichtigstes Problem. Diese Zahl sollte Ihnen das Gefühl geben, verstanden zu werden: In einem Lakehouse bewegt sich alles schnell, und Metadaten sind die Karte, die Sie aktualisieren müssen, während die Straßen noch gebaut werden.
Warum Metadaten zuerst brechen (und immer wieder)
Metadaten sind schwierig, weil:
- Definitionen driften auseinander: „Aktiver Kunde“ bedeutet für die Finanzabteilung etwas anderes als für das Growth-Team.
- Zuständigkeiten sind unklar: Niemand ist sich sicher, wer ein neues Feld, eine neue Tabelle oder eine neue Aufbewahrungsregel genehmigt.
- Pipelines ändern sich wöchentlich: neue Quellen, neue Joins, neue ML-Features – Ihr Katalog und Ihre Tags hinken hinterher.
Und doch erhalten Sie bei Investitionen in Governance messbare Erträge: 88 % berichten von einer verbesserten Data-Quality-Governance, und 81 % von einer besseren Lakehouse-Sicherheits-Governance. Das ist der Lohn für die unspektakuläre Arbeit.
Governance-Triage: Die richtigen Dinge in der richtigen Reihenfolge angehen
- Zuerst Metadaten und Zuständigkeiten: Definieren Sie kritische Datenelemente, weisen Sie einen Dateninhaber und einen Data Steward zu, und standardisieren Sie Geschäftsbegriffe in Ihrem Katalog.
- Als Nächstes Zugriffssteuerung: Implementieren Sie RBAC nach dem Prinzip der minimalen Berechtigungen, zusammen mit klaren Genehmigungswegen für Ausnahmen.
- Lineage und Prüfprotokolle: Verfolgen Sie, woher Daten stammen, wie sie sich verändert haben und wer darauf zugegriffen hat. Hier lassen sich Fragen zu DSGVO/HIPAA/CCPA schnell beantworten.
- Automatisierung zuletzt (aber kontinuierlich): Automatisieren Sie Richtlinienprüfungen, Kennzeichnung und Anomalieerkennung, damit die Durchsetzung nicht von Heldentaten abhängt.
Was passiert, wenn HIPAA auf CCPA trifft?
Stellen Sie sich ein Lakehouse vor, in dem ein HIPAA-reguliertes Patientendatenset (Patientenkontakte) mit einem dem CCPA unterliegenden Marketing-Datensatz (Webverhalten) verknüpft wird. Zuerst bricht meist Klassifizierung und Einwilligung: PHI-Tags fehlen, Einwilligungskennzeichen werden durch Joins nicht weitergegeben, und ein nachgelagertes Dashboard zeigt mehr als beabsichtigt. Ohne Lineage können Sie nicht belegen, wohin die Daten gelangt sind; ohne RBAC können Sie breiten Zugriff nicht stoppen; ohne Prüfprotokolle und Identitätsverwaltung können Sie keine Verantwortlichkeit nachweisen.
„Die eigentliche Herausforderung besteht nicht darin, KI zum Laufen zu bringen, sondern sie verantwortungsvoll in den Systemen zum Laufen zu bringen, die Sie bereits haben.“
— Dr. Fei-Fei Li
Ein einfaches Ritual, das Sie auf Kurs hält: die monatliche Governance-Retrospektive
Führen Sie monatlich eine 45-minütige Retrospektive mit IT, Sicherheit und Fachverantwortlichen durch. Prüfen Sie: die drei größten Metadatenlücken, die drei größten Zugriffsausnahmen, einen Lineage-Fehler und einen Automatisierungserfolg. Halten Sie Maßnahmen in einem gemeinsamen Tracker fest, und weisen Sie jedem Punkt eine einzige verantwortliche Person zu.
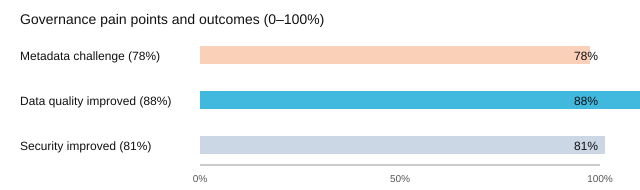
6) Compliance ohne Panik: DSGVO, HIPAA, CCPA im Lakehouse
Im Lakehouse behandeln Sie Compliance als Entwurfsvorgabe, nicht als Last-Minute-Hektik. Wenn Sie Kontrollen von Tag eins an in Aufnahme, Speicherung und Zugriff einbauen, werden DSGVO- und HIPAA-Compliance sowie CCPA-Data-Governance keine Feuerwehreinsätze mehr, sondern normaler Betrieb. Die Studie des Stallion Journal zu „Data Governance in Lakehouse“ zeigt warum: Organisationen, die metadatengesteuerte Governance, Automatisierung und ML einsetzen, meldeten Compliance-Quoten von 92 % für DSGVO und HIPAA. Nutzen Sie das als Nordstern-Benchmark, nicht als Garantie.
„Sicherheit ist ein Prozess, kein Produkt – und Governance ist der Weg, diesen Prozess ehrlich zu halten.“
—Bruce Schneier
Kontrollen den Vorschriften zuordnen: Ihr Kernwerkzeug für Compliance
„DSGVO umsetzen“ oder „HIPAA umsetzen“ gelingt nicht allein durch das Schreiben von Richtlinien. Sie ordnen die Anforderungen wiederholbaren Kontrollen im Lakehouse zu:
- RBAC (rollenbasierte Zugriffskontrolle): Begrenzen Sie, wer PHI/PII einsehen und wer sie exportieren darf.
- Audit-Trails im Lakehouse: Belegen Sie, wer worauf wann, von wwo aus zugegriffen und was die Person getan hat.
- Data Lineage: Zeigen Sie, woher sensible Felder stammen, wie sie sich verändert haben und wohin sie gelangt sind.
- Durchsetzung von Richtlinien: Wenden Sie Maskierung, Aufbewahrung und Zweckbindung einheitlich über alle Tools hinweg an.
- Metadatenverwaltung und Katalog: Klassifizieren Sie Daten, kennzeichnen Sie die Vertraulichkeit und steuern Sie darüber die Automatisierung.
| Regulierung | Was Prüfer prüfen | Lakehouse-Kontrolle |
|---|---|---|
| DSGVO | Rechtmäßiger Zugriff, Datenminimierung, Aufbewahrung | RBAC, Maskierung, Aufbewahrungsrichtlinien, Data Lineage |
| HIPAA | Zugriffsprotokolle, Schutzmaßnahmen, Least Privilege | Audit-Trails, RBAC, Verschlüsselung, Überwachung |
| CCPA | Dateninventar, Umgang mit Zugriffs- und Löschanfragen | Katalog und Metadaten, Data Lineage, Richtlinien-Workflows |
Die nächste Welle: regionsspezifische Vorgaben und Altsysteme
Die Studie nennt künftige Aufgaben, die Sie jetzt einplanen sollten: regionsspezifische Compliance und eine bessere Anpassbarkeit für Altsysteme oder eingeschränkte Umgebungen. Wenn Sie über Bundesländer oderLänder hinweg arbeiten, entwickeln Sie Richtlinien, die sich regional unterscheiden können (Aufbewahrungsfristen, Einwilligungsregeln, Meldepflichten bei Datenschutzverletzungen). Betreiben Sie noch ältere Systeme, beginnen Sie mit einem kleineren Umfang und integrieren Sie schrittweise. Automatisierung hilft, aber die Komplexität ist real.
Durchgang „Audit-Tag“: Was Sie vorlegen müssen
- Dateninventar: Wo PII/PHI liegt, wer die Verantwortung trägt und zu welchem Zweck die Daten verarbeitet werden (
catalog + tags). - Nachweis des Zugriffs: RBAC-Rollen, Genehmigungen und Exporte der Audit-Trails im Lakehouse.
- Nachweis der Datenherkunft: Pfade von der Quelle bis zum Bericht für zentrale Datensätze und sensible Spalten.
- Nachweis der Richtlinien: Maskierung, Aufbewahrung, Löschprozesse und Protokolle zur Durchsetzung.
- Beteiligte im Raum: Dateninhaber, Security, Plattformadministrator, Compliance/Rechtsabteilung und ein Analyst, der die Daten nutzt.
Radar-Ansicht: Ausgangsbasis im Vergleich zu einem gesteuerten Lakehouse
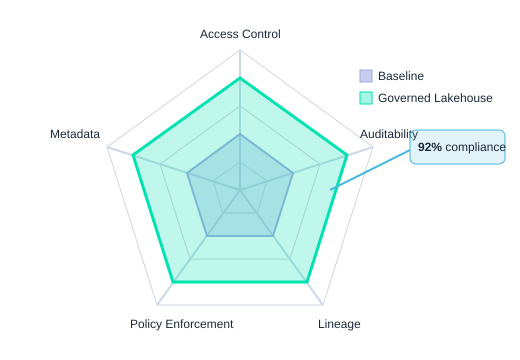
Kleiner, ehrlicher Einschub: Sind Sie eine kleinere Organisation, starten Sie mit einer einfachen Ausgangsbasis aus RBAC, Protokollierung und einem schlanken Katalog, bevor Sie Enterprise-Tools kaufen. Die Studie macht deutlich, dass die Komplexität der Umsetzung eine echte Hürde sein kann, besonders wenn die Ressourcen knapp sind.
7) Anbieterbias, Politik und das, was Governance-Präsentationen auslassen
Sie können ein sauberes Governance-Modell für das Lakehouse auf dem Papier entwerfen und dann zusehen, wie es sich verbiegt, sobald Data-Governance-Tools ins Spiel kommen. Die unbequeme Wahrheit ist einfach: Werkzeuge und Anbieter prägen, wie „Best Practice“ aussieht, weil sie bestimmen, was sich leicht vorführen, leicht kaufen und leicht berichten lässt.
Die Studie des Stallion Journal zum Lakehouse benennt das im Abschnitt zu Interessenkonflikten ausdrücklich. Sie nennt drei Quellen von Bias, von denen Sie in jedem Governance-Programm ausgehen sollten: Anbieterbias (Bevorzugung von Plattformen wie Collibra-Talend-Governance-Stacks oder anderen kommerziellen Suiten), organisatorischer Berichtsbias (nur Erfolgskennzahlen werden geteilt) und finanzielle und regulatorische Drucksituationen (Auswahl dessen, was Prüfern am sichersten erscheint, nicht dessen, was zu Ihrer Architektur passt). Die zentrale Erkenntnis der Forschung lautet: Transparenz und Offenlegung sind notwendig, um die Integrität der Forschung zu wahren und Ihre Governance-Entscheidungen über die Erzählungen der Anbieter hinaus nützlich zu halten.
Satya Nadella: „Vertrauen ist die ultimative Währung – und bei Daten verdienen Sie es sich, indem Sie offen darlegen, was Sie getan haben und warum.“
Bias-Risiken, die Sie klar benennen sollten
Governance-Forschung und Tooling-Bias-Risiken & Anbieterbias 40 %, Berichtsbias 35 %, Finanziell/Regulatorisch 25 %: Anbieterbias, Berichtsbias, Finanziell/Regulatorisch
Ihre Checkliste gegen Bias (praktisch, nicht politisch)
- Stichprobe: Vergleichen Sie mindestens eine kommerzielle Suite und eine Open-Source-Option über die Ökosysteme AWS, Snowflake, Databricks, SAP und Oracle Cloud Infrastructure hinweg.
- Offenlegung: Dokumentieren Sie Sponsoren, die Gründe für die Werkzeugauswahl und was Sie nicht getestet haben.
- Bewertungskriterien: Tiefe der Data Lineage, Passung von RBAC/ABAC, Audit-Trails, API-Zugriff, Exportformate und Integration in Ihre Lakehouse-Tabellen.
- Proof of Value: Führen Sie einen zeitlich begrenzten Pilotversuch in einem Bereich durch und messen Sie die Dauer der Richtliniendurchsetzung, die Fehlerquote und die Reibung für die Nutzer.
- Prüfung des Anbieter-Risikos für die Datenplattform: Fragen Sie nach, wie sich Vendor-Lock-in in Metadaten, Katalogen und Workflow-Regeln zeigt.
Kleines Szenario: Sie moderieren die eigentliche Entscheidung
Der Einkauf drängt auf einen einzigen Anbieter im Namen der „Standardisierung“. Die Entwickler wollen Open Source, um die Kontrolle zu behalten. Compliance verlangt „zertifizierte“ Funktionen und saubere Nachweise für Audits. Ihre Aufgabe ist es, zwischen diesen Interessen zu vermitteln: Sie können Compliance mit starken Kontrollen und Audit-Trails gerecht werden, die Entwickler mit APIs und Portabilität und den Einkauf mit einem klaren ROI. Dabei sollte keine Gruppe Governance als „alles, was das Tool verkauft“ definieren.
Was, wenn Ihr Tool übernommen wird und sich der Preis verdreifacht?
Gehen Sie davon aus, dass das passieren kann. Testen Sie die Portabilität jetzt: Können Sie Ihr Business-Glossar, Ihre Datenherkunft und Ihre Richtlinienregeln in brauchbaren Formaten exportieren? Wenn sich Ihre Metadaten nicht verlagern lassen, ist Ihre Governance kein Programm, sondern ein Abonnement.
8) Zukunftssicherheit: IoT, Edge, dezentrale Daten und das Lakehouse, das Sie übernehmen
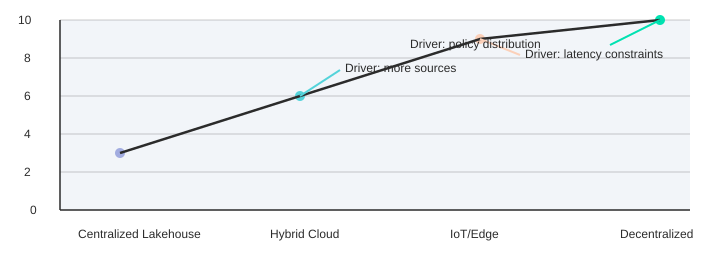
Ihre Lakehouse-Governance funktioniert am besten, wenn Daten größtenteils zentralisiert sind, sich für Batch-Verarbeitung eignen und von wenigen Plattformen kontrolliert werden. IoT- und Edge-Computing-Governance stellt diese Annahmen schnell infrage: Sie haben es mit mehr Quellen zu tun (Geräte, Gateways, Apps), mit weniger zentraler Kontrolle (Teams stellen unabhängig voneinander bereit) und mit strengeren Latenzgrenzen (Sie können nicht „auf den nächtlichen Job warten“, um Zugriffe oder Qualität zu entscheiden). Die Studie des Stallion Journal benennt diesen Druck direkt und empfiehlt Governance-Erweiterungen für drei neue Bereiche: IoT-Data-Lakes, dezentrale Architekturen und Edge Computing.
Warum IoT und Edge Ihr aktuelles Modell unter Druck setzen
Bei IoT-Streams kann dasselbe „Kunden“-Ereignis von mehreren Sensoren, in unterschiedlichen Formaten und zu verschiedenen Zeitpunkten eintreffen. Wenn Ihre Richtlinien von einer einzigen zentralen Katalogaktualisierung abhängen, verlangsamen Sie den Betrieb oder nehmen blinde Flecken in Kauf. Edge-Standorte erzeugen außerdem lokale Datenkopien für Geschwindigkeit und Ausfallsicherheit. Daher müssen Ihre Audit-Trails, Ihre Datenherkunft und Ihre Aufbewahrungsregeln mit den Daten mitwandern und dürfen nicht in einer warehouse-artigen Steuerungsebene gefangen bleiben.
Dezentrale Datenarchitektur braucht portable Governance
In einer dezentralen Datenarchitektur veröffentlichen Domänen Datenprodukte und entwickeln ihre Schemas nach eigenen Zeitplänen weiter. Das ist gut für die Liefergeschwindigkeit, aber riskant, wenn Ihre Definitionen von „PII“, „Einwilligung“ oder „HIPAA-Geltungsbereich“ nicht einheitlich sind. Zukunftssicherheit bedeutet, Governance als gemeinsam genutzten Dienst zu gestalten: erweiterbare Metadaten, versionierte Richtlinien und Identitätskontrollen, die über Teams und Regionen hinweg funktionieren. Damit folgen Sie auch dem Anliegen der Studie, die Compliance an regionale Anforderungen anpassbar zu halten.
Setzen Sie auf cloud-native Bausteine, die Sie weiterverwenden können
Das Referenz-Set rund um die Studie verweist auf praxistaugliche Bausteine: Docker zum Verpacken von Richtliniendiensten, Kubernetes zum Betrieb überall, Kafka für Streaming-Durchsetzungs-Hooks, Elasticsearch für schnelle Suche sowie Postgres/PySpark für governte Verarbeitung. Sie wählen Werkzeuge nicht aus Modegründen, sondern weil sie in der Cloud, lokal und am Edge mit denselben Kontrollen laufen können.
„Alles scheitert, jederzeit – gestalten Sie Governance so, als rechneten Sie mit Veränderung statt mit Stabilität.“ — Werner Vogels
Eine Roadmap mit kleinen Wetten, die Sie in Bewegung hält
Sie müssen die Edge-Governance heute nicht vollständig lösen. Sie brauchen aber Metadaten- und Richtliniensysteme, die sich ohne Neuaufbau erweitern lassen. Beginnen Sie damit, KI-gestützte Anomalieerkennung auf Governance-Signalen zu pilotieren (Schema-Drift, ungewöhnliche Zugriffspfade, auffällige Exporte). Erweitern Sie dann automatisierte Richtlinienprüfungen bei der Aufnahme und zur Abfragezeit. Wenn Ihr Datenbestand wächst, setzen Sie auf stärkere Identitätsverwaltung, prüfen Sie für kritische Audit-Trails manipulationssichere Nachweise nach Blockchain-Art und planen Sie eine Notfallwiederherstellung, die zu Ihrer Risikostufe passt.
| Umgebung | Governance-Komplexitätsindex (illustrativ) |
|---|---|
| Zentralisiertes Lakehouse | 3 |
| Hybrid Cloud | 6 |
| IoT/Edge | 9 |
| Dezentralisiert | 10 |
Formulieren Sie Ihre Governance-Prinzipien so, als würden Sie irgendwann ersetzt: klare Definitionen, portable Richtlinien und Entscheidungsprotokolle, die Umstrukturierungen überstehen. Das Lakehouse, das Sie später übernehmen, wird unübersichtlicher sein als heute. Ihr künftiges Ich wird ruhiger schlafen, wenn Sie das jetzt einplanen.
Microsoft Fabric Lakehouse-Architektur: Microsoft Fabric für Analytics und Data Engineering verstehen
Was ist die Lakehouse-Architektur von Microsoft Fabric?
Die Lakehouse-Architektur in Microsoft Fabric ist ein einheitliches Datenplattform-Design, das Elemente von Data Lakes und Data Warehouses kombiniert. Sie speichert Rohdaten sowie strukturierte, transformierte Datensätze an einem einzigen Ort. Dafür nutzt sie Azure Data Lake Storage für die Datenmengen, Fabric-Compute-Engines für die Verarbeitung und Medallion-Architektur-Muster, um Rohdaten sowie angereicherte und kuratierte Ebenen zu verwalten. So können Teams Daten analysieren, Data-Science-Workloads ausführen und Berichte in Power BI bereitstellen, ohne Daten zu duplizieren.
Wie funktioniert die Medallion-Architektur in einem Fabric Lakehouse?
Die Medallion-Architektur in Fabric gliedert Daten in Ebenen, typischerweise Bronze (Rohdaten), Silber (bereinigt und angereichert) und Gold (kuratiert, bereit für Analysen und BI). Fabric stellt Werkzeuge für Dateneingang und Datentransformation bereit, mit denen Sie Daten über die Ebenen hinweg verschieben und transformieren. Das unterstützt Data-Engineering- und Datenaufbereitungs-Workflows, hält eine einzige Kopie Ihrer Daten vor, reduziert Datenduplikate und unterstützt Analysen und Data Science.
Wie implementiere ich ein Lakehouse in Microsoft Fabric und wie erstelle ich eines?
Um ein Lakehouse in Microsoft Fabric zu implementieren, verbinden Sie zunächst Ihre Datenquellen und nehmen Daten mithilfe der Fabric-Funktionen für den Dateneingang in einen Azure Data Lake auf. Wenden Sie anschließend Fabric-Compute-Engines oder Dataflow-Transformationen an, um die Medallion-Architektur umzusetzen. Katalogisieren Sie die Datensätze in OneLake und sichern Sie den Zugriff ab. Binden Sie Power BI und weitere Analysetools für die Berichterstellung ein. Die Plattform vereinfacht das Datenmanagement, unterstützt die Datenintegration von bestehenden Daten und Big Data und ermöglicht es, Daten zu transformieren, ohne sie unnötig zu verschieben.
Worin unterscheidet sich ein Lakehouse von einem klassischen Data Warehouse in Microsoft Fabric?
Ein Lakehouse verbindet die Flexibilität eines Data Lakes für Roh- und semistrukturierte Daten mit der Leistung und dem Schema-Management eines Data Warehouses. In Microsoft Fabric speichert das Lakehouse Daten in Azure Data Lake Storage und bietet dank der Fabric-Compute-Engines eine Abfrageleistung wie in einem Data Warehouse. So stehen Funktionen eines Data Warehouses zur Verfügung, etwa kuratierte, strukturierte Daten für Analysen, während die Flexibilität eines Data Lakes für moderne Daten- und Data-Engineering-Aufgaben erhalten bleibt.
Wie verarbeitet Fabric den Dateneingang und vermeidet Datenduplikate?
Fabric unterstützt mehrere Muster für den Dateneingang – Streaming, Batch und Konnektoren zu Unternehmensdatenquellen – in einen zentralen Lake (Azure Data Lake). Mithilfe der Medallion-Architektur und OneLake fördert Fabric eine einzige Kopie Ihrer Daten sowie logische Datensätze, anstatt physische Kopien anzulegen. Werkzeuge für Datenintegration und Datentransformation ermöglichen es Ihnen, Daten aufzunehmen, direkt an Ort und Stelle zu transformieren und allen Analyse- und Data-Science-Workloads einen einheitlichen Datenzugriff bereitzustellen. So lassen sich Datenduplikate über Systeme hinweg minimieren.
Kann ich bestehende Data Warehouses und Azure-Daten zusammen mit einem Fabric Lakehouse nutzen?
Ja. Fabric lässt sich mit Microsoft- und Drittanbietersystemen integrieren. Sie können Abfragen an bestehende Data Warehouses, Synapse und Azure Data Lake Storage föderieren und so den Zugriff auf Ihre Datenlandschaft bündeln. Sie können vorhandene Daten aufnehmen oder referenzieren, Data-Mesh-Muster umsetzen und je nach Anforderungen an Governance, Kosten und Leistung entscheiden, ob Daten in das Lakehouse verschoben oder direkt darauf zugegriffen werden soll.
Welche typischen Anwendungsfälle gibt es für ein Fabric Lakehouse in Analytics und Data Science?
Typische Anwendungsfälle sind das einheitliche Datenmanagement für BI mit Power BI, die Aufbereitung großer Rohdatensätze für Machine Learning und Data Science, der Aufbau von ELT-Pipelines nach der Medallion-Architektur, die Analyse von Daten über Unternehmenssysteme hinweg sowie ein zentraler Speicherort für strukturierte und unstrukturierte Daten. Fabric vereinfacht die Datenverarbeitung, ermöglicht skalierbare Analysen und unterstützt moderne Datenarchitekturen wie Data Mesh und unternehmensweite Datenkataloge.
Wie funktionieren Sicherheit, Governance und Datenzugriff in einem Fabric Lakehouse?
Fabric bietet rollenbasierte Zugriffssteuerung, Datenrichtlinien sowie die Integration mit Microsoft Purview und Azure Active Directory für Governance und Datenherkunft (Data Lineage). OneLake und Lakehouse-Konstrukte ermöglichen feingranulare Berechtigungen für Daten in Azure Data Lake Storage. So sind sicherer Datenzugriff, Compliance und kontrollierte Datenaufbereitungs-Workflows gewährleistet, bei durchgehender Nachvollziehbarkeit über Dateneingang und Transformationsschritte hinweg.
Welche Fabric-Compute-Engines sollte ich für unterschiedliche Workloads im Lakehouse verwenden?
Fabric bietet mehrere Compute-Engines, die für bestimmte Workloads optimiert sind: interaktive SQL-Abfragen für Analysen und BI, Spark für die Verarbeitung großer Datenmengen und Data Engineering sowie spezialisierte Engines für Echtzeit-Ingestion. Wählen Sie die Fabric-Compute-Engines anhand der Workload-Merkmale aus: Verwenden Sie Spark für umfangreiche Transformationen, Warehouse-SQL für BI-Abfragen und Streaming-Engines für die kontinuierliche Datenaufnahme. So bringen Sie Kosten, Leistung und Anforderungen an die Datenverarbeitung in Einklang.
Wo erfahren Sie mehr über die Lakehouse-Architektur in Microsoft Fabric, und wie starten Sie damit?
Für den Einstieg empfehle ich, die Tutorials auf Microsoft Learn durchzuarbeiten, die Dokumentation zur Lakehouse-Architektur in Microsoft Fabric zu lesen und Beispiele für die Medallion-Architektur in Fabric anzuschauen. Beginnen Sie damit, eine Datenquelle anzubinden, Rohdaten in Azure Data Lake Storage aufzunehmen, eine einfache Medallion-Pipeline umzusetzen und die Ergebnisse in Power BI zu visualisieren. So wird deutlich, wie Fabric das Erstellen eines Lakehouse und die Bereitstellung von Analysen aus einem einheitlichen Datenbestand vereinfacht.