 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
MAI-1 a ekonomia głębokiego rozumowania
By Mirko Peters ·
Kiedy firmy zaczynają badać możliwości sztucznej inteligencji w przedsiębiorstwie, rozmowa niemal od razu sprowadza się do jednego, prostego pytania: Który model jest absolutnie najlepszy?
Automatically translated with AI from the original post. Read the English original
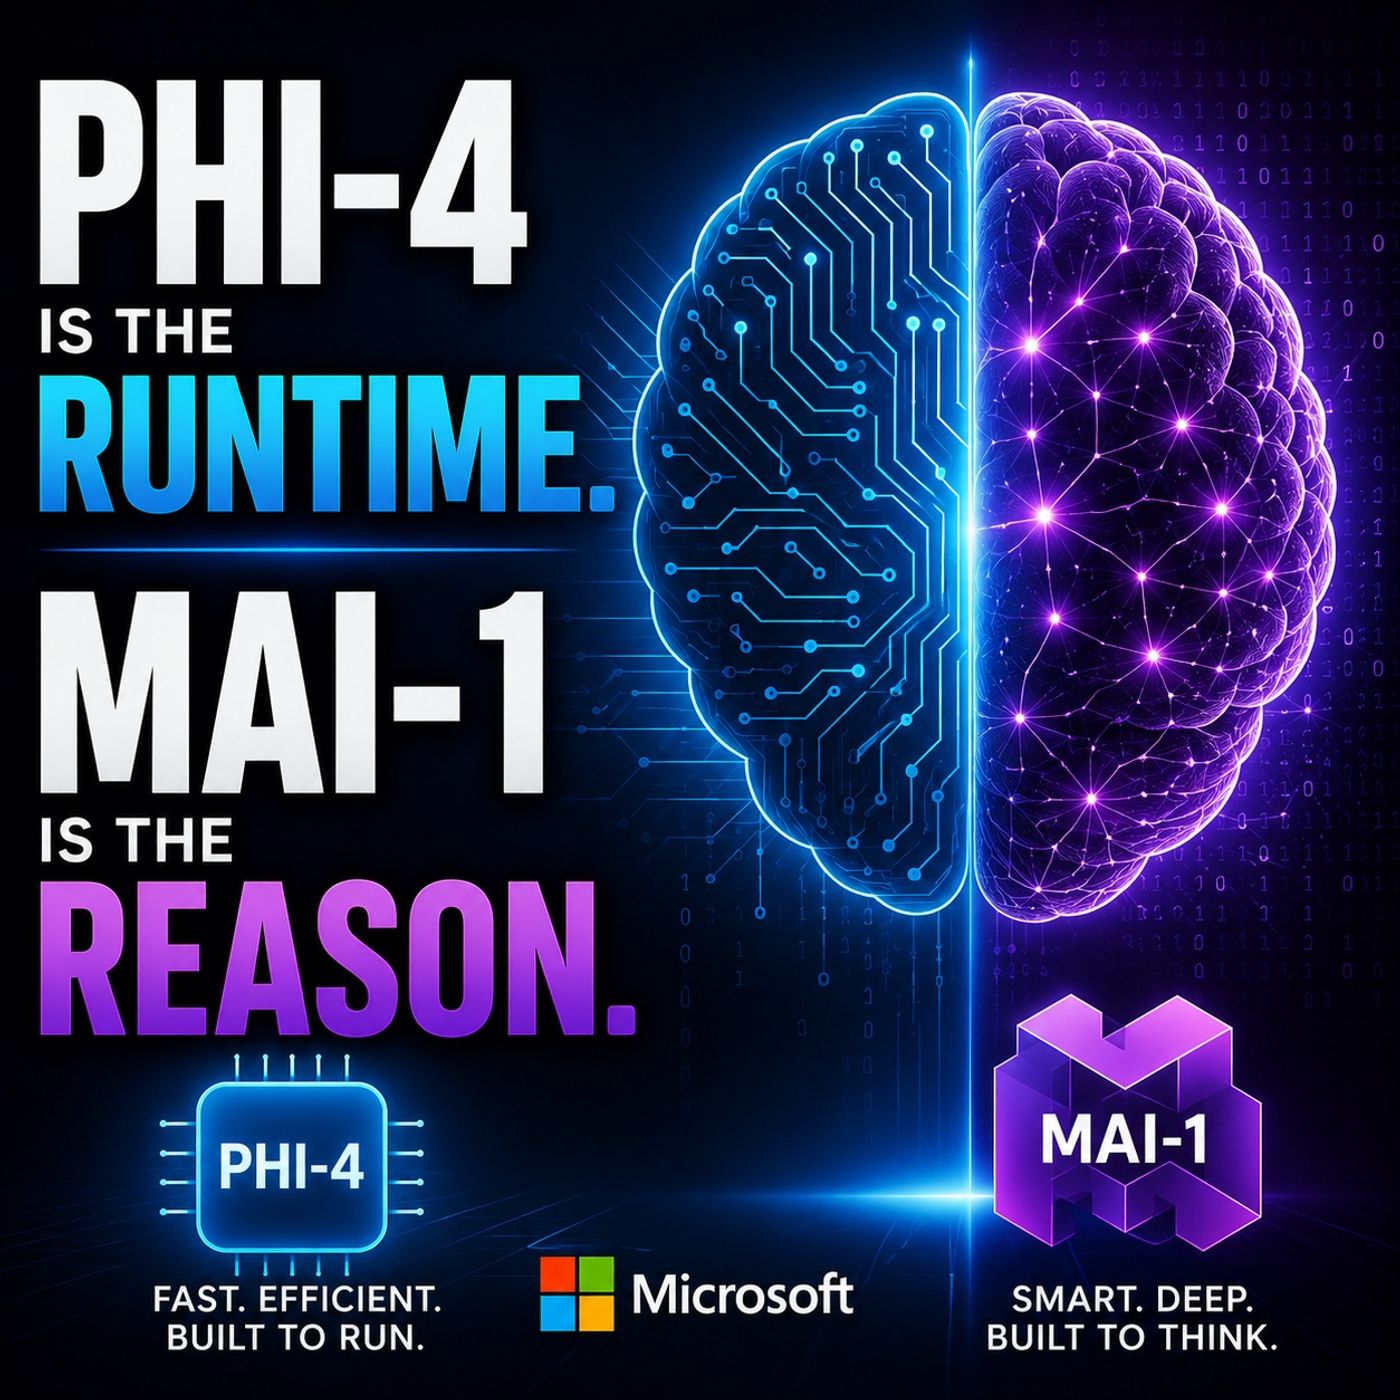
Kiedy firmy zaczynają badać możliwości sztucznej inteligencji w przedsiębiorstwie, rozmowa niemal od razu sprowadza się do jednego, prostego pytania: który model jest absolutnie najlepszy? Skupiamy się na wynikach testów porównawczych, liczymy parametry jak karty kolekcjonerskie i szukamy jednego, flagowego silnika inteligencji, który można podłączyć do każdej aplikacji w organizacji. Wraz z dojrzewaniem strategii wdrożeń ten prosty wybór zaczyna jednak tracić sens. Traktowanie AI jak zawodów, w których zwycięzca bierze wszystko, ignoruje realia działania infrastruktury programowej w praktyce. Tak jak nowoczesne przedsiębiorstwo nigdy nie kierowałoby każdego zadania obliczeniowego na jeden ogromny superkomputer ani nie przechowywało każdego pliku w tej samej warstwie pamięci masowej, tak poleganie na jednym monolitycznym modelu klasy frontier przy każdej interakcji jest finansowo nie do utrzymania i architektonicznie nieefektywne.
Przyszłość AI w przedsiębiorstwach nie leży w znalezieniu jednego uniwersalnego modelu, lecz w zrozumieniu, jak różne klasy inteligencji można łączyć w spójną architekturę. Strategia Microsoftu w tym obszarze stanowi wzorcowy przykład, pokazując wyraźny podział pracy między szybkie, bardzo wydajne modele uruchomieniowe a rozbudowane systemy zdolne do głębokiego rozumowania. Aby ta architektura działała, organizacje muszą wyjść poza samą moc obliczeniową i zacząć oceniać ekonomię swoich obciążeń. Zrozumienie, kiedy problem wymaga siłowego planowania właściwego modelowi frontier, a kiedy można go obsłużyć lekką warstwą uruchomieniową, staje się jednym z najważniejszych wyzwań technicznych i finansowych we współczesnym wytwarzaniu oprogramowania.
Ekonomia AI: rutynowe wykonywanie a głębokie rozumowanie
Architektura modelu bardzo szybko przekształca się w równanie finansowe, gdy firma odchodzi od piaskownicy typu proof of concept na rzecz środowisk produkcyjnych. Na etapie wstępnych eksperymentów różnica kosztów między przetworzeniem zapytania w lekkim modelu lokalnym a wywołaniem dużego modelu rozumowania w chmurze może wydawać się pomijalna. Gdy jednak przeniesiemy tę różnicę na miliony codziennych interakcji użytkowników, zautomatyzowane procesy w tle i przepływy pracy agentów, finansowy wymiar tego wyboru staje się wyraźnie widoczny.
Błąd, który popełnia wiele organizacji, polega na ocenianiu kosztów AI wyłącznie przez pryzmat ceny za token. Tani token ma wartość tylko wtedy, gdy model go przetwarzający rzeczywiście potrafi efektywnie rozwiązać problem. Jeśli złożony, wieloetapowy problem planistyczny skierujesz do małego, taniego modelu, najprawdopodobniej zawiedzie, co wymusi kosztowną interwencję człowieka, ponowne próby lub narastanie błędów. I odwrotnie: jeśli rutynowe zapytanie klasyfikacyjne, na przykład oznaczanie nowego zgłoszenia do działu wsparcia klienta lub wyodrębnianie standardowego pola danych, wyślesz do dużego modelu rozumowania, marnujesz kosztowne zasoby obliczeniowe i zwiększasz opóźnienia bez żadnej korzyści biznesowej.
Oznacza to, że ekonomię AI trzeba rozpatrywać w kontekście złożoności obciążenia. Zapytanie wymagające głębokiego rozumowania często uzasadnia wyższy koszt wnioskowania, ponieważ sam problem biznesowy ma dużą wartość i wymaga starannego osądu. Rutynowe wykonywanie natomiast wymaga dużej liczby operacji i wysokiej szybkości. Dopasowując złożoność obciążenia do odpowiedniego poziomu inteligencji, organizacje mogą budować architektury, które są zarówno funkcjonalnie wydajne, jak i finansowo zrównoważone w długim okresie.
Phi-4 jako wydajna warstwa uruchomieniowa
Aby wesprzeć to warstwowe podejście do inteligencji w przedsiębiorstwie, organizacje potrzebują poziomu modeli poświęconego wyłącznie wykonywaniu zadań. Tą rolę pełni warstwa uruchomieniowa. Runtime znajduje się możliwie blisko miejsca pracy, oferuje niskie opóźnienia, przewidywalne działanie oraz model ekonomiczny, który bez wysiłku skaluje się przy dużej liczbie operacji. W ekosystemie Microsoftu modele takie jak Phi-4 doskonale wypełniają tę operacyjną niszę.
Kompaktowe modele z rodziny Phi-4 zostały zaprojektowane z myślą o wydajności. Oferują sporo możliwości w niezwykle małej formie, dzięki czemu idealnie nadają się do środowisk wbudowanych, lokalnych punktów końcowych oraz przepływów pracy agentów, które opierają się na szybkim wywoływaniu funkcji, a nie na rozwlekłym generowaniu rozmów. Wyobraźmy sobie lokalnego asystenta programisty, który analizuje otwarty plik, agenta zabezpieczeń punktu końcowego klasyfikującego nietypowe zachowanie w sieci albo aplikację kierującą wewnętrzne wywołania API na podstawie danych kontekstowych. Te zadania wymagają prawdziwej inteligencji, ale nie wymagają ogromnego modelu klasy frontier z nieskończonymi oknami kontekstu i wyczerpującymi pętlami planowania.
Co więcej, lokalne wdrażanie kompaktowych modeli daje istotne korzyści, gdy mowa o suwerenności danych i zarządzaniu. Zamiast kierować każdy fragment korporacyjnej telemetrii czy wrażliwy dokument do zdalnej usługi chmurowej, organizacje mogą wykonywać rutynowe zadania bezpośrednio na lokalnym sprzęcie lub w ściśle kontrolowanym obszarze. Rezydencja danych staje się cechą architektury, a nie reaktywnym łataniem zabezpieczeń. Dzięki temu silnie regulowane branże mogą trzymać krytyczne operacje blisko siebie, a infrastrukturę chmurową zarezerwować wyłącznie dla zadań wymagających scentralizowanego, ciężkiego przetwarzania.
MAI-1 jako warstwa zaawansowanego wnioskowania
Podczas gdy warstwa środowiska uruchomieniowego obsługuje szybkie wykonywanie i zadania o dużym wolumenie, nieuchronnie pojawiają się złożone problemy przedsiębiorstw, które przekraczają możliwości kompaktowego modelu. Są to scenariusze, w których system nie może polegać na natychmiastowym dopasowywaniu wzorców, lecz musi ocenić konkurujące ze sobą alternatywy, rozplątać zależności, zaplanować wiele kroków naprzód i zsyntetyzować ogromne ilości różnorodnych informacji. To domena warstwy głębokiego wnioskowania, reprezentowanej przez modele takie jak MAI-1.
Modele wnioskowania zbudowano do sytuacji, w których kolejna właściwa akcja nie jest od razu oczywista. Weźmy pod uwagę złożony przegląd architektury obejmujący kilkadziesiąt wzajemnie zależnych usług chmurowych, dogłębne badanie przyczyny źródłowej w rozległej bazie kodu mikrousług albo strategiczny problem optymalizacji łańcucha dostaw ograniczony sprzecznymi zmiennymi logistycznymi. To nie są proste problemy wykonawcze; wymagają, aby model zachował strukturalną spójność problemu, jednocześnie rozumując nad kaskadowymi konsekwencjami.
Osiągnięcie takiej głębi wymaga ogromnej aktywnej zdolności wnioskowania, zaawansowanych możliwości rozwiązywania problemów wieloetapowych oraz wyrafinowanych procesów trenowania ukierunkowanych na inżynierię oprogramowania i logikę. Ponieważ modele te wykorzystują zaawansowane architektury, takie jak selektywna aktywacja w projektach Mixture-of-Experts, mogą skierować ogromne możliwości na trudne problemy, nie marnując zasobów na błahe. Zbudowano je, by myślały głęboko, ale należy je wywoływać wyłącznie wtedy, gdy złożoność problemu rzeczywiście uzasadnia taką inwestycję.
Routing i orkiestracja: kiedy eskalować
Istnienie zarówno warstwy środowiska uruchomieniowego, jak i warstwy wnioskowania tworzy natychmiastową potrzebę architektoniczną: coś musi decydować, jak żądania przepływają między nimi. Środowisko uruchomieniowe bez mechanizmu routingu do warstwy wnioskowania nieuchronnie napotka barierę, gdy trafi na problem wykraczający poza jego możliwości. Warstwa wnioskowania bez inteligentnego środowiska uruchomieniowego będzie natomiast marnować środki na rutynowe, mało wartościowe zapytania.
To sprawia, że orkiestracja staje się centralnym układem nerwowym nowoczesnej architektury AI. Inteligentna warstwa orkiestracji działa jak kontroler ruchu: ocenia przychodzące podpowiedzi, analizuje ich złożoność strukturalną i decyduje, czy zadanie może zostać szybko rozwiązane przez lokalne środowisko uruchomieniowe, czy trzeba je eskalować do modelu wnioskowania klasy frontier. Jeśli organizacja opanuje tę zdolność routingu, użytkownicy zyskają to, co najlepsze w obu światach: aplikacje będą działać natychmiastowo i responsywnie przy rutynowych interakcjach, a jednocześnie bez wysiłku okażą się potężne, gdy potrzebna jest złożona analiza.
Zbudowanie tej warstwy orkiestracji wymaga solidnej telemetrii, jasnych rubryk klasyfikacji i ciągłego dostrajania samej logiki routingu. Firmy muszą mierzyć nie tylko wydajność modelu, ale również dokładność routingu, czyli upewniać się, że ścieżki eskalacji uruchamiają się niezawodnie wtedy, gdy złożoność tego wymaga, a z drugiej strony, że rutynowe zapytania są konsekwentnie odfiltrowywane z dala od kosztownych silników wnioskowania.
Zrównoważony rozwój finansowy na skali przedsiębiorstwa
Gdy korporacyjne budżety na AI wychodzą z laboratoriów innowacji i trafiają pod nadzór dyrektora finansowego, decyzje architektoniczne podjęte dziś określą, czy inicjatywy AI będą opłacalne jutro. Wdrażanie jednego, drogiego modelu granicznego do każdego przypadku użycia w przedsiębiorstwie to prosta droga do nie do utrzymania rachunków za chmurę i sfrustrowanych interesariuszy.
Prawdziwa zrównoważoność finansowa wynika z dyscypliny architektonicznej. Dzieląc obciążenia na warstwy – kierując powtarzalne zadania o dużej liczbie wywołań do wydajnych środowisk uruchomieniowych, takich jak Phi-4, a głębokie, analityczne myślenie zostawiając zaawansowanym modelom, takim jak MAI-1 – organizacje mogą zoptymalizować całkowity koszt posiadania. Takie warstwowe podejście zamienia AI z nieprzewidywalnego kosztu operacyjnego w przewidywalny, precyzyjnie dostrojony zasób, który przynosi mierzalny zwrot z inwestycji w każdym dziale.
Podsumowanie: projektowanie architektur AI dopasowanych do konkretnych obciążeń
Era traktowania AI jako monolitycznego asystenta szybko dobiega końca. Jak pokazuje strategia Microsoftu, przyszłość należy do architektur opartych na specjalizacji, podziale pracy i inteligentnej orkiestracji. Rozumiejąc odrębne role wydajnych środowisk uruchomieniowych i silników głębokiego rozumowania, organizacje mogą przestać zadawać niewłaściwe pytania o to, który model jest uniwersalnie lepszy, i zacząć budować systemy dopasowane do konkretnych realiów ekonomicznych i technicznych swoich obciążeń.
Aby zgłębić, jak Microsoft kształtuje to dwuwarstwowe podejście i co oznacza ono dla architektury przedsiębiorstwa, koniecznie sprawdź powiązany odcinek podcastu: Phi-4 is the Runtime. MAI-1 is the Reason. Ocenianie strategii AI przez ten pryzmat pomoże zapewnić, że Twoje systemy pozostaną szybkie, skalowalne i finansowo zrównoważone, gdy inteligencja przedsiębiorstw będzie nadal ewoluować.