 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Dlaczego Twój kolejny projekt AI zasługuje na dedykowaną stację roboczą
By Mirko Peters ·
Wykorzystaj pełny potencjał swoich projektów AI dzięki dedykowanej stacji roboczej, która zapewnia optymalną wydajność, efektywność i płynne wykonywanie wielu zadań naraz przy złożonych zadaniach.
Automatically translated with AI from the original post. Read the English original
Uważam, że dedykowana stacja robocza do AI to jedno z najprostszych ulepszeń, jakie można wprowadzić, aby przyspieszyć tworzenie rozwiązań, skrócić czas iteracji i zachować wrażliwe dane lokalnie. Kiedy przenoszę intensywne trenowanie modeli lub wnioskowanie na dużą skalę z chmury na maszynę przeznaczoną do tego celu, zyskuję bardziej przewidywalną wydajność, niższe koszty w dłuższej perspektywie i uproszczone narzędzia.
Wybór odpowiedniej stacji roboczej pozwala mi szybciej prototypować, wiarygodniej odtwarzać wyniki i skupić się na jakości modelu, a nie na zarządzaniu infrastrukturą.
Jak wybierałem te stacje robocze
Skupiłem się na czynnikach, które mają znaczenie, gdy faktycznie uruchamia się projekty AI i wielokrotnie je iteruje: surowej mocy obliczeniowej do trenowania modeli, pojemności pamięci dla dużych partii danych i magazynów osadzeń, szybkiej pamięci masowej NVMe na zbiory danych i punkty kontrolne oraz wysokoprzepustowych operacji wejścia-wyjścia dla potoków danych. Uwzględniłem także zgodność oprogramowania i systemu operacyjnego, konstrukcję termiczną oraz utrzymanie wydajności pod długotrwałym obciążeniem, wymiary fizyczne i przenośność zależnie od zastosowania oraz wsparcie producenta i gwarancję.
Cena i zużycie energii miały wpływ na kompromisy, ponieważ stacja robocza powinna pasować do Twojego przepływu pracy i budżetu w perspektywie wielu miesięcy intensywnego użytkowania.
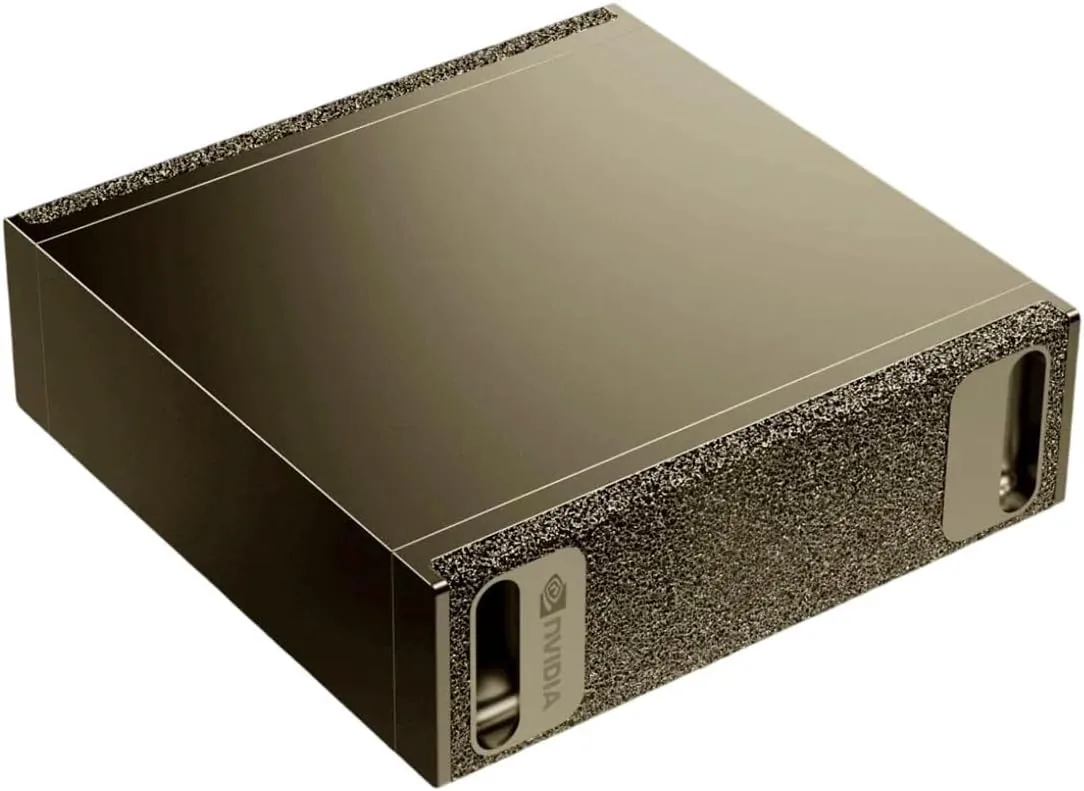
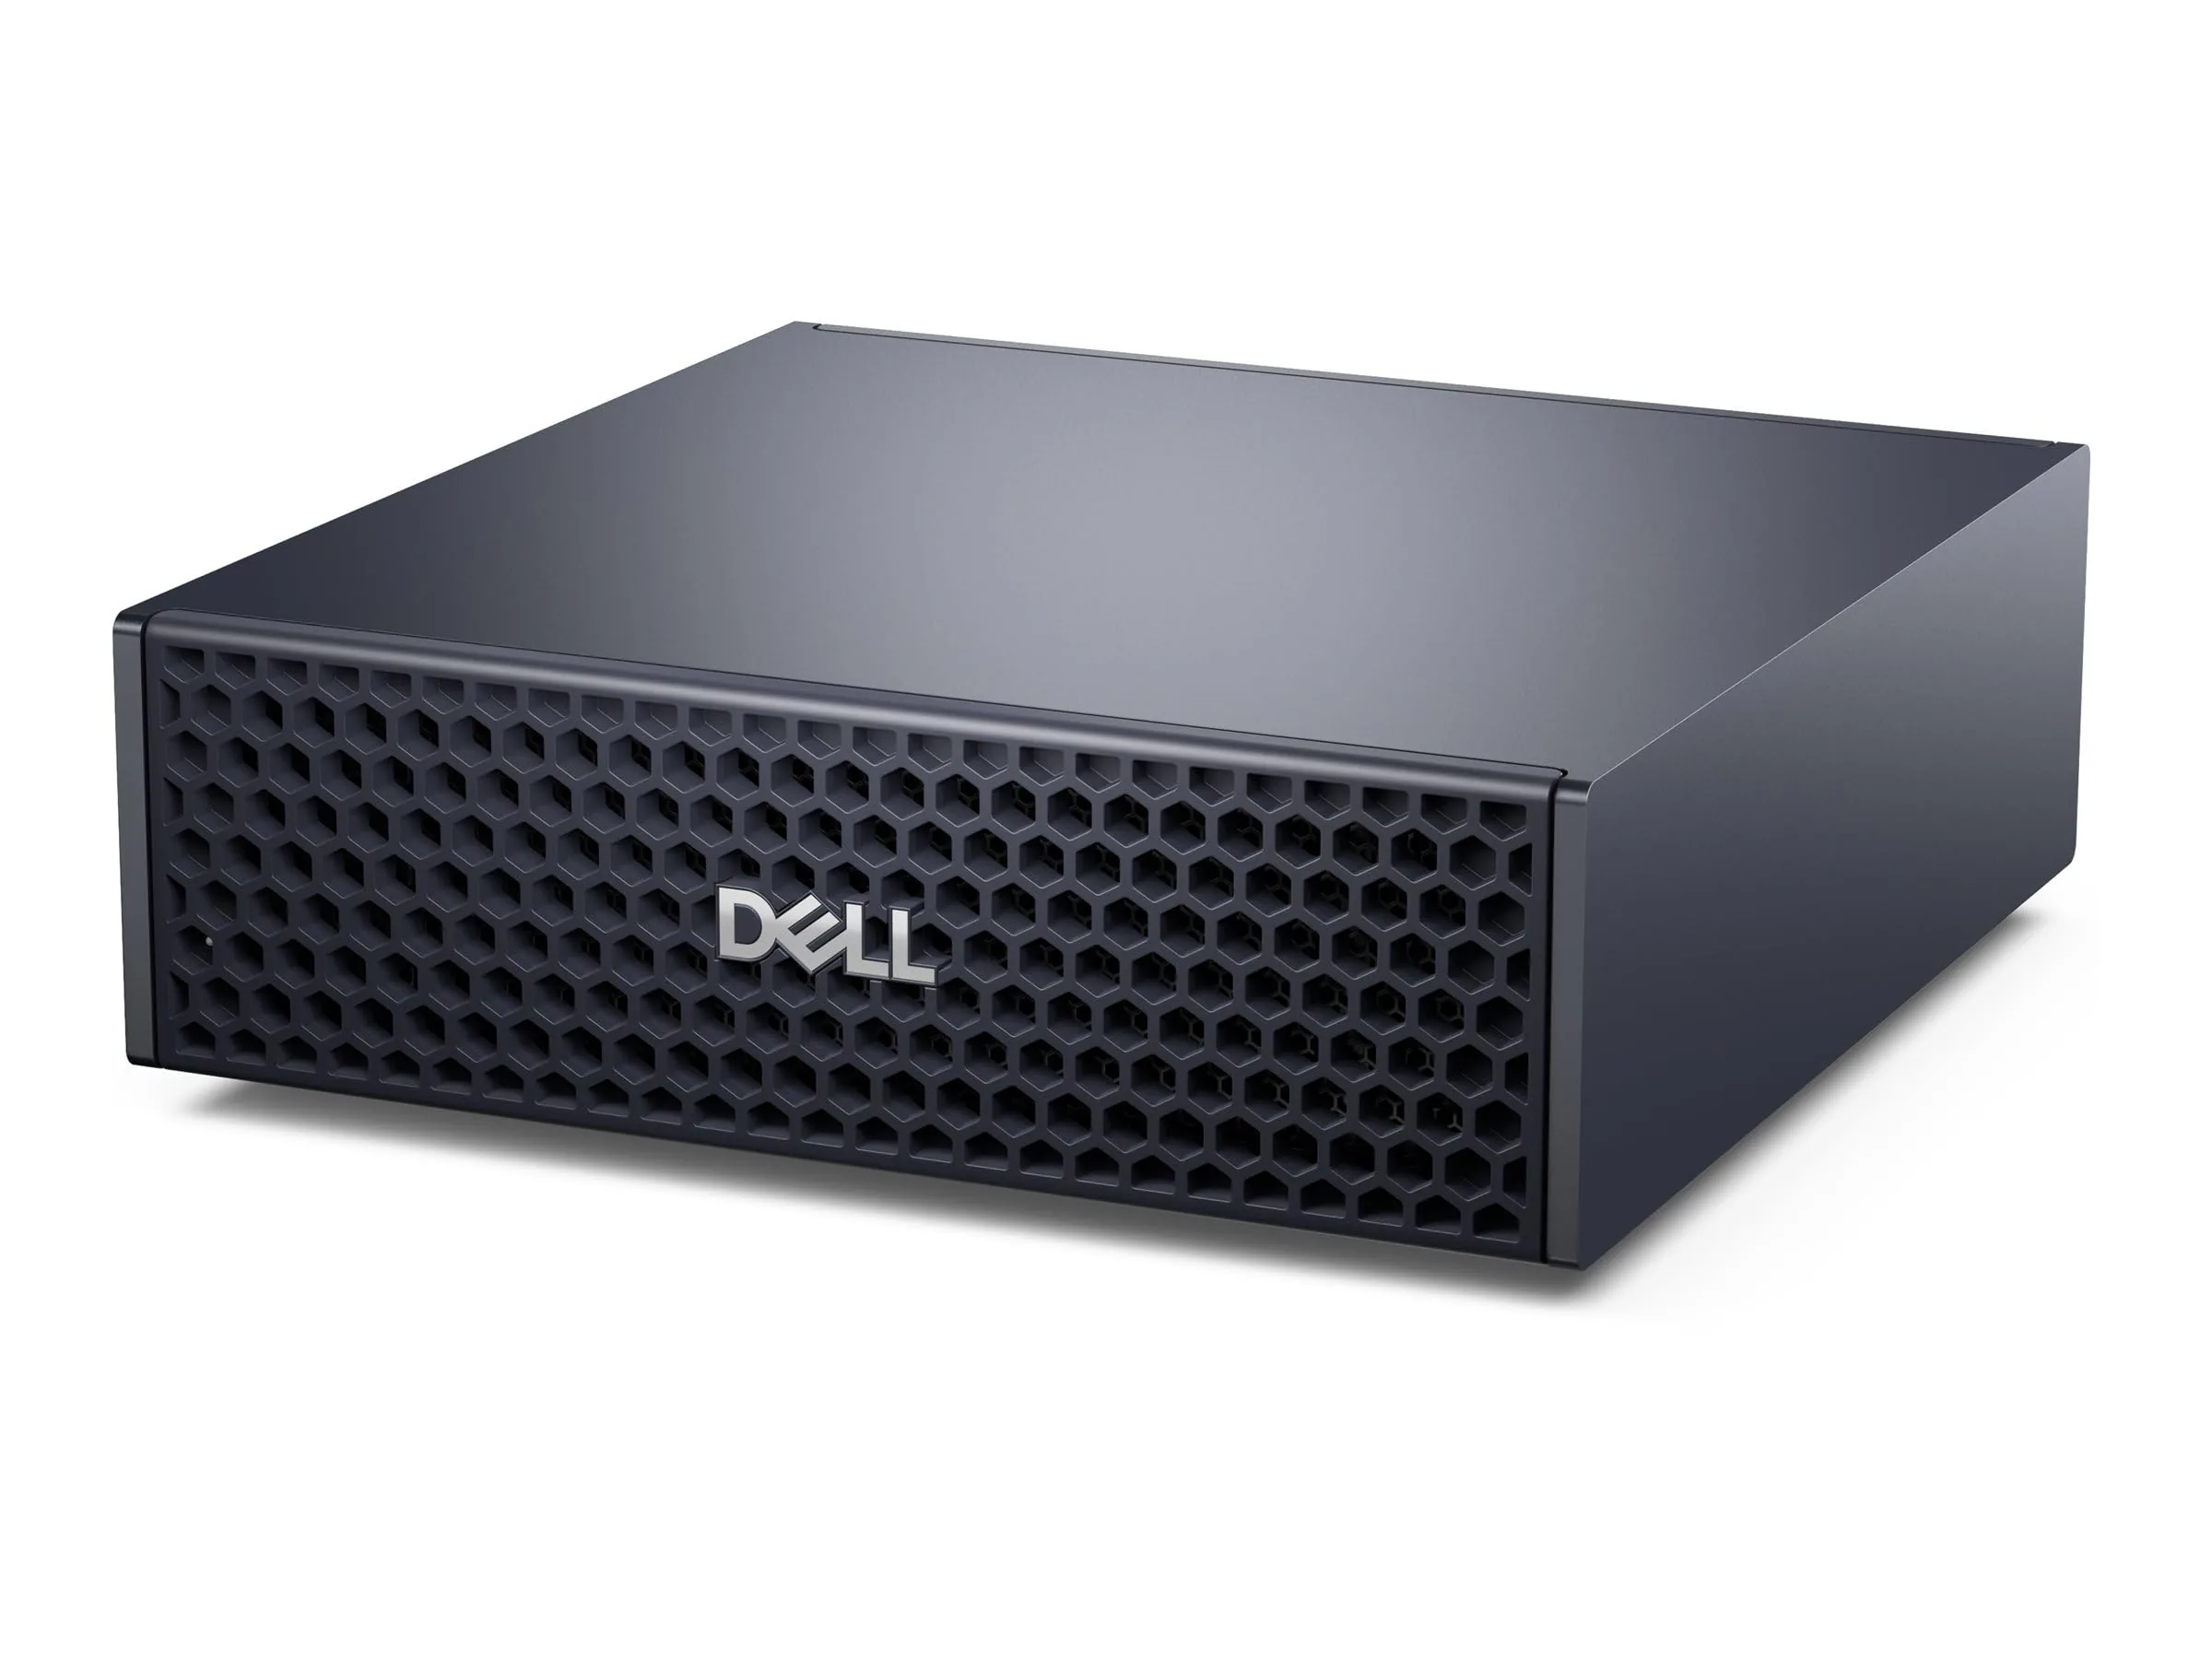
DGX Spark
Osobisty superkomputer biurkowy do AI z superukładem NVIDIA GB10 Grace Blackwell, 128 GB zunifikowanej pamięci, dyskiem SSD NVMe 4 TB i systemem NVIDIA DGX OS w kompaktowej obudowie mini PC.
Traktuję DGX Spark jak niewielkie centrum danych, które mogę trzymać na biurku. Łączy dedykowany stos AI z kompaktowymi wymiarami, dzięki czemu mogę trenować modele, uruchamiać wnioskowanie i iterować lokalnie bez zmagania się z rozproszonym sprzętem. Na co dzień wykorzystuję go do trenowania modeli średniej skali, przygotowywania zbiorów danych i szybkiego eksperymentowania. Przy wyjątkowych okazjach, takich jak prezentacje dla klientów czy warsztaty szkoleniowe, wygodnie jest podłączyć jedno, wydajne urządzenie i mieć przewidywalną wydajność.
Gdybym potrzebował gotowej, wyposażonej w dużo pamięci maszyny, która po prostu działa z popularnymi frameworkami AI, sięgnąłbym właśnie po tę.
Co mówią użytkownicy
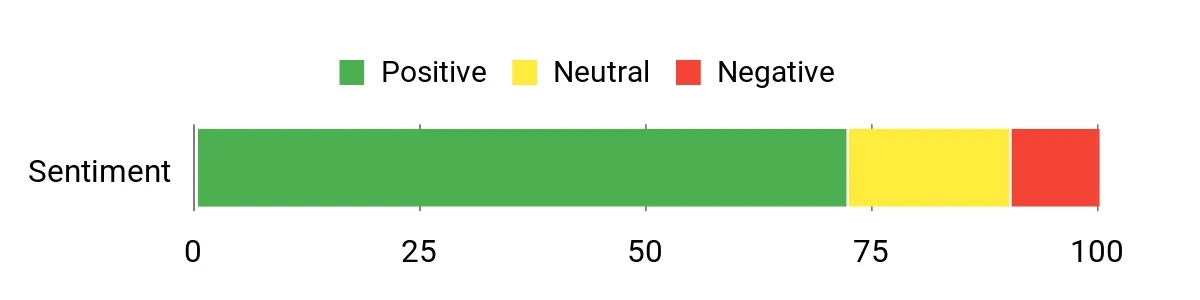
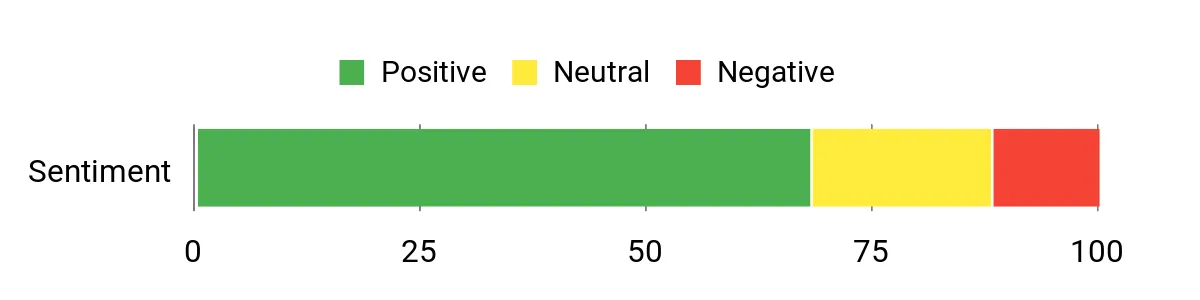
Ludzie najczęściej podkreślają, że surowa moc obliczeniowa i duża pamięć DGX Spark to przełom w lokalnych eksperymentach. Wielu zwraca uwagę, że kompaktowa konstrukcja i zintegrowane oprogramowanie ułatwiają przeniesienie poważnych zasobów obliczeniowych na biurko lub do laboratorium. Niektórzy użytkownicy wspominają też o krzywej uczenia się związanej ze specjalistycznym systemem operacyjnym oraz o optymalnym chłodzeniu przy długotrwałym obciążeniu, jednak ogólny odbiór koncentruje się na wydajności i wygodzie.
Ogólny odbiór: Pozytywny
Długoterminowe oszczędności
Przeniesienie stałych obciążeń związanych z trenowaniem i wnioskowaniem na lokalną stację roboczą, taką jak ta, ogranicza powtarzające się rachunki za obliczenia w chmurze oraz opłaty za transfer danych wychodzących. Uważam, że przewidywalna lokalna pojemność ułatwia planowanie budżetu i pozwala uniknąć nieoczekiwanych miesięcznych kosztów związanych z ciągłym uruchamianiem dużych instancji w chmurze.
Zwrot z inwestycji
Zwrot widać w szybszych cyklach iteracji i mniejszej liczbie zadań w kolejce. Gdy mogę przeprowadzić więcej eksperymentów dziennie bez czekania na zasoby w chmurze, szybciej prototypuję i szybciej docieram do modeli gotowych do produkcji, co przekłada się na zaoszczędzone godziny i szybsze wdrażanie funkcji w projektach.
Korzyści w różnych sytuacjach
Sytuacja | Jak to pomaga |
|---|---|
Laboratorium badawcze | Dzięki dużej zunifikowanej pamięci i szybkiej pamięci masowej mogę równolegle uruchamiać kilka eksperymentów średniej skali, co skraca czas między kolejnymi wersjami modelu. |
Lokalne prototypowanie | Na potrzeby prezentacji dla klientów lub budowy koncepcji dowodowych uzyskuję stabilne wnioskowanie o niskim opóźnieniu i pewność, że modele działają tak samo na moim komputerze, jak w środowiskach lokalnych (on-premises). |
Nauczanie i warsztaty | Studenci i uczestnicy mogą pracować z prawdziwymi modelami lokalnie, dzięki czemu nie muszę zarządzać kontami w chmurze ani limitami dla każdego uczestnika. |
Zespół deweloperski | Kompaktowa stacja robocza stanowi stale dostępny, wspólny zasób zespołu do testowania integracji i iterowania bez rozpraszania pracy na wiele projektów w chmurze. |
Łatwość użycia
Funkcja | Poziom łatwości |
|---|---|
Początkowa konfiguracja | Umiarkowany |
Stos oprogramowania (DGX OS) | Łatwy |
Integracja z frameworkami | Łatwa |
Konserwacja fizyczna | Umiarkowana |
Wszechstronność
Doceniam to, jak DGX Spark sprawdza się w różnych rolach: równie dobrze działa jako stanowisko deweloperskie dla jednego użytkownika, wspólny zasób zespołu lub maszyna demonstracyjna. Obsługuje trenowanie, wnioskowanie i przygotowanie danych, a także może pełnić rolę poligonu testowego przed skalowaniem do większych klastrów.
Innowacyjność
Superchip GB10 Grace Blackwell i spójna zunifikowana architektura pamięci to funkcje, które wyglądają w przyszłość. Podoba mi się, że NVIDIA łączy rdzenie ARM, dedykowaną architekturę AI i obsługę SmartNIC, co ogranicza przenoszenie danych i przyspiesza typowe operacje AI.
Wydajność i szybkość
Dzięki 128 GB zunifikowanej pamięci RAM, 20-rdzeniowemu procesorowi ARM i dyskowi NVMe SSD o pojemności 4 TB urządzenie DGX Spark zapewnia stabilną przepustowość przy średnich i dużych modelach. Platforma została zaprojektowana tak, by minimalizować wąskie gardła we/wy, dzięki czemu więcej czasu poświęcam na eksperymenty, a mniej na czekanie.
Niezawodność
Dyski NVMe SSD z samoszyfrowaniem, kompaktowy system chłodzenia oraz roczna gwarancja sprawiają, że to niezawodny wybór do ciągłej pracy. Zauważyłem, że stabilne sterowniki i system DGX OS ograniczają nieoczekiwane przerwy podczas długich obliczeń.
Najważniejsze zalety
- Duża ilość pamięci i szybka pamięć masowa NVMe dla dużych zbiorów danych i punktów kontrolnych
- Dedykowany system DGX OS i superchip GB10 przyspieszają typowe przepływy pracy AI
- Kompaktowa obudowa stacjonarna, która zmieści się na biurku w laboratorium lub w biurze
- Funkcje sprzętowe, takie jak samoszyfrujące dyski NVMe i SmartNIC, zapewniające bezpieczne, szybkie operacje we/wy
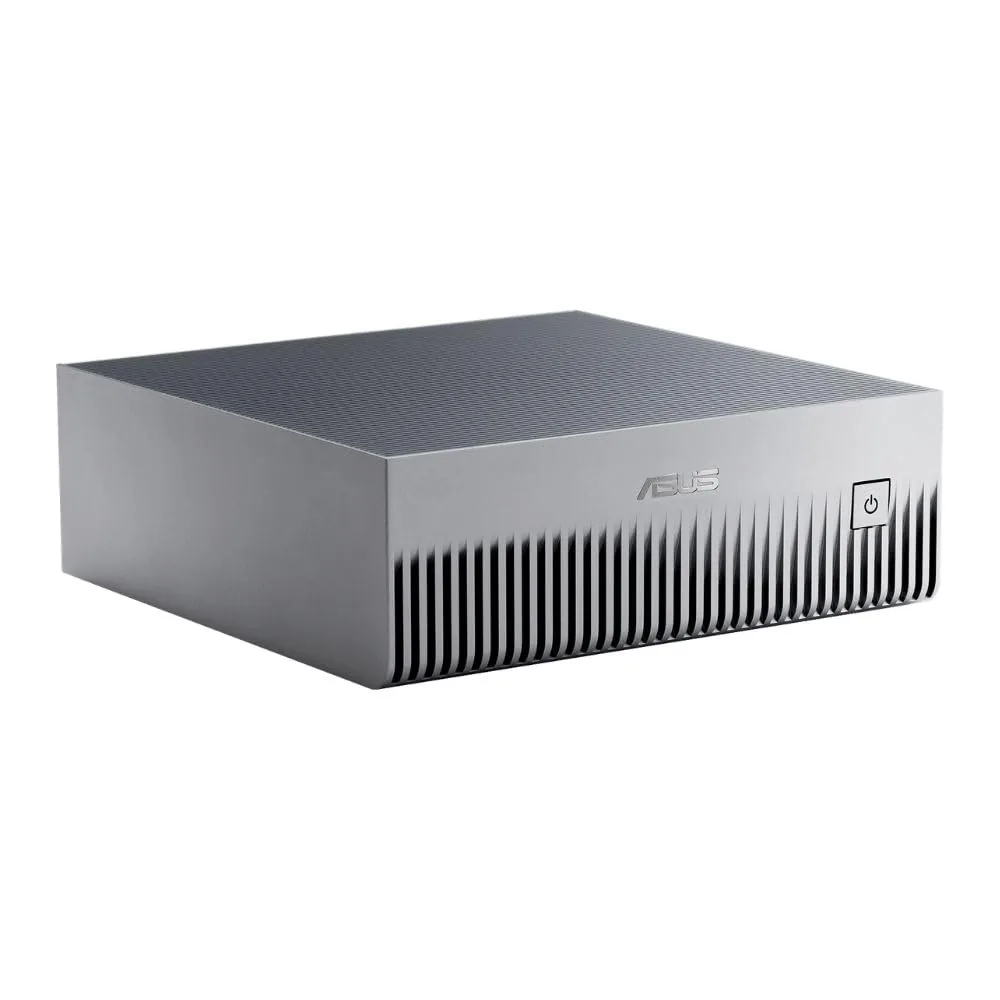
Ascent GX10
ASUS Ascent GX10 to osobisty superkomputer AI oparty na superchipie NVIDIA GB10, obsługujący 128 GB pamięci RAM, dyski NVMe SSD i zgodny z systemami Ubuntu/DGX OS, zamknięty w kompaktowej obudowie stacjonarnej.
Postrzegam Ascent GX10 jako kompaktową maszynę o dużej mocy dla osób, które chcą mieć na biurku moc zbliżoną do petaflopa. Łączy superchip GB10 z dużą ilością pamięci RAM i dyskiem NVMe, dzięki czemu mogę trenować duże modele, iterować prototypy i uruchamiać wnioskowanie o niskim opóźnieniu bez ciągłego żonglowania zasobami w chmurze.
Na co dzień używam go do rozwijania modeli, przygotowywania zbiorów danych i szybkich eksperymentów; podczas demonstracji czy warsztatów jest to niezawodne, samodzielne urządzenie, które ułatwia udostępnianie wyników. Dla zespołów, które chcą wysokiej przepustowości na niewielkiej powierzchni, to praktyczny wybór, który polecam wypróbować.
Co mówią użytkownicy
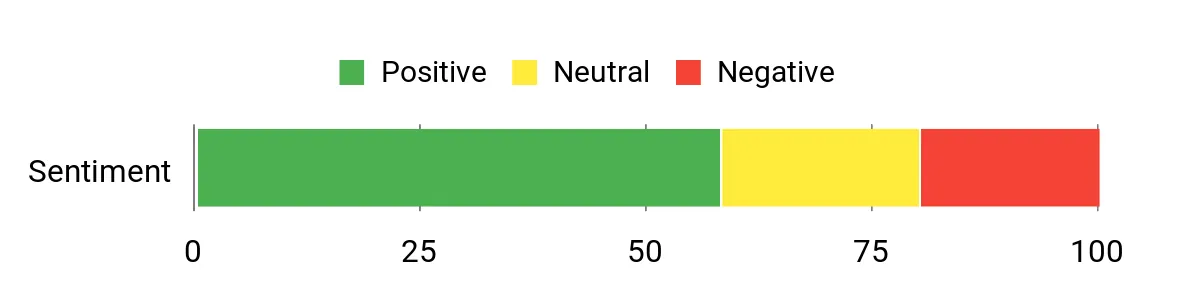
Użytkownicy często chwalą dużą gęstość mocy obliczeniowej GX10 i to, ile możliwości zmieściło się w niewielkiej obudowie. Wielu wskazuje na łatwość integracji znanych frameworków i wygodę szybkiej pamięci NVMe, a inni zwracają uwagę, że hałas chłodzenia i pewne trudności przy pierwszej konfiguracji warto uwzględnić z góry.
Ogólne wrażenie jest takie, że po krótkim okresie nauki urządzenie zapewnia poważną wydajność lokalną.
Ogólny wydźwięk: neutralny
Długoterminowe oszczędności
Prowadzenie stałego rozwoju i testów na lokalnej maszynie, takiej jak ta, ogranicza powtarzające się wykorzystanie mocy obliczeniowej w chmurze oraz koszty transferu danych wychodzących. Uważam, że przewidywalna lokalna pojemność pomaga kontrolować bieżące wydatki na infrastrukturę i upraszcza planowanie budżetu przy długotrwałych projektach.
Zwrot z inwestycji
Zwrot z inwestycji widać w szybszych cyklach eksperymentów i mniejszej liczbie opóźnień związanych z oczekiwaniem na instancje w chmurze. Gdy mogę prototypować i weryfikować modele lokalnie, szybciej wdrażam zmiany na produkcję i unikam czasu straconego na udostępnianie zasobów w chmurze oraz wąskie gardła związane z transferem danych.
Korzyści zależne od sytuacji
Sytuacja | Jak to pomaga |
|---|---|
Laboratorium badawcze | Duża gęstość mocy obliczeniowej pozwala mi lokalnie uruchamiać większe eksperymenty, skracając cykle iteracji przy dostrajaniu modeli. |
Prototypy dla klientów | Mogę osobiście demonstrować modele wymagające dużych zasobów, bez polegania na dostępie do internetu czy poświadczeniach chmurowych. |
Testy na brzegu sieci | Kompaktowa obudowa ułatwia testowanie scenariuszy wdrożeniowych, które odwzorowują ograniczenia sprzętu używanego w terenie. |
Zajęcia dydaktyczne | Studenci mają praktyczny dostęp do prawdziwych modeli bez zakładania indywidualnych kont w chmurze i bez napotykania limitów przydziałów. |
Łatwość użycia
Funkcja | Poziom łatwości |
|---|---|
Wstępna konfiguracja | Umiarkowany |
System operacyjny | Umiarkowany |
Integracja z frameworkami | Łatwy |
Konserwacja fizyczna | Umiarkowany |
Wszechstronność
GX10 dobrze sprawdza się w pracy solo, we współdzielonym użytkowaniu w małych zespołach i w środowiskach demonstracyjnych. Niezawodnie obsługuje trenowanie, wnioskowanie i przygotowanie danych, dzięki czemu mogę przechodzić między przepływami pracy bez przekładania sprzętu.
Innowacyjność
Umieszczenie superchipa GB10 w kompaktowej obudowie stacjonarnej, z podstawkami umożliwiającymi układanie w stos i nowoczesnymi portami we/wy, to mądry krok w stronę dostępnej, zaawansowanej AI. Doceniam, że ASUS postawił na gęstość i praktyczne funkcje, takie jak obsługa SmartNIC ConnectX‑7.
Wydajność i szybkość
Dzięki procesorowi GB10, dużym zasobom pamięci RAM i pamięci masowej NVMe połączonej przez PCIe, GX10 zapewnia szybkie ładowanie danych i stabilną moc obliczeniową przy średnich i dużych modelach. Podczas długich przebiegów zauważam mniej przestojów związanych z operacjami wejścia-wyjścia niż w starszych konfiguracjach.
Niezawodność
Jakość wykonania, konstrukcja chłodzenia i gwarancja producenta sprawiają, że jest to niezawodne narzędzie pracy na co dzień podczas programowania. Traktuję go jako węzeł zawsze dostępny, który ogranicza przerwy podczas długich eksperymentów.
Najważniejsze korzyści
- Wysoka wydajność pojedynczego węzła dzięki superukładowi GB10 i obsłudze 128 GB pamięci
- Kompaktowa obudowa stacjonarna, łatwa do umieszczenia w laboratorium lub biurze
- Pamięć NVMe i nowoczesne wejście-wyjście zapewniające szybki dostęp do zbiorów danych i punktów kontrolnych
- Zgodność z systemami Ubuntu i DGX OS upraszcza typowe konfiguracje frameworków AI
Alienware 18
18-calowy laptop o wysokiej wydajności z procesorem Intel Ultra 9, kartą graficzną NVIDIA GeForce RTX 5080, do 64 GB pamięci DDR5 i dyskiem SSD o pojemności do 4 TB, system Windows 11 Pro oraz klawiatura z podświetleniem RGB AlienFX dla każdego klawisza.
Traktuję Alienware 18 jako mobilną maszynę o ogromnej mocy, która zaciera granicę między zestawem do gier a przenośną stacją roboczą. Oferuje wydajność procesora i karty graficznej na poziomie komputera stacjonarnego w obudowie laptopa, dzięki czemu mogę trenować modele, uruchamiać wnioskowanie lokalnie, a jednocześnie grać lub prezentować treści o bogatej oprawie wizualnej.
Na co dzień wykorzystuję go do ciężkich zadań programistycznych, walidacji modeli i pracy wielozadaniowej; w podróży lub na spotkaniach z klientami to urządzenie, które zabieram, gdy potrzebuję poważnej mocy obliczeniowej bez pełnego zestawu stacjonarnego. Jeśli potrzebujesz najwyższej klasy wydajności mobilnej i świetnego ekranu, to prosty wybór.
Co mówią użytkownicy
Użytkownicy często podkreślają surową wydajność laptopa i wciągający ekran jako wyróżniające cechy. Wielu docenia, że obsługuje wymagające obciążenia płynnie i radzi sobie z wielozadaniowością bez zacięć, a inni wskazują masę urządzenia i hałas wentylatorów jako praktyczne kompromisy podczas przenoszenia.
Ogólnie opinie koncentrują się na mocy, jakości ekranu i wygodzie posiadania jednego, przenośnego urządzenia do poważnej pracy.
Ogólny odbiór: Pozytywny
Oszczędności w dłuższej perspektywie
Korzystanie z jednego wydajnego laptopa może ograniczyć potrzebę osobnego sprzętu stacjonarnego oraz stałego czasu w chmurze na potrzeby programowania i demonstracji. Uważam, że skonsolidowanie moich procesów pracy na jednym wydajnym urządzeniu upraszcza narzędzia, eliminuje cykliczne transfery do chmury i może zmniejszyć koszty ogólne w krótkoterminowych projektach lub w zespołach pracujących w podróży.
Zwrot z inwestycji
Zwrot z inwestycji przejawia się w mniejszym przełączaniu kontekstu i szybszym dostarczaniu rezultatów. Gdy mogę kompilować kod, trenować mniejsze modele i weryfikować wyniki na tym samym urządzeniu, którego używam do demonstracji i programowania, iteruję szybciej i unikam opóźnień wynikających z udostępniania zdalnych instancji.
Korzyści w konkretnych sytuacjach
Sytuacja | Jak to pomaga |
|---|---|
Demonstracje na miejscu | Mogę uruchamiać złożone demonstracje lokalnie, bez polegania na łączności internetowej lub zdalnych serwerach, dzięki czemu prezentacje są niezawodne i responsywne. |
Programowanie w podróży | Gdy jestem poza biurkiem, laptop zapewnia wydajność zbliżoną do komputera stacjonarnego, więc nie tracę tempa podczas eksperymentów i debugowania. |
Zróżnicowane obciążenia | Przełączanie się między trenowaniem modeli, wizualizacją a tworzeniem treści jest płynniejsze dzięki dużej ilości pamięci RAM i szybkiej pamięci masowej. |
Demo i rozrywka | Mogę wizualnie weryfikować wyniki modeli, a także odprężyć się, grając lub oglądając media na tym samym wydajnym ekranie. |
Łatwość użytkowania
Funkcja | Poziom łatwości |
|---|---|
Konfiguracja początkowa | Łatwa |
Zgodność oprogramowania | Łatwa |
Przenośność | Umiarkowana |
Zarządzanie temperaturą | Umiarkowana |
Wszechstronność
Podoba mi się, że Alienware 18 świetnie sprawdza się w różnych procesach pracy: programowaniu, testowaniu modeli, wizualizacji i grach. To jedno urządzenie, na którym mogę polegać, czy siedzę przy biurku, podróżuję, czy prezentuję wyniki interesariuszom.
Innowacyjność
Funkcje takie jak akcelerowany przez AI układ NPU, obsługa DLSS 4 i zaawansowana łączność pokazują, jak laptopy dla konsumentów przejmują profesjonalne możliwości, które pomagają zarówno twórcom, jak i programistom.
Wydajność i szybkość
Dzięki wielordzeniowemu procesorowi Intel Ultra 9 i karcie graficznej RTX 5080 laptop zapewnia wysoką wydajność pojedynczego węzła przy trenowaniu mniejszych modeli oraz błyskawiczną szybkość wnioskowania i zadań wizualnych, a ekran o wysokiej częstotliwości odświeżania sprawia, że interakcje wydają się natychmiastowe.
Niezawodność
Solidna konstrukcja, wydajne systemy chłodzenia i zaktualizowane sterowniki sprawiają, że to niezawodny koń roboczy do intensywnej pracy, choć planuję krótsze sesje bez podłączenia do zasilania, ze względu na typowe ograniczenia baterii w tej klasie wydajności.
Najważniejsze korzyści
- Wydajność procesora CPU i karty GPU na poziomie stacji roboczych w przenośnej obudowie
- Duży, szybko odświeżający się ekran 18 cali, idealny do wizualnego debugowania i analizy modeli
- Duża pojemność pamięci i pamięci masowej do obsługi rozbudowanych zbiorów danych i pracy wielozadaniowej
- Nowoczesna łączność, np. Thunderbolt 5 i Wi‑Fi 7, zapewniająca szybkie operacje wejścia/wyjścia i transfery
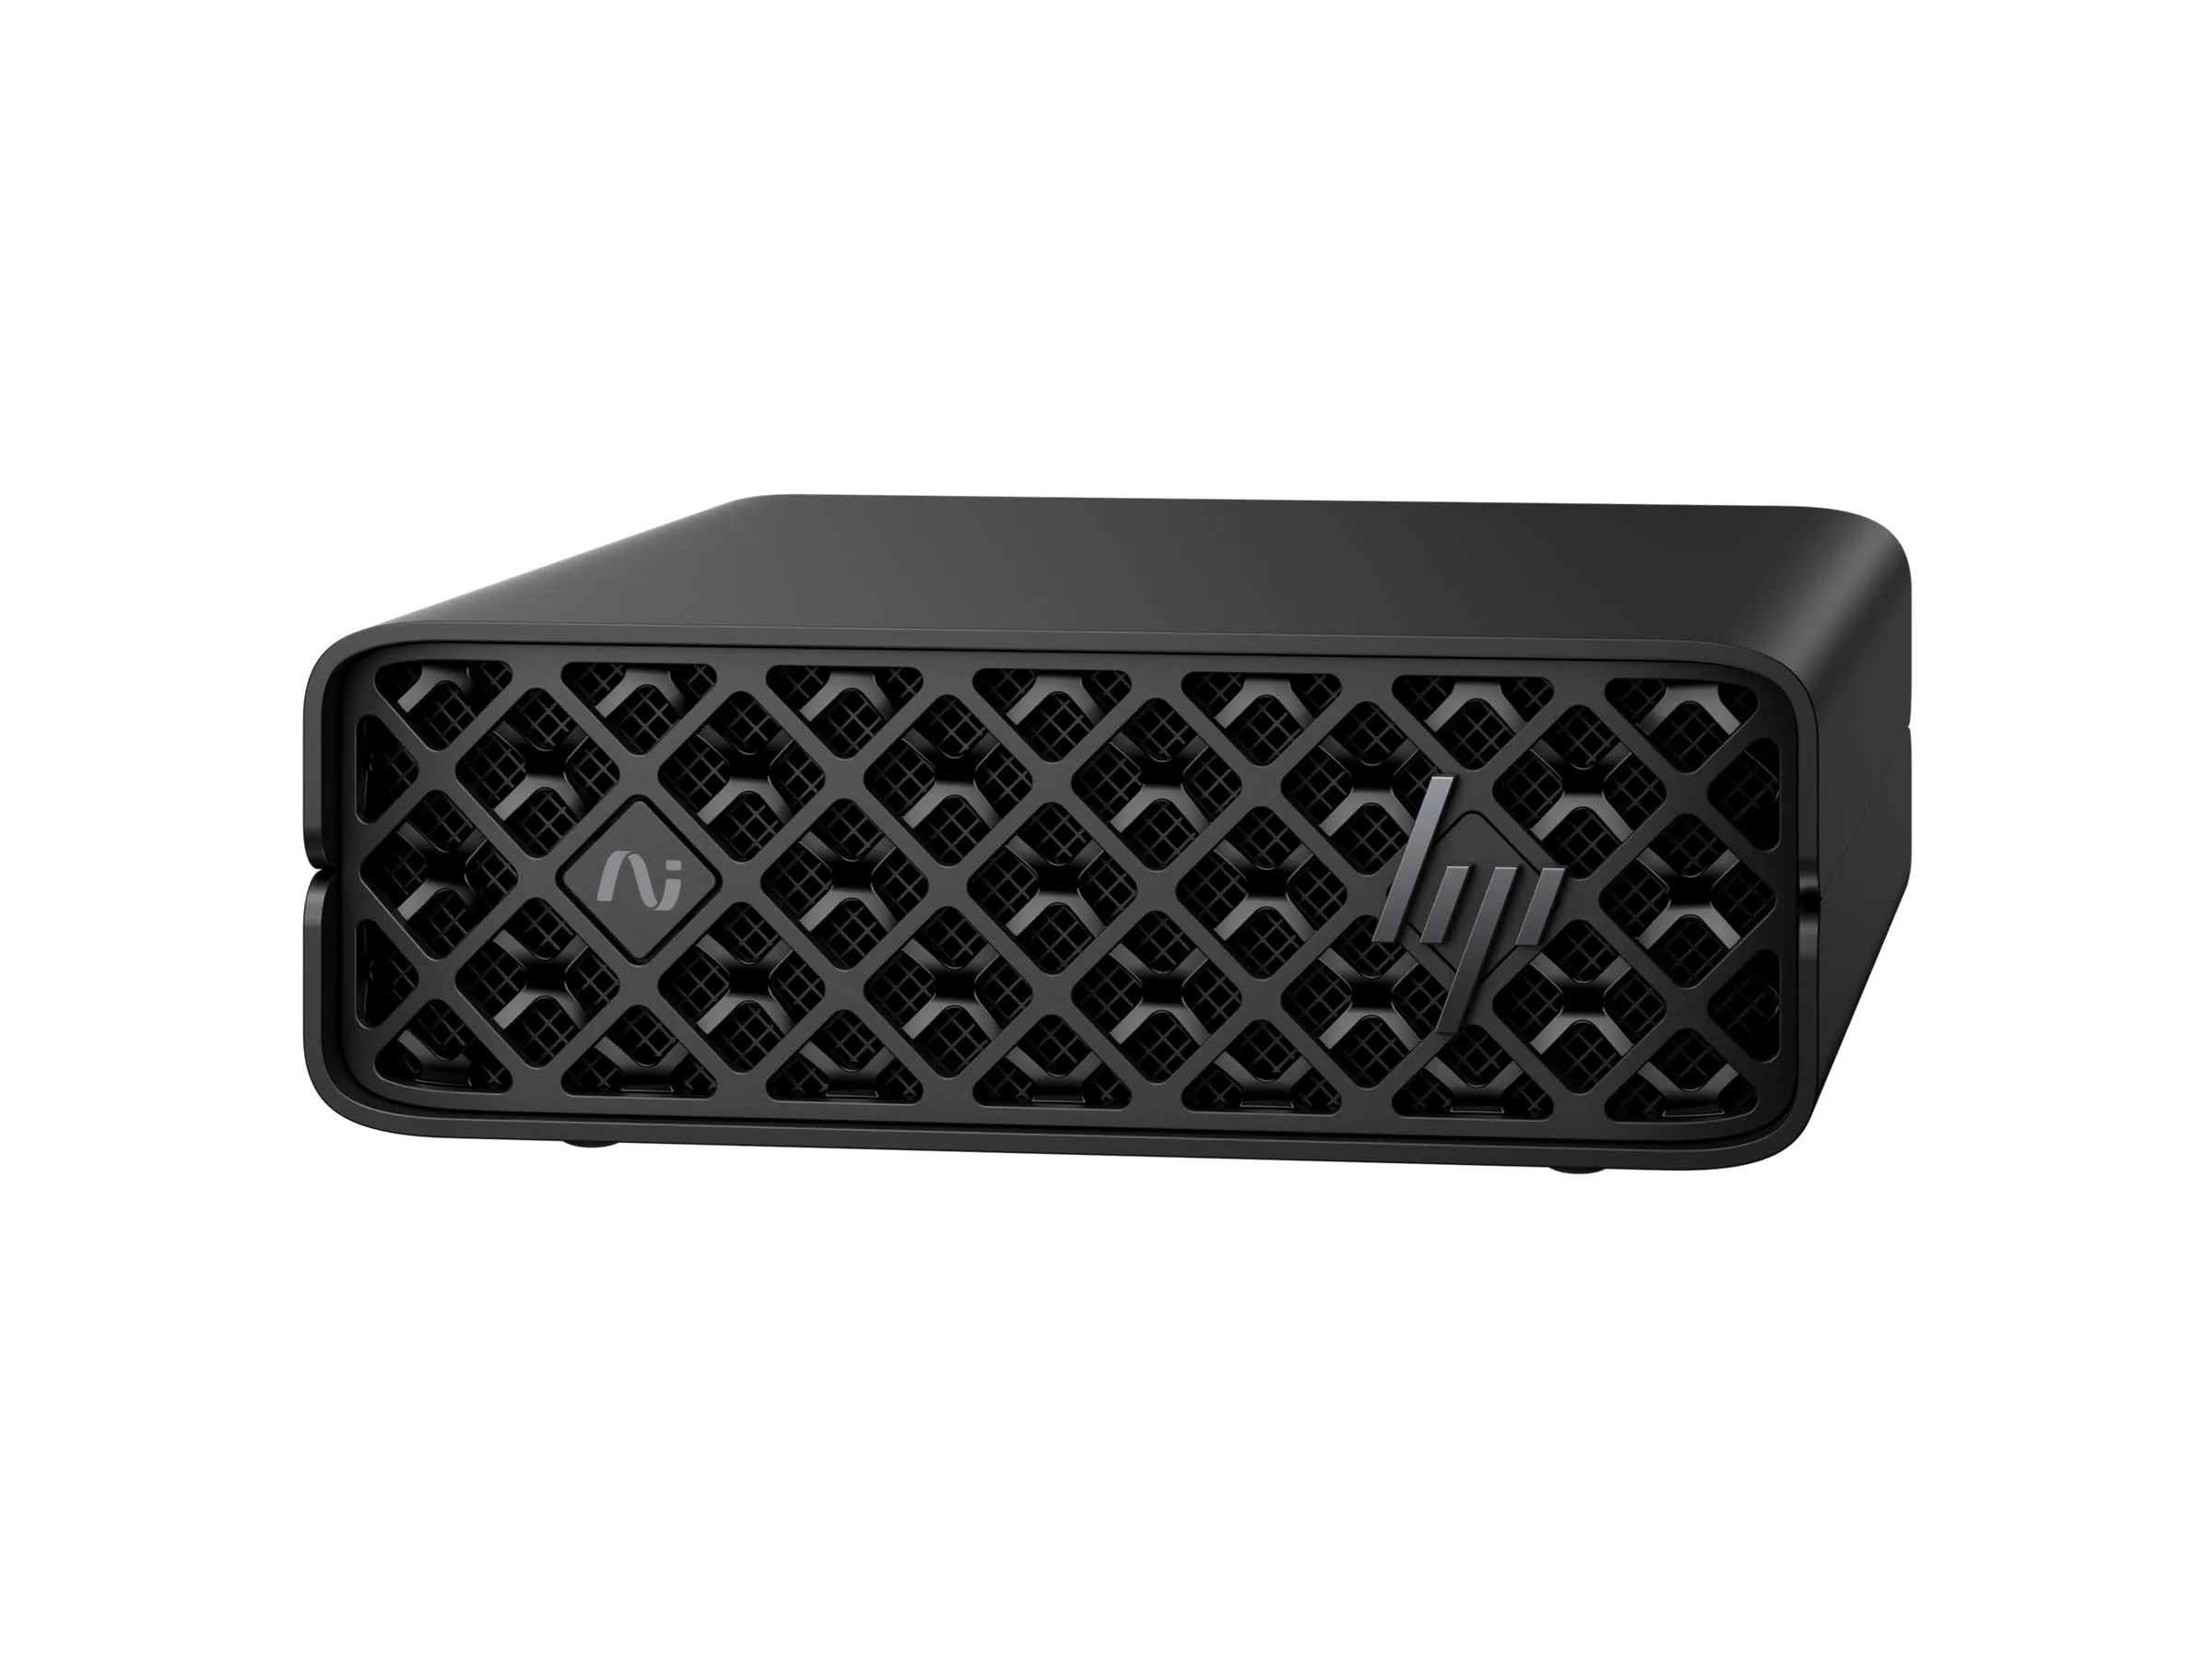
ZGX Nano
HP ZGX Nano G1n to mini stacja AI z superukładem GB10 Grace Blackwell, 128 GB pamięci LPDDR5X, dyskiem SSD NVMe 2 TB, Wi‑Fi 7 i systemem bazowym NVIDIA DGX Base OS, zamknięte w kompaktowej obudowie mini PC.
Traktuję ZGX Nano jako maszynę, po którą sięgam, gdy potrzebuję poważnych możliwości AI bez pełnej szafy serwerowej. Łączy superukład GB10, dużą pamięć LPDDR5X i szybką pamięć NVMe w obudowie wielkości dłoni, dzięki czemu mogę rozwijać modele, uruchamiać wnioskowanie i testować wdrożenia, siedząc przy małym biurku.
Na co dzień wykorzystuję go do przygotowywania zbiorów danych, iteracji modeli i testów w stylu brzegowym (edge), tam gdzie brakuje miejsca lub zasilania. Na warsztaty lub prezentacje na miejscu jest łatwy w transporcie i zapewnia przewidywalną wydajność lokalną, odzwierciedlającą większe systemy lokalne (on-prem).
Co mówią użytkownicy
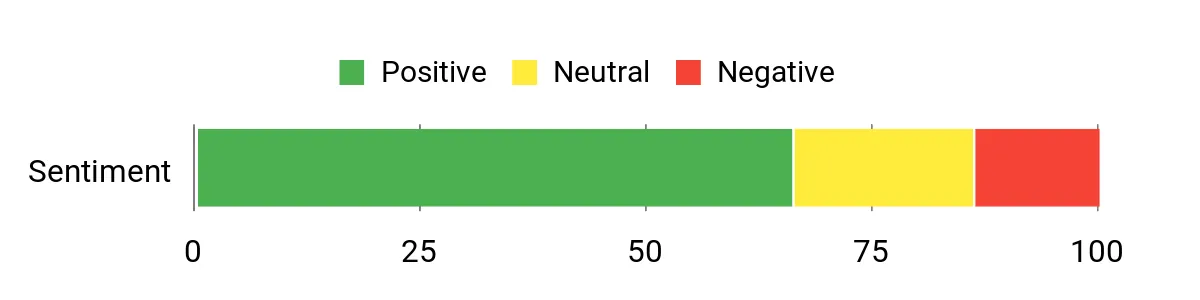
Użytkownicy często chwalą Nano za to, że mieści imponującą moc obliczeniową w małym pudełku oraz za szybką pamięć i pamięć masową. Wielu zwraca uwagę, że opcje sieciowe i obsługa nowoczesnych standardów Wi‑Fi ułatwiają przesyłanie danych, a kilku wspomina, że konfiguracja i strojenie chłodzenia to kwestie, o których trzeba pamiętać. Ogólnie panuje zgodna opinia, że urządzenie oferuje zaskakującą moc jak na swoje rozmiary.
Ogólne nastawienie: Pozytywne
Oszczędności długoterminowe
Prowadzenie stałego rozwoju i testów lokalnie, na kompaktowej stacji roboczej, ogranicza powtarzalne wykorzystanie instancji w chmurze oraz opłaty za transfer danych wychodzących (egress). Uważam, że przewidywalna pojemność lokalna pomaga kontrolować bieżące wydatki na infrastrukturę i unika niespodzianek związanych ze zmiennymi rachunkami za chmurę.
Zwrot z inwestycji (ROI)
ROI przejawia się w szybszych cyklach eksperymentów i mniejszym czasie traconym na przygotowywanie zasobów. Gdy mogę weryfikować modele i uruchamiać demonstracje lokalnie, ograniczam opóźnienia iteracji i szybciej przechodzę od prototypu do testów produkcyjnych.
Korzyści w konkretnych sytuacjach
Sytuacja | Jak to pomaga |
|---|---|
Prototypowanie brzegowe (edge) | Niewielkie rozmiary pozwalają odtworzyć ograniczone środowiska i testować scenariusze wdrożeń w warunkach zbliżonych do rzeczywistego sprzętu. |
Zajęcia lub warsztaty | Mogę zapewnić praktyczny dostęp do modeli bez zarządzania wieloma kontami w chmurze ani przepustowością dla każdego uczestnika. |
Zdalne prezentacje | Na prezentacje dla klientów zabieram ze sobą stabilną moc obliczeniową działającą lokalnie, dzięki czemu nie zależę od niestabilnej sieci. |
Mały węzeł zespołu | Kompaktowy węzeł daje zespołowi wspólny zasób do szybkich eksperymentów i testów integracyjnych bez uruchamiania zdalnych instancji. |
Łatwość użycia
Funkcja | Poziom łatwości |
|---|---|
Wstępna konfiguracja | Umiarkowany |
System operacyjny i frameworki | Łatwy |
Konfiguracja sieci | Umiarkowany |
Obsługa fizyczna | Łatwy |
Wszechstronność
ZGX Nano sprawdza się jako stacja dla pojedynczego dewelopera, wspólny węzeł testowy lub urządzenie demonstracyjne. Obsługuje zadania treningu, wnioskowania i przygotowania danych przy minimalnym zapotrzebowaniu na miejsce, dzięki czemu mogę przełączać się między procesami bez żonglowania sprzętem.
Innowacyjność
Połączenie superukładu GB10, szybkiej pamięci LPDDR5X oraz łączności multi‑GbE i Wi‑Fi 7 w mini obudowie pokazuje wyraźny kierunek: przenoszenie funkcji klasy centrów danych na biurko.
Wydajność i szybkość
Dzięki 20-rdzeniowemu układowi GB10, 128 GB pamięci LPDDR5X i dyskowi NVMe 2 TB Nano minimalizuje wąskie gardła we/wy i pamięci w wielu obciążeniach realizowanych na jednym węźle. Podczas testów zauważyłem płynny dostęp do zbiorów danych i stabilne opóźnienia wnioskowania.
Niezawodność
Zbudowany na nowoczesnej pamięci NVMe i opcjach sieciowych klasy przedsiębiorstwowej, Nano sprawdza się jako niezawodny lokalny węzeł do pracy ciągłej. Traktuję go jako zawsze dostępne środowisko testowe, które ogranicza niespodzianki podczas dłuższych przebiegów.
Najważniejsze korzyści
- Bardzo kompaktowa obudowa, która mimo to obsługuje dużą pamięć i szybką pamięć NVMe
- Superukład GB10 z 20 rdzeniami zapewniający solidną przepustowość AI na jednym węźle
- Nowoczesna łączność, w tym Wi‑Fi 7 i opcje multi‑GbE, zapewniająca szybki transfer danych
- Zgodność z systemem bazowym Linux/DGX ułatwiająca konfigurację frameworków
Często zadawane pytania
Czy potrzebuję dedykowanej stacji roboczej?
Sięgam po dedykowaną stację roboczą, gdy uruchamiam częste zadania trenowania, szybko iteruję modele albo przetwarzam wrażliwe dane, których nie chcę wypuszczać poza moją sieć. Lokalna maszyna zapewnia mi stabilną wydajność i niższe opóźnienia podczas eksperymentów, a jest szczególnie przydatna przy demonstracjach, warsztatach i powtarzalnych badaniach.
Często łączę stację roboczą z sporadycznym przenoszeniem obciążeń do chmury, dzięki czemu mam to, co najlepsze w obu rozwiązaniach.
Jak stacja robocza wypada w porównaniu z chmurą?
Przy krótkich, przewidywalnych obciążeniach i pracy interaktywnej wolę stację roboczą, ponieważ eliminuje opóźnienia związane z udostępnianiem zasobów i utrzymuje dane lokalnie, co sprzyja prywatności i powtarzalności. Chmura sprawdza się przy ogromnej, żądanej na bieżąco skali i jednorazowych dużych obliczeniach, dlatego testuję typowe zadania i wykorzystuję chmurę do nadmiaru obciążenia, a codzienną pracę zostawiam na swoim komputerze, aby uniknąć cyklicznych transferów i uciążliwej konfiguracji.
Co warto rozważyć przed zakupem?
Zaczynam od potrzeb obciążenia: jeśli trenujesz duże modele, priorytetem jest pamięć oraz pamięć VRAM GPU, a jeśli pracujesz z dużymi zbiorami danych, wybierz dysk NVMe i szybkie wejście/wyjście o wysokiej przepustowości. Zwróć uwagę na chłodzenie, poziom hałasu, zasilanie i zajmowaną powierzchnię w swoim miejscu pracy oraz upewnij się, że system operacyjny i frameworki są kompatybilne, aby Twój zestaw narzędzi działał sprawnie. Biorę też pod uwagę gwarancję i wsparcie techniczne, możliwości rozbudowy oraz to, czy maszyna będzie służyć jako stanowisko deweloperskie jednego użytkownika, współdzielony węzeł zespołu, czy egzemplarz demonstracyjny.