 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Der Latenz-Mythos entlarvt: lokaler Prozess vs. Enterprise-HTTP
Von Mirko Peters ·
Willkommen zurück zu unseren laufenden technischen Deep Dives zu Enterprise-Architektur und moderner Systemarchitektur. In diesem Beitrag greifen wir ein Thema auf, das unter Softwareentwicklern und Systemarchitekten regelmäßig für Diskussionen sorgt: das tatsächliche Wesen der Latenz in verteilten Anwendungen im Vergleich zu lokalen Prozessen. Beim Entwurf leistungsstarker Systeme, insbesondere s
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
Willkommen zurück zu unseren laufenden technischen Deep Dives zu Enterprise-Architektur und moderner Systemarchitektur. In diesem Beitrag greifen wir ein Thema auf, das unter Softwareentwicklern und Systemarchitekten regelmäßig für Diskussionen sorgt: das tatsächliche Wesen der Latenz in verteilten Anwendungen im Vergleich zu lokalen Prozessen. Beim Entwurf leistungsstarker Systeme, insbesondere solcher, die die Lücke zwischen KI-Assistenten auf dem Desktop und Cloud-Datenplattformen im Backend überbrücken, tappen Entwickler häufig in die Falle der Microbenchmarks. Sie betrachten reine Übertragungsgeschwindigkeiten und gehen davon aus, dass die lokale Interprozesskommunikation dem netzwerkgebundenen Enterprise-HTTP grundsätzlich überlegen ist. Wie wir in diesem Artikel zeigen, ist diese Annahme jedoch ein Mythos.
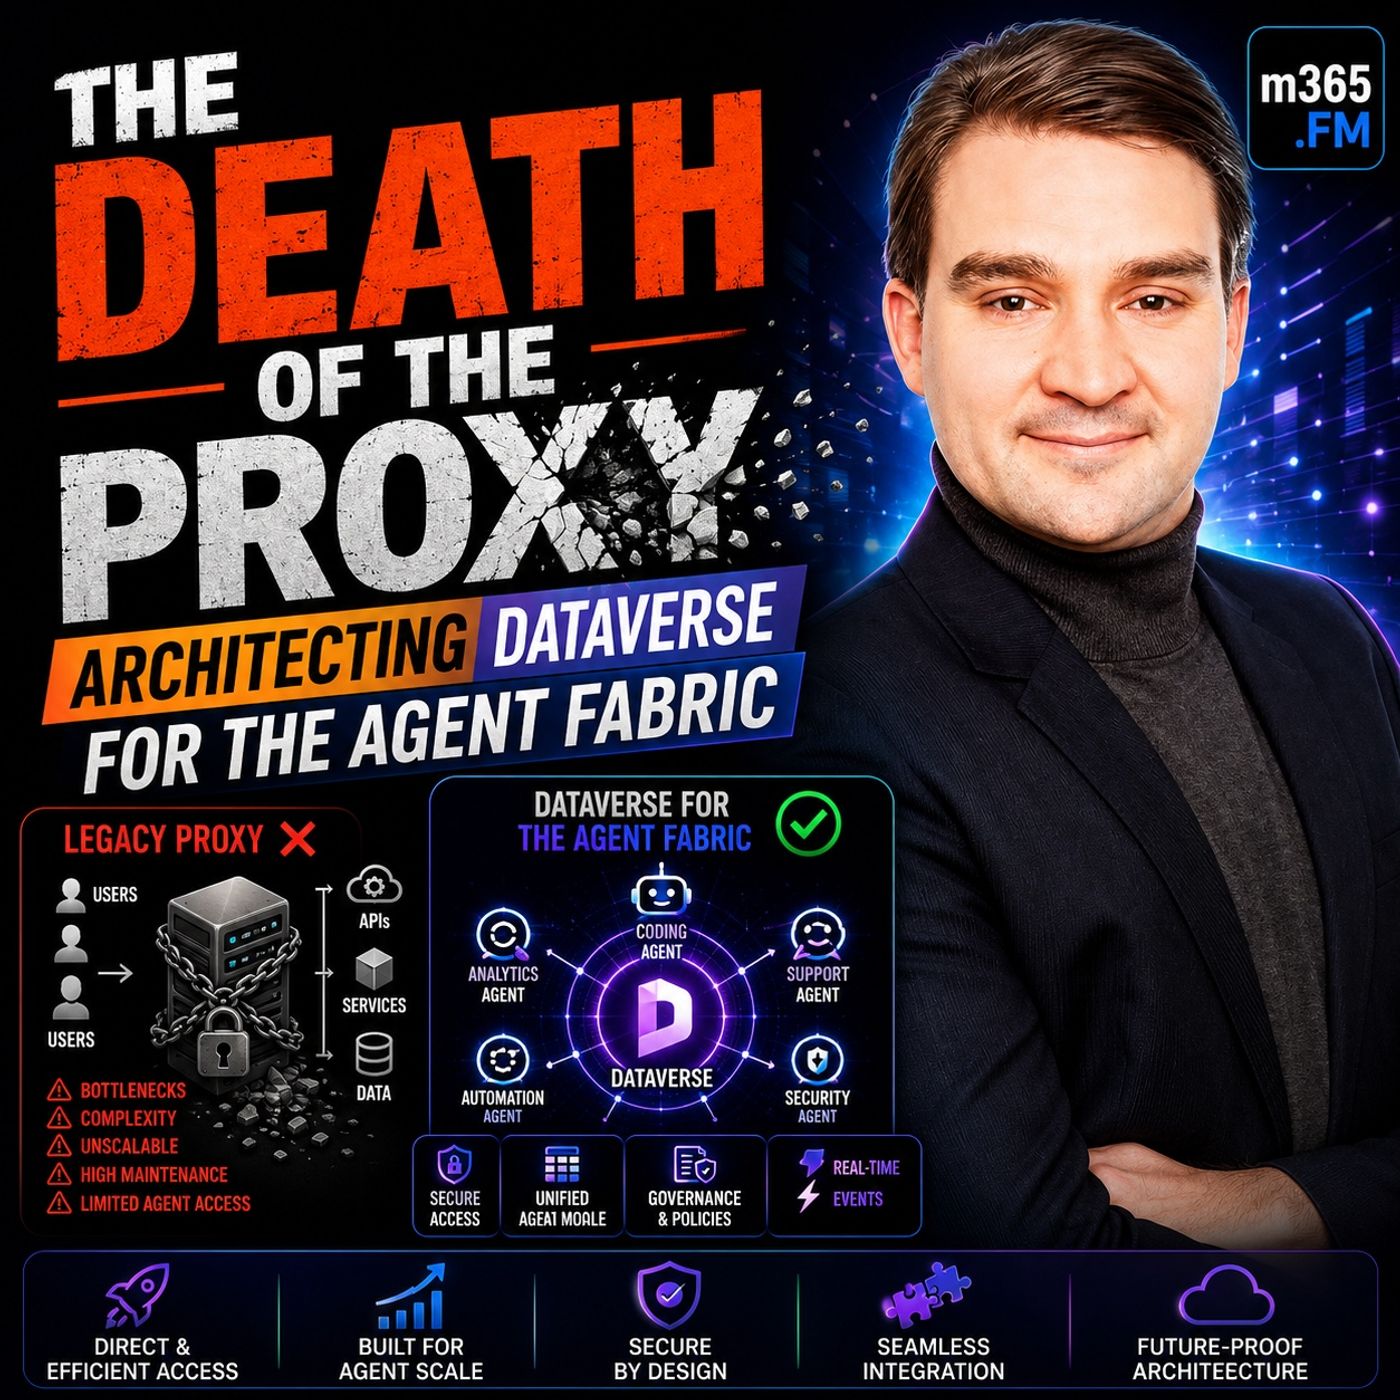
Dieses Thema knüpft direkt an unser jüngstes Podcast-Gespräch an. Falls Sie es noch nicht gehört haben, sehen Sie sich unbedingt THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric an. Darin zeigen wir, wie moderne Architekturen sich von fragilen lokalen Proxys hin zu robusten, skalierbaren Enterprise-HTTP-Endpunkten bewegen.
Einführung in den Latenz-Mythos in der Enterprise-KI
Die Entwicklung von Unternehmenssoftware hat dazu geführt, dass wir die Kommunikation zwischen Clients und Backend-Systemen grundlegend überdenken müssen. Nirgendwo wird das deutlicher als in der Architektur der KI-Integration in Unternehmen. Jahrelang galten lokale Werkzeuge wie STDIO-Proxys als die Standardempfehlung, um Desktop-Anwendungen mit Cloud-Datenbanken zu verbinden. Sie ließen sich einfach installieren, benötigten kaum Infrastruktur und fühlten sich beim lokalen Testen nahezu verzögerungsfrei an.
Sobald Organisationen jedoch von isolierten Entwicklerexperimenten zu unternehmensweiten Rollouts mit Hunderten oder Tausenden KI-Agenten übergehen, beginnen diese lokalen Annahmen zu bröckeln. Befürworter lokaler Prozesse führen häufig die Transportlatenz als ausschlaggebenden Faktor an. Sie argumentieren, dass HTTP Netzwerk-Overhead, TCP-Handshakes und TLS-Aushandlung mit sich bringe, während lokale Pipes in Mikrosekunden arbeiten. Dieses Argument beruht jedoch auf einem grundlegenden Missverständnis darüber, wo in einer realen Enterprise-Transaktion tatsächlich Zeit verloren geht. Um Performance wirklich zu verstehen, müssen wir über die Transportschicht hinausblicken und die gesamte Arbeitslast betrachten.
Microbenchmarks versus reale Enterprise-Workloads
Microbenchmarks sind berüchtigt für ihre Irreführung. Misst man in einer isolierten Testumgebung, wie lange das Übertragen einer JSON-Nutzlast über eine lokale STDIO-Pipe im Vergleich zu einer HTTP-Loopback-Schnittstelle dauert, gewinnt fast immer der lokale Prozess. Die Zahlen wirken eindeutig: einstellige Millisekunden für lokale Pipes gegenüber zweistelligen Millisekunden für Netzwerkschleifen.
Der Fehler liegt darin, dass Microbenchmarks die Realität der Ausführung von Enterprise-Software ausblenden. Wenn ein KI-Agent Daten von einer leistungsfähigen Plattform wie Dataverse anfordert, ist der Transportmechanismus nur ein Bruchteil der Gleichung. Hinter diesem Endpunkt verbirgt sich eine komplexe Kette von Vorgängen:
- Identitätsprüfung und Token-Validierung über Microsoft Entra ID
- Rollenbasierte Zugriffssteuerung (RBAC) und Prüfung der Sicherheitsgrenzen
- Ausführung komplexer Geschäftslogik, Plug-ins und benutzerdefinierter Workflows
- Kompilierung von Datenbankabfragen, Auswertung von Indizes und physischer Datenabruf
- Serialisierung und Deserialisierung umfangreicher Enterprise-Datenmodelle
Wenn Ihre Datenbankabfrage und die Geschäftslogik dreihundert Millisekunden benötigen, fallen die vier Millisekunden Transport-Overhead praktisch nicht ins Gewicht. Der Engpass liegt nie in der Leitung, sondern im Rechenaufwand, der nötig ist, um die geschäftliche Anforderung zu erfüllen. Wer die Transportschicht optimiert und dabei die betriebliche Last der Backend-Logik ignoriert, optimiert den falschen Teil des Stacks.
Die tatsächlichen Kosten des Transport-Overheads
Die lokale Prozesskommunikation glänzt zwar mit beeindruckender theoretischer Geschwindigkeit, verbirgt jedoch einen erheblichen operativen und infrastrukturellen Overhead, der sich mit zunehmender Skalierung summiert. Betrachten Sie, was passiert, wenn jeder einzelne Benutzer einen eigenen lokalen Prozess betreibt, um einen KI-Client mit einem Cloud-Dienst zu verbinden.
Jede einzelne Instanz eines lokalen Proxys verursacht eigene Startkosten, einen eigenen Initialisierungsaufwand für den Prozess und einen eigenen, isolierten Authentifizierungszyklus. Außerdem muss jeder lokale Prozess seine Verbindungen, Anmeldeinformationen und Fehlerzustände selbst verwalten. Wenn eine Organisation fünfhundert Entwickler oder automatisierte Agenten mit lokalen Proxys betreibt, bedeutet das fünfhundert getrennte Verbindungspipelines, die jeweils versuchen, mit Backend-Ressourcen zu kommunizieren.
Im Vergleich zu einem richtig konfigurierten Enterprise-HTTP-Endpunkt werden die versteckten Kosten des lokalen Modells deutlich. Lokale Prozesse können Zustände kaum gemeinsam nutzen, Verbindungsaufbauten nicht global zwischenspeichern und Ressourcen über verschiedene Client-Anwendungen hinweg nicht effizient bündeln. Die gefühlte Geschwindigkeit eines lokalen Prozesses ist eine Illusion, die spätestens dann zusammenbricht, wenn Parallelität und Systemfragmentierung ins Spiel kommen.
Wie Connection Pooling das Performance-Rennen gewinnt
Hier dreht Enterprise-HTTP die Performance-Bilanz deutlich. Anders als kurzlebige lokale Prozesse, die Verbindungen immer wieder auf- und abbauen, nutzen produktionsreife HTTP-Dienste ausgereiftes Connection Pooling, persistente Sitzungen und langlebige Serverinfrastrukturen.
Wenn ein HTTP-Client im Unternehmen eine Verbindung zu einem gemeinsam genutzten Dienst aufbaut, fallen die initialen Handshake-Kosten, etwa DNS-Auflösung, TCP-Slow-Start und TLS-Aushandlung, nur einmal an. Folgende Anfragen laufen über bestehende, persistente Verbindungen. Da diese Verbindungen über eine zentrale Dienstschicht gepoolt und verwaltet werden, kann das System außerdem warme Datenbankverbindungen, vorab authentifizierte Sitzungen und zwischengespeicherte Metadatenschemas vorhalten.
In einer sauber abgestimmten Unternehmensumgebung bedeuten diese Optimierungen, dass ein kontinuierlicher Strom von HTTP-Anfragen eine geringere durchschnittliche End-to-End-Latenz erreichen kann als ein unkoordiniertes Geflecht aus lokalen Prozessen. Der Netzwerk-Overhead verteilt sich auf Tausende blitzschnelle, persistente Transaktionen, sodass die anfängliche Transportverzögerung völlig irrelevant wird.
Skalierung: Enterprise-HTTP vs. Overhead lokaler Prozesse
Die Skalierung einer Softwarearchitektur ist der eigentliche Test für ihre Designprinzipien. Wenn ein Unternehmen von einer Handvoll Entwicklungsassistenten zu einem umfassenden Ökosystem aus KI-Werkzeugen übergeht, darunter GitHub Copilot, Claude Code, eigene Orchestratoren und interne Copilot-CLIs, wird der Betrieb mit lokalen Prozessen nicht mehr tragbar.
Die Verwaltung Hunderter getrennter Proxy-Prozesse führt zu erheblichem administrativem Drift. Es gibt keine zentrale Übersicht, das Monitoring ist fragmentiert, und die Fehlersuche bei sporadisch auftretenden Störungen auf verteilten lokalen Rechnern ist für IT-Administratoren ein Albtraum. Die Sicherheits-Governance wird zu einem Flickenteppich lokaler Konfigurationen statt einer einheitlichen, durchsetzbaren Richtlinie.
Demgegenüber ist die Skalierung einer Enterprise-HTTP-Architektur linear und planbar. Statt die Infrastruktur auf jedem Benutzer-Arbeitsplatz zu vervielfachen, skalieren Organisationen einen einzigen, hochverfügbaren Dienst hinter einem Enterprise-Load-Balancer. Steigt die Last, starten Sie einfach zusätzliche Serverinstanzen. Clients kommunizieren weiterhin mit exakt demselben kontrollierten Endpunkt, während die Plattform horizontale Skalierung, Lastverteilung und Telemetrie transparent übernimmt. Sicherheitsfunktionen wie PKCE (Proof Key for Code Exchange) ermöglichen es öffentlichen Desktop-Clients, sich sicher zu authentifizieren, ohne fest codierte Geheimnisse zu speichern. So verbinden sich robuste Enterprise-Governance und reibungslose Entwicklerergonomie.
Fazit: Geschäftslogik vor Mikrooptimierung
Die anhaltende Attraktivität der lokalen Prozesskommunikation ist ein klassisches Beispiel dafür, wie Mikrooptimierungen Architekten den Blick auf die makroskopischen Zusammenhänge verstellen. Lokale Pipes mögen einen synthetischen Benchmark um wenige Millisekunden gewinnen, doch sie bringen erhebliche betriebliche Komplexität mit sich, untergraben die Sicherheit im Unternehmen und skalieren in modernen, KI-getriebenen Umgebungen nicht sauber. Wenn wir den Fokus von der Transportschicht auf robuste, mit Connection Pooling arbeitende Enterprise-HTTP-Architekturen verlagern, bauen wir Systeme, die sicher, skalierbar und tatsächlich für die Anforderungen des modernen Unternehmens gerüstet sind.
Wenn Sie tiefer einsteigen möchten, wie sich Plattformen wie Dataverse weiterentwickeln, um als einheitliche Datengrundlage für die gesamte Agent Fabric zu dienen, hören Sie sich unbedingt die komplette Folge an: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. Vielen Dank fürs Lesen, und bleiben Sie dran für weitere Deep Dives zur Enterprise-Cloud-Architektur!