 ES
 English
 Deutsch
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
MAI-1 y la economía del razonamiento profundo
By Mirko Peters ·
Cuando las empresas empiezan a explorar la inteligencia artificial empresarial, la conversación casi siempre se reduce de inmediato a una pregunta sencilla: ¿cuál es el mejor modelo?
Automatically translated with AI from the original post. Read the English original
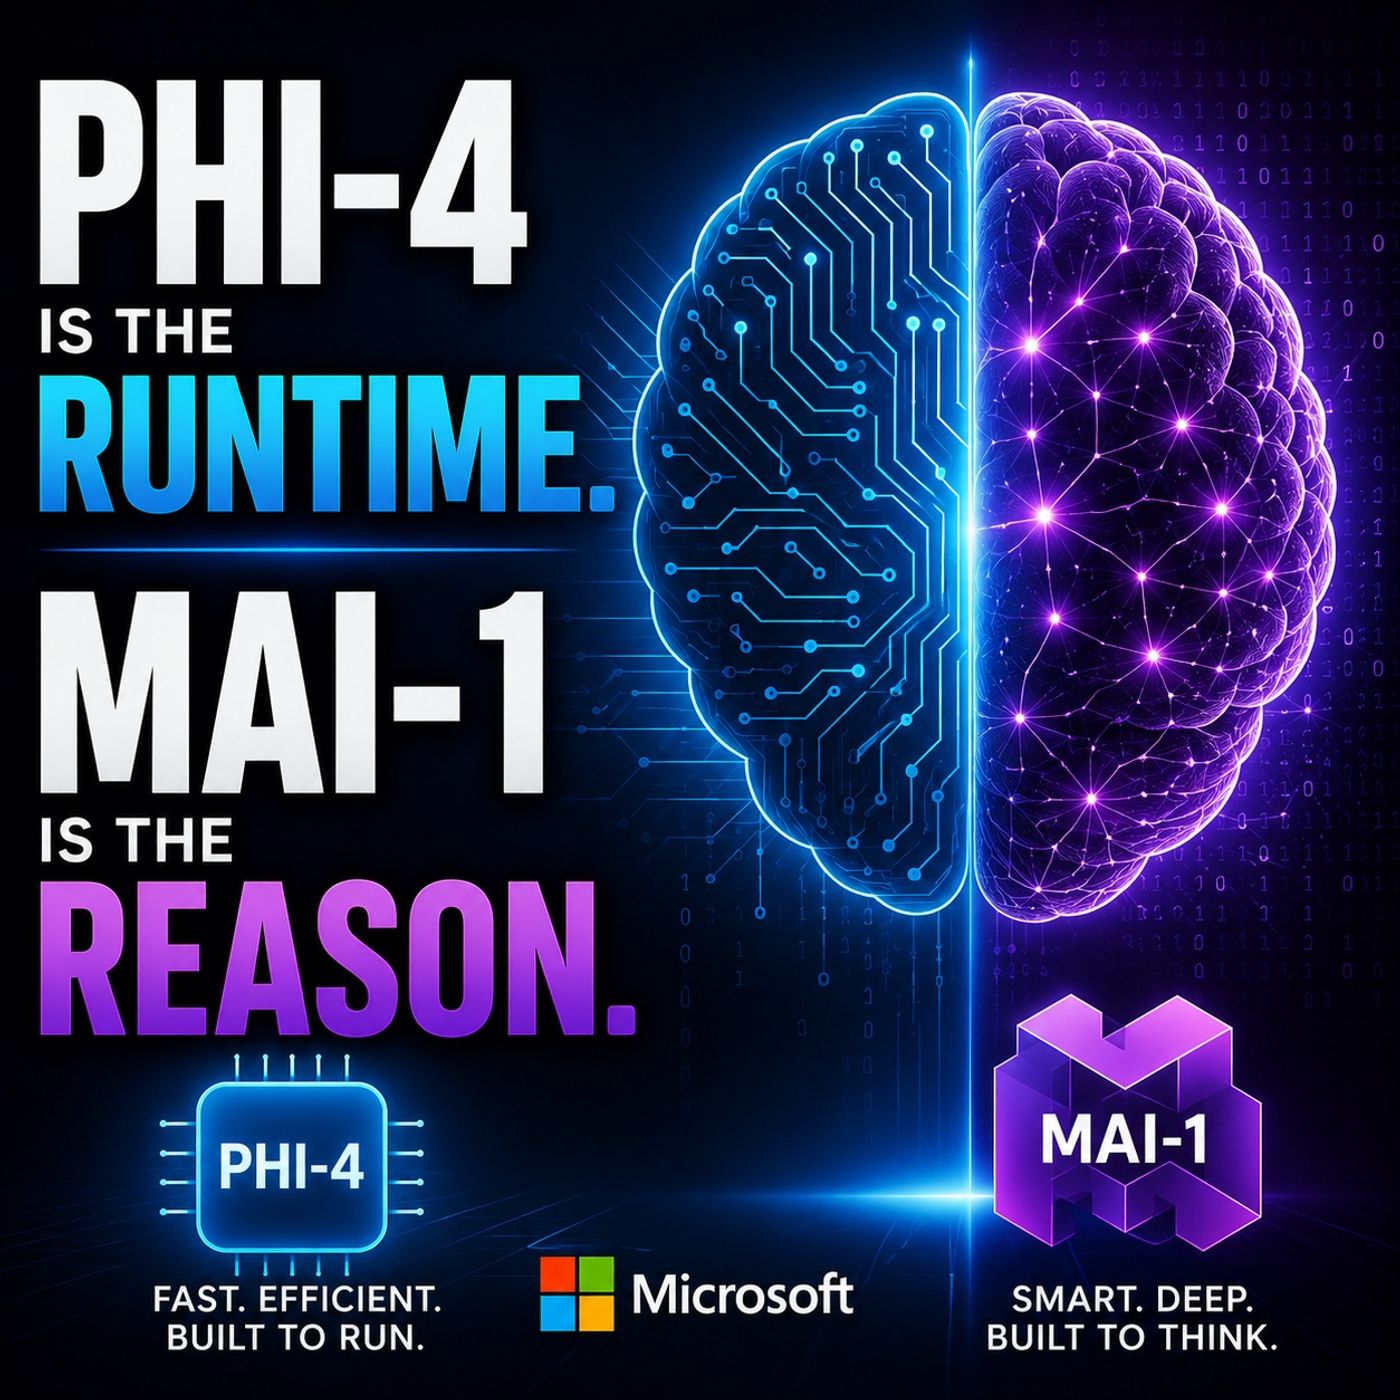
Cuando las empresas empiezan a explorar la inteligencia artificial empresarial, la conversación casi siempre se reduce de inmediato a una pregunta sencilla: ¿cuál es el mejor modelo? Nos obsesionamos con las puntuaciones de los benchmarks, contamos los parámetros como si fueran cromos de béisbol y buscamos un único motor de inteligencia insignia que pueda integrarse en todas las aplicaciones de la organización. Pero a medida que las estrategias de implantación maduran, esa pregunta tan simple empieza a perder sentido. Tratar la IA como un evento deportivo en el que solo gana uno ignora la realidad de cómo funciona la infraestructura de software en el mundo real. Del mismo modo que una empresa moderna nunca enviaría todas sus tareas de computación a un único superordenador masivo ni guardaría todos los archivos en el mismo nivel de almacenamiento, depender de un solo modelo de frontera monolítico para cada interacción es financieramente insostenible y arquitectónicamente ineficiente.
El futuro de la IA empresarial no está en encontrar un único modelo universal, sino en entender cómo se pueden combinar distintas clases de inteligencia dentro de una arquitectura cohesiva. La estrategia emergente de Microsoft es un gran ejemplo de este enfoque, con una clara división de funciones entre modelos de ejecución rápidos y muy eficientes, y sistemas masivos capaces de razonar en profundidad. Para que esta arquitectura funcione, las organizaciones deben ir más allá de la capacidad bruta y empezar a evaluar la economía subyacente de sus cargas de trabajo. Saber cuándo un problema requiere la potencia de planificación de fuerza bruta de un modelo de frontera, y cuándo puede resolverse con una capa de ejecución ágil, se está convirtiendo en uno de los desafíos técnicos y financieros más críticos del desarrollo de software actual.
La economía de la IA: ejecución rutinaria frente a razonamiento profundo
La arquitectura del modelo se convierte rápidamente en una ecuación financiera en el momento en que una empresa pasa de un entorno de prueba de concepto a entornos de producción. En las primeras fases de experimentación, la diferencia de coste entre ejecutar un prompt en un modelo local ligero o invocar un gran modelo de razonamiento en la nube puede parecer insignificante. Pero si escalamos esa diferencia a millones de interacciones diarias de usuarios, procesos automatizados en segundo plano y flujos de trabajo agénticos, la realidad financiera de esa decisión se vuelve sorprendentemente evidente.
El error que cometen muchas organizaciones es evaluar los costes de la IA únicamente desde la perspectiva del coste por token. Un token más barato solo tiene valor si el modelo que lo procesa es realmente capaz de resolver el problema de forma eficiente. Si envías un problema de planificación complejo y de varios pasos a un modelo pequeño y económico, es probable que falle, lo que obligará a una intervención humana costosa, a reintentos o a errores que se acumulan. Por el contrario, si envías una solicitud de clasificación rutinaria, como etiquetar un ticket de soporte de cliente entrante o extraer un campo de datos estándar, a un gran modelo de razonamiento, estarás desperdiciando ciclos de cómputo caros y aumentando la latencia sin ningún beneficio para el negocio.
Esta dinámica significa que la economía de la IA debe analizarse en relación con la complejidad de la carga de trabajo. Una solicitud que exige razonamiento profundo suele justificar un coste de inferencia más alto, porque el problema de negocio en sí tiene un valor elevado y requiere un juicio cuidadoso. La ejecución rutinaria, en cambio, requiere gran volumen y alta velocidad. Si alineas la complejidad de cada carga de trabajo con el nivel de inteligencia adecuado, las empresas pueden construir arquitecturas que sean funcionalmente potentes y financieramente sostenibles a largo plazo.
Phi-4 como capa de ejecución eficiente
Para respaldar este enfoque por niveles de la inteligencia empresarial, las organizaciones necesitan un nivel de modelos dedicado por completo a la ejecución. Este es el papel de la capa de ejecución. Un runtime se sitúa lo más cerca posible del punto de trabajo, ofreciendo baja latencia, una ejecución predecible y un modelo económico que escala sin esfuerzo en volúmenes altos. En el ecosistema de Microsoft, modelos como Phi-4 encajan perfectamente en este espacio operativo.
Los modelos compactos de la familia Phi-4 están diseñados en torno a la eficiencia. Ofrecen una capacidad considerable en un tamaño sorprendentemente reducido, lo que los convierte en una opción ideal para entornos integrados, endpoints locales y flujos de trabajo agénticos que dependen de llamadas a funciones rápidas en lugar de una generación conversacional extensa. Imagina un asistente de programación local que analiza un archivo abierto, un agente de seguridad de endpoints que clasifica comportamientos anómalos de red o una aplicación que enruta llamadas a API internas en función de datos contextuales. Estas tareas requieren inteligencia real, pero no necesitan un modelo de frontera masivo con ventanas de contexto infinitas y bucles de planificación exhaustivos.
Además, desplegar modelos compactos en local aporta ventajas profundas cuando se habla de soberanía de datos y gobernanza. En lugar de enviar cada fragmento de telemetría corporativa o cada documento sensible a un servicio remoto en la nube, las organizaciones pueden ejecutar las tareas rutinarias directamente en hardware local o dentro de perímetros muy controlados. La residencia de los datos se convierte en una característica de la arquitectura, y no en un parche de seguridad reactivo. Así, los sectores muy regulados pueden mantener las operaciones críticas cerca de casa y reservar la infraestructura en la nube exclusivamente para las tareas que exigen un procesamiento centralizado y de gran envergadura.
MAI-1 como capa de razonamiento de frontera
Mientras la capa de runtime se encarga de la ejecución rápida y de las tareas de gran volumen, inevitablemente surgen problemas empresariales complejos que superan las capacidades de un modelo compacto. Son escenarios en los que un sistema no puede basarse en la coincidencia inmediata de patrones, sino que debe evaluar alternativas en competencia, desenredar dependencias, planificar varios pasos por adelantado y sintetizar grandes cantidades de información dispar. Este es el ámbito de la capa de razonamiento profundo, representada por modelos como MAI-1.
Los modelos de razonamiento están diseñados para situaciones en las que la siguiente acción correcta no es evidente de inmediato. Piensa en una revisión arquitectónica compleja que involucra decenas de servicios en la nube interdependientes, en una investigación profunda de causa raíz en una base de código de microservicios extensa o en un problema estratégico de optimización de la cadena de suministro condicionado por variables logísticas en conflicto. No son problemas de ejecución simples: requieren que el modelo mantenga la integridad estructural del problema mientras razona sobre las consecuencias en cascada.
Alcanzar este nivel de profundidad exige una enorme capacidad de razonamiento activo, habilidades avanzadas para resolver problemas en varios pasos y linajes de entrenamiento sofisticados orientados a la ingeniería de software y a la lógica. Como estos modelos utilizan arquitecturas avanzadas, como la activación selectiva mediante diseños Mixture-of-Experts, pueden aplicar una capacidad inmensa a los problemas difíciles sin desperdiciar recursos en los triviales. Están construidos para pensar en profundidad, pero solo deberían invocarse cuando la complejidad del problema realmente justifique la inversión.
Enrutamiento y orquestación: saber cuándo escalar
La existencia de una capa de runtime y una capa de razonamiento crea una necesidad arquitectónica inmediata: algo tiene que decidir cómo fluyen las peticiones entre ambas. Un runtime sin un mecanismo de enrutamiento hacia la capa de razonamiento chocará inevitablemente contra un muro cuando se enfrente a un problema que supere sus capacidades. Una capa de razonamiento sin un runtime inteligente malgastará recursos en consultas rutinarias de bajo valor.
Por eso la orquestación se convierte en el sistema nervioso central de la arquitectura de IA moderna. Una capa de orquestación inteligente actúa como un controlador de tráfico: evalúa las peticiones entrantes, analiza su complejidad estructural y determina si la tarea puede resolverse rápidamente por un runtime local o si debe escalarse a un modelo de razonamiento de frontera. Si una organización domina esta capacidad de enrutamiento, los usuarios disfrutan de lo mejor de ambos mundos: las aplicaciones responden de forma instantánea en las interacciones rutinarias, pero resultan sorprendentemente potentes cuando se requiere una capacidad analítica compleja.
Construir esta capa de orquestación exige telemetría sólida, rúbricas de clasificación claras y un ajuste continuo de la propia lógica de enrutamiento. Las empresas deben medir no solo el rendimiento del modelo, sino también la precisión del enrutamiento: asegurarse de que las rutas de escalado se activan de forma fiable cuando la complejidad lo exige y, a la inversa, de que las consultas rutinarias se filtran de manera eficaz para que no lleguen a motores de razonamiento costosos.
Sostenibilidad financiera a escala empresarial
A medida que los presupuestos de IA corporativos salen del laboratorio de innovación y pasan al escrutinio del director financiero, las decisiones de arquitectura que se tomen hoy determinarán la viabilidad comercial de las iniciativas de IA de mañana. Desplegar un único modelo de frontera, caro, para cada caso de uso empresarial es el camino más rápido hacia facturas de nube insostenibles y partes interesadas frustradas.
La sostenibilidad financiera real surge de la disciplina arquitectónica. Si organizas las cargas de trabajo por niveles, trasladando las tareas repetitivas y de gran volumen a entornos de ejecución eficientes como Phi-4 y reservando el razonamiento profundo y analítico para modelos avanzados como MAI-1, las organizaciones pueden optimizar su coste total de propiedad. Este enfoque por niveles convierte la IA en un activo predecible y muy calibrado, en lugar de un gasto operativo impredecible, y genera un retorno de la inversión medible en todos los departamentos.
Conclusión: diseñar arquitecturas de IA específicas para cada carga de trabajo
La era de tratar la IA como un asistente monolítico llega rápidamente a su fin. Tal como muestra la estrategia de Microsoft, el futuro pertenece a las arquitecturas basadas en la especialización, la división del trabajo y la orquestación inteligente. Al comprender los roles diferentes de los entornos de ejecución eficientes y de los motores de razonamiento profundo, las organizaciones pueden dejar de preguntarse qué modelo es universalmente superior y empezar a construir sistemas adaptados a las realidades económicas y técnicas concretas de sus cargas de trabajo.
Para profundizar en cómo Microsoft está dando forma a este enfoque de doble capa y qué significa para la arquitectura de tu empresa, no dejes de escuchar el episodio de podcast relacionado: Phi-4 is the Runtime. MAI-1 is the Reason. Evaluar tu estrategia de IA desde esta perspectiva te ayudará a que tus sistemas sigan siendo rápidos, escalables y financieramente sostenibles a medida que la inteligencia empresarial continúa evolucionando.