 FR
 English
 Deutsch
 Español
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Orientation permanente ou expertise situationnelle : restructurer l’architecture de votre IA
By Mirko Peters ·
Bienvenue dans le blog d’accompagnement de notre podcast. Dans l’article d’aujourd’hui, nous plongeons au cœur d’un obstacle technique que presque toutes les équipes informatiques d’entreprise rencontrent après le déploiement de leur première vague de solutions d’IA…
Automatically translated with AI from the original post. Read the English original
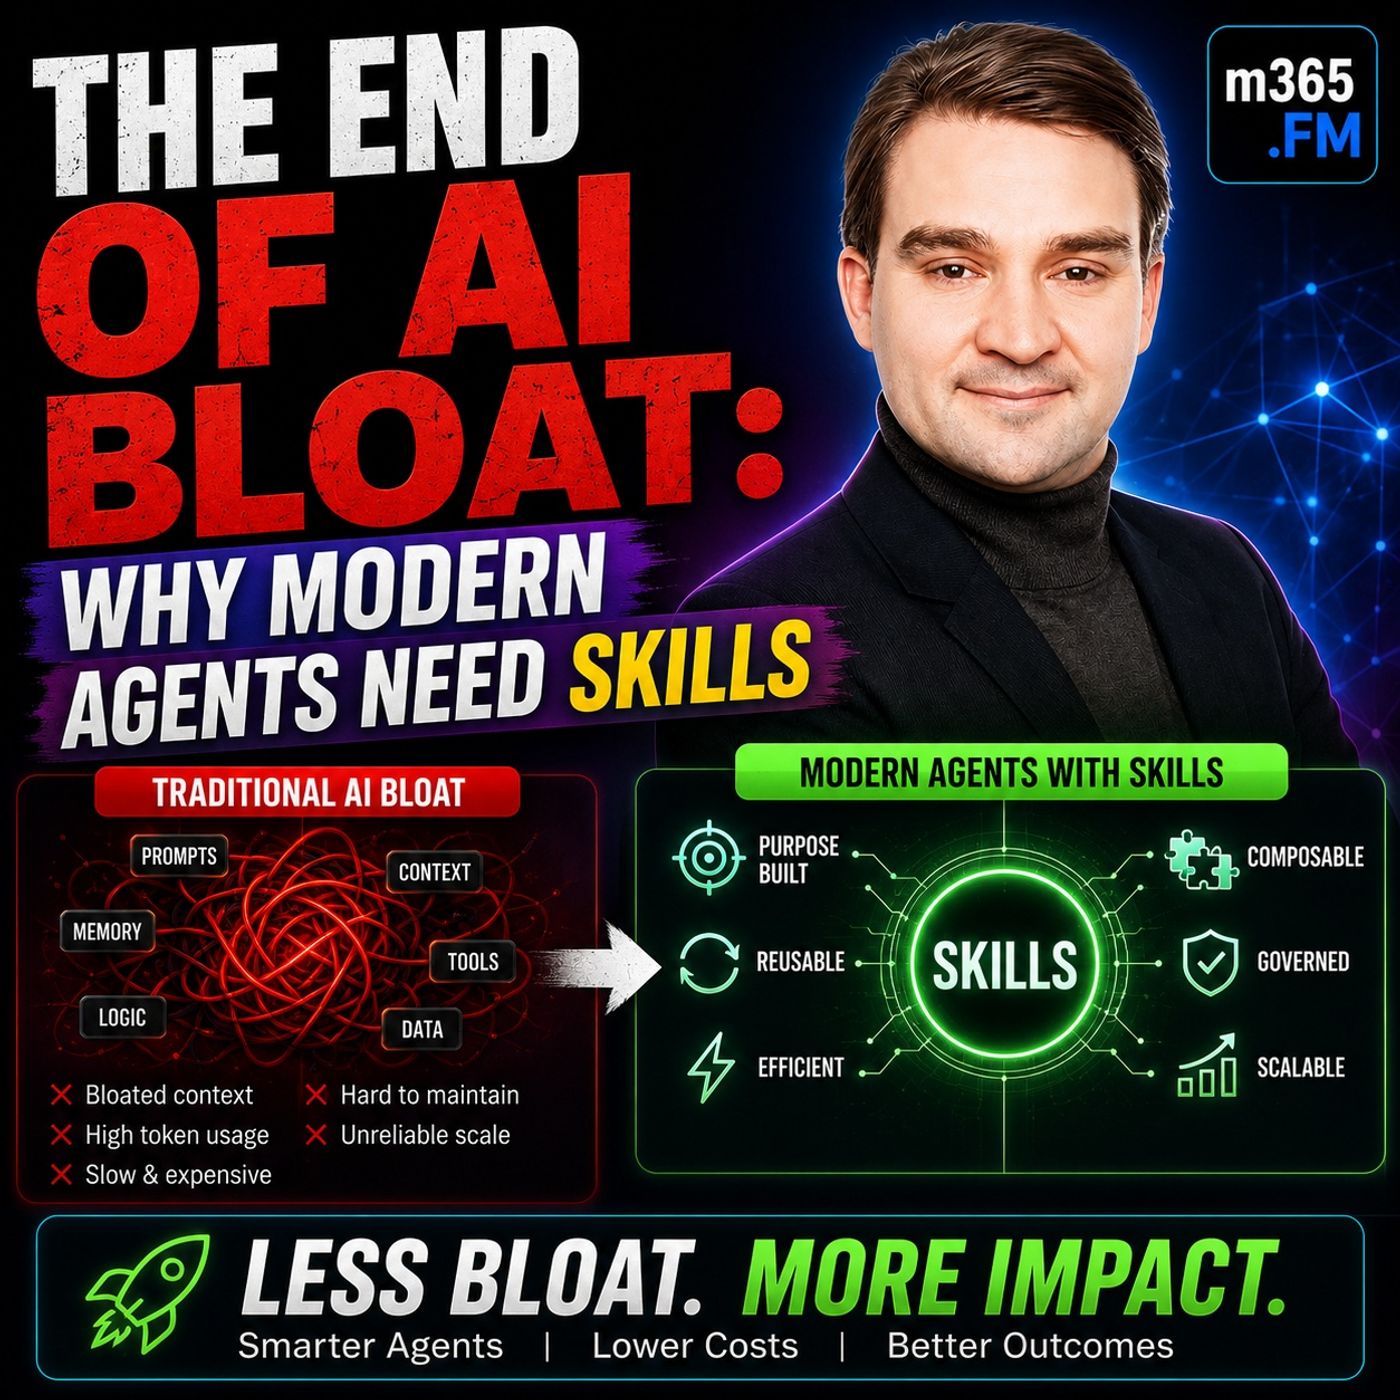
Bienvenue dans le blog d’accompagnement de notre podcast. Dans cet article, nous nous penchons en détail sur un obstacle technique que presque toutes les équipes des grandes entreprises rencontrent après le déploiement de leur première vague de solutions d’IA. Vous créez un agent d’IA sur mesure, et au début, cela ressemble à de la magie. Il est rapide, très précis et particulièrement réactif. Mais passez trois à six mois plus tard : quelque chose d’étrange se produit. Les temps de réponse ralentissent, les coûts opérationnels grimpent insensiblement, et l’agent commence à halluciner ou à s’écarter du comportement prévu. La pratique courante dans de nombreuses organisations consiste à ajouter davantage de puissance de calcul ou à passer à un modèle de langage plus volumineux. Mais, comme nous le détaillons, le problème central ne vient pas du modèle lui-même : il tient à l’architecture sous-jacente de vos prompts.
Dans cet article, nous analysons pourquoi les prompts monolithiques entraînent une dégradation catastrophique du contexte, comment séparer les comportements universels de base des workflows propres à chaque tâche, et pourquoi les modèles de conception modulaires transforment le paysage de l’IA en entreprise.
Introduction : le coût caché des prompts monolithiques
Lorsque les équipes d’ingénierie prototypent pour la première fois des agents conversationnels, elles s’appuient généralement sur un prompt système unique et exhaustif. Ce prompt définit qui est l’agent, comment il doit s’exprimer, quelles règles il doit suivre et comment il doit gérer les cas limites complexes. C’est une approche intuitive pour démarrer. Cependant, à mesure que l’activité évolue, le prompt évolue aussi. Les RH ajoutent de nouvelles stratégies de congés, la conformité introduit des réglementations régionales, et le support client ajoute des workflows de remboursement.
Avant que vous ne vous en rendiez compte, votre prompt système gonfle jusqu’à atteindre des milliers de tokens d’instructions denses. Chaque fois qu’un utilisateur pose une question simple, comme la consultation des horaires d’ouverture, le modèle d’IA est contraint d’ingérer, de traiter et de raisonner sur chaque règle, chaque stratégie et chaque cas limite de l’ensemble de votre prompt système. Bien que quatre-vingt-quinze pour cent de ces instructions n’aient absolument aucun rapport avec les horaires d’ouverture, le modèle doit tout de même les analyser. Cette taxe cachée sur le calcul et le raisonnement, que nous appelons la « Context Tax », altère profondément les caractéristiques de performance de votre agent d’IA au fil du temps.
Comprendre la « Context Tax » et pourquoi les agents se dégradent avec le temps
La dégradation des agents en environnement de production est remarquablement prévisible. Elle ne résulte pas d’une incapacité du modèle à raisonner. Elle provient du fait que nous surchargeons la fenêtre de contexte active du modèle avec du bruit cognitif. Lorsque l’on oblige une IA à parcourir des montagnes de documentation procédurale sans rapport avec chaque interaction utilisateur, plusieurs effets se produisent simultanément :
- La consommation de tokens augmente, ce qui fait directement grimper les coûts d’inférence par requête.
- La latence des réponses s’accroît, car des contextes plus volumineux demandent davantage de temps de traitement.
- La probabilité d’hallucinations augmente, le modèle peinant à arbitrer entre des instructions contradictoires ou non pertinentes.
- La cohérence du raisonnement diminue, car l’attention du modèle se disperse entre trop de directives concurrentes.
Le système n’est pas devenu moins intelligent ; son cheminement de raisonnement a simplement été alourdi par des données inutiles. Pour y remédier, nous devons examiner de près la manière dont nous répartissons l’information au sein de nos architectures.
Orientation permanente et expertise situationnelle
L’un des changements de mentalité les plus puissants que vous puissiez adopter en ingénierie de l’IA moderne consiste à séparer vos instructions système en deux catégories distinctes : l’orientation permanente et l’expertise situationnelle.
L’orientation permanente regroupe les garde-fous universels et les marqueurs d’identité qui doivent s’appliquer à chaque interaction, quelle que soit l’intention de l’utilisateur. Elle comprend :
- L’identité de l’agent, sa persona et son ton de voix
- Les exigences de sécurité universelles de l’entreprise
- Les règles de conformité fondamentales et les limites absolues
- Les préférences standard de mise en forme et de sortie
L’expertise situationnelle, en revanche, est entièrement contextuelle. Il s’agit d’informations qui ne prennent de la valeur que lorsqu’un scénario ou un workflow spécifique est déclenché. Citons par exemple les protocoles d’intégration des fournisseurs, les réglementations en matière de calcul de la fiscalité, les stratégies de retour régionales ou les procédures complexes de réponse aux incidents informatiques.
Dans les architectures traditionnelles, ces deux catégories sont regroupées dans un même prompt massif. Dans une architecture modernisée et restructurée, seules les consignes permanentes restent chargées en permanence. Tout le reste est conditionné dans des composants modulaires qui se chargent dynamiquement.
Anatomie d’une Skill : conditionner la connaissance pour l’IA
Pour éliminer la Context Tax, nous avons besoin d’un mécanisme permettant de stocker l’expertise situationnelle en dehors du prompt principal, et de ne la faire intervenir que lorsque c’est nécessaire. Ce mécanisme est la Skill IA. Une Skill n’est pas simplement un extrait de prompt : c’est un ensemble complet et réutilisable d’instructions et de ressources propres à une tâche. Une Skill bien conçue comprend généralement :
- Des descriptions de déclenchement claires qui indiquent à l’orchestrateur quand la Skill est pertinente
- Des instructions procédurales structurées pour traiter la tâche
- Des documents de référence, des formulaires ou des modèles de stratégies
- Des scripts ou des définitions d’API facultatifs pour exécuter des actions
Au centre de ce package se trouve le fichier de configuration principal, souvent structuré sous la forme d’un fichier SKILL.md. Ce fichier décrit le périmètre exact, l’objectif et les étapes d’exécution de ce domaine de connaissance précis. En modularisant ainsi la connaissance, vous créez des unités de capacité d’entreprise claires et faciles à maintenir, qui peuvent être mises à jour indépendamment sans risquer la stabilité de l’agent principal.
Établir des frontières de raisonnement claires
Modulariser votre agent IA en Skills distinctes ne se limite pas à économiser des jetons : cela établit des frontières de raisonnement rigoureuses. Lorsqu’un modèle reçoit un prompt monolithique, il tente de résoudre chaque problème à travers le prisme de toutes les règles à la fois. Avec les Skills, vous isolez le domaine de raisonnement.
Par exemple, lorsqu’un utilisateur lance un workflow d’achat, la Skill achats est chargée, et le moteur de raisonnement de l’agent se concentre exclusivement sur les stratégies d’achat, les hiérarchies d’approbation et les directives fournisseurs. Pendant que cette Skill est active, les règles sans rapport, concernant les déductions fiscales ou les politiques de ressources humaines, restent hors de la fenêtre de contexte active. Cette frontière stricte améliore nettement la précision et la cohérence des résultats de l’IA, et lui permet de suivre des procédures spécialisées sans interférence avec les autres volets de l’entreprise.
Mettre en œuvre la divulgation progressive pour gagner en efficacité
Comment gérer ces Skills sans surcharger le système ? La réponse réside dans un modèle de conception connu sous le nom de divulgation progressive. Plutôt que de charger toutes les instructions et tous les workflows au démarrage, votre agent conserve un catalogue léger, qui ne contient que les noms et les descriptions des Skills disponibles.
Lorsqu’un utilisateur soumet un prompt, le workflow suit une séquence précise :
- L’orchestrateur analyse la demande de l’utilisateur par rapport au catalogue léger des Skills.
- Il identifie la Skill spécifique nécessaire pour traiter le scénario.
- Le système charge dynamiquement cette Skill unique dans la fenêtre de contexte.
- L’agent exécute la tâche avec une grande précision.
- Une fois la tâche terminée, la Skill se décharge, et l’agent retrouve son état de base allégé.
Ce modèle de conception réduit considérablement les besoins en calcul, diminue la latence et maîtrise les coûts opérationnels, tout en garantissant que vos agents conservent l’accès à une connaissance métier approfondie et spécialisée.
Conclusion : restructurer votre architecture IA pour l’avenir
Les prompts monolithiques ont bien servi lors des premières expérimentations de l’IA générative, mais les déploiements en entreprise exigent davantage d’évolutivité, une latence réduite et une fiabilité accrue. En séparant les consignes permanentes de l’expertise situationnelle et en adoptant des Skills modulaires grâce à la divulgation progressive, vous pouvez éliminer la Context Tax, prévenir la dégradation des agents et bâtir des systèmes IA robustes, capables d’évoluer harmonieusement avec votre organisation.
Pour découvrir une analyse complète de ces modèles d’architecture, des exemples de mise en œuvre concrets, ainsi que la manière dont ces concepts s’appliquent à des plateformes comme Microsoft Copilot Studio, GitHub Copilot et Claude Code, consultez notre épisode associé : The End of AI Bloat: Why Modern Agents Need Skills. Restez à l’écoute, abonnez-vous et dites-nous comment vous structurez vos agents IA d’entreprise !