 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Guida sempre attiva vs. competenza situazionale: come ristrutturare l'architettura della tua AI
By Mirko Peters ·
Bentornato sul blog di accompagnamento al nostro podcast. In questo post approfondiamo un ostacolo tecnico che quasi tutti i team enterprise incontrano dopo il primo rilascio di soluzioni AI. Costruisci un agente AI personalizzato e, all'inizio, sembra magia. È veloce, molto accurato e reattivo. Ma dopo tre o sei mesi succede qualcosa di strano. I tempi di risposta rallentano, i costi operativi sa
Automatically translated with AI from the original post. Read the English original
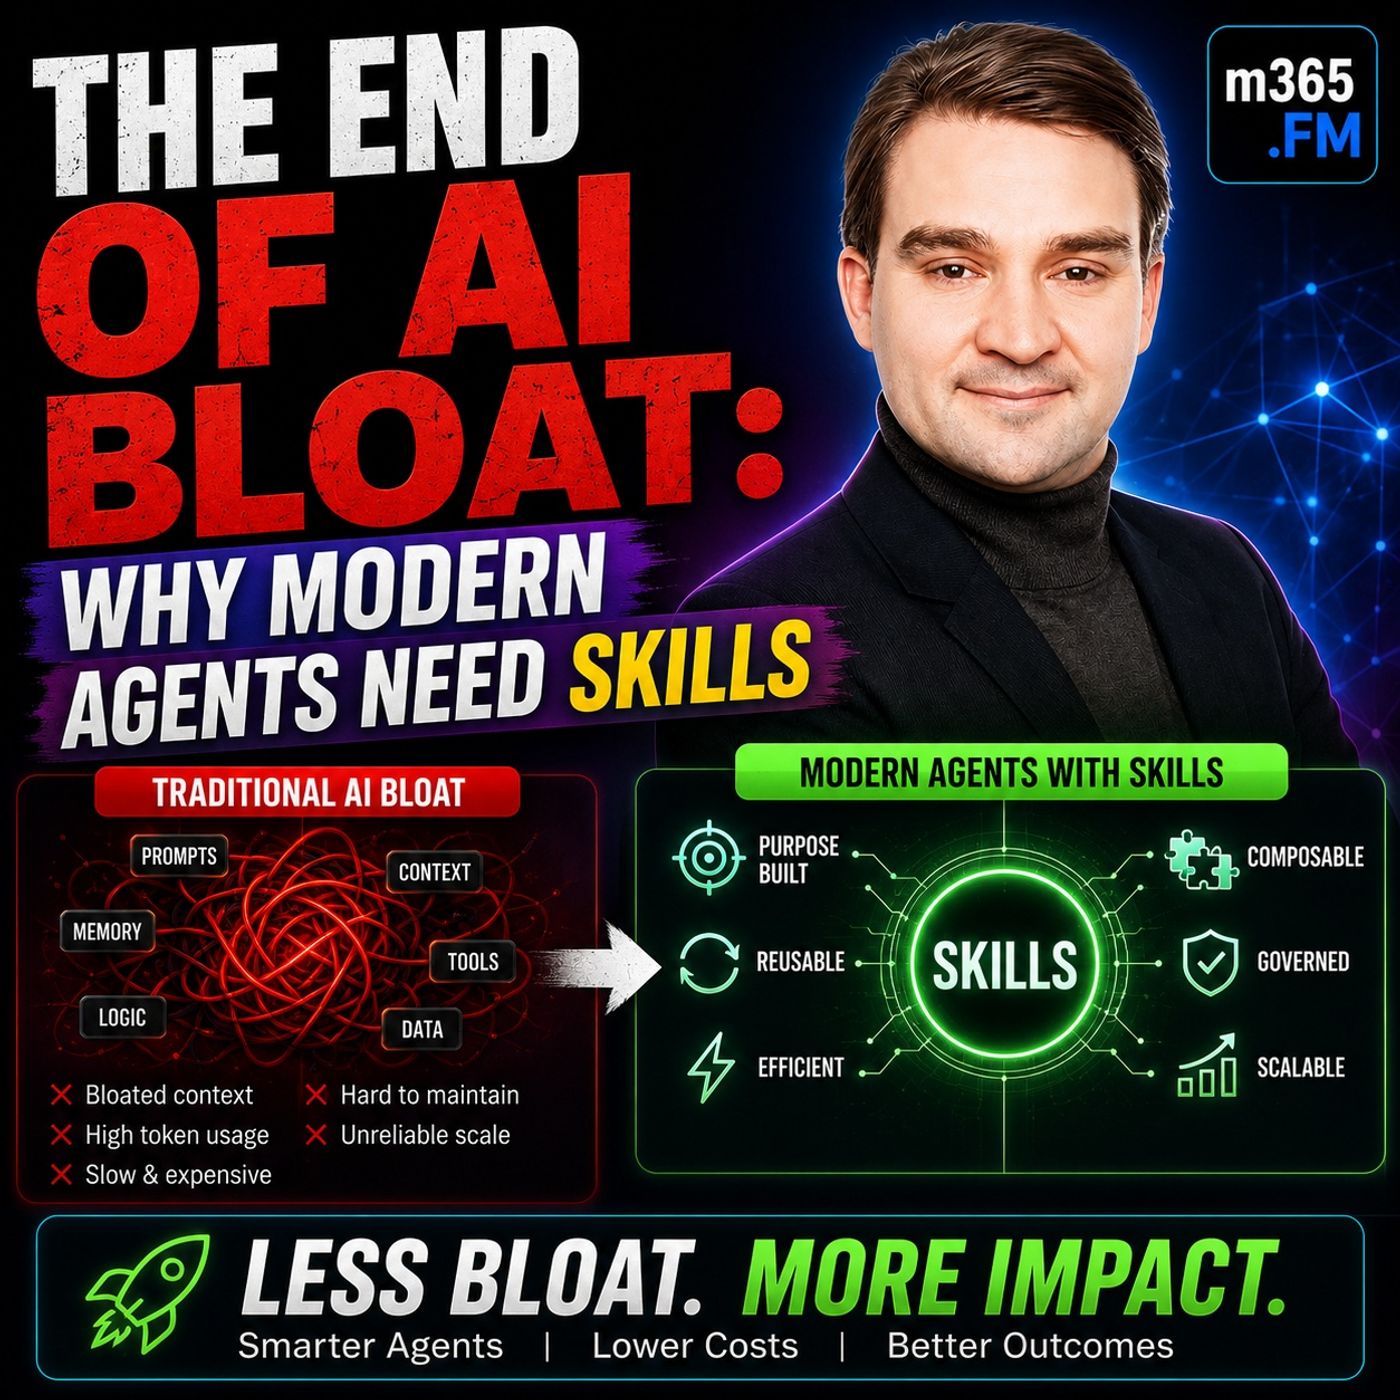
Bentornato sul blog di accompagnamento al nostro podcast. In questo post approfondiamo un ostacolo tecnico che quasi tutti i team enterprise incontrano dopo il primo rilascio di soluzioni AI. Costruisci un agente AI personalizzato e, all'inizio, sembra magia. È veloce, molto accurato e reattivo. Ma dopo tre o sei mesi succede qualcosa di strano. I tempi di risposta rallentano, i costi operativi salgono e l'agente comincia ad allucinare o a discostarsi dal comportamento previsto. La pratica standard in molte organizzazioni è aggiungere potenza di calcolo o passare a un modello linguistico più grande. Ma, come vedremo in dettaglio, il problema di fondo non è il modello in sé: è l'architettura sottostante dei tuoi prompt.
In questo post vedremo perché i prompt monolitici portano a un degrado catastrofico del contesto, come separare i comportamenti universali di base dai flussi di lavoro specifici per attività e perché i pattern di progettazione modulari stanno cambiando il panorama dell'AI enterprise.
Introduzione: il costo nascosto dei prompt monolitici
Quando i team di ingegneria prototipano per la prima volta agenti AI conversazionali, di solito si affidano a un unico prompt di sistema completo. Questo prompt stabilisce chi è l'agente, come deve parlare, quali regole deve seguire e come gestire casi limite complessi. È un modo intuitivo per iniziare. Tuttavia, man mano che il business evolve, evolve anche il prompt. Le risorse umane aggiungono nuove policy sui congedi, la compliance introduce normative regionali e il supporto clienti aggiunge flussi di lavoro per i rimborsi.
Prima che te ne accorga, il prompt di sistema si gonfia fino a migliaia di token di istruzioni dense. Ogni volta che un utente pone una domanda semplice, come verificare gli orari di apertura dell'ufficio, il modello AI è costretto a elaborare e ragionare su ogni singola regola, criterio e caso limite contenuto nell'intero prompt di sistema. Anche se il novantacinque per cento di queste istruzioni è del tutto irrilevante per verificare gli orari di apertura, il modello deve comunque analizzarle. Questo costo nascosto in termini di calcolo e ragionamento è ciò che chiamiamo Context Tax e, nel tempo, altera in modo sostanziale le prestazioni del tuo agente AI.
Comprendere il Context Tax e perché gli agenti degradano nel tempo
Il degrado degli agenti in ambienti di produzione è sorprendentemente prevedibile. Non accade perché il modello sottostante abbia dimenticato come ragionare, ma perché sovraccarichiamo la finestra di contesto attiva del modello con rumore cognitivo. Quando costringi un'AI a passare al setaccio montagne di documentazione procedurale non pertinente a ogni interazione con l'utente, succedono contemporaneamente diverse cose:
- Il consumo di token aumenta in modo netto, facendo crescere direttamente i costi di inferenza per ogni richiesta.
- La latenza della risposta aumenta, perché contesti più grandi richiedono più tempo di elaborazione.
- La probabilità di allucinazioni cresce, perché il modello fatica a ponderare istruzioni contrastanti o irrilevanti.
- La coerenza del ragionamento cala, perché l'attenzione del modello si frammenta su troppe direttive in competizione.
Il sistema non è diventato meno intelligente: il suo percorso di ragionamento è semplicemente appesantito da dati superflui. Per risolvere il problema, dobbiamo osservare da vicino come distribuiamo le informazioni all'interno delle nostre architetture.
Guida sempre attiva vs. competenza situazionale
Uno dei cambi di mentalità più efficaci nell'ingegneria dell'AI moderna è separare le istruzioni di sistema in due categorie distinte: guida sempre attiva e competenza situazionale.
La guida sempre attiva comprende i guardrail universali e gli elementi identitari che devono applicarsi a ogni singola interazione, indipendentemente dall'intento dell'utente. Include:
- Identità, persona e tono di voce dell'agente
- Requisiti universali di sicurezza enterprise
- Regole di conformità di base e limiti assoluti
- Preferenze standard di formattazione e di output
La competenza situazionale, invece, è interamente contestuale. Si tratta di informazioni che hanno valore solo quando si attiva uno scenario o un flusso di lavoro specifico. Esempi includono i protocolli di onboarding dei fornitori, le normative sul calcolo delle imposte, le policy di reso regionali o le procedure complesse di risposta agli incidenti IT.
Nelle architetture legacy, entrambe le categorie finiscono in un unico, enorme prompt. In un'architettura moderna e ristrutturata, solo le indicazioni sempre attive restano caricate in modo permanente. Tutto il resto viene confezionato in componenti modulari che si caricano dinamicamente.
Anatomia di una Skill: impacchettare la conoscenza per l'AI
Per eliminare la Context Tax, dobbiamo disporre di un meccanismo che conservi le competenze situazionali al di fuori del prompt principale e le richiami solo quando servono. Questo meccanismo è la Skill di AI. Una Skill non è semplicemente un frammento di prompt: è un pacchetto completo e riutilizzabile di istruzioni e risorse specifiche per un compito. Una Skill ben progettata include in genere:
- Descrizioni chiare del trigger, che indicano all'orchestratore quando la Skill è pertinente
- Istruzioni procedurali strutturate per gestire il compito
- Documenti di riferimento, moduli o modelli di criteri
- Script o definizioni di API opzionali per eseguire azioni
Al centro di questo pacchetto c'è il file di configurazione principale, spesso strutturato come file SKILL.md. Questo file descrive l'ambito esatto, lo scopo e i passaggi di esecuzione per quello specifico dominio di conoscenza. Modularizzando la conoscenza in questo modo, si creano unità pulite e gestibili di capacità aziendale che possono essere aggiornate in modo indipendente senza mettere a rischio la stabilità dell'agente principale.
Definire confini di ragionamento chiari
Modularizzare l'agente AI in Skill distinte fa più che risparmiare token: stabilisce confini di ragionamento rigorosi. Quando a un modello viene fornito un prompt monolitico, cerca di risolvere ogni problema attraverso il filtro di tutte le regole contemporaneamente. Con le Skill, invece, si isola il dominio di ragionamento.
Ad esempio, quando un utente avvia un flusso di lavoro per gli acquisti, viene caricata la Skill dedicata agli acquisti e il motore di ragionamento dell'agente si concentra interamente su criteri di acquisto, gerarchie di approvazione e linee guida sui fornitori. Mentre la Skill è attiva, le regole non pertinenti, come quelle su detrazioni fiscali o politiche delle risorse umane, restano fuori dalla finestra di contesto attiva. Questo confine rigoroso migliora sensibilmente sia la precisione sia la coerenza dell'output dell'AI, garantendo che segua procedure specializzate senza interferenze da altre parti dell'azienda.
Implementare la divulgazione progressiva per l'efficienza
Come gestire queste Skill senza sovraccaricare il sistema? La risposta sta in un pattern di progettazione noto come divulgazione progressiva. Invece di caricare all'avvio ogni istruzione e flusso di lavoro, l'agente mantiene un catalogo leggero che contiene solo nomi e descrizioni delle Skill disponibili.
Quando un utente invia un prompt, il flusso di lavoro segue una sequenza precisa:
- L'orchestratore confronta la richiesta dell'utente con il catalogo leggero delle Skill.
- Individua la Skill specifica necessaria per gestire lo scenario.
- Il sistema carica dinamicamente quella singola Skill nella finestra di contesto.
- L'agente esegue il compito con elevata precisione.
- Al termine del compito, la Skill viene scaricata e l'agente torna al suo stato base snello.
Questo pattern riduce drasticamente i requisiti di calcolo, abbatte la latenza e tiene sotto controllo i costi operativi, garantendo al tempo stesso che gli agenti abbiano accesso a conoscenze aziendali approfondite e specialistiche.
Conclusione: ristrutturare l'architettura dell'AI per il futuro
I prompt monolitici hanno servito bene nelle prime fasi di sperimentazione con l'AI generativa, ma le implementazioni aziendali richiedono maggiore scalabilità, latenza più bassa e affidabilità più elevata. Separando le indicazioni sempre attive dalle competenze situazionali e adottando Skill modulari tramite la divulgazione progressiva, puoi eliminare la Context Tax, prevenire il degrado degli agenti e costruire sistemi di AI solidi che crescono in modo armonico insieme alla tua organizzazione.
Per ascoltare un'analisi completa di questi pattern architetturali, esempi di implementazione reali e il modo in cui questi concetti si applicano a piattaforme come Microsoft Copilot Studio, GitHub Copilot e Claude Code, non perdere l'episodio correlato: The End of AI Bloat: Why Modern Agents Need Skills. Sintonizzati, iscriviti e facci sapere come stai strutturando i tuoi agenti AI aziendali!