 JA
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 한국어
2026-10-08
産業データモデルとは何か
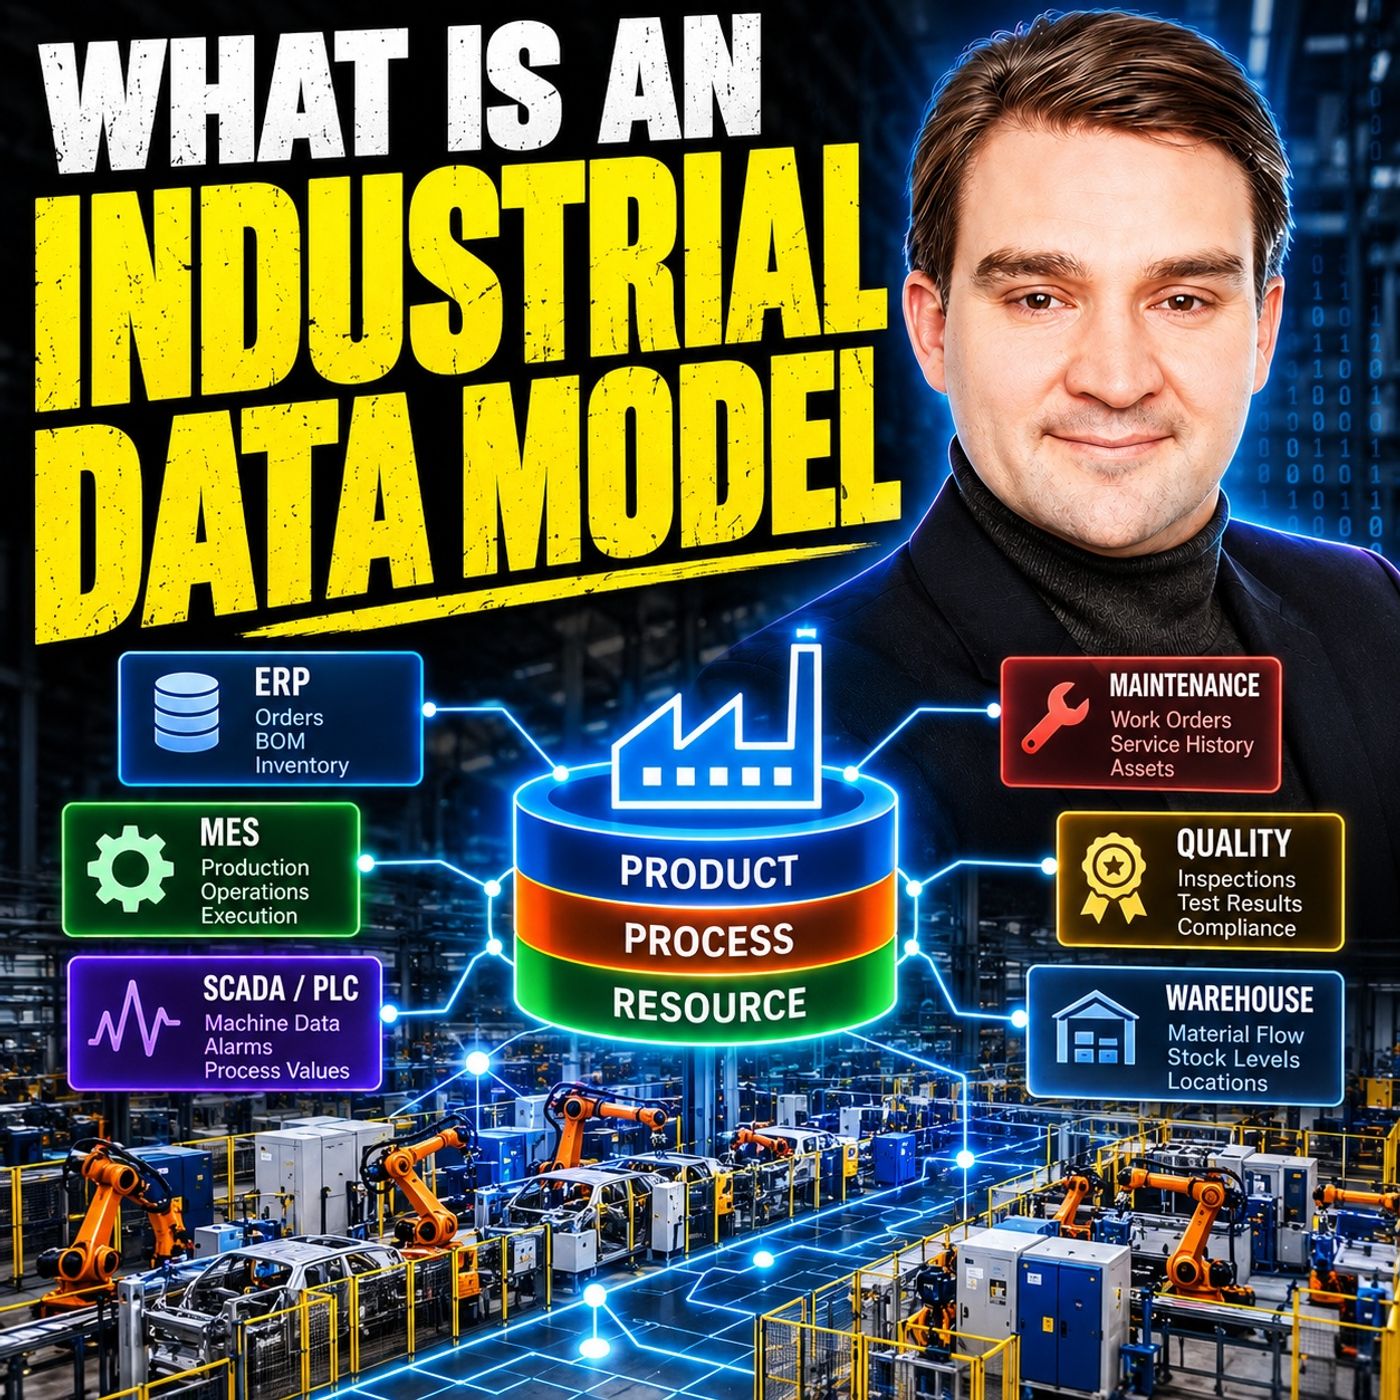
工場では膨大なデータを収集していても、基本的な運用上の問いに答えられないことがあります。この出来事は実際に何に影響するのか、という問いです。
ERPは顧客受注、材料、計画日、在庫を把握しています。MESは工場現場で実行中の作業を把握しています。PLCやSCADAは設備の状態、アラーム、プロセス値を把握しています。保全部門は設備の状態と修理履歴を把握しています。品質部門は検査と出荷可否の状態を把握しています。エンジニアリング部門は製品の定義を把握しています。通常、問題はデータが不足していることではありません。問題は、これらのシステムがそれぞれ異なる名称、ID、状態、ルールで同じ工場を表現していることにあります。
産業向けデータモデルは、こうした境界をまたいで共通の意味を作り出します。重要な工場オブジェクトを定義し、安定した識別子を与え、製品、工程、リソース、受注、材料、人員、工具、品質記録、設備イベントがどのように関係するかを記述します。目的はERP、MES、保全などのソースシステムを置き換えることではありません。それぞれの情報を、ひとつにつながった生産コンテキストとして理解できるようにすることが目的です。
多数のシステムがあっても共通の意味がない
現代の工場には、ほぼすべての重要な業務に専用のシステムがあります。ERPは需要と約束を管理し、MESは実行を管理し、PLCは設備を制御し、SCADAは設備状態を表示し、ヒストリアンはプロセスデータを蓄積し、保全システムは設備と修理作業を管理し、品質システムは検査記録を保持します。Power BIはこれらの情報を組み合わせてレポートにできます。
それぞれのシステムには存在理由があります。問題が生じるのは、同じ実世界のオブジェクトが、各システムで異なる形で現れる場合です。ある機械は、ERPでは作業センター、保全システムでは設備番号、MESではリソース、制御システムではOPC UAノードのグループ、現場では全く別の呼び名として表現されることがあります。
産業向けモデルは、これらすべてのシステムに単一の識別子を強制するわけではありません。代わりに、各参照が同じ物理的または論理的なオブジェクトとどう関係するかを記録します。これにより、各ソースシステムが必要とするローカルな構造を壊すことなく、工場に安定した識別レイヤーを与えることができます。
産業向けデータモデルの実体
産業向けデータモデルとは、工場で何が重要であり、それらがどのように結びつくかを記述する、共有されたルールの集合です。
それは、生産オーダーとして何を数えるのか、製品リビジョンが何を表すのか、作業センターと物理的な設備の違いは何か、材料はいつリリースされるのか、設備が「稼働可能」であるとは実際に何を意味するのか、といった実務的な問いに答えます。
モデルが記述できるものは次のとおりです。
・オブジェクトの種類と識別子
・プロパティと状態
・工場オブジェクト間の関係
・ソースシステムの参照
・有効日とバージョン
・関係に付随する条件
・定義とルールの所有者
これにより、複数のシステムが、誤解を招く単一のステータスにまとめることなく、同じ生産状況の異なる側面を記述できるようになります。ERPでは受注がリリースされていても、MESの現在の工程が停止したままになることがあります。設備が機械的には健全でも、必要な治具が欠けているため稼働不可となることもあります。これらの事実は同時に成り立ちます。
モデルはデータプラットフォームそのものではない
Microsoft Fabric、SQLデータベース、ヒストリアン、データレイクなどのプラットフォームは、情報の保存、移動、ガバナンス、分析に有用です。しかし、記録を一緒に保存したからといって、それらが自工場における作業センーの意味を決められるわけではありません。
ERPの受注、MESの実行記録、保全イベント、品質結果、設備のテレメトリを1つのLakehouseに読み込んでも、ある作業を終業前に別の設備へ移せるかどうか、という問いには答えられないことがあります。その答えは関係性に依存するからです。
どの製品リビジョンが関係するのか。次にどの工程を実行しなければならないのか。その工程にはどのリソースが承認されているのか。必要な工具は何か。作業者は資格を持っているのか。現在の設備状態で作業が許可されるのか。代替ルートに検査ルールが付随しているか。
プラットフォームはこれらの関係を保持し照会できますが、それを定義するのは依然として工場の役割です。
表だけでは難しくなる理由
リレーショナルテーブルそのものが問題なのではありません。ERP、MES、保全、そして多くの製造アプリケーションは、トランザクションと構造化された記録に優れたリレーショナルモデルに依存しています。
困難が生じるのは、時間とともに変化する多数の関係をまたぐ生産上の問いが発生したときです。
製品リビジョンには複数の工程が必要かもしれません。ある工程は複数のリソースで承認されている場合があります。ある設備は、特定の製品バージョン、工具の組み合わせ、サイズ範囲、検査要件などの一部しか対応できないことがあります。作業者の資格は期限切れになることがあります。設計変更によって、以前承認されたルートが無効になることもあります。
これらはすべてテーブルで表現できますが、そのロジックはレポート、SQLクエリ、スプレッドシート、現場のローカルな例外リストに分散しがちです。その結果、異なるレポートがそれぞれ異なる形で同じ工場の関係を再構築してしまいます。
産業向けモデルは共有された関係レイヤーを提供し、ルールを一度定義して統制し、再利用できるようにします。難しい生産上の問いが出るたびに、ルールを再発見する必要はなくなります。
PPR:製品、工程、リソース
実用的な出発点となる構造がPPR、すなわち製品(Product)、工程(Process)、リソース(Resource)です。
製品は「何を作っているのか」に答えます。
工程は「作業はどのように行われるべきか」に答えます。
リソースは「実際の生産条件のもとで、その作業を何が実行できるか」に答えます。
PPRは、孤立した記録を生産モデルへとつなぐための単純な基盤を提供します。企業全体を一度にモデル化しようとするのではなく、作業が実際に可能かどうかを決める関係に焦点を当てます。
製品は品番以上のもの
製品定義には、製品ファミリー、特定のバリアント、リビジョン、部品表、顧客構成、材料要件、検査要件、品質ルールが含まれることがあります。
これが重要なのは、同じ大まかな品番を持つ2つの記録が互換性を持つとは限らないからです。新しいリビジョンでは、より厳しい公差、異なるプロセスパラメータ、追加の検査工程、より高い能力を持つ設備が必要になることがあります。
PLMのようなエンジニアリングシステムが設計意図を所有することがあります。ERPは材料マスタと計画版を保持するかもしれません。MESは生産定義を保持し、品質部門は検査計画を管理するかもしれません。
産業向けモデルはこれらの参照をつなぎ、生産が「この品番は何か」よりもはるかに重要な問いに答えられるようにします。
それは次の問いに答えられます。現在適用されているルールのもとで、正しいリビジョンを製造しているか。
工程は作業がどのように行われるべきかを定義する
工程側は、生産を通じて承認されたルートを記述します。それは単なる設備のリストにとどまりません。
工程には、作業順序、段取り要件、検査ポイント、待ち時間、手直しの経路、承認、引き継ぎ、作業を続行する前に満たすべき条件などが記述できます。
計画された工程定義は、作業が本来どのように行われるべきかを記述します。MESの実行データは、特定のオーダーで実際に何が起きたかを記録します。
両方が重要です。
計画された工程がなければ、実行が承認されたルートに従ったかどうかを判断できません。実行履歴がなければ、生産中に実際に何が起きたかを学ぶことができません。
リソースは機械ではなく能力を意味する
生産リソースは、機械、ライン、ワークステーション、工具、治具、テストリグ、搬送システム、作業者、その他作業の実行に必要な能力のいずれでもあり得ます。
この区別は重要です。機械は技術的には稼働可能でも、工程そのものが実行不可能であることがあるからです。
必要な治具が別の場所で使用中かもしれません。工具が校正期限切れかもしれません。資格を持つ唯一の作業者が現在のシフトにいないかもしれません。設備は製品ファミリーには対応していても、現在のリビジョンには対応していないかもしれません。
Apple Podcasts · Spotify · YouTube · Deezer
What Is an Industrial Data Model (English)