 PT
 English
 Deutsch
 Español
 Français
 Italiano
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Orientação sempre ativa vs. expertise situacional: como reestruturar a arquitetura da sua IA
By Mirko Peters ·
Bem-vindo de volta ao blog complementar do nosso podcast. No post de hoje, vamos mergulhar fundo em um obstáculo técnico que quase toda equipe corporativa enfrenta depois de implantar sua primeira onda de soluções de IA. Você cria um agente de IA personalizado e, no início, parece mágica. Ele é rápido, muito preciso e extremamente responsivo. Mas avance três a seis meses. Algo estranho acontece. O
Automatically translated with AI from the original post. Read the English original
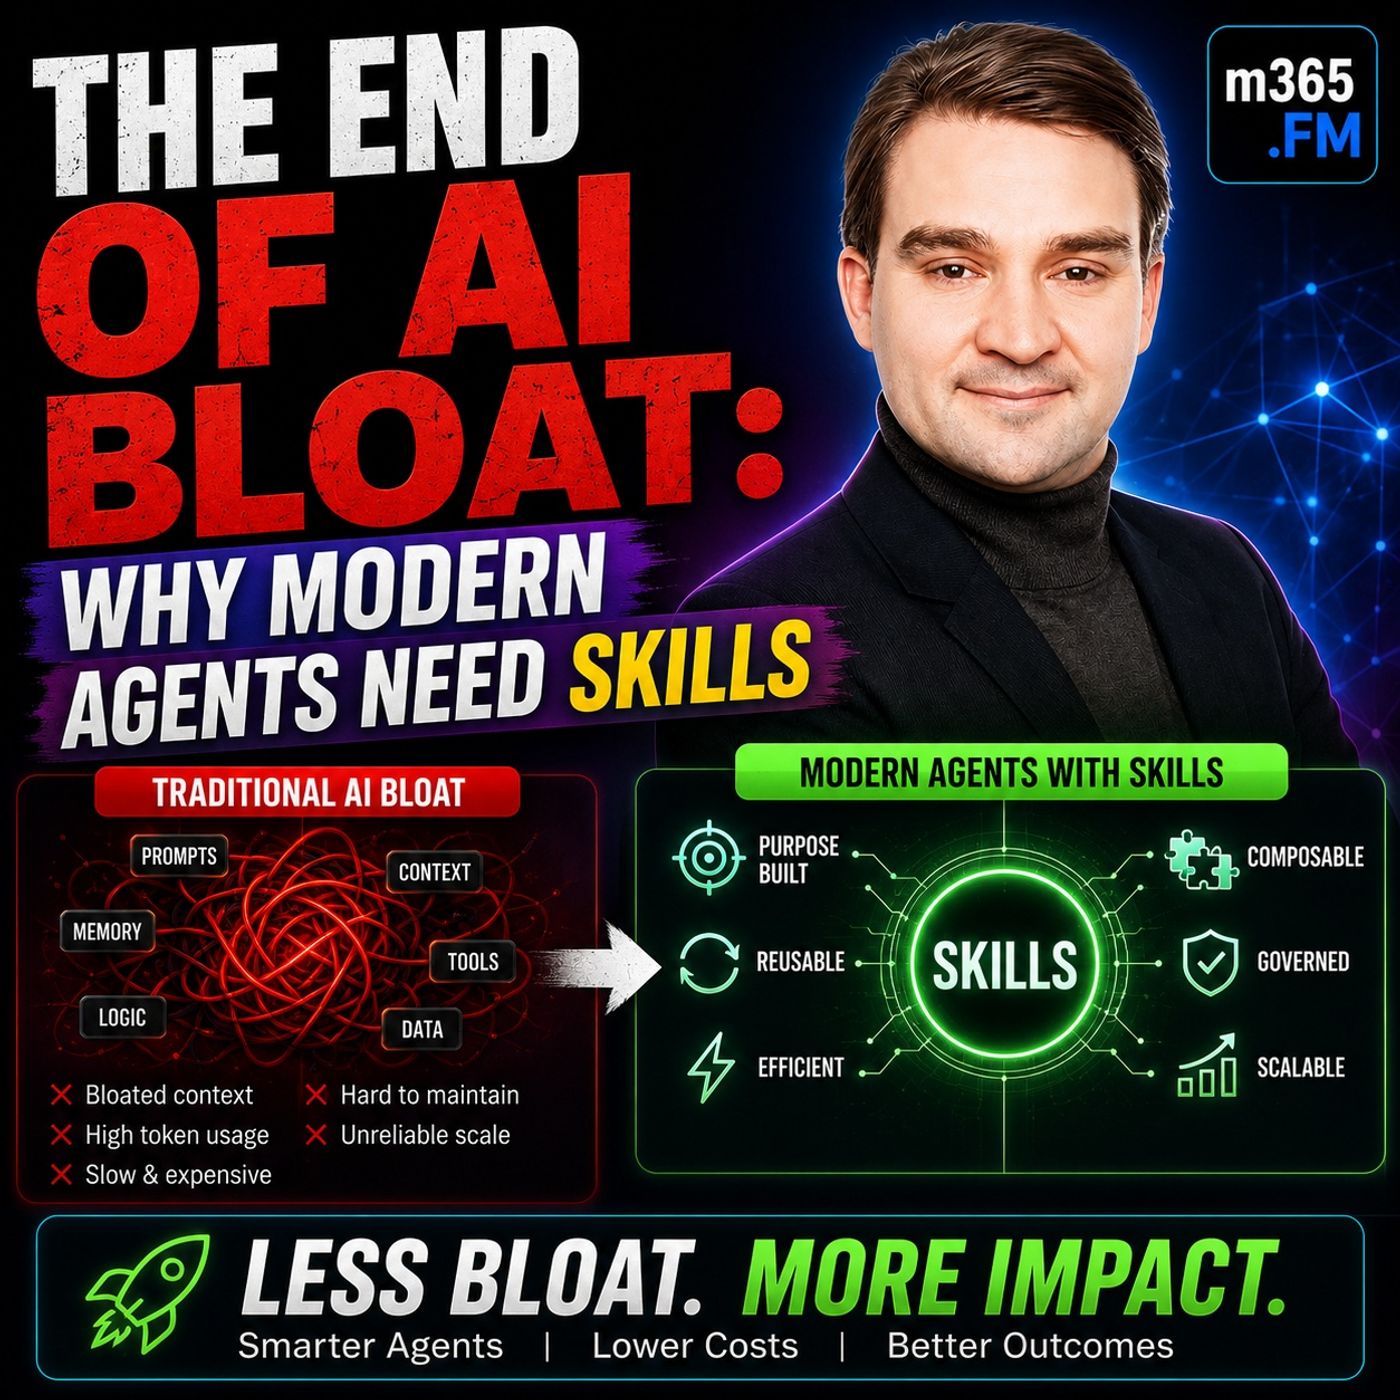
Bem-vindo de volta ao blog complementar do nosso podcast. No post de hoje, vamos mergulhar fundo em um obstáculo técnico que quase toda equipe corporativa enfrenta depois de implantar sua primeira onda de soluções de IA. Você cria um agente de IA personalizado e, no início, parece mágica. Ele é rápido, muito preciso e extremamente responsivo. Mas avance três a seis meses. Algo estranho acontece. Os tempos de resposta ficam lentos, os custos operacionais sobem aos poucos e o agente começa a alucinar ou a se afastar do comportamento pretendido. A prática comum em muitas organizações é jogar mais capacidade de processamento no problema ou atualizar para um modelo de linguagem maior. Mas, como exploramos em profundidade, o problema central não é o modelo em si, e sim a arquitetura subjacente dos seus prompts.
Neste post, vamos detalhar por que prompts monolíticos levam a uma degradação catastrófica do contexto, como separar comportamentos centrais universais de fluxos de trabalho específicos de cada tarefa e por que padrões de design modulares estão transformando o cenário da IA nas empresas.
Introdução: o custo oculto dos prompts monolíticos
Quando as equipes de engenharia prototipam pela primeira vez agentes de IA conversacionais, normalmente se apoiam em um único prompt de sistema abrangente. Esse prompt define quem é o agente, como ele deve falar, quais regras deve seguir e como deve lidar com casos extremos complexos. É uma forma intuitiva de começar. No entanto, à medida que o negócio evolui, o prompt também evolui. RH acrescenta novas políticas de licença, compliance introduz regulamentações regionais e o suporte ao cliente anexa fluxos de reembolso.
Quando você percebe, seu prompt de sistema já inchou para milhares de tokens de instruções densas. Toda vez que um usuário faz uma pergunta simples, como consultar o horário de funcionamento do escritório, o modelo de IA é obrigado a absorver, processar e raciocinar sobre cada regra, política e caso extremo de todo o seu prompt de sistema. Mesmo que noventa e cinco por cento dessas instruções sejam completamente irrelevantes para consultar o horário de funcionamento, o modelo ainda precisa analisá-las. Esse custo oculto em processamento e raciocínio é o que chamamos de Context Tax (imposto de contexto), e ele altera fundamentalmente as características de desempenho do seu agente de IA com o passar do tempo.
Entendendo o Context Tax e por que os agentes degradam com o tempo
A degradação de agentes em ambientes de produção é notavelmente previsível. Ela não acontece porque o modelo subjacente esqueceu como raciocinar. Acontece porque sobrecarregamos a janela de contexto ativa do modelo com ruído cognitivo. Quando você obriga uma IA a vasculhar montanhas de documentação procedimental não relacionada a cada interação com o usuário, várias coisas acontecem simultaneamente:
- O consumo de tokens dispara, aumentando diretamente o custo de inferência por requisição.
- A latência de resposta aumenta, porque contextos maiores exigem mais tempo para processamento.
- A probabilidade de alucinações cresce à medida que o modelo tem dificuldade para ponderar instruções conflitantes ou irrelevantes.
- A consistência do raciocínio cai, porque a atenção do modelo se fragmenta entre diretivas concorrentes demais.
O sistema não ficou menos inteligente; seu caminho de raciocínio simplesmente foi sobrecarregado por dados desnecessários. Para resolver isso, precisamos observar com atenção como distribuímos as informações dentro das nossas arquiteturas.
Orientação sempre ativa vs. expertise situacional
Uma das mudanças de mentalidade mais poderosas que você pode fazer na engenharia de IA moderna é separar as instruções do sistema em duas categorias distintas: orientação sempre ativa e expertise situacional.
A orientação sempre ativa consiste nas salvaguardas universais e nos marcadores de identidade que devem se aplicar a cada interação, independentemente da intenção do usuário. Isso inclui:
- Identidade, persona e tom de voz do agente
- Requisitos universais de segurança corporativa
- Regras centrais de compliance e limites absolutos
- Preferências padronizadas de formatação e saída
A expertise situacional, por outro lado, é totalmente contextual. São informações que só têm valor quando um cenário ou fluxo de trabalho específico é acionado. Exemplos incluem protocolos de onboarding de fornecedores, regras de cálculo de impostos, políticas regionais de devolução ou procedimentos complexos de resposta a incidentes de TI.
Em arquiteturas legadas, as duas categorias são reunidas em um único prompt enorme. Em uma arquitetura moderna e reestruturada, apenas as orientações sempre ativas permanecem carregadas o tempo todo. Todo o restante é empacotado em componentes modulares que são carregados dinamicamente.
Anatomia de uma Skill: empacotando conhecimento para a IA
Para eliminar o Context Tax, precisamos de um mecanismo que armazene a expertise situacional fora do prompt principal e a traga para dentro apenas quando necessário. Esse mecanismo é a Skill de IA. Uma Skill não é apenas um trecho de prompt; ela é um pacote completo e reutilizável de instruções e recursos específicos para uma tarefa. Uma Skill bem projetada normalmente inclui:
- Descrições claras de gatilho que informam ao orquestrador quando a Skill é relevante
- Instruções procedimentais estruturadas para a execução da tarefa
- Documentos de referência, formulários ou modelos de política
- Scripts ou definições de API opcionais para executar ações
No centro desse pacote está o arquivo de configuração principal, geralmente estruturado como um arquivo SKILL.md. Esse arquivo descreve o escopo exato, a finalidade e as etapas de execução para aquele domínio específico de conhecimento. Ao modularizar o conhecimento dessa forma, você cria unidades limpas e sustentáveis de capacidade empresarial, que podem ser atualizadas de forma independente sem comprometer a estabilidade do agente principal.
Estabelecendo limites de raciocínio claros
Modularizar seu agente de IA em Skills distintas faz mais do que economizar tokens: estabelece limites de raciocínio rigorosos. Quando um modelo recebe um prompt monolítico, ele tenta resolver todos os problemas sob a ótica de todas as regras ao mesmo tempo. Ao usar Skills, você isola o domínio de raciocínio.
Por exemplo, quando um usuário inicia um fluxo de trabalho de compras, a Skill de compras é carregada, e o mecanismo de raciocínio do agente se concentra exclusivamente em políticas de compra, hierarquias de aprovação e diretrizes de fornecedores. Enquanto essa Skill está ativa, regras não relacionadas, como as de dedução de impostos ou as políticas de recursos humanos, ficam fora da janela de contexto ativa. Esse limite rigoroso melhora de forma significativa tanto a precisão quanto a consistência da saída da IA, garantindo que ela siga procedimentos especializados sem interferência de outras áreas do negócio.
Implementando a divulgação progressiva para mais eficiência
Como gerenciar essas Skills sem sobrecarregar o sistema? A resposta está em um padrão de design conhecido como divulgação progressiva. Em vez de carregar todas as instruções e fluxos de trabalho na inicialização, seu agente mantém um catálogo leve que contém apenas os nomes e as descrições das Skills disponíveis.
Quando um usuário envia um prompt, o fluxo de trabalho segue uma sequência precisa:
- O orquestrador analisa a solicitação do usuário em relação ao catálogo leve de Skills.
- Ele identifica a Skill específica necessária para tratar o cenário.
- O sistema carrega dinamicamente essa única Skill na janela de contexto.
- O agente executa a tarefa com alta precisão.
- Quando a tarefa é concluída, a Skill é descarregada, devolvendo o agente ao seu estado enxuto e básico.
Esse padrão de design reduz drasticamente a necessidade de processamento, diminui a latência e mantém os custos operacionais sob controle, ao mesmo tempo em que garante que seus agentes continuem tendo acesso a conhecimento empresarial profundo e especializado.
Conclusão: reestruturando sua arquitetura de IA para o futuro
Os prompts monolíticos foram úteis nos primeiros dias da experimentação com IA generativa, mas as implantações corporativas exigem mais escalabilidade, menor latência e maior confiabilidade. Ao separar as orientações sempre ativas da expertise situacional e adotar Skills modulares por meio da divulgação progressiva, você pode eliminar o Context Tax, evitar a degradação dos agentes e construir sistemas de IA robustos que escalam com elegância junto com a sua organização.
Para ouvir uma análise completa desses padrões de arquitetura, exemplos reais de implementação e como esses conceitos se aplicam a plataformas como Microsoft Copilot Studio, GitHub Copilot e Claude Code, não deixe de conferir nosso episódio relacionado: The End of AI Bloat: Why Modern Agents Need Skills. Acompanhe, inscreva-se e nos conte como você está estruturando seus agentes de IA corporativos!