 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Azure Event Hubs meistern: Partitionen, Consumer Groups und Skalierung
Von Mirko Peters ·
Willkommen zurück bei unserer fortlaufenden Reihe zu Cloud-Architektur und Echtzeit-Datentechnik. In der Welt moderner Unternehmensanwendungen ist das Datenvolumen, das von Benutzern, IoT-Geräten, Microservices und Log-Aggregatoren erzeugt wird, enorm. Unternehmen wollen Daten nicht mehr nur über Nacht für die Stapelverarbeitung speichern; sie brauchen jetzt verwertbare Erkenntnisse. Um diesem Bed
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
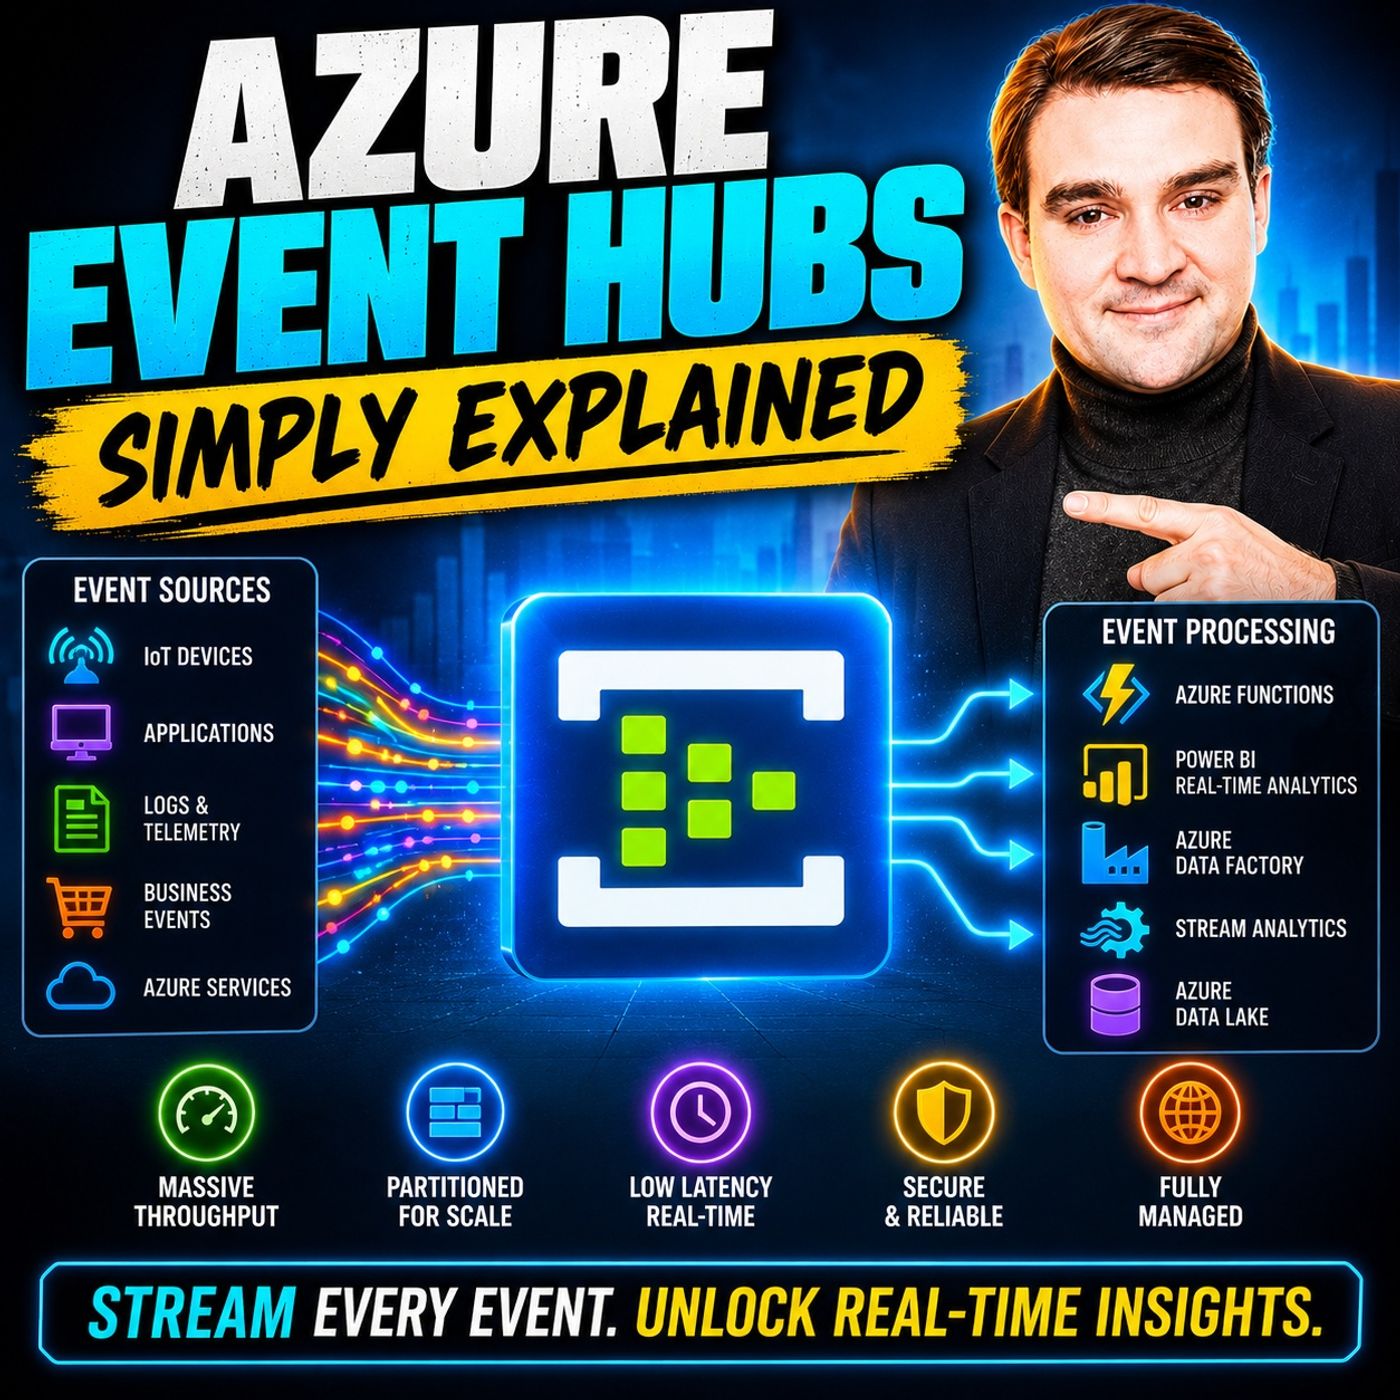
Willkommen zurück bei unserer fortlaufenden Reihe zu Cloud-Architektur und Echtzeit-Datentechnik. In der Welt moderner Unternehmensanwendungen ist das Datenvolumen, das von Benutzern, IoT-Geräten, Microservices und Log-Aggregatoren erzeugt wird, enorm. Unternehmen wollen Daten nicht mehr nur über Nacht für die Stapelverarbeitung speichern; sie brauchen jetzt verwertbare Erkenntnisse. Um diesem Bedarf gerecht zu werden, greifen Cloud-Architekten auf leistungsstarke Event-Streaming-Plattformen zurück. Wenn Sie Lösungen im Microsoft-Azure-Ökosystem entwickeln, sticht Azure Event Hubs als führender, vollständig verwalteter Dienst für die Datenaufnahme im großen Maßstab hervor.
In diesem umfassenden Leitfaden tauchen wir tief in die zentralen Architekturkomponenten ein, die Azure Event Hubs funktionieren lassen. Wir zeigen, wie Partitionen eine massive parallele Verarbeitung ermöglichen, untersuchen, wie Consumer Groups es mehreren Anwendungen erlauben, denselben Stream zu lesen, ohne sich gegenseitig zu behindern, und betrachten Skalierungsstrategien wie Durchsatzeinheiten und Auto-Inflate. Ob Sie ein System zur Erkennung von Finanzbetrug oder eine globale Telemetrie-Pipeline entwerfen: Das Verständnis dieser grundlegenden Konzepte ist entscheidend für Ihren Erfolg.
Wenn Sie lieber auditiv lernen, schauen Sie sich unbedingt unsere passende Podcast-Folge an: Azure Event Hubs - Simply Explained. Darin erläutern wir diese Architekturmuster in klarer, praxisnaher Sprache.
Einführung in die Architektur von Azure Event Hubs
Im Kern ist Azure Event Hubs als hochskalierbare Engine zur Ereignisaufnahme konzipiert. Sie kann Millionen Ereignisse pro Sekunde mit extrem niedriger Latenz empfangen und verarbeiten und dient als Eingangstor für Big-Data-Pipelines in der Cloud. Stellen Sie sich das als ein riesiges, gut organisiertes Parkhaus für Datenpakete vor. Produzenten wie mobile Apps, Serverprotokolle oder Sensoren in Fabriken legen ihre Nutzdaten im Hub ab, und Konsumenten wie Azure Stream Analytics, Azure Functions oder eigene Worker-Dienste holen sie zur Verarbeitung ab.
Anders als klassische Nachrichtenwarteschlangen, die Nachrichten so lange speichern, bis ein einzelner Konsument sie bestätigt (woraufhin die Nachricht entfernt wird), arbeitet Azure Event Hubs nach einem Streaming-Modell. Die Daten werden an ein unveränderliches Protokoll angehängt. Dadurch können mehrere nachgelagerte Systeme denselben Datenstrom unabhängig voneinander und in ihrem eigenen Tempo lesen, ohne dass die Daten für andere Leser verloren gehen. Um die enorme Geschwindigkeit moderner Workloads zu bewältigen, setzt Event Hubs auf eine verteilte Architektur, die auf zwei grundlegenden Konzepten beruht: Partitionen und Consumer Groups.
Partitionen für die parallele Verarbeitung verstehen
Wenn Sie einen hohen Durchsatz erreichen wollen, dürfen Sie nicht alle eingehenden Daten durch einen einzigen Verarbeitungsengpass leiten. Genau hier kommen Partitionen ins Spiel. Eine Partition ist im Grunde eine eigenständige Folge von Ereignissen innerhalb eines Event Hubs. Beim Erstellen eines Event Hubs müssen Sie die Anzahl der Partitionen festlegen. Bei den Standard-Tarifen liegt sie typischerweise zwischen 2 und 32, für dedizierte Umgebungen sind jedoch deutlich höhere Grenzwerte verfügbar.
Wenn Produzenten Ereignisse senden, können sie einen Partitionsschlüssel angeben, etwa eine Geräte-ID, eine Benutzer-ID oder eine Transaktionsregion. Event Hubs bildet einen Hash aus diesem Schlüssel und leitet das Ereignis an eine bestimmte Partition weiter. Dadurch landen alle Ereignisse mit demselben Schlüssel immer in genau derselben Partition, was die strikte Reihenfolge zusammengehöriger Daten sicherstellt.
Die eigentliche Stärke der Partitionen liegt in der parallelen Verarbeitung. Indem Sie den gesamten Datenstrom in mehrere unabhängige Abschnitte aufteilen, können mehrere Consumer-Instanzen gleichzeitig aus verschiedenen Partitionen lesen. Hat Ihr Event Hub beispielsweise 16 Partitionen, können Sie eine Consumer-Anwendung mit 16 eigenständigen Leser-Instanzen bereitstellen, die jeweils einer einzelnen Partition zugeordnet sind. Dieses horizontale Skalierungsmodell sorgt dafür, dass die Verarbeitungsleistung linear mit der Last wächst.
Consumer Groups für unabhängigen Datenzugriff nutzen
In einer komplexen Unternehmensumgebung wird ein einzelner Datenstrom selten nur von einem Team genutzt. Ihr Security Operations Center möchte vielleicht Protokolle auf Auffälligkeiten prüfen, Ihr Data-Science-Team möchte Telemetriedaten in ein Machine-Learning-Modell einspeisen, und Ihre Abrechnungsabteilung möchte Nutzungsmetriken erfassen – alle aus genau demselben eingehenden Ereignisstrom.
Azure Event Hubs löst diese Herausforderung über Consumer Groups. Eine Consumer Group stellt eine vollständige Sicht auf einen gesamten Event Hub dar. Sie fungiert als Cursor oder als Lesezeichen-Verwaltung. Indem Sie mehrere Consumer Groups anlegen, können mehrere verbrauchende Anwendungen den Ereignisstrom gleichzeitig und unabhängig voneinander vom Anfang bis zum Ende lesen.
Da jede Consumer Group ihren eigenen, separaten Offset verwaltet – also einen Zeiger, der angibt, welche Ereignisse bereits gelesen wurden –, kann Consumer-Anwendung A Ereignisse in Echtzeit verarbeiten, während Consumer-Anwendung B zurückliegt oder historische Daten vom Anfang des Tages erneut abspielt, ohne dass sich die beiden gegenseitig beeinflussen. Genau diese Entkopplung von Producern und Consumern macht Event Hubs zu einem so vielseitigen Integrationshub für moderne Unternehmensarchitekturen.
Skalierungsstrategien: Throughput Units, Processing Units und Auto-Inflate
Kapazitäten effektiv zu verwalten, gehört zu den wichtigsten Aufgaben eines Cloud-Architekten. Azure Event Hubs bietet flexible Preisstufen und Skalierungsmechanismen, damit Ihre Architektur auch unter wechselnden Lasten leistungsfähig und kosteneffizient bleibt.
In der Standard-Stufe wird die Kapazität in Throughput Units (TUs) gemessen. Eine einzelne Throughput Unit bietet Ihnen 1 MB/s Eingangs- und 2 MB/s Ausgangsdurchsatz sowie bis zu 1.000 eingehende Ereignisse pro Sekunde je TU. Steigt der Datenverkehr sprunghaft an, ist manuelles Skalieren mühsam und fehleranfällig. Zum Glück bietet Event Hubs mit Auto-Inflate eine native Auto-Skalierungsfunktion.
Ist Auto-Inflate aktiviert, skaliert Azure die Anzahl der Throughput Units automatisch abhängig von der Last. So werden Drosselungen verhindert, und Ihre Ingestion-Pipeline verliert auch bei unerwarteten Lastspitzen keine Daten. Für Organisationen, die dedizierte, isolierte Rechenressourcen mit verlässlicher Leistung benötigen, bieten die Premium- und die Dedicated-Stufe Processing Units (PUs). Sie bringen höhere Grenzwerte, keine Beeinflussung durch sogenannte Noisy Neighbors und eine Isolation auf Unternehmensniveau.
Datenzuverlässigkeit, Aufbewahrung und Disaster Recovery
Bei hochfrequenter Telemetrie und kritischen Geschäftsprotokollen ist Datenverlust schlicht keine Option. Azure Event Hubs enthält robuste Mechanismen, die Datenbeständigkeit und hohe Verfügbarkeit garantieren.
Daten, die in Event Hubs geschrieben werden, werden standardmäßig innerhalb einer Azure-Region über mehrere Fehlerdomänen hinweg repliziert. Zudem bewahrt die Standard-Stufe Daten bis zu 7 Tage auf, während die Premium- und die Dedicated-Stufe die Aufbewahrung auf bis zu 90 Tage verlängern. Dieses Aufbewahrungsfenster ermöglicht es Anwendungen, sich nach längeren Ausfällen zu erholen, indem sie Daten ab einem bestimmten Zeitpunkt erneut abspielen.
Für geschäftskritische Anwendungen, die Schutz vor regionalen Ausfällen benötigen, stellt Azure Geo-Disaster-Recovery- und Geo-Replikationsfunktionen bereit. Indem Sie einen primären Namespace mit einem sekundären Namespace in einer gekoppelten Azure-Region verbinden, können Organisationen ihre Datenpipelines im Katastrophenfall schnell umschalten und dabei strenge Recovery Time Objectives (RTO) und Recovery Point Objectives (RPO) einhalten.
Azure Event Hubs, Service Bus und Apache Kafka im Vergleich
Architekten tun sich oft schwer, den richtigen Messaging-Dienst in Azure auszuwählen, weil das Portfolio mehrere leistungsstarke Optionen umfasst. Um die richtige Wahl zu treffen, hilft es, zu verstehen, wie sich Event Hubs im Vergleich zu Azure Service Bus und Apache Kafka schlägt.
Azure Service Bus ist für Enterprise-Messaging-Muster konzipiert. Der Fokus liegt auf verlässlichen Garantien wie Transaktionen, Dead-Lettering, Sessions und komplexem Pub/Sub-Routing bei vergleichsweise moderaten Datenmengen. Azure Event Hubs hingegen ist speziell für die Aufnahme massiver Telemetriedaten und die Verarbeitung von Streams mit hohem Durchsatz gebaut. Wenn Sie Millionen schlanker Ereignisse pro Sekunde verarbeiten müssen, ist Event Hubs deutlich kosteneffizienter und leistungsstärker als Service Bus.
Im Vergleich zum Open-Source-Produkt Apache Kafka bietet Azure Event Hubs einen klaren betrieblichen Vorteil: Der Dienst ist vollständig verwaltet. Sie müssen keine Cluster verwalten, Zookeeper nicht konfigurieren und sich nicht um das Patchen des Betriebssystems kümmern. Event Hubs stellt sogar einen Kafka-kompatiblen Endpunkt bereit. Damit können bestehende Kafka-Anwendungen mit minimalen Codeänderungen eine Verbindung zu Azure Event Hubs herstellen. Sie erhalten so das Beste aus beiden Welten.
Bewährte Methoden für den Entwurf robuster Streaming-Pipelines
Eine Streaming-Pipeline auf Unternehmensniveau erfordert sorgfältige Planung und die Einhaltung bewährter Methoden. Zum Abschluss unserer Architekturbetrachtung sollten Sie die folgenden zentralen Empfehlungen im Blick behalten:
- Planen Sie die Anzahl der Partitionen sorgfältig: Beachten Sie, dass Sie Durchsatzeinheiten zwar dynamisch skalieren können, die Anzahl der Partitionen jedoch festgelegt ist, sobald Sie einen Event Hub erstellen. Wählen Sie eine Partitionsanzahl, die künftiges Wachstum berücksichtigt, ohne unnötigen Koordinationsaufwand zu verursachen.
- Wählen Sie die richtigen Partitionsschlüssel: Verwenden Sie aussagekräftige Partitionsschlüssel, damit die Daten gleichmäßig auf die Partitionen verteilt werden. So vermeiden Sie „Hot Partitions“, bei denen ein einzelner Schlüssel die Ressourcen monopolisiert.
- Implementieren Sie eine robuste Fehlerbehandlung: Integrieren Sie Wiederholungsrichtlinien und Mechanismen für Dead-Lettering in Ihre Consumer-Anwendungen, damit Poison Messages und vorübergehende Netzwerkfehler sauber abgefangen werden.
- Überwachen Sie Drosselungen: Verwenden Sie Azure Monitor, um Metriken wie eingehende Anforderungen, gedrosselte Anforderungen und den Zustand der Partitionen zu erfassen. So stellen Sie sicher, dass Ihre Anwendung deutlich innerhalb der bereitgestellten Grenzwerte bleibt.
Wer Partitionen, Consumer-Gruppen und Skalierungsstrategien beherrscht, kann Streaming-Pipelines entwickeln, die nicht nur blitzschnell, sondern auch belastbar und skalierbar sind und jedes Datenvolumen bewältigen, mit dem Ihre Organisation konfrontiert wird.
In diesem Blogbeitrag haben wir die grundlegende Architektur von Azure Event Hubs untersucht. Dabei haben wir gezeigt, wie Partitionen eine parallele Verarbeitung ermöglichen, wie Consumer-Gruppen unabhängige Workloads voneinander entkoppeln und wie automatische Skalierungsmechanismen Ihre Anwendungen auch unter hoher Last stabil halten. Für den Einstieg erstellen Sie im Azure-Portal einen Event Hubs-Namespace, konfigurieren Ihre erste Consumer-Gruppe und binden einen Stream-Prozessor an.
Um Ihr Wissen zu vertiefen und praxisnahe Diskussionen zu diesem Thema zu hören, hören Sie sich unbedingt unsere Podcast-Episode an: Azure Event Hubs - Simply Explained. Nutzen Sie die Möglichkeiten der Echtzeit-Datenstreaming und gestalten Sie Ihre Data-Engineering-Workflows noch heute neu! 🚀
Häufige Fragen
Was ist Azure Event Hubs?
Azure Event Hubs ist eine vollständig verwaltete Plattform für Event-Streaming mit hohem Durchsatz. Sie kann Millionen Ereignisse pro Sekunde mit geringer Latenz aufnehmen und verarbeiten und eignet sich damit ideal für moderne Echtzeit-Datenpipelines.
Wie funktionieren Partitionen in Azure Event Hubs?
Partitionen unterteilen den gesamten Datenstrom in unabhängige Sequenzen. Producer leiten Ereignisse mithilfe eines Partitionsschlüssels an Partitionen weiter. So können mehrere Consumer-Instanzen die Daten parallel lesen und den Verarbeitungsdurchsatz maximieren.
Worin unterscheidet sich ein Event Hub von einer Consumer-Gruppe?
Ein Event Hub ist der zentrale Log-Speicher für eingehende Ereignisse, während eine Consumer-Gruppe eine eigenständige Sicht auf diesen Ereignisstrom darstellt. Mehrere Consumer-Gruppen ermöglichen es verschiedenen Anwendungen, dieselben Daten unabhängig voneinander zu lesen, ohne sich gegenseitig zu beeinflussen.
Kann ich Azure Event Hubs automatisch skalieren?
Ja. Wenn Sie das Feature Auto-Inflate für Namespaces der Standard-Stufe aktivieren, erhöht Azure die bereitgestellten Durchsatzeinheiten automatisch, sobald die Last steigt. So werden Leistungseinschränkungen durch Drosselung vermieden.
Wie lange werden Daten in Azure Event Hubs aufbewahrt?
Die Aufbewahrungsdauer hängt von Ihrer Preisstufe ab. Die Standard-Stufe speichert Daten bis zu 7 Tage, während die Premium- und Dedicated-Stufen eine Aufbewahrung von bis zu 90 Tagen ermöglichen.
Ist Azure Event Hubs mit Apache Kafka kompatibel?
Ja. Azure Event Hubs stellt einen Kafka-nativen Endpunkt bereit. Damit können bestehende Apache-Kafka-Clientanwendungen und -Tools mit Event Hubs kommunizieren, ohne dass Ihr Code neu geschrieben werden muss.
🎧 Diese Episode anhören
Sie möchten eine praxisnahe, gesprochene Erklärung zu Azure Event Hubs? Diese Episode erläutert die Architektur in verständlicher Sprache und zeigt, warum sie für moderne Cloud-Entwicklung, Unternehmensanalysen und skalierbare Anwendungen wichtig ist.
Hören Sie sich diese Episode an, wenn Sie:
- Die Grundlagen von Azure Event Hubs Partitionen und Skalierung verstehen
- Erfahren Sie, wie sich Streaming-Architekturen in das Microsoft-Azure-Ökosystem einfügen
- Erfahren Sie, wo Event-Streaming für Ihr Unternehmen einen praktischen Geschäftsnutzen schafft
Diese verwandten M365 FM-Episoden könnten Sie ebenfalls interessieren:
Entdecken Sie weitere praxisnahe Gespräche rund um Cloud und Microsoft auf M365 FM.
Zuletzt überprüft: Juli 2026.
Für wen dieser Podcast interessant ist
Diese Episode ist besonders wichtig für Azure-Administratoren, Enterprise-Architekten, Softwareentwickler und technische Verantwortliche, die eine solide, praxisnahe Grundlage benötigen, bevor sie Echtzeit-Streaming-Architekturen entwerfen, steuern oder betreiben.
🎧 Das könnte Sie auch interessieren
- Azure Event Grid — Ein praxisnaher nächster Schritt, um reaktive Cloud-Nachrichtenübermittlung kennenzulernen.
- Azure Service Bus — Erfahren Sie, wann Sie Nachrichtenwarteschlangen und wann Ereignisströme einsetzen sollten.
- Azure Functions — Entdecken Sie, wie Sie Ihre Ereignisströme im Serverless-Stil verarbeiten.