 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Warum Microsoft Fabric Semantic Models und Ontologien für die KI-Bereitschaft im Unternehmen unverzichtbar sind
Von Mirko Peters ·
Erfahren Sie, warum die direkte Anbindung von LLMs an Rohdatenspeicher scheitert. Entdecken Sie, wie Microsoft Fabric Semantic Models, Metadaten und Ontologien die KI-Bereitschaft im Unternehmen sicherstellen.
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
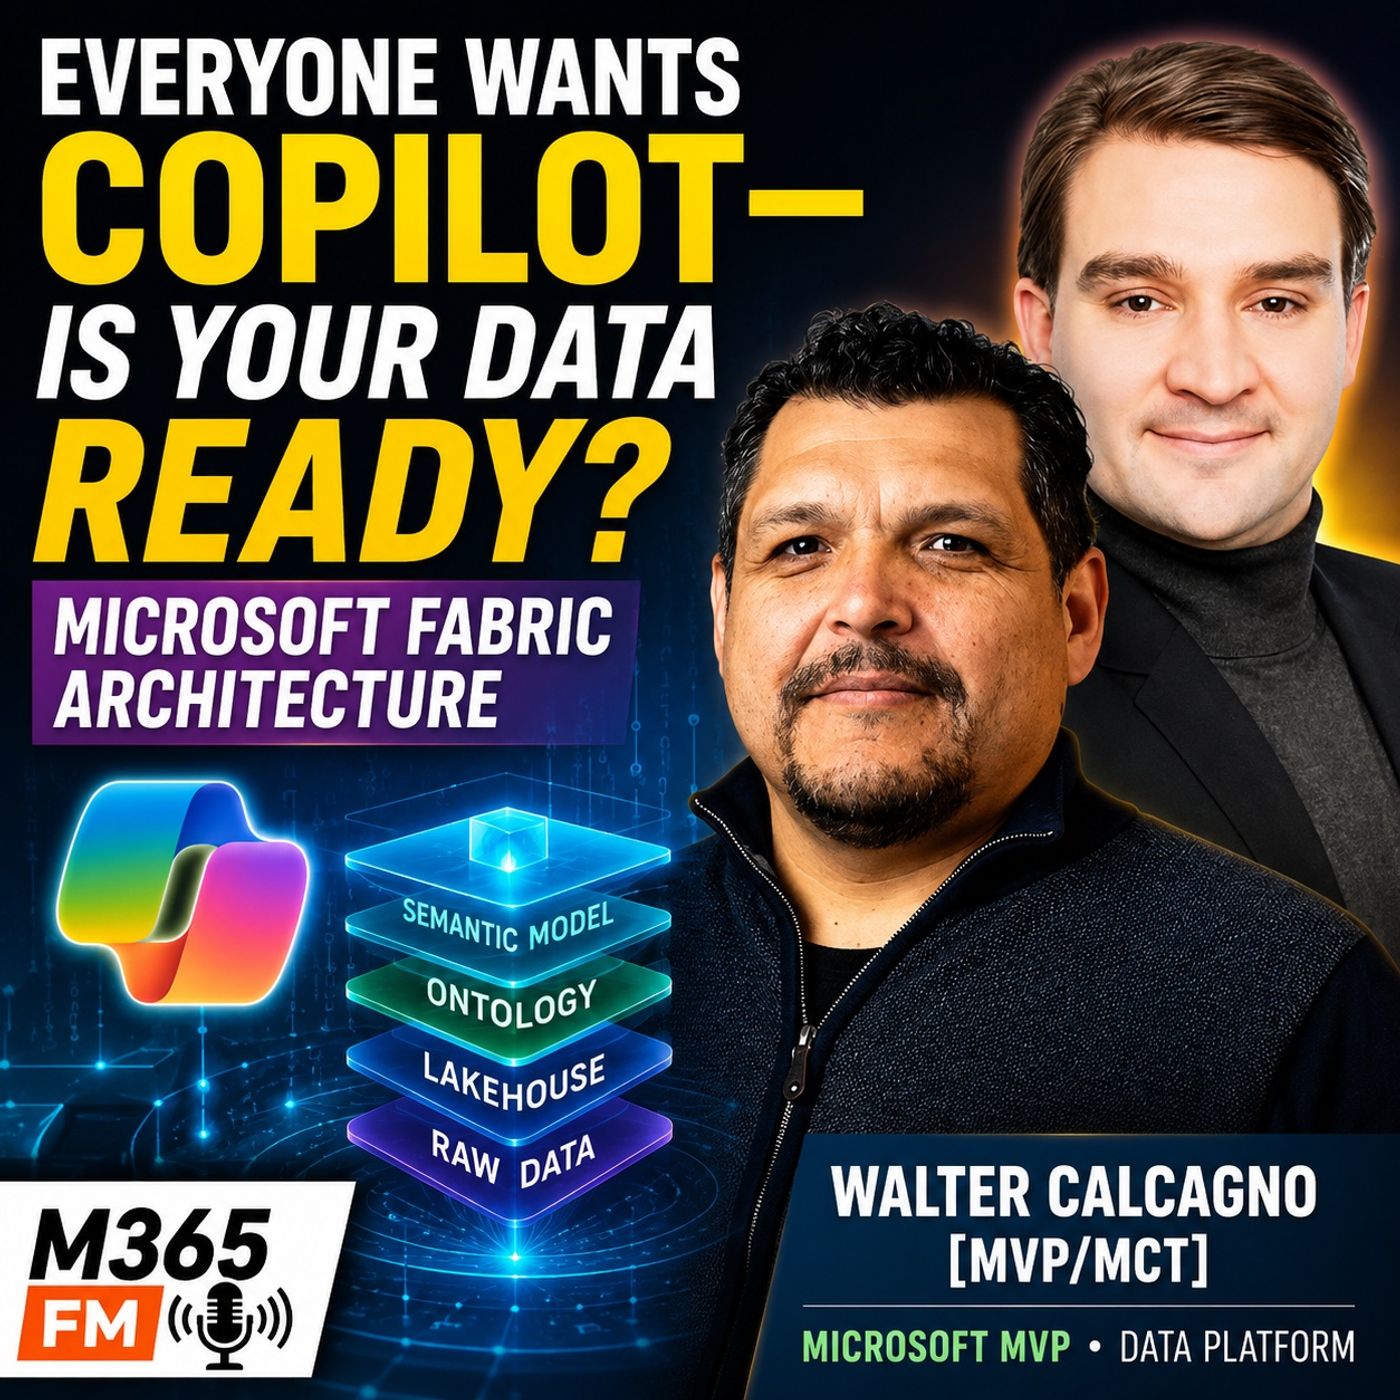
Erfahren Sie, warum die direkte Anbindung eines Large Language Model an rohe Datenbankspeicher zu hohem Tokenverbrauch, Halluzinationen und Sicherheitsrisiken führt. Lernen Sie, wie Microsoft Fabric Semantic Models, Metadaten-Maps und Ontologien die Lücke zwischen unübersichtlichen Unternehmensdaten und verlässlichen KI-Agenten schließen.
Das Wichtigste in Kürze
- Die direkte Anbindung von LLMs an Rohdaten im Cloud-Speicher überspringt kritische Architekturebenen, die für den fachlichen Kontext nötig sind.
- Microsoft Fabric Semantic Models strukturieren die Geschäftsdaten. Große Organisationen benötigen jedoch Ontologien, um Beziehungen zwischen getrennten Domänen abzubilden.
- Metadaten wirken wie ein GPS für KI-Systeme. Sie senken den kostspieligen Tokenverbrauch, indem sie Modelle direkt zu den relevanten Informationen führen, statt alles zu durchsuchen.
- Unternehmens-KI braucht explizite fachliche Definitionen für Kennzahlen wie Umsatz und Kundenabwanderung, damit Modelle keine widersprüchlichen Kennzahlen erfinden.
- Vor dem Einsatz natürlichsprachlicher Schnittstellen auf sensiblen Unternehmensdaten sind ein starkes Datengovernance-Konzept und korrekt gesetzte Berechtigungen unverzichtbar.
Die Illusion direkter KI-Anbindung in Unternehmensumgebungen
Unternehmen führen Copilot und eigene KI-Agenten ein, angetrieben von dem Versprechen, Daten in natürlicher Sprache abfragen zu können. Führungskräfte wollen, dass Mitarbeitende einfache Fragen stellen, etwa „Welche Produktlinien waren im letzten Quartal am erfolgreichsten?“, und sofort verlässliche Antworten erhalten. Ein gravierender architektonischer Fehler entsteht jedoch, wenn Teams davon ausgehen, dass sie ein LLM oder ein Retrieval-Augmented-Generation-System (RAG) einfach direkt auf vorhandene Cloud-Speicherkonten, Data Lakes oder unstrukturierte Tabellen richten können.
Rohdaten fehlt der Kontext. Ohne strukturierte Ebenen hat ein Large Language Model keinerlei Verständnis dafür, ob eine Spalte mit der Bezeichnung „Umsatz“ Erstattungen, Steuern oder abgegrenzte Erlöse enthält. Lässt man ein KI-Modell Zeilen und Spalten eigenständig interpretieren, entstehen erhebliche Risiken: Halluzinationen, fehlerhafte Berechnungen und kostspieliger Tokenaufwand. Echte KI-Bereitschaft erfordert eine bewusst gestaltete Datenarchitektur, und zwar lange bevor der erste Prompt geschrieben wird.
Über Semantic Models hinaus: Die Rolle von Ontologien in Microsoft Fabric
Innerhalb des Microsoft-Fabric-Ökosystems bilden Semantic Models strukturierte Darstellungen von Geschäftsdaten ab, die für Analyse und Reporting optimiert sind. Sie wandeln rohe Delta-Tabellen in erkennbare fachliche Entitäten um. Große Unternehmen arbeiten jedoch selten mit nur einem einzigen Semantic Model. Verschiedene Abteilungen, etwa Finanzen, Vertrieb, Personal und Supply Chain, pflegen häufig eigene Semantic Models, die auf ihre operativen Anforderungen zugeschnitten sind.
Der Versuch, dieses Fragmentierungsproblem zu lösen, indem man ein gesamtes Unternehmen in ein einziges, massives, monolithisches semantisches Modell presst, scheitert selten. Stattdessen setzen moderne Data Architects auf eine Ontologieschicht. Eine Ontologie beschreibt die Beziehungen, Abhängigkeiten und kontextuellen Pfade über mehrere Modelle hinweg. Wer strukturierte semantische Modelle mit einer belastbaren Ontologieschicht kombiniert, gibt KI-Systemen eine Navigationskarte an die Hand, die Geschäftsbedeutung, strukturelle Zusammenhänge und Zugriffskontrollen bewahrt.
Metadaten als Karte für effiziente LLM-Navigation
Einer der am häufigsten übersehenen Aspekte bei der Einführung von Enterprise AI ist die wirtschaftliche Realität des Token-Verbrauchs. Große Mengen unnötiger Daten und unstrukturierter Dateien in das Kontextfenster eines LLM zu schicken, treibt die Betriebskosten in die Höhe und verschlechtert gleichzeitig die Qualität der Modellausgabe.
Ein hilfreicher Vergleich ist eine Reise durch ein unbekanntes Land. Sie fahren nicht jede Wohnstraße ab, um Ihr Ziel zu finden. Sie nutzen Autobahnen, Landstraßen und Stadtpläne, um direkt zur richtigen Adresse zu gelangen. Metadaten erfüllen für ein KI-System genau dieselbe Funktion als Navigationskarte. Aussagekräftige Metadaten-Tags, Schemadefinitionen und Katalogisierung helfen dem Modell, genau zu finden, wo vertrauenswürdige Informationen liegen. Ohne Metadaten müssen KI-Agenten mehr arbeiten, mehr Rechenressourcen verbrauchen und den Speicherort von Daten erraten. Das führt zu unzuverlässigen Business-Intelligence-Ergebnissen.
Mehrdeutigkeiten beseitigen: Gemeinsame Definitionen für Enterprise AI
Zentrale Geschäftsbegriffe wie „Kunde“, „aktiver Mitarbeiter“, „Marge“ und „Abwanderung“ haben innerhalb einer Organisation oft unterschiedliche Bedeutungen, je nachdem, wen man fragt. Das Marketing definiert zum Beispiel einen aktiven Lead möglicherweise anders, als der Vertrieb einen aktiven Account definiert. Von einem LLM zu erwarten, dass es diese widersprüchlichen Definitionen selbstständig auflöst, ist ein Rezept für eine Katastrophe.
Organisationen müssen ihre Geschäftsdefinitionen, Key Performance Indicators (KPIs) und Berechnungsregeln explizit festhalten, bevor sie Daten für KI-Werkzeuge freigeben. Klare Metadatenanweisungen und semantische Leitplanken sorgen dafür, dass die KI lernt, wie Begriffe in genau dieser Unternehmenskultur definiert sind. Eindeutige Geschäftsregeln schützen das Unternehmen vor automatisierter Falschinformation und sorgen bei jeder Nutzerinteraktion für Konsistenz.
Fazit
Die Einführung von Enterprise AI ist letztlich eine Reise zu organisatorischer Reife und architektonischer Disziplin und keine einfache Softwareinstallation. Wer in passende semantische Schichten, umfassende Metadatenzuordnung und konsequente Data Governance auf Plattformen wie Microsoft Fabric investiert, kann fragmentierte Datensilos in vertrauenswürdige Werte verwandeln, die moderne KI-Werkzeuge sicher unterstützen.
Um diese Konzepte der Datenarchitektur genauer kennenzulernen, einschließlich der fünfdimensionalen Bewertung der KI-Reife und des siebenschichtigen Datenarchitekturmodells, hören Sie sich die vollständige Folge an und erfahren Sie, wie fachkundige Beratung Ihre Unternehmensdaten auf die Zukunft der Arbeit vorbereiten kann.
Häufige Fragen
Warum lässt sich ein LLM nicht direkt mit meinem Data Lake verbinden?
Wenn ein LLM direkt auf den rohen Speicher eines Data Lake zugreift, werden wesentliche Kontextschichten übersprungen. Rohdaten enthalten keine Geschäftsdefinitionen, Formatierungsstandards und Beziehungsstrukturen. Die Folge: KI-Modelle liefern ungenaue Ergebnisse, halluzinieren Antworten und verbrauchen übermäßig viele Token.
Was ist der Unterschied zwischen einem semantischen Modell und einer Ontologie?
Ein semantisches Modell strukturiert Daten innerhalb einer bestimmten Domäne oder Abteilung in Tabellen, Measures und Beziehungen. Eine Ontologie ist ein übergeordnetes Framework, das mehrere semantische Modelle verbindet. Sie beschreibt, wie verschiedene Geschäftsobjekte und Domänen im gesamten Unternehmen zueinander in Beziehung stehen.
Wie senken Metadaten die Betriebskosten von KI?
Metadaten wirken als präzise Navigationskarte für KI-Modelle. Anstatt das LLM zu zwingen, große Mengen Rohdaten und Dateien zu durchsuchen, führen die Metadaten das Modell direkt zu den Tabellen und Spalten, die für die Beantwortung eines Prompts nötig sind. Das reduziert den Token-Verbrauch und die Verarbeitungskosten erheblich.
Warum sind gemeinsame Geschäftsdefinitionen für Enterprise AI wichtig?
Verschiedene Abteilungen verwenden oft dieselben Begriffe, etwa Umsatz, Marge oder aktiver Benutzer, mit widersprüchlichen Definitionen. Wenn Sie diese KPIs explizit definieren, muss das KI-Modell nichts raten und liefert keine inkonsistenten Antworten. So entstehen zuverlässige und vertrauenswürdige Erkenntnisse für das gesamte Unternehmen.