 ES
 English
 Deutsch
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Evitar la trampa del monolito distribuido en microservicios .NET
By Mirko Peters ·
Cuando los equipos de ingeniería pasan de una aplicación monolítica a una arquitectura de microservicios, normalmente persiguen un conjunto muy concreto de promesas: entrega de funcionalidades más rápida, escalabilidad independiente, aislamiento de fallos localizado y libertad para experimentar con stacks tecnológicos modernos. Sin embargo, muchas organizaciones .NET chocan contra un muro en el qu
Automatically translated with AI from the original post. Read the English original
Cuando los equipos de ingeniería pasan de una aplicación monolítica a una arquitectura de microservicios, normalmente persiguen un conjunto muy concreto de promesas: entrega de funcionalidades más rápida, escalabilidad independiente, aislamiento de fallos localizado y libertad para experimentar con stacks tecnológicos modernos. Sin embargo, muchas organizaciones .NET chocan contra un muro en el que la velocidad de desarrollo se detiene por completo. En lugar de un ecosistema ágil y débilmente acoplado, se encuentran manteniendo un monolito distribuido: una arquitectura que combina la complejidad operativa de los sistemas distribuidos con el fuerte acoplamiento de un monolito tradicional.
Este problema rara vez es malintencionado o deliberado. Suele colarse a través de decisiones arquitectónicas sutiles, como compartir una base de datos entre varios servicios, depender en gran medida de llamadas HTTP síncronas o dejar que la gobernanza de las API se convierta en un cuello de botella administrativo. En este artículo veremos los síntomas de la trampa del monolito distribuido, descubriremos los problemas de rendimiento ocultos en las capas de red, identificaremos los cuellos de botella arquitectónicos con herramientas modernas de observabilidad y repasaremos estrategias prácticas para recuperar la escalabilidad independiente en tus microservicios .NET. Si tu equipo ha sentido la fricción de la entrega cada vez más lenta, no estás solo, y entender estos patrones es el primer paso para recuperar tu agilidad.
Arquitectura de microservicios: complejidad oculta
Monolitos distribuidos
Síntomas
Quizá pienses que dividir tu aplicación en microservicios resolverá automáticamente tus problemas de rendimiento. Sin embargo, es muy fácil acabar con un monolito distribuido. Esto ocurre cuando los servicios dependen tanto unos de otros que se pierden los verdaderos beneficios de la separación. Estos son algunos síntomas habituales:
- Los servicios dependen de llamadas síncronas para cada operación de negocio estándar.
- Los equipos tienen dificultades para desplegar cambios individuales sin arriesgar caídas del servicio o romper los servicios dependientes.
- Las bases de datos compartidas obligan a coordinar estrechamente los cambios de esquema entre varios equipos de desarrollo distintos.
- Los componentes siguen fuertemente acoplados, aunque se ejecuten físicamente en procesos o contenedores separados.
Impacto en la velocidad
Un monolito distribuido puede ralentizar tu sistema de formas que no esperas al principio. Verás aumentar la latencia de red, porque cada llamada entre servicios añade retraso. A diferencia de una aplicación monolítica, donde las llamadas se producen de forma instantánea en memoria, una arquitectura de microservicios desplaza los cuellos de botella de rendimiento de la base de datos o la CPU a la capa de red. Las llamadas síncronas entre microservicios acumulan latencia, mientras que un monolito resuelve estas llamadas dentro del mismo proceso. En consecuencia, pierdes la capacidad de escalar servicios de forma independiente y de aislar fallos con eficacia, y los problemas de rendimiento se agravan a medida que crece el árbol de dependencias.
Cuando intentas distribuir una aplicación monolítica sin un diseño adecuado de los límites entre componentes, a menudo te enfrentas a problemas de rendimiento graves. Los componentes siguen dependiendo mucho unos de otros, y no obtienes los beneficios de escalabilidad independiente ni de aislamiento de fallos que ofrecen los microservicios bien estructurados.
Sobrecarga de coordinación
Gobernanza de API
La arquitectura de microservicios requiere una gobernanza de API sólida. Debes revisar y aprobar cada cambio para evitar acumular deuda técnica y esfuerzos duplicados. Si la gobernanza es demasiado estricta, ralentizas el desarrollo hasta casi detenerlo. Si es demasiado laxa, corres el riesgo de acumular deuda técnica estructural casi de la noche a la mañana.
Cuando la gobernanza es demasiado laxa o demasiado estricta, puede provocar deuda técnica, esfuerzos duplicados y ralentizaciones enormes en el proceso de desarrollo.
En esencia, estás acumulando una gran cantidad de deuda técnica muy rápidamente. Y al final, tienes que gastar más dinero y más tiempo en desmontarlo todo y empezar de nuevo.
Debes diseñar tus modelos de gobernanza para que beneficien activamente a los desarrolladores. La automatización ayuda a mejorar la calidad, la seguridad y la coherencia de las API sin añadir carga administrativa.
Cuando la gobernanza está diseñada para beneficiar a los desarrolladores y se refuerza con automatización, se convierte en un catalizador para mejorar la calidad, la seguridad y la coherencia de las APIs.
Las APIs desempeñan un papel fundamental en tu estrategia empresarial más amplia. Debes tratarlas como ciudadanos de primera clase.
En el último informe sobre el estado de la integración de APIs, el 84 por ciento de las empresas afirmó que las APIs eran críticas o muy críticas para su estrategia empresarial principal.
Colaboración en equipo
Los microservicios exigen una coordinación constante entre equipos. Pasas horas preparando reuniones, cambiando de contexto entre dominios y aclarando funciones entre equipos. Estas actividades pueden consumir fácilmente una gran parte de tu semana laboral.
| Factores de coste de coordinación | Descripción |
|---|---|
| Latencia en la toma de decisiones | Retrasos debidos a múltiples partes interesadas y cadenas de aprobación engorrosas |
| Cambio de contexto | Atención fragmentada entre diversos puntos de coordinación interfuncional |
| Deterioro de la información | Pérdida o distorsión de conocimiento crítico a través de las capas organizativas |
| Ambigüedad de funciones | Responsabilidades poco claras que generan lagunas y esfuerzos de desarrollo duplicados |
| Actividad de coordinación | Tiempo dedicado |
|---|---|
| Preparación de reuniones | Más de 8 horas a la semana |
| Actividades de coordinación | Entre el 35 y el 80 % del tiempo de los trabajadores del conocimiento |
Debes reconocer que la sobrecarga de coordinación puede socavar en silencio la velocidad de entrega. Los límites de responsabilidad claros y los canales de comunicación optimizados son imprescindibles para evitar lagunas y esfuerzos duplicados.
Desafíos del ecosistema .NET
Ingeniería de plataforma
La arquitectura de microservicios en el ecosistema .NET plantea desafíos de ingeniería específicos. A menudo te enfrentas a la duplicación de código y a redundancias, que aumentan los esfuerzos de mantenimiento y el riesgo de incoherencias en los datos. Los desarrolladores suelen lidiar con una cantidad excesiva de código repetitivo solo para poner en marcha la infraestructura. Organizar el código fuente se vuelve especialmente difícil cuando compartes modelos de dominio entre servicios de forma inadecuada. Los antipatrones de copiar y pegar retrasan las correcciones de errores y complican considerablemente el mantenimiento a largo plazo.
- La duplicación de código conlleva mayores costes de mantenimiento continuo.
- Los modelos compartidos entre servicios hacen que las actualizaciones de esquema sean arriesgadas.
- Los desarrolladores pueden copiar y pegar lógica de servicios, lo que ralentiza las correcciones críticas de errores.
Límites de dominio
Debes definir límites de dominio muy precisos al crear microservicios en .NET. Si no lo haces, aumentas drásticamente la carga cognitiva de los desarrolladores. Demasiadas exigencias arquitectónicas simultáneas abruman a tu equipo. Mantener los estándares y el cumplimiento normativo se vuelve difícil, lo que puede provocar problemas de fiabilidad y debilitar tu postura de seguridad general.
- La carga cognitiva aumenta bruscamente cuando los desarrolladores gestionan múltiples servicios interconectados.
- Los estándares y el cumplimiento normativo empresarial son más difíciles de aplicar de forma coherente.
- La fiabilidad y la seguridad se resienten cuando los límites de dominio están mal definidos.
Aunque la arquitectura de microservicios ofrece beneficios muy atractivos, debes abordar proactivamente su complejidad oculta. Vigila los síntomas de los monolitos distribuidos, gestiona la sobrecarga de coordinación y afronta de frente los desafíos de la plataforma específicos de .NET.
Bomba de relojería: problemas de rendimiento
Puede que supongas que los microservicios aumentarán de forma inherente la velocidad del sistema, pero sin un diseño riguroso pueden convertirse en una bomba de relojería para tu infraestructura. Muchos equipos de ingeniería descubren los problemas de rendimiento habituales solo después de desplegar en producción. Estos problemas permanecen ocultos bajo la superficie, esperando para lastrar tu aplicación bajo una carga máxima. Necesitas entender cómo la latencia de red, los puntos de fallo en cascada y la contención en la base de datos convierten tu arquitectura en una fuente de frustración crónica en producción.
Latencia de red
Llamadas en proceso frente a llamadas de red
Cuando divides un monolito en microservicios, pasas de las llamadas a funciones en proceso a las llamadas de red. Este cambio arquitectónico introduce una latencia inevitable. En una aplicación monolítica, una llamada a función se resuelve casi al instante. En los microservicios, cada llamada entre servicios debe atravesar la red, añadiendo milisegundos de retraso.
| Tipo de arquitectura | Latencia media |
|---|---|
| Llamada a función en proceso (monolito) | 0,001 ms (1 microsegundo) |
| Llamada HTTP dentro del mismo centro de datos (microservicios) | 1-5 ms (1.000-5.000 microsegundos) |
Las llamadas de red son órdenes de magnitud más lentas que las llamadas a funciones en el mismo proceso. Esta diferencia se acumula rápidamente a medida que tu sistema crece. Cada nuevo servicio que se añade a una cadena de peticiones aumenta la latencia y convierte operaciones sencillas en experiencias lentas y frustrantes para los usuarios finales.
Uso de recursos
Las llamadas de red no solo añaden latencia; también consumen recursos valiosos del sistema. Cada llamada consume ciclos de CPU, búferes de memoria y ancho de banda de red. A medida que añades más microservicios, generas un tráfico de red que crece de forma exponencial. Esta carga adicional se traduce en mayores costes de infraestructura en la nube y tiempos de respuesta más lentos.
Puedes mejorar el rendimiento reduciendo de forma agresiva las llamadas innecesarias entre servicios. Algunos equipos avanzados utilizan una gestión inteligente del tráfico para reducir la latencia y aumentar la resiliencia:
- El enfoque MCG mejoró los tiempos de respuesta un 15% bajo una mayor latencia de red, gracias a la reducción de los retrasos en la comunicación entre servicios.
- En condiciones de carga máxima, la configuración mejorada con MCG mostró una resiliencia superior y menos tasas de error en comparación con las configuraciones estándar de malla de servicios.
- Las evaluaciones de rendimiento demostraron que las estrategias inteligentes de colocación del tráfico mitigaron la sobrecarga de los proxies sidecar, reduciendo los tiempos de respuesta y estabilizando el rendimiento.
Debes monitorizar de forma continua cómo afecta el tráfico de red al rendimiento de tu sistema. Los pequeños retrasos acumulados se convierten fácilmente en cuellos de botella importantes.
Puntos de fallo
Riesgos de propagación
Los microservicios cambian fundamentalmente el perfil de fallos de tu sistema. Como cada servicio depende de otros, un único fallo puede propagarse por toda tu infraestructura.
| Tipo de arquitectura | Riesgo de propagación de fallos | Aislamiento de fallos | Resiliencia del sistema |
|---|---|---|---|
| Monolítica | Alto | No | Bajo |
| Microservicios | Bajo | Sí | Alta |
En un sistema monolítico, un solo error fatal puede tumbar todo el proceso de la aplicación. Los microservicios ofrecen un aislamiento de fallos mucho mejor: si un servicio no crítico falla, los demás pueden seguir funcionando. Los patrones de resiliencia, como los interruptores de circuito (circuit breakers), ayudan a evitar que los fallos se extiendan a todo el sistema.
- En un monolito, un solo error puede provocar una caída total del servicio, creando un punto único de fallo.
- Los microservicios permiten una verdadera tolerancia a fallos, de modo que el fallo de componentes no críticos no hunde la plataforma.
- Patrones como los circuit breakers mejoran la resiliencia al aislar las dependencias descendentes que fallan.
Retos de observabilidad
Necesitas una observabilidad completa para detectar y resolver problemas de rendimiento en una malla de microservicios tan extensa. Localizar la causa raíz de una latencia o de errores intermitentes se vuelve exponencialmente más difícil a medida que se multiplican los servicios. Debes agregar logs, métricas de infraestructura y trazas distribuidas de cada instancia en ejecución. Sin herramientas de observabilidad robustas, perderás incontables horas buscando el origen de las ralentizaciones en producción.
Los cuellos de botella de rendimiento suelen esconderse en cadenas de llamadas complejas y asíncronas. Debes aprovechar el trazado distribuido para seguir las peticiones a través de los límites de cada servicio, lo que te permitirá detectar los cuellos de botella antes de que afecten a tus usuarios.
Ten cuidado con estos antipatrones clásicos:
- Servicio Dios (demasiada responsabilidad): un servicio que gestiona varios dominios de negocio dispares, vulnerando los principios arquitectónicos básicos.
- Acoplamiento fuerte entre servicios: dependencias directas codificadas que rompen los sistemas descendentes cada vez que cambia un esquema.
Contención en la base de datos
Almacenes de datos compartidos
Muchos equipos cometen el error crítico de compartir una base de datos entre varios microservicios. Esta práctica crea un acoplamiento severo a nivel de esquema. Modificar la estructura de la base de datos se vuelve peligroso, porque puede romper servicios externos y comprometer tu velocidad y tu escalabilidad independiente.
El principal problema de las bases de datos compartidas es que generan acoplamiento por esquema. El coste de los cambios aumenta drásticamente, porque resulta difícil saber cuándo puedes realizar cambios de forma segura sin romper otro servicio. Esto tiene efectos en cadena sobre la escalabilidad del sistema. No puedes escalar los servicios de forma individual cuando dependen de un almacén de datos compartido. Como la escalabilidad de un servicio está limitada por su componente más lento, una base de datos compartida se convierte rápidamente en un cuello de botella enorme.
Debes eliminar por completo los almacenes de datos compartidos. Asigna a cada microservicio su propia base de datos dedicada para desacoplar las capas de datos y recuperar el rendimiento.
Problemas de escalabilidad
La contención en la base de datos es una bomba de relojería para las aplicaciones empresariales. Cuando varios microservicios compiten por el mismo motor de base de datos, se crea un cuello de botella de rendimiento considerable. La consulta o el servicio más lento limita la capacidad de todo el sistema, lo que provoca el agotamiento del pool de conexiones, el aumento de la latencia y caídas catastróficas durante los picos de tráfico.
Identificar cuellos de botella en una arquitectura de microservicios
Herramientas de monitorización
Métricas
Debes seguir las métricas operativas adecuadas para detectar cuanto antes la degradación del rendimiento. Las métricas ofrecen una instantánea inmediata del estado de tu sistema y te ayudan a detectar tendencias antes de que afecten a producción. Céntrate en los indicadores relevantes para el negocio junto con las métricas técnicas: monitoriza los tiempos de respuesta p99, las tasas de error y el rendimiento de las solicitudes.
Visibilidad
La visibilidad es imprescindible en los sistemas distribuidos. No puedes arreglar lo que no puedes ver. Implementa herramientas de monitorización que ingieran telemetría de cada instancia de servicio:
- Prometheus, Datadog y Grafana para la monitorización en tiempo real de la infraestructura y las aplicaciones.
- Elasticsearch, Logstash, Kibana (ELK) o Graylog para la agregación centralizada de logs.
- Herramientas de monitorización del rendimiento de aplicaciones (APM), como New Relic o Dynatrace, para el perfilado de llamadas a nivel de código.
- Kubernetes u otros orquestadores de contenedores para la observabilidad del clúster subyacente.
- Gateways de API como Kong o Zuul para el análisis del tráfico en el perímetro.
Trazado distribuido
Flujos de solicitudes
El trazado distribuido permite seguir una solicitud HTTP a medida que atraviesa tu arquitectura de microservicios. Herramientas de trazado como OpenTelemetry, Jaeger y Zipkin conectan estas llamadas entre sí, mostrando la ruta de ejecución de extremo a extremo y señalando los puntos exactos de latencia.
- El trazado distribuido proporciona una visibilidad profunda a través de los límites de los servicios.
- Revela cuellos de botella ocultos y acelera considerablemente los flujos de depuración.
- Los equipos de ingeniería usan las trazas para descubrir las fuentes de latencia y mejorar la fiabilidad.
Fuentes de latencia
La latencia se acumula a medida que las solicitudes saltan entre servicios. Los logs estándar y las métricas de infraestructura por sí solos no pueden mostrar este nivel de granularidad transaccional. El trazado conserva el contexto de la solicitud a través de los saltos de red, de modo que puedes localizar con precisión el método o la consulta de base de datos que causa las ralentizaciones.
Detectar ralentizaciones ocultas
Síntomas
Las ralentizaciones ocultas pueden dañar la experiencia de usuario incluso sin caídas totales. Vigila el aumento de los tiempos de respuesta, las tasas de error elevadas y el mayor consumo de memoria. Usa identificadores de correlación para seguir las solicitudes a través de tus sistemas y configura alertas proactivas basadas en objetivos de nivel de servicio (SLO) estrictos.
Casos reales
Los casos de estudio reales de ingeniería subrayan la importancia de detectar los cuellos de botella de forma proactiva. Por ejemplo, un microservicio Spring Boot de alta carga sufrió una degradación grave del rendimiento. Mediante herramientas APM y de perfilado en profundidad, el equipo de ingeniería descubrió un bucle de consultas sin optimizar. Al introducir una cláusula específica para agrupar las operaciones de base de datos, redujeron las consultas por segundo de 300 a 30, estabilizando al instante el uso de CPU y eliminando la sobrecarga del recolector de basura.
Consejo: combina siempre métricas, logs y trazas en un pipeline de observabilidad unificado. Esta combinación ofrece una visión inmediata y global del estado de tu sistema.
Soluciones para los problemas de rendimiento de los microservicios
Comunicación asíncrona
Ventajas de la mensajería
Muchos problemas de escalado en una arquitectura de microservicios se resuelven con la comunicación asíncrona. Al desacoplar las peticiones mediante colas de mensajes, los servicios procesan el trabajo a su propio ritmo y absorben los picos de tráfico sin perder peticiones.
| Mejora del rendimiento | Descripción |
|---|---|
| Escalabilidad | La mensajería asíncrona permite escalar de forma masiva usando colas que amortiguan los picos de tráfico. |
| Fiabilidad | Los brokers asíncronos admiten reintentos de mensajes y colas de mensajes fallidos (dead-letter), lo que garantiza cero pérdida de mensajes durante las caídas del servicio. |
| Facilidad de prueba | Las pruebas son más sencillas, ya que los servicios consumidores solo necesitan una cola simulada (mock) para verificar la carga útil. |
Implementación
Implementa la comunicación asíncrona con brokers de mensajes robustos como RabbitMQ, Azure Service Bus o Apache Kafka. Usa patrones de publicación-suscripción para difundir eventos de dominio de forma limpia entre servicios independientes.
Mamparos e interruptores de circuito
Estrategias de aislamiento
Protege tus microservicios frente a fallos en cascada con mamparos e interruptores de circuito. Los mamparos dividen los grupos de recursos para que un fallo en un servicio no pueda agotar los hilos o las conexiones de todo el sistema.
Los mamparos están diseñados para aislar los dominios de fallo creando grupos de recursos o cuotas separadas para cada servicio, evitando que los fallos localizados tumben toda la aplicación.
Mitigación de fallos
Los interruptores de circuito monitorizan las tasas de error y rechazan de inmediato las peticiones a dependencias no saludables, evitando interrupciones en cascada en toda la red.
El patrón mamparo en la arquitectura de microservicios se utiliza para evitar que los fallos de una parte del sistema provoquen la caída de toda la plataforma, aislando eficazmente los fallos en su origen.
Caché y escalado
Selección del almacén de datos
La caché es una herramienta esencial para microservicios de alto rendimiento. Descarga las lecturas repetidas de bases de datos y los cálculos costosos de API en cachés rápidas en memoria como Redis o Memcached.
| Beneficio | Descripción |
|---|---|
| Control detallado | Almacena en caché fragmentos de dominio según su volatilidad y frecuencia de actualización. |
| Menos invalidaciones de caché | Reduce la sobrecarga de purgado actualizando solo los segmentos de datos afectados. |
| Mejores tasas de acierto en caché | Permite entradas de caché más pequeñas y muy optimizadas, con mayores tasas de acierto en memoria. |
| Gestión híbrida dinámica/estática | Admite la caché de registros estáticos mientras obtiene de forma dinámica las estadísticas en tiempo real. |
Escalado independiente
La caché y los almacenes de datos segregados te permiten escalar cada servicio de forma independiente, eliminando los cuellos de botella por contención de recursos.
- Mayor escalabilidad del sistema
- Mayor agilidad de desarrollo y salida al mercado más rápida
- Aislamiento de fallos sólido y resiliencia del sistema
- Uso rentable de los recursos en la nube
- Mejor integración con DevOps y canales de despliegue continuo
Reducción de dependencias
Desacoplamiento
Los microservicios auténticos requieren un desacoplamiento radical. Cuando los servicios operan de forma independiente, sin llamadas síncronas bloqueantes, eliminas cuellos de botella artificiales.
Desacoplar significa que cada microservicio gestiona su carga de trabajo interna sin esperar de forma síncrona a procesos externos. Esta independencia evita los cuellos de botella y mantiene la plataforma funcionando sin problemas.
Las principales ventajas arquitectónicas de reducir dependencias incluyen:
- Escalado independiente de los servicios según su carga de trabajo en tiempo real.
- Menor riesgo de fallos en cascada entre los límites de los equipos.
- Autonomía para que los equipos de desarrollo publiquen código según su propio calendario.
- Aislamiento más rápido de la causa raíz durante la respuesta a incidentes.
Simplificación
Simplificar tu grafo de dependencias reduce la carga cognitiva y hace que la arquitectura sea mucho más fácil de probar, monitorizar y proteger.
| Enfoque | Qué significa | Por qué importa |
|---|---|---|
| SLO individuales | Medir la fiabilidad de cada microservicio por separado | Pueden pasar por alto la degradación de la experiencia de usuario en todo el sistema |
| SLO compuestos | Combinar los objetivos de fiabilidad de servicios interdependientes | Reflejan la salud real del sistema de extremo a extremo |
Evaluación del encaje de una arquitectura de microservicios
Elegir el modelo arquitectónico adecuado determina la velocidad de tu equipo de ingeniería y los costes operativos. El Microsoft Development Podcast explora con frecuencia esta tensión y destaca una tendencia creciente: las organizaciones consolidan microservicios excesivamente fragmentados en monolitos modulares manejables.
Matriz de decisión
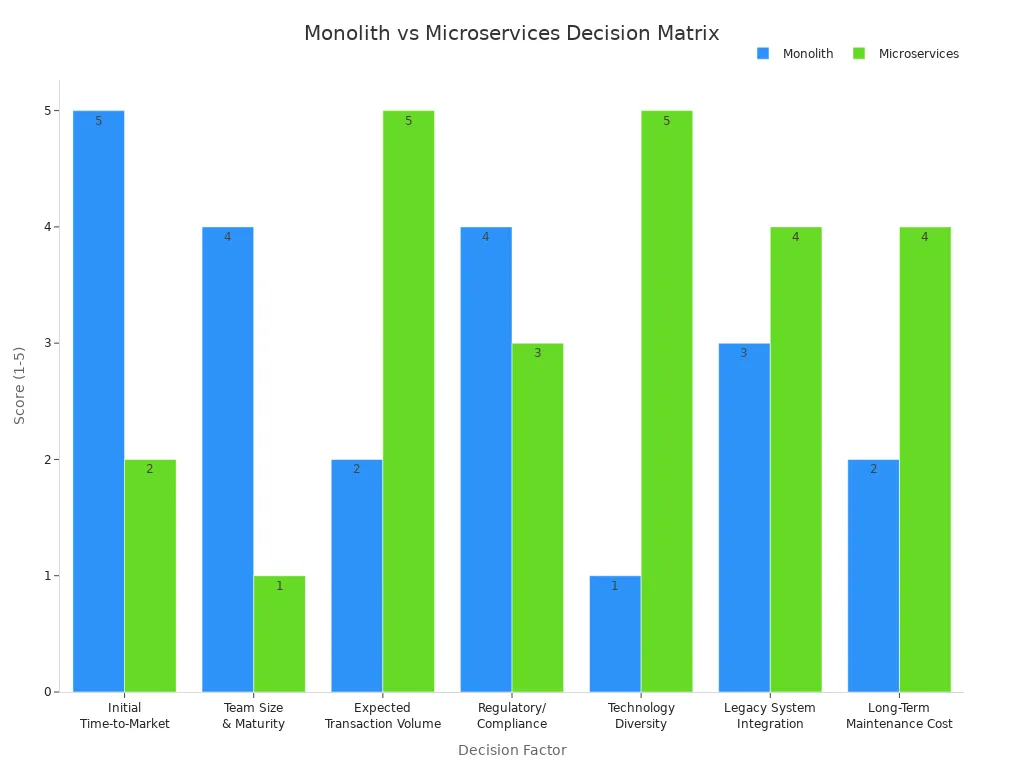
Usa una matriz de decisión estructurada para evaluar si los microservicios encajan realmente con la madurez de tu organización:
| Factor de decisión | Puntuación del monolito (1-5) | Puntuación de microservicios (1-5) | Justificación estratégica |
|---|---|---|---|
| Tiempo inicial de salida al mercado (velocidad) | 5 | 2 | Los monolitos requieren una configuración de infraestructura inicial mínima. |
| Tamaño y madurez del equipo (DevOps) | 4 | 1 | Los microservicios exigen CI/CD avanzado, automatización y observabilidad. |
| Volumen esperado de transacciones (escala) | 2 | 5 | Los microservicios permiten escalar de forma precisa e independiente los cuellos de botella con alto consumo de recursos. |
| Complejidad regulatoria o de cumplimiento | 4 | 3 | Los artefactos únicos simplifican la auditoría de seguridad y las comprobaciones iniciales de cumplimiento. |
| Diversidad tecnológica y experimentación | 1 | 5 | Los microservicios permiten a los equipos adoptar pilas tecnológicas especializadas por dominio de servicio. |
| Integración con sistemas heredados | 3 | 4 | Los microservicios son ideales para encapsular y modernizar componentes heredados. |
| Coste de mantenimiento a largo plazo (TCO) | 2 | 4 | Los microservicios reducen el coste de las funcionalidades con el tiempo, a cambio de una mayor sobrecarga operativa. |
Preguntas clave de evaluación
- ¿Tu equipo de ingeniería tiene competencias sólidas en DevOps, ingeniería de plataformas y SRE?
- ¿Tienes requisitos de escala extremos que justifiquen la sobrecarga de un sistema distribuido?
- ¿Necesitas persistencia políglota y diversidad tecnológica?
- ¿Está tu cultura organizativa preparada para asumir los intensos costes de coordinación entre equipos?
Señales para reconsiderar
Vigila estas señales de alerta que indican que tu arquitectura de microservicios necesita una reestructuración:
- La velocidad de entrega se detiene por dependencias constantes entre equipos.
- Los gastos operativos en la nube crecen más rápido que los ingresos del negocio.
- Las caídas se propagan fácilmente entre varios dominios.
Monolitos frente a microservicios
| Tipo de arquitectura | Recomendación de tamaño de equipo | Características clave |
|---|---|---|
| Monolítica | < 8-10 desarrolladores | Despliegues sencillos, baja sobrecarga operativa |
| Microservicios | > 10-15 desarrolladores | Autonomía independiente de los equipos, coordinación distribuida compleja |
Al implementar una arquitectura de microservicios te enfrentarás a una complejidad oculta y a riesgos de rendimiento. Los cuellos de botella aparecen invariablemente en capas de red y de datos inesperadas. El Microsoft Development Podcast subraya que la entrega rápida exige una disciplina arquitectónica rigurosa. Para mantener sanos tus sistemas .NET, recuerda:
- Gestionar con cuidado las solicitudes entre servicios y las directivas de tiempo de espera.
- Implementar equilibrio de carga elástico y escalado automatizado.
- Desacopla los almacenes de datos para que cada servicio sea propietario de su base de datos.
- Almacena en caché de forma agresiva las consultas repetitivas a API y bases de datos.
Además, debes aplicar una gobernanza arquitectónica, utilizar pasarelas de API robustas y realizar revisiones arquitectónicas periódicas. La evaluación continua garantiza que tu pila tecnológica escale de forma eficaz junto con tu negocio.
Preguntas frecuentes
¿Qué es un monolito distribuido?
Un monolito distribuido es un antipatrón en el que una aplicación se divide físicamente en varios microservicios, pero sigue acoplada lógicamente mediante llamadas HTTP síncronas, bases de datos compartidas y dependencias de despliegue estrechas, lo que anula los beneficios fundamentales de los microservicios.
¿Cómo detectas cuellos de botella de rendimiento en los microservicios?
Supervisa los tiempos de respuesta p99, las tasas de error y el rendimiento de las solicitudes. Aprovecha las herramientas de trazado distribuido para seguir las solicitudes a través de los límites de cada servicio e identificar saltos de red lentos o consultas a bases de datos.
¿Por qué importa la latencia de red en una arquitectura de microservicios?
La latencia de red añade milisegundos de retardo a cada llamada entre servicios. A diferencia de las llamadas instantáneas en memoria de un monolito, los saltos de red distribuidos se acumulan rápidamente y degradan la capacidad de respuesta general de la aplicación.
¿Cómo puedes reducir la sobrecarga de coordinación entre equipos?
Define límites claros de propiedad por dominio, automatiza las comprobaciones de gobernanza de API, reduce las reuniones de estado innecesarias y adopta patrones de comunicación asíncrona para que los equipos trabajen de forma autónoma.
¿Qué herramientas ayudan con la observabilidad en microservicios de .NET?
Entre las herramientas de observabilidad más populares están Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin y las plataformas de registro centralizado, como la pila ELK, que en conjunto capturan métricas, registros y trazas distribuidas.
¿Cuándo debes plantearte consolidar microservicios?
Plantéate la consolidación si la velocidad de entrega de funcionalidades disminuye, si los costos de la infraestructura en la nube se disparan o si las caídas en cascada afectan con regularidad tu capacidad para mantener la disponibilidad.
¿Cuál es la mejor forma de gestionar los datos compartidos en microservicios?
Asigna a cada microservicio su propia base de datos privada. Evita compartir bases de datos entre servicios para eliminar el acoplamiento de esquemas y recuperar la escalabilidad independiente de cada base de datos.
¿Cómo mejora la comunicación asíncrona el rendimiento de los microservicios?
La comunicación asíncrona mediante brokers de mensajes permite que los servicios procesen los eventos a su propio ritmo, absorbiendo los picos de tráfico y eliminando los cuellos de botella síncronos que bloquean el sistema.
🎧 Escucha este episodio
¿Quieres una explicación práctica y en profundidad sobre por qué la arquitectura de microservicios ralentiza la entrega de software? Este episodio desglosa estos temas arquitectónicos clave con un lenguaje claro y explica por qué importan para Microsoft 365, Azure, Power Platform, la seguridad empresarial, la IA y la ingeniería de software moderna.
Escucha este episodio si quieres:
- Entender los conceptos básicos de por qué los microservicios pueden ralentizar la entrega de software
- Ver cómo encaja la arquitectura en el ecosistema tecnológico más amplio de Microsoft
- Descubrir dónde puede aportar valor práctico y medible a tu organización empresarial
También te pueden interesar estos episodios relacionados de M365 FM:
- El mito del monorepo: por qué tu arquitectura está fragmentada
- Automatización con Microsoft Graph: arquitectura más allá de los scripts
- Agentes de IA con Graph: una guía de arquitectura empresarial
- Extensibilidad en .NET y arquitectura limpia con Miguel Castro [MVP]
- Malla de agentes de IA empresarial: arquitectura más allá de los chatbots
Descubre más conversaciones prácticas de ingeniería de Microsoft en M365 FM.