 ID
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Tata Kelola Data di Microsoft Fabric Lakehouse: Arsitektur Tanpa Bikin Pusing
By Mirko Peters · · Updated
Atur tata kelola data dalam arsitektur lakehouse di Microsoft Fabric tanpa bikin pusing. Sederhanakan analitik dengan solusi yang kokoh dan mudah dikelola.
Automatically translated with AI from the original post. Read the English original
Pernah mengalami momen canggung ketika seseorang dalam rapat bertanya, "Bisakah kita buktikan dari mana angka ini berasal?" lalu seluruh ruangan terdiam? Saya sudah sering melihat keheningan itu berlangsung lama di perusahaan yang punya "semua data", tetapi tidak punya bukti pendukung. Lakehouse menjanjikan satu platform untuk segalanya: tabel terstruktur, file yang berantakan, aliran data real-time, dan fitur ML. Namun janji itu hanya terpenuhi jika Anda bisa mengatur tata kelolanya tanpa membatasi tim Anda. Artikel ini banyak mengacu pada studi Stallion Journal bulan Oktober 2024 berjudul "Data Governance in Lakehouse" (Shah & Jain), lalu menambahkan sisi manusianya: jalan pintas yang tergoda untuk Anda ambil, politik yang akan Anda hadapi, dan kebiasaan sederhana yang membuat Anda terhindar dari kepanikan akibat audit.
8 Fakta Mengejutkan tentang Tata Kelola di Microsoft Fabric Lakehouse- Tata kelola terpadu lintas artefak: Tata kelola Fabric berlaku secara seragam untuk tabel lakehouse, file, notebook, pipeline, dan dasbor, sehingga kebijakan terpusat dapat mencakup artefak data sekaligus artefak analitik.
- Penangkapan lineage otomatis: Lineage ditangkap secara otomatis untuk banyak operasi (ingest, transformasi, notebook, dan dasbor), memberikan visibilitas hampir real-time atas asal-usul data tanpa instrumentasi tambahan.
- Integrasi keamanan tingkat baris dan tingkat kolom: Lakehouse mendukung kontrol akses terperinci (tingkat baris dan kolom) yang diterapkan saat kueri dijalankan, sehingga akses yang diatur tetap melekat pada data, apa pun mesin konsumsinya.
- Klasifikasi data dan label sensitivitas bawaan: Fabric menampilkan klasifikasi data (jenis informasi sensitif) dan terintegrasi dengan label sensitivitas Microsoft Purview, sehingga tata kelola dapat memanfaatkan klasifikasi yang ditemukan untuk penegakan kebijakan.
- Policy-as-code untuk kontrol siklus hidup: Kebijakan tata kelola (retensi, gerbang kualitas, enkripsi, compute yang diizinkan) dapat dinyatakan dan diterapkan secara terprogram, sehingga penegakannya berjalan otomatis di seluruh siklus hidup lakehouse.
- Isolasi penyewa dan workspace yang mulus: Model tata kelola Fabric mendukung isolasi multi-workspace dan kebijakan yang sadar penyewa, sehingga Anda dapat membatasi pembagian dan perpindahan data antarproyek sambil tetap memungkinkan kolaborasi yang diatur.
- Log mutasi dan akses yang dapat diaudit: Semua operasi yang relevan dengan tata kelola (pembacaan/penulisan data, perubahan kebijakan, penugasan peran) dapat diaudit, menghasilkan log yang terintegrasi dengan Microsoft Sentinel dan SIEM untuk pemantauan kepatuhan.
- Kontrak data yang didukung tata kelola: Fabric memungkinkan pembuatan kontrak data dan skema dengan pemeriksaan kompatibilitas yang diterapkan, sehingga konsumen mendapatkan antarmuka lakehouse yang stabil dan teratur, sementara produsen tetap dapat berkembang dengan aman.
1) Masalah "rapat yang hening": mengapa lakehouse membutuhkan tata kelola
Anda sedang mengikuti tinjauan kepemimpinan. Sebuah KPI muncul di layar, seperti retensi pendapatan, waktu tunggu pasien, atau risiko churn. Seseorang bertanya, "Dari mana angka ini berasal?" Ruangan pun hening. Anda tidak bisa menelusuri dataset, transformasinya, atau siapa yang terakhir mengubah logikanya minggu lalu. Pada saat seperti itu, Anda tidak hanya punya masalah analitik, melainkan masalah kepercayaan terhadap data.
Lakehouse dalam bahasa sederhana: satu atap, dua janji
Lakehouse adalah perpaduan praktis: fleksibilitas data lake (simpan apa saja, cepat) plus keandalan data warehouse (tabel yang konsisten, performa yang kuat). Di bawah satu atap, Anda bisa mengelola data terstruktur dan tidak terstruktur, menjalankan analitik real-time, dan mendukung beban kerja machine learning. Nilai "semua dalam satu" inilah yang menjadi alasan mengapa strategi arsitektur lakehouse Anda harus menyertakan tata kelola sejak hari pertama.
Mengapa lakehouse memperkuat kebutuhan tata kelola data lakehouse
Lakehouse bergerak cepat: aliran streaming, pelatihan ulang model yang sering, dan banyak tim yang merilis dasbor secara bersamaan. Kecepatan itu melipatgandakan risiko. Tipe data yang beragam dan banyaknya alat memudahkan Anda kehilangan jejak definisi, izin, dan lineage. Ketika Anda tidak bisa menjelaskan sebuah metrik, para pemangku kepentingan berhenti mempercayai dasbor tersebut, meskipun angkanya benar.
- Data real-time memperbesar kemungkinan snapshot yang tidak konsisten dan KPI yang "bergerak terus".
- Pipeline ML menambah aset baru yang perlu diatur: fitur, kumpulan data pelatihan, keluaran model, dan sinyal drift.
- Lebih banyak pengguna (analis, data scientist, tim produk) berarti lebih banyak jalur akses—dan lebih banyak celah untuk melanggar kebijakan.
Tata kelola bukan urusan administrasi—melainkan cara Anda terus merilis dengan aman
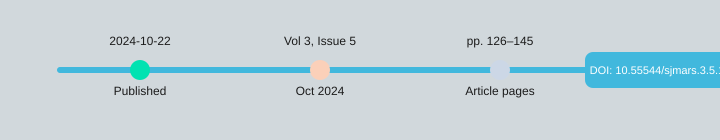
Studi terulas sejawat "Data Governance in Lakehouse" dari Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay) yang diterbitkan pada 22-10-2024 di Volume 3, Issue 5 (hlm. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12) memandang tata kelola sebagai kebutuhan strategis sekaligus keharusan operasional. Pesannya sederhana: tata kelola melindungi Anda dalam hal kepatuhan (GDPR, HIPAA, CCPA), mengurangi risiko, serta menjaga kualitas data dan kepercayaan pemangku kepentingan.
Samarth Shah: "Di lakehouse, kecepatan tanpa tata kelola bukanlah kelincahan—melainkan kebingungan yang lebih cepat."
Dalam praktiknya, tata kelola data lakehouse berarti Anda dapat menjawab "KPI ini apa?" dengan bukti: metadata, entri katalog, kontrol akses (seperti RBAC), jejak audit, dan lineage. Ini bukan birokrasi. Ini adalah sistem yang memungkinkan Anda menghadirkan analitik dengan cepat—tanpa melanggar hukum atau kepercayaan.
| Item metadata | Nilai |
|---|---|
| Tanggal publikasi | 22-10-2024 |
| Edisi jurnal | Volume 3, Issue 5 (Okt 2024) |
| Halaman | 126–145 |
| ISSN | 2583-3340 |
2) Seperti apa "tata kelola yang baik" saat data Anda ada di mana-mana
Di lakehouse, data Anda tidak "berada di satu tempat." Data tersebar di tabel, file, stream, dan fitur ML—sering kali di platform seperti AWS, Snowflake, atau Databricks. Tata kelola yang baik adalah cara menjaga data tetap dapat digunakan dan aman tanpa memperlambat tim. Anggap ini sebagai pagar pengaman, bukan gerbang: Anda mengaktifkan analitik real-time sambil memenuhi ekspektasi GDPR, HIPAA, dan CCPA.
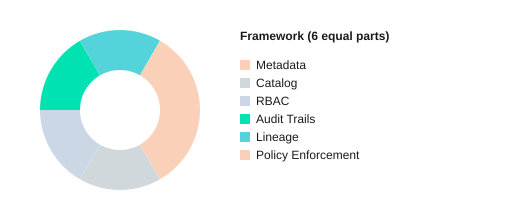
6 blok bangunan yang benar-benar akan Anda terapkan
- Tata kelola berbasis metadata: tentukan pemilik, sensitivitas, retensi, dan aturan kualitas dalam metadata agar kontrol dapat mengikuti volume dan perubahan.
- Praktik terbaik katalog data: satu tempat yang dapat dicari untuk definisi, tag, dan dataset tepercaya—agar orang tidak lagi menebak-nebak.
- Kontrol akses RBAC: peran dipetakan sesuai kebutuhan pekerjaan (analis, engineer, klinisi), bukan izin ad hoc.
- Pelacakan lineage data: tunjukkan asal data, bagaimana data berubah, dan apa yang menjadi sumbernya.
- Jejak audit: siapa mengakses apa, kapan, dan apa yang mereka lakukan—krusial untuk investigasi dan audit.
- Penegakan kebijakan: pemeriksaan otomatis (masking, retensi, persetujuan) yang berjalan secara default, bukan atas permintaan.
Tata kelola yang didokumentasikan vs. yang ditegakkan (hanya satu yang mencegah insiden)
Tata kelola yang didokumentasikan adalah halaman wiki yang menyatakan "PII harus di-mask." Tata kelola yang ditegakkan terjadi ketika lakehouse Anda secara otomatis melakukan masking PII berdasarkan tag metadata, memblokir ekspor berisiko, dan mencatat akses dalam jejak audit. Penelitian di balik tata kelola lakehouse modern menunjukkan bahwa otomatisasi dan metadata mengurangi waktu serta kesalahan penegakan manual—karena platform menerapkan aturan secara konsisten.
Tata kelola terpadu saat Anda mengelola tabel, file, stream, dan fitur sekaligus
Anda membutuhkan satu control plane yang berfungsi di seluruh tabel batch, file object-store, stream seperti Kafka, dan kumpulan fitur ML. Ketika tata kelola terpadu, RBAC, tag, dan kebijakan yang sama mengikuti data—sehingga dasbor, notebook, dan model Anda tetap selaras serta patuh.
Selingan singkat: bagaimana "satu dataset bersama" berubah menjadi 12 versi
Tanpa pelacakan lineage data, dataset "customer" disalin menjadi customer_v2, customer_clean, customer_final, dan "final_final." Tak lama kemudian, tim berdebat soal angka karena tidak ada yang bisa membuktikan versi mana yang menjadi sumber laporan mana.
Shubham Jain: "Lineage adalah perbedaan antara 'saya rasa' dan 'saya bisa membuktikannya' ketika seseorang mempertanyakan angka Anda."
Daftar periksa mandiri 5 menit
- Dapatkah Anda menemukan pemilik dan tag sensitivitas untuk 10 dataset teratas Anda di katalog?
- Apakah peran (bukan individu) yang mengontrol akses melalui RBAC?
- Dapatkah Anda melacak KPI kembali ke sumbernya dengan lineage dalam waktu kurang dari 2 menit?
- Apakah jejak audit saat ini dapat menjawab "siapa yang melihat/mengekspor ini"?
- Apakah kebijakan ditegakkan secara otomatis (masking, retensi, persetujuan), bukan secara manual?
Setiap kontrol terkait dengan hasil: lebih sedikit insiden akses (RBAC + kebijakan), audit lebih cepat (jejak audit + katalog), dan analitik yang lebih bersih (metadata + lineage).
3) Angka-angka yang membuat tata kelola terasa tidak lagi sebagai "beban tambahan"
Jika tata kelola terdengar seperti "proses tambahan," hasil penelitian ini membantu Anda membingkainya ulang sebagai keuntungan operasional yang terukur. Ketika Anda menerapkan tata kelola berbasis metadata dengan otomatisasi dan ML di lakehouse, Anda tidak sekadar "menambah kontrol"; Anda sedang menghemat waktu, meningkatkan kepercayaan terhadap data, dan menurunkan risiko kepatuhan dengan cara yang bisa dipantau oleh CFO.
Tata kelola berbasis metadata: ROI yang bisa Anda tampilkan di slide
Studi ini melaporkan tiga hasil utama ketika tim mengandalkan metadata, katalogisasi, lineage, dan kontrol akses yang kuat:
- Peningkatan efisiensi tata kelola hingga 40%
- Peningkatan kualitas data sebesar 35%
- Tingkat keberhasilan kepatuhan GDPR HIPAA sebesar 92% (GDPR/HIPAA)
Secara praktis, peningkatan efisiensi 40% sering kali berarti lebih sedikit tinjauan manual, lebih sedikit putaran pertanyaan "siapa pemilik dataset ini?", dan persetujuan akses serta pembagian data yang lebih cepat. Daftar pekerjaan Anda menyusut karena pemeriksaan rutin berpindah dari manusia ke sistem, dan antrean insiden Anda berkurang karena lebih sedikit masalah yang sampai ke produksi.
Penegakan kebijakan otomatis: perbandingan sebelum dan sesudah yang mengubah percakapan
Bukti paling jelas tentang "beban versus manfaat" adalah pergeseran dari kontrol manual ke penegakan kebijakan otomatis:
- Waktu penegakan kebijakan: 72% → 28%
- Tingkat kesalahan: 45% → 15%
Ini bukan optimasi kecil. Inilah perbedaan antara tata kelola yang menjadi gerbang dan tata kelola yang menjadi pagar pengaman. Anda menghabiskan lebih sedikit waktu untuk mengejar pengecualian dan lebih banyak waktu untuk mendukung layanan mandiri yang aman.
"Tata kelola terpadu hanya bertahan ketika alur kerjanya lebih mudah daripada jalan pintas." —Taylor, Singh, & Green (2021)
Realitas adopsi: kuat untuk pengguna teknis, lebih sulit untuk yang lain
Skor kegunaan tinggi di kalangan data scientist, business analyst, dan administrator TI (4,2–4,7/5). Namun, makalah ini juga mencatat kesenjangan yang umum: pengguna nonteknis membutuhkan antarmuka yang lebih sederhana, definisi yang lebih jelas, dan alur kerja yang terpandu. Jika Anda ingin mencapai angka-angka di atas, Anda harus menganggarkan untuk pendampingan dan pelatihan, bukan hanya untuk alat.
Metrik utama sekilas
| Metrik | Hasil |
|---|---|
| Peningkatan efisiensi tata kelola | Hingga 40% |
| Peningkatan kualitas data | 35% |
| Tingkat kepatuhan GDPR HIPAA | 92% |
| Waktu penegakan kebijakan | 72% (manual) vs 28% (otomatis) |
| Tingkat kesalahan | 45% (manual) vs 15% (otomatis) |
| Peringkat kegunaan | 4,2–4,7 dari 5 |
| Pengurangan waktu pemrosesan | 25% |
4) Alat, prototipe, dan kenyataan berantakan dalam implementasi
Apa yang dilakukan penelitian (dalam istilah sederhana)
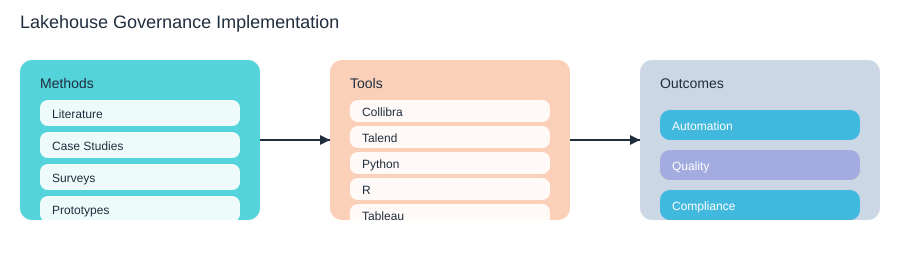
Studi Stallion Journal tidak memperlakukan tata kelola sebagai masalah slide presentasi. Studi ini menggunakan empat metode yang mungkin sudah Anda kenali dari pekerjaan nyata: ia membaca literatur (tinjauan sistematis), meninjau studi kasus industri, men-survei pemangku kepentingan, lalu menguji prototipe. Bagian terakhir ini penting, karena tata kelola lakehouse gagal di celah antara kebijakan dan pipeline, terutama ketika data Anda datang dengan cepat, sering berubah, dan berasal dari banyak tim.
Tumpukan prototipe: apa yang benar-benar dicoba
Dalam eksperimen, studi ini menggunakan Collibra dan Talend untuk pola tata kelola dan integrasi, serta alat analitik (Python, R, Tableau) untuk memvalidasi kegunaan dan hasil. Anda dapat menerapkan pendekatan ini baik saat menjalankan tata kelola Databricks, penyiapan lakehouse Snowflake, maupun tata kelola data cloud-native yang lebih luas dengan Kubernetes, Docker, Kafka, Postgres, PySpark, dan Elasticsearch di dalamnya.
Jalur penerapan yang bisa Anda tiru (dan tetap terkendali)
Keberhasilan implementasi bergantung pada tata kelola yang didukung alat dan kemampuan Anda menangani kecepatan, kompleksitas, serta keterbatasan sumber daya. Urutan praktis yang dapat diterapkan adalah:
- Mulai dengan katalog + RBAC: terapkan praktik terbaik katalog data (kepemilikan yang jelas, istilah bisnis, dan dataset "emas"). Kemudian petakan akses menggunakan RBAC.
- Tambahkan lineage: catat dampak hulu/hilir agar perubahan tidak mengejutkan analis atau auditor.
- Otomatiskan penegakan: beralih dari persetujuan manual ke policy-as-code jika memungkinkan, dengan jejak audit.
Harris & Nguyen (2020): "RBAC itu sederhana di atas kertas; ia menjadi nyata pada hari Anda memetakannya ke tim, bukan ke jabatan."
Musuh harian Anda: kecepatan dan aliran data yang tidak konsisten
Aliran data berkecepatan tinggi (misalnya aliran bergaya Kafka) menimbulkan "schema drift", peristiwa yang terlambat, dan rekaman duplikat. Di sinilah tata kelola terasa berantakan: katalog Anda menyatakan sebuah kolom wajib diisi, tetapi aliran data justru menghilangkannya; aturan kualitas Anda mengharapkan satu stempel waktu, tetapi produsen data mengirim tiga. Studi ini menandai hal tersebut sebagai hambatan yang terus berulang, terutama ketika tim kekurangan personel.
Penyebaran alat yang tidak terkendali: ketika sistem saling bertentangan
Waspadai masalah split-brain klasik: katalog Anda menampilkan Dataset A sebagai "restricted", tetapi grup IAM masih mengizinkan akses luas. Atau, kebijakan tata kelola Databricks Anda tidak sesuai dengan yang dikonfigurasi di IAM cloud. Anggaplah "satu sumber kebenaran" sebagai tujuan desain, bukan sekadar slogan.
| Sudut pandang pengambilan keputusan | Jaga agar tetap sederhana |
|---|---|
| Beli atau bangun sendiri | Beli untuk katalog dan alur kerja; bangun sendiri hanya konektor dan pemeriksaan yang ringan. |
| Hindari labirin tata kelola | Satu katalog, satu model kebijakan, peran kustom seminimal mungkin, dan audit otomatis. |
5) Titik nyeri tata kelola teratas (dan cara Anda memprioritaskannya)
Jika tata kelola terasa lebih sulit daripada yang "seharusnya", Anda tidak sendirian. Dalam sintesis riset, 78% organisasi menyebut tantangan manajemen metadata sebagai titik nyeri utama. Angka ini mungkin membuat Anda merasa dipahami, karena di lakehouse semuanya bergerak cepat, dan metadata adalah peta yang harus Anda perbarui sementara jalannya masih dibangun.
Mengapa metadata rusak lebih dulu (dan terus rusak)
Metadata sulit dikelola karena:
- Definisi bergeser: "Pelanggan aktif" berarti satu hal bagi tim Keuangan dan hal lain bagi tim Growth.
- Kepemilikan tidak jelas: tidak ada yang yakin siapa yang menyetujui kolom baru, tabel baru, atau aturan retensi baru.
- Pipeline berubah setiap minggu: sumber baru, join baru, fitur ML baru. Katalog dan tag Anda pun tertinggal.
Namun, ketika Anda berinvestasi dalam tata kelola, Anda memperoleh imbal hasil yang terukur: 88% melaporkan peningkatan tata kelola kualitas data, dan 81% melaporkan tata kelola keamanan lakehouse yang lebih baik. Inilah imbalan dari pekerjaan yang tidak glamor, tetapi perlu dilakukan.
Triase tata kelola: perbaiki hal yang tepat dengan urutan yang tepat
- Metadata dan kepemilikan terlebih dahulu: definisikan elemen data kritis, tetapkan data owner dan steward, serta standarkan istilah bisnis di katalog Anda.
- Kontrol akses berikutnya: terapkan RBAC dengan prinsip hak akses minimum, ditambah jalur persetujuan yang jelas untuk pengecualian.
- Lineage dan jejak audit: lacak asal data, cara data berubah, dan siapa yang menyentuhnya. Di sinilah pertanyaan terkait GDPR/HIPAA/CCPA dapat dijawab dengan cepat.
- Otomatisasi terakhir (tetapi dilakukan secara bertahap): otomatiskan pemeriksaan kebijakan, pemberian tag, dan deteksi anomali agar penegakan aturan tidak bergantung pada aksi kepahlawanan.
Apa yang rusak ketika HIPAA bertemu CCPA?
Bayangkan sebuah lakehouse tempat dataset kesehatan yang diatur HIPAA (riwayat kunjungan pasien) digabungkan dengan dataset pemasaran yang tercakup CCPA (perilaku web). Yang biasanya rusak lebih dulu adalah klasifikasi dan persetujuan: tag PHI hilang, flag persetujuan tidak ikut terbawa melalui join, dan dasbor hilir memperlihatkan lebih dari yang seharusnya. Tanpa lineage, Anda tidak dapat membuktikan ke mana data itu pergi. Tanpa RBAC, Anda tidak dapat menghentikan akses yang terlalu luas. Tanpa jejak audit dan manajemen identitas, Anda tidak dapat menunjukkan akuntabilitas.
"Tantangan sebenarnya bukan membuat AI berfungsi, melainkan membuatnya berfungsi secara bertanggung jawab di dalam sistem yang sudah Anda miliki."
— Dr. Fei-Fei Li
Ritual sederhana yang menjaga kewarasan Anda: retrospektif tata kelola bulanan
Jalankan retrospektif bulanan selama 45 menit bersama pemilik bisnis, IT, dan keamanan. Tinjau: 3 celah metadata teratas, 3 pengecualian akses teratas, satu kegagalan lineage, dan satu keberhasilan otomatisasi. Catat tindakan dalam pelacak bersama dan tetapkan satu penanggung jawab untuk setiap item.
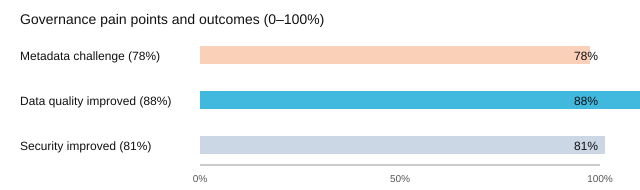
6) Kepatuhan tanpa paranoia: GDPR, HIPAA, CCPA di lakehouse
Di lakehouse, perlakukan kepatuhan sebagai kendala desain, bukan kepanikan di menit terakhir. Ketika Anda membangun kontrol ke dalam ingestion, penyimpanan, dan akses sejak hari pertama, kepatuhan GDPR HIPAA dan tata kelola data CCPA tidak lagi terasa seperti situasi darurat, melainkan operasi normal. Studi Stallion Journal tentang "Data Governance in Lakehouse" menunjukkan alasannya: organisasi yang menggunakan tata kelola berbasis metadata, otomatisasi, dan ML melaporkan tingkat kepatuhan GDPR dan HIPAA yang naik hingga 92%. Gunakan angka ini sebagai tolok ukur acuan utama, bukan sebagai jaminan.
"Keamanan adalah sebuah proses, bukan produk, dan tata kelola adalah cara Anda menjaga proses itu tetap jujur."
— Bruce Schneier
Petakan kontrol ke regulasi: perangkat kepatuhan inti Anda
Anda tidak bisa "memenuhi GDPR" atau "memenuhi HIPAA" hanya dengan menulis kebijakan. Anda perlu memetakan persyaratan ke kontrol yang dapat diulang di dalam lakehouse:
- RBAC (kontrol akses berbasis peran): batasi siapa yang dapat melihat PHI/PII dan siapa yang dapat mengekspornya.
- Jejak audit lakehouse: buktikan siapa yang mengakses apa, kapan, dari mana, dan apa yang mereka lakukan.
- Data lineage: tunjukkan dari mana kolom sensitif berasal, bagaimana perubahannya, dan ke mana datanya berakhir.
- Penegakan kebijakan: terapkan masking, retensi, dan batasan tujuan secara konsisten di berbagai alat.
- Manajemen metadata + katalog: klasifikasikan data, beri tag sensitivitas, dan jalankan otomatisasi.
| Regulasi | Yang dicari auditor | Kontrol lakehouse |
|---|---|---|
| GDPR | Akses yang sah, minimisasi, retensi | RBAC, masking, kebijakan retensi, lineage |
| HIPAA | Log akses, pengamanan, hak akses minimum | Jejak audit, RBAC, enkripsi, pemantauan |
| CCPA | Inventaris data, penanganan akses/penghapusan | Katalog + metadata, lineage, alur kerja kebijakan |
Gelombang berikutnya: aturan spesifik wilayah dan batasan sistem lama
Makalah ini menandai pekerjaan masa depan yang sebaiknya sudah Anda rencanakan sekarang: kepatuhan spesifik wilayah dan kemampuan adaptasi yang lebih baik untuk lingkungan lama atau terbatas. Jika Anda beroperasi lintas negara bagian atau negara, susun kebijakan yang dapat berbeda per wilayah (jangka waktu retensi, aturan persetujuan, pelaporan pelanggaran). Jika Anda masih menjalankan sistem lama, mulailah dengan cakupan yang lebih kecil dan integrasikan secara bertahap. Otomatisasi membantu, tetapi kompleksitasnya nyata.
Penelusuran "hari audit": apa saja yang perlu Anda tunjukkan
- Inventaris data: di mana PII/PHI berada, pemiliknya, dan tujuannya (
catalog + tags). - Bukti akses: peran RBAC, persetujuan, dan ekspor jejak audit lakehouse.
- Bukti lineage: jalur dari sumber ke laporan untuk dataset kunci dan kolom sensitif.
- Bukti kebijakan: masking, retensi, alur kerja penghapusan, dan log penegakan.
- Pihak yang hadir: pemilik data, tim keamanan, admin platform, kepatuhan/hukum, dan satu analis yang menggunakan data.
Tampilan radar: dasar vs lakehouse yang diatur tata kelola
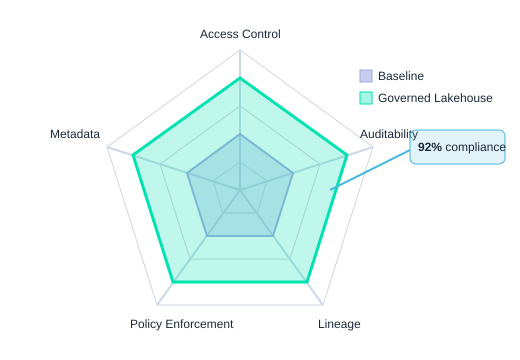
Catatan singkat dan jujur: jika Anda berada di organisasi yang lebih kecil, mulailah dengan dasar yang sederhana, yaitu RBAC, pencatatan log, dan katalog ringan, sebelum membeli alat tata kelola perusahaan. Studi ini jelas menyebutkan bahwa kompleksitas implementasi bisa menjadi hambatan nyata, terutama ketika sumber daya terbatas.
7) Bias vendor, politik, dan hal-hal yang sering dilewatkan dalam presentasi tata kelola
Anda bisa merancang model tata kelola lakehouse yang rapi di atas kertas, lalu melihatnya berubah bentuk begitu alat tata kelola data masuk ke ruangan. Kenyataan yang tidak nyaman adalah ini: alat dan vendor membentuk seperti apa "praktik terbaik" itu, karena merekalah yang menentukan apa yang mudah didemonstrasikan, mudah dibeli, dan mudah dilaporkan.
Studi lakehouse Stallion Journal menyoroti hal ini secara langsung di bagian konflik kepentingannya. Studi tersebut menandai tiga sumber bias yang sebaiknya Anda anggap ada dalam program tata kelola mana pun: bias vendor (lebih memilih platform seperti tumpukan tata kelola Collibra Talend governance atau suite komersial lainnya), bias pelaporan organisasi (hanya membagikan metrik "keberhasilan"), dan tekanan finansial/regulasi (memilih apa yang tampak paling aman bagi auditor, bukan apa yang sesuai dengan arsitektur Anda). Temuan penelitiannya jelas: transparansi dan pengungkapan diperlukan untuk menjaga integritas penelitian dan agar pilihan tata kelola Anda tetap berguna di luar narasi vendor.
Satya Nadella: "Kepercayaan adalah mata uang tertinggi, dan dalam data, Anda mendapatkannya dengan menjelaskan secara eksplisit apa yang Anda lakukan dan mengapa."
Risiko bias yang perlu Anda sebutkan secara terbuka
Risiko Bias Riset & Alat Tata Kelola. Bias Vendor 40%. Bias Pelaporan 35%. Finansial/Regulasi 25%. Bias Vendor. Bias Pelaporan. Finansial/Regulasi
Daftar periksa anti-bias Anda (praktis, bukan politis)
- Sampling: bandingkan setidaknya satu suite komersial dan satu opsi terbuka di ekosistem AWS, Snowflake, Databricks, SAP, dan Oracle Cloud Infrastructure.
- Pengungkapan: dokumentasikan sponsor, alasan pemilihan alat, dan apa yang tidak Anda uji.
- Kriteria evaluasi: kedalaman lineage, kesesuaian RBAC/ABAC, jejak audit, akses API, format ekspor, dan integrasi dengan tabel lakehouse Anda.
- Proof-of-value: jalankan pilot dengan batas waktu pada satu domain; ukur waktu penegakan kebijakan, tingkat kesalahan, dan gesekan pengguna.
- Pemeriksaan risiko vendor pada platform data: tanyakan bagaimana lock-in muncul dalam metadata, katalog, dan aturan alur kerja.
Cerita singkat: Anda memediasi keputusan yang sebenarnya
Tim pengadaan mendorong satu vendor demi "standardisasi." Para engineer menginginkan open source agar tetap memegang kendali. Tim kepatuhan menginginkan fitur yang "tersertifikasi" serta bukti audit yang rapi. Tugas Anda adalah menerjemahkan kebutuhan tersebut: Anda dapat memenuhi kepatuhan dengan kontrol yang kuat dan jejak audit, memenuhi kebutuhan engineer dengan API dan portabilitas, serta memenuhi pengadaan dengan ROI yang jelas, tanpa membiarkan satu kelompok pun mendefinisikan tata kelola sebagai "apa pun yang dijual oleh tool tersebut."
Bagaimana jika tool Anda diakuisisi dan harganya naik tiga kali lipat?
Anggap skenario itu bisa terjadi. Uji portabilitas sekarang: dapatkah Anda mengekspor glosarium bisnis, lineage, dan aturan kebijakan Anda dalam format yang dapat digunakan? Jika metadata Anda tidak dapat dipindahkan, tata kelola Anda bukanlah sebuah program, melainkan sebuah langganan.
8) Kesiapan masa depan: IoT, edge, data terdesentralisasi, dan lakehouse yang akan Anda warisi
Tata kelola lakehouse Anda bekerja paling baik ketika data sebagian besar terpusat, ramah untuk pemrosesan batch, dan dikendalikan oleh beberapa platform saja. Tata kelola IoT dan edge computing dengan cepat mematahkan asumsi tersebut: Anda menghadapi lebih banyak sumber (perangkat, gateway, aplikasi), kendali pusat yang lebih sedikit (tim melakukan deployment secara mandiri), dan batasan latensi yang lebih ketat (Anda tidak bisa "menunggu job malam" untuk memutuskan akses atau kualitas). Studi Stallion Journal secara langsung menyoroti tekanan ini dan merekomendasikan perluasan tata kelola untuk tiga domain yang sedang berkembang: IoT data lakes, arsitektur terdesentralisasi, dan edge computing.
Mengapa IoT dan edge menguji model Anda saat ini
Pada stream IoT, peristiwa "pelanggan" yang sama dapat datang dari beberapa sensor, dalam format berbeda, dan pada waktu berbeda. Jika kebijakan Anda bergantung pada pembaruan katalog pusat tunggal, Anda akan memperlambat operasi atau menerima titik buta. Lokasi edge juga membuat salinan data lokal demi kecepatan dan ketahanan, yang berarti jejak audit, lineage, dan aturan retensi Anda harus ikut berpindah bersama data, bukan terkunci dalam satu control plane bergaya data warehouse.
Arsitektur data terdesentralisasi membutuhkan tata kelola yang portabel
Dalam arsitektur data terdesentralisasi, domain menerbitkan produk data dan mengembangkan schema sesuai jadwal masing-masing. Hal itu sehat untuk kecepatan pengiriman, tetapi berisiko jika definisi "PII," "persetujuan," atau "cakupan HIPAA" tidak konsisten. Kesiapan masa depan berarti Anda merancang tata kelola sebagai layanan bersama: metadata yang dapat diperluas, kebijakan yang diversi, dan kontrol identitas yang berfungsi lintas tim dan wilayah, selaras dengan seruan makalah tersebut agar kepatuhan dapat disesuaikan dengan kebutuhan wilayah tertentu.
Bangun di atas blok cloud-native yang dapat Anda warisi
Kumpulan referensi di sekitar studi ini menunjuk pada blok bangunan praktis: Docker untuk mengemas layanan kebijakan, Kubernetes untuk menjalankannya di mana saja, Kafka untuk stream hook penegakan kebijakan, Elasticsearch untuk penemuan data yang cepat, dan Postgres/PySpark untuk pemrosesan data yang terkelola. Anda tidak memilih tool karena tren; Anda memilih apa yang dapat berjalan di cloud, on-prem, dan edge dengan kontrol yang sama.
"Segala sesuatu gagal, sepanjang waktu. Rancang tata kelola dengan asumsi perubahan, bukan stabilitas." — Werner Vogels
Roadmap taruhan kecil yang membuat Anda terus bergerak
Anda tidak perlu menyelesaikan tata kelola edge sepenuhnya hari ini. Yang perlu Anda miliki adalah sistem metadata dan kebijakan yang dapat diperluas tanpa perlu ditulis ulang. Mulailah dengan menguji deteksi anomali berbasis AI pada sinyal tata kelola (schema drift, jalur akses yang tidak biasa, ekspor di luar pola), lalu perluas ke pemeriksaan kebijakan otomatis saat ingestion dan saat query. Seiring bertambahnya cakupan, tambahkan manajemen identitas yang lebih kuat, pertimbangkan bukti anti-manipulasi bergaya blockchain untuk jejak audit kritis, dan rencanakan pemulihan bencana yang sesuai dengan tingkat risiko Anda.
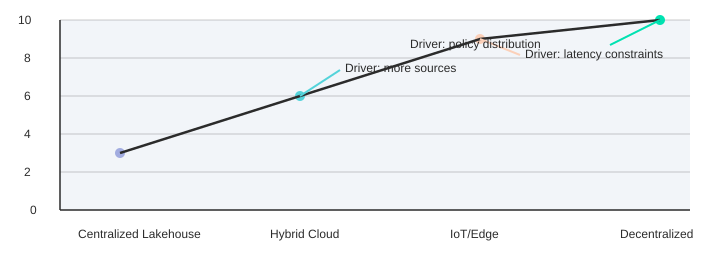
| Lingkungan | Indeks Kompleksitas Tata Kelola (ilustratif) |
|---|---|
| Lakehouse Terpusat | 3 |
| Cloud Hibrida | 6 |
| IoT/Edge | 9 |
| Terdesentralisasi | 10 |
Tulislah prinsip tata kelola Anda seolah-olah Anda akan digantikan: definisi yang jelas, kebijakan yang portabel, dan catatan keputusan yang tetap bertahan meski terjadi reorganisasi. Lakehouse yang Anda warisi nanti akan lebih berantakan dibandingkan hari ini, dan versi diri Anda di masa depan akan lebih tenang jika Anda merancangnya untuk kondisi itu sejak sekarang.
arsitektur lakehouse microsoft fabric: memahami microsoft fabric untuk analitik dan rekayasa data
Apa itu arsitektur lakehouse Microsoft Fabric?
Arsitektur lakehouse Microsoft Fabric adalah desain platform data terpadu yang menggabungkan unsur data lake dan data warehouse untuk menyimpan data mentah serta dataset terstruktur yang sudah ditransformasi dalam satu lokasi. Arsitektur ini memanfaatkan Azure Data Lake Storage untuk volume data, mesin komputasi Fabric untuk pemrosesan, dan pola arsitektur medallion untuk mengelola lapisan mentah, diperkaya, dan terkurasi. Dengan cara ini, tim dapat menganalisis data, menjalankan beban kerja data science, dan menyajikan laporan di Power BI tanpa menduplikasi data.
Bagaimana cara kerja arsitektur medallion dalam lakehouse Fabric?
Arsitektur medallion di Fabric mengatur data ke dalam beberapa lapisan, yang umumnya berupa bronze (data mentah), silver (data yang sudah dibersihkan dan diperkaya), dan gold (data terkurasi yang siap untuk analitik/BI). Fabric mengintegrasikan alat ingestion dan transformasi data untuk memindahkan serta mengubah data di antara lapisan-lapisan tersebut. Dengan begitu, alur kerja rekayasa data dan persiapan data dapat berjalan sambil tetap mempertahankan satu salinan data dan mengurangi duplikasi data, sekaligus mendukung analitik dan data science.
Bagaimana cara menerapkan lakehouse di Microsoft Fabric dan membuat lakehouse?
Untuk menerapkan lakehouse di Microsoft Fabric, mulailah dengan menghubungkan sumber data Anda dan melakukan ingestion data ke Azure Data Lake menggunakan kemampuan ingestion data Fabric. Gunakan mesin komputasi Fabric atau transformasi dataflow untuk menerapkan pemrosesan arsitektur medallion, mengkatalogkan dataset di OneLake, dan mengamankan akses. Integrasikan Power BI dan alat analitik lainnya untuk pelaporan. Platform ini menyederhanakan manajemen data, mendukung integrasi data dari data yang sudah ada maupun big data, dan memungkinkan Anda mentransformasi data tanpa memindahkannya secara tidak perlu.
Apa perbedaan antara lakehouse dan data warehouse tradisional di Microsoft Fabric?
Lakehouse menggabungkan fleksibilitas data lake untuk data mentah dan semi-terstruktur dengan performa serta pengelolaan skema dari data warehouse. Di Microsoft Fabric, lakehouse memungkinkan penyimpanan data di Azure Data Lake Storage sekaligus memberikan performa kueri setara warehouse melalui mesin komputasi Fabric. Hal ini menghadirkan kemampuan data warehouse, seperti data terkurasi dan terstruktur untuk analitik, sambil tetap mempertahankan fleksibilitas data lake untuk tugas data modern dan rekayasa data.
Bagaimana Fabric menangani ingestion data dan menghindari duplikasi data?
Fabric mendukung berbagai pola ingestion data, yaitu streaming, batch, dan konektor ke sumber data perusahaan, ke dalam satu data lake pusat (Azure Data Lake). Dengan menggunakan arsitektur medallion dan OneLake, Fabric mendorong adanya satu salinan data dan dataset logis, bukan menduplikasi salinan fisik. Alat integrasi dan transformasi data memungkinkan Anda melakukan ingestion data, mentransformasi data di tempatnya, serta menyediakan akses data yang konsisten untuk beban kerja analitik dan data science, sehingga duplikasi data antarsistem dapat diminimalkan.
Bisakah saya menggunakan data warehouse dan data Azure yang sudah ada bersama lakehouse Fabric?
Bisa. Fabric terintegrasi dengan sistem Microsoft maupun pihak ketiga, sehingga Anda dapat melakukan federasi kueri ke data warehouse, synapse, dan Azure Data Lake Storage yang sudah ada sekaligus mengonsolidasikan akses ke lanskap data Anda. Anda dapat melakukan ingestion atau merujuk data yang sudah ada, menerapkan pola data mesh, dan memilih apakah data akan dipindahkan ke lakehouse atau diakses langsung, sesuai kebutuhan tata kelola, biaya, dan performa.
Apa saja kasus penggunaan umum untuk lakehouse Fabric dalam analitik dan data science?
Kasus penggunaan umum meliputi manajemen data terpadu untuk BI dengan Power BI, persiapan dataset mentah berukuran besar untuk machine learning dan data science, pembangunan pipeline ELT dengan arsitektur medallion, analisis data lintas sistem perusahaan, serta penyediaan satu lokasi untuk data terstruktur maupun tidak terstruktur. Fabric menyederhanakan pemrosesan data, memungkinkan analisis data yang dapat diskalakan, dan mendukung arsitektur data modern seperti data mesh serta katalog data perusahaan.
Bagaimana keamanan, tata kelola, dan akses data bekerja di lakehouse Fabric?
Fabric menyediakan kontrol akses berbasis peran, kebijakan data, serta integrasi dengan Microsoft Purview dan Azure Active Directory untuk tata kelola dan data lineage. OneLake dan konstruksi lakehouse memungkinkan izin yang terperinci pada data yang disimpan di Azure Data Lake Storage. Hal ini memastikan akses data yang aman, kepatuhan, dan alur persiapan data yang terkendali, sekaligus menjaga auditability di seluruh tahap ingestion dan transformasi data.
Mesin komputasi Fabric mana yang sebaiknya saya gunakan untuk beban kerja yang berbeda di lakehouse?
Fabric menyediakan beberapa mesin komputasi yang dioptimalkan untuk beban kerja tertentu: kueri SQL interaktif untuk analitik dan BI, Spark untuk pemrosesan big data dan rekayasa data, serta mesin khusus untuk ingesti real-time. Pilih mesin komputasi Fabric berdasarkan karakteristik beban kerja—gunakan Spark untuk transformasi skala besar, SQL warehouse untuk kueri BI, dan mesin streaming untuk ingesti data berkelanjutan—agar biaya, performa, dan kebutuhan pemrosesan data tetap seimbang.
Di mana saya bisa mempelajari lebih lanjut dan mulai menggunakan arsitektur lakehouse Microsoft Fabric?
Untuk memulai, ikuti tutorial di Microsoft Learn, pelajari dokumentasi tentang arsitektur lakehouse di Microsoft Fabric, dan jelajahi contoh arsitektur medallion di Fabric. Mulailah dengan menghubungkan sumber data, melakukan ingesti data mentah ke Azure Data Lake Storage, menerapkan pipeline medallion sederhana, dan memvisualisasikan hasilnya di Power BI untuk memahami bagaimana Fabric menyederhanakan pembuatan lakehouse dan penyajian analitik dari satu data estate yang terpadu.