 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Padroneggiare Azure Event Hubs: partizioni, gruppi di consumer e scalabilità
By Mirko Peters ·
Bentornati nel nostro percorso continuo di esplorazione dell'architettura cloud e dell'ingegneria dei dati in tempo reale. Nel mondo delle applicazioni enterprise moderne, il volume di dati generato da utenti, dispositivi IoT, microservizi e aggregatori di log è impressionante. Le organizzazioni non si limitano più a memorizzare i dati per l'elaborazione batch notturna; hanno bisogno di insight ut
Automatically translated with AI from the original post. Read the English original
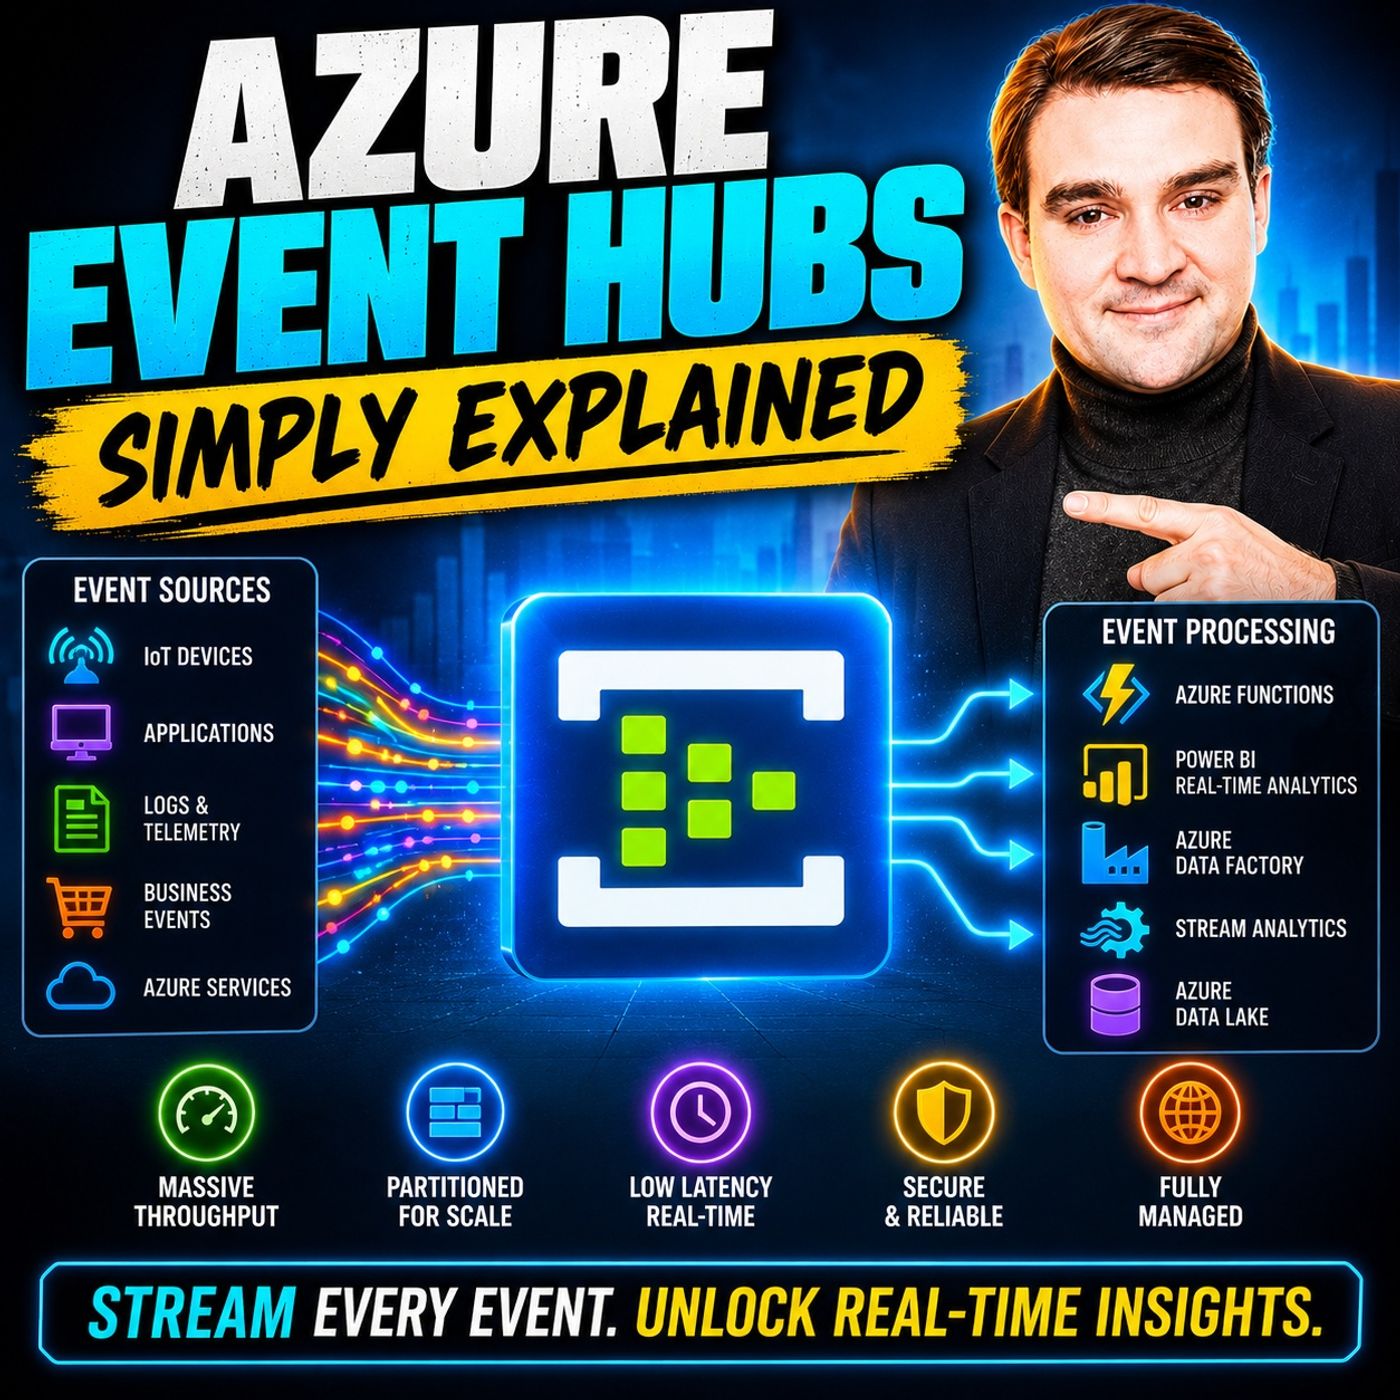
Bentornati nel nostro percorso continuo di esplorazione dell'architettura cloud e dell'ingegneria dei dati in tempo reale. Nel mondo delle applicazioni enterprise moderne, il volume di dati generato da utenti, dispositivi IoT, microservizi e aggregatori di log è impressionante. Le organizzazioni non si limitano più a memorizzare i dati per l'elaborazione batch notturna; hanno bisogno di insight utilizzabili subito. Per rispondere a questa esigenza, gli architetti cloud ricorrono a robuste piattaforme di streaming di eventi. Se stai costruendo soluzioni nell'ecosistema Microsoft Azure, Azure Event Hubs si distingue come il servizio completamente gestito di riferimento per l'acquisizione su larga scala.
In questa guida completa approfondiremo i componenti architetturali fondamentali che fanno funzionare Azure Event Hubs. Vedremo come le partizioni consentano un'elaborazione parallela massiva, come i gruppi di consumer permettano a più applicazioni di leggere lo stesso flusso senza interferire tra loro, e analizzeremo strategie di scalabilità come le unità di throughput e l'auto-inflation. Che tu stia progettando un sistema di rilevamento delle frodi finanziarie o una pipeline globale di telemetria, comprendere questi concetti di base è fondamentale per il successo del progetto.
Se preferisci un approfondimento in formato audio, non perdere il nostro episodio di podcast correlato su Azure Event Hubs - Simply Explained, in cui spieghiamo questi pattern architetturali con un linguaggio chiaro e pratico.
Introduzione all'architettura di Azure Event Hubs
Nella sua essenza, Azure Event Hubs è progettato come un motore di acquisizione eventi altamente scalabile. Può ricevere ed elaborare milioni di eventi al secondo con latenza ultra-bassa, fungendo da punto d'ingresso per le pipeline di big data nel cloud. Immaginalo come un enorme parcheggio multipiano, molto ben organizzato, per i pacchetti di dati. I produttori, come app mobili, log dei server o sensori di fabbrica, depositano i propri payload nell'hub, e i consumer, come Azure Stream Analytics, Azure Functions o servizi worker personalizzati, li prelevano per l'elaborazione.
A differenza delle tradizionali code di messaggi, che conservano i messaggi fino a quando un singolo consumer non ne conferma la ricezione (momento in cui il messaggio viene rimosso), Azure Event Hubs opera secondo un modello di streaming. I dati vengono aggiunti a un log immutabile. Ciò significa che più sistemi a valle possono leggere lo stesso flusso di dati in modo indipendente, al proprio ritmo, senza compromettere i dati per gli altri lettori. Per gestire la velocità dei carichi di lavoro moderni, Event Hubs si affida a un'architettura distribuita costruita attorno a due concetti fondamentali: partizioni e gruppi di consumer.
Comprendere le partizioni per l'elaborazione parallela
Se vuoi ottenere un throughput elevato, non puoi far passare tutti i dati in ingresso attraverso un unico collo di bottiglia nell'elaborazione. È qui che entrano in gioco le partizioni. Una partizione è essenzialmente una sequenza distinta di eventi contenuta in un event hub. Quando crei un event hub devi specificare il numero di partizioni, che per i piani standard va in genere da 2 a 32, anche se per gli ambienti dedicati sono disponibili limiti molto più alti.
Quando i produttori inviano eventi, possono includere una chiave di partizione, come un ID dispositivo, un ID utente o una regione di transazione. Event Hubs calcola l'hash di questa chiave e instrada l'evento verso una partizione specifica. Questo garantisce che tutti gli eventi che condividono la stessa chiave finiscano sempre nella stessa partizione, preservando un ordinamento rigoroso per i dati correlati.
La vera forza delle partizioni sta nell'elaborazione parallela. Suddividendo il flusso di dati complessivo in più segmenti indipendenti, più istanze di consumer possono leggere da partizioni diverse contemporaneamente. Ad esempio, se il tuo event hub ha 16 partizioni, puoi distribuire un'applicazione consumer con 16 istanze di lettura distinte, ciascuna dedicata a una sola partizione. Questo modello di scalabilità orizzontale fa sì che la capacità di elaborazione cresca in modo lineare all'aumentare del carico di lavoro.
Sfruttare i gruppi di consumer per il consumo indipendente dei dati
In un ambiente aziendale complesso, un singolo flusso di dati raramente viene usato da un solo team. Il tuo security operations center potrebbe voler analizzare i log alla ricerca di anomalie, il team di data science potrebbe voler alimentare un modello di machine learning con i dati di telemetria e il reparto fatturazione potrebbe voler monitorare le metriche di utilizzo, il tutto a partire dallo stesso identico flusso di eventi in ingresso.
Azure Event Hubs risolve questa esigenza tramite i gruppi di consumer. Un gruppo di consumer rappresenta una visione completa dell'intero event hub. Funziona come un cursore o un raccoglitore di segnalibri. Creando più gruppi di consumer, più applicazioni consumer possono leggere in modo concorrente il flusso di eventi, dall'inizio alla fine, in modo indipendente.
Poiché ogni gruppo di consumer mantiene un proprio offset separato, ovvero un puntatore che indica quali eventi sono già stati letti, l'applicazione consumer A può elaborare gli eventi in tempo reale mentre l'applicazione consumer B può essere in ritardo o riprodurre dati storici della giornata, senza interferire l'una con l'altra. Questo disaccoppiamento di producer e consumer è ciò che rende Event Hubs un hub di integrazione così versatile per le architetture aziendali moderne.
Strategie di scalabilità: Throughput Unit, Processing Unit e auto-inflation
Gestire la capacità in modo efficace è una delle responsabilità più importanti di un cloud architect. Azure Event Hubs offre piani tariffari flessibili e meccanismi di scalabilità per garantire che la tua architettura resti performante ed economicamente efficiente con carichi variabili.
Per il piano Standard, la capacità si misura in Throughput Unit (TU). Una singola Throughput Unit garantisce 1 MB/s in ingresso e 2 MB/s in uscita, insieme a un massimo di 1.000 eventi in ingresso al secondo per TU. Se il traffico subisce picchi, la scalabilità manuale può essere laboriosa e soggetta a errori umani. Per fortuna, Event Hubs dispone di una funzionalità di scalabilità automatica nativa nota come Auto-Inflate.
Quando Auto-Inflate è abilitato, Azure aumenta automaticamente il numero di Throughput Unit in base al carico di traffico, evitando il throttling e garantendo che la pipeline di acquisizione non perda mai pacchetti durante picchi imprevisti. Per le organizzazioni che richiedono risorse di calcolo dedicate e isolate, con garanzie di prestazioni prevedibili, i piani Premium e Dedicated introducono le Processing Unit (PU), che offrono limiti più elevati, nessuna interferenza da parte di "noisy neighbor" e un isolamento di livello enterprise.
Affidabilità dei dati, conservazione e disaster recovery
Quando si gestiscono dati di telemetria ad alta velocità e log aziendali critici, la perdita di dati non è semplicemente un'opzione. Azure Event Hubs integra meccanismi solidi per garantire la durabilità dei dati e un'elevata disponibilità.
By default, i dati scritti in Event Hubs vengono replicati su più fault domain all'interno di una regione Azure. Inoltre, il piano Standard conserva i dati fino a 7 giorni, mentre i piani Premium e Dedicated estendono la conservazione fino a 90 giorni. Questo intervallo di conservazione consente alle applicazioni di recuperare da interruzioni prolungate riproducendo i dati a partire da un determinato momento nel tempo.
Per le applicazioni mission-critical che richiedono protezione da interruzioni a livello regionale, Azure offre le funzionalità Geo-Disaster Recovery e geo-replica. Associando uno spazio dei nomi primario a uno secondario in una regione Azure abbinata, le organizzazioni possono eseguire rapidamente il failover delle proprie pipeline di dati in caso di disastro, soddisfacendo obiettivi RTO (Recovery Time Objective) e RPO (Recovery Point Objective) stringenti.
Confronto tra Azure Event Hubs, Service Bus e Apache Kafka
Gli architect spesso faticano a scegliere il servizio di messaggistica giusto in Azure, perché il portafoglio include diverse opzioni molto potenti. Per fare la scelta giusta è utile capire come Event Hubs si confronta con Azure Service Bus e Apache Kafka.
Azure Service Bus è progettato per i pattern di messaggistica enterprise, con un focus su garanzie solide come transazioni, dead-lettering, sessioni e routing pub/sub complesso per volumi di dati relativamente moderati. Al contrario, Azure Event Hubs è costruito appositamente per l'acquisizione massiva di telemetria e l'elaborazione di stream ad alto throughput. Se devi elaborare milioni di eventi leggeri al secondo, Event Hubs è molto più economico e performante di Service Bus.
Rispetto ad Apache Kafka open source, Azure Event Hubs offre un vantaggio operativo concreto: è completamente gestito. Non devi gestire cluster, configurare Zookeeper o occuparti dell'applicazione di patch al sistema operativo. Event Hubs fornisce persino un endpoint compatibile con Kafka, che consente alle applicazioni Kafka esistenti di connettersi ad Azure Event Hubs con modifiche minime al codice, offrendoti il meglio di entrambi i mondi.
Procedure consigliate per progettare pipeline di streaming solide
Progettare una pipeline di streaming di livello enterprise richiede un'attenta pianificazione e il rispetto delle procedure consigliate consolidate. Per concludere la nostra analisi architetturale, tieni presenti queste raccomandazioni chiave:
- Pianifica con attenzione il numero di partizioni: ricorda che, sebbene tu possa scalare dinamicamente le unità di throughput, il numero di partizioni è fisso quando crei un event hub. Scegli un numero di partizioni che permetta la crescita futura senza introdurre un overhead di coordinamento non necessario.
- Scegli le chiavi di partizione giuste: usa chiavi di partizione significative per garantire una distribuzione uniforme dei dati tra le partizioni, evitando le "hot partition" in cui una singola chiave monopolizza le risorse.
- Implementa una gestione degli errori solida: integra criteri di nuovo tentativo e meccanismi di dead-lettering nelle applicazioni consumer per gestire in modo corretto i messaggi non elaborabili e i guasti di rete temporanei.
- Monitora la limitazione (throttling): usa Azure Monitor per tenere sotto controllo metriche come richieste in ingresso, richieste limitate e integrità delle partizioni, assicurandoti che la tua applicazione rimanga ben al di sotto dei limiti allocati.
Padroneggiando partizioni, gruppi di consumer e strategie di scalabilità, puoi creare pipeline di streaming non solo estremamente veloci, ma anche resilienti, scalabili e pronte a gestire qualsiasi volume di dati con cui la tua organizzazione si trovi a confrontarsi.
In questo post del blog abbiamo esplorato l'architettura di base di Azure Event Hubs, descrivendo come le partizioni consentano l'esecuzione parallela, come i gruppi di consumer disaccoppiano carichi di lavoro indipendenti e come i meccanismi di scalabilità automatica mantengono le tue applicazioni in funzione senza problemi anche sotto pressione. Per iniziare, crea uno spazio dei nomi di Event Hubs nel portale di Azure, configura il primo gruppo di consumer e collega un processore di flusso.
Per approfondire l'argomento e ascoltare discussioni reali su questo tema, non perdere il nostro episodio di podcast dedicato: Azure Event Hubs - Simply Explained. Abbraccia la potenza dello streaming di dati in tempo reale e trasforma oggi stesso i flussi di lavoro di data engineering della tua organizzazione! 🚀
Domande frequenti
Che cos'è Azure Event Hubs?
Azure Event Hubs è una piattaforma di streaming di eventi completamente gestita e ad alta velocità di trasmissione, in grado di acquisire ed elaborare milioni di eventi al secondo con bassa latenza, il che la rende ideale per le moderne pipeline di dati in tempo reale.
Come funzionano le partizioni in Azure Event Hubs?
Le partizioni dividono il flusso di dati complessivo in sequenze indipendenti. I producer indirizzano gli eventi alle partizioni tramite una chiave di partizione, consentendo a più istanze consumer di leggere i dati in parallelo e di massimizzare il throughput di elaborazione.
Qual è la differenza tra un Event Hub e un gruppo di consumer?
Un event hub è l'archivio centrale del log degli eventi in ingresso, mentre un gruppo di consumer rappresenta una vista distinta di quel flusso di eventi. Più gruppi di consumer consentono a diverse applicazioni di leggere gli stessi dati in modo indipendente, senza interferire tra loro.
Posso scalare Azure Event Hubs automaticamente?
Sì. Abilitando la funzionalità Auto-Inflate sugli spazi dei nomi del piano Standard, Azure aumenta automaticamente le unità di throughput allocate man mano che il carico di traffico cresce, evitando la limitazione delle prestazioni.
Per quanto tempo vengono conservati i dati in Azure Event Hubs?
La conservazione dei dati dipende dal piano di prezzo. Il piano Standard conserva i dati fino a 7 giorni, mentre i piani Premium e Dedicated consentono una conservazione fino a 90 giorni.
Azure Event Hubs è compatibile con Apache Kafka?
Sì. Azure Event Hubs fornisce un endpoint nativo Kafka, che consente alle applicazioni e agli strumenti client Apache Kafka esistenti di comunicare con Event Hubs senza dover riscrivere il codice.
🎧 Ascolta questo episodio
Vuoi una spiegazione pratica e parlata di Azure Event Hubs? Questo episodio illustra l'architettura con un linguaggio chiaro e spiega perché è importante per lo sviluppo cloud moderno, l'analisi aziendale e le applicazioni scalabili.
Ascolta questo episodio se vuoi:
- Capisci i meccanismi di base delle partizioni e della scalabilità di Azure Event Hubs
- Scopri come le architetture di streaming si inseriscono nel più ampio ecosistema di Microsoft Azure
- Scopri dove lo streaming di eventi crea valore di business concreto per la tua organizzazione
Potrebbero interessarti anche questi episodi correlati di M365 FM:
Scopri altre conversazioni pratiche su cloud e Microsoft su M365 FM.
Ultima revisione: luglio 2026.
A chi è rivolto
Questo episodio è essenziale per amministratori Azure, enterprise architect, sviluppatori software e responsabili tecnici che hanno bisogno di una base solida e pratica prima di progettare, governare o gestire architetture di streaming in tempo reale.
🎧 Ascolta anche
- Azure Event Grid — Un passo successivo pratico per esplorare la messaggistica reattiva nel cloud.
- Azure Service Bus — Scopri quando usare le code di messaggi invece dei flussi di eventi.
- Azure Functions — Scopri come elaborare i tuoi flussi di eventi in modalità serverless.