 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Data governen in een Microsoft Fabric lakehouse: architectuur zonder slapeloze nachten
By Mirko Peters · · Updated
Data governen in een lakehouse-architectuur in Microsoft Fabric zonder slapeloze nachten. Vereenvoudig analytics met een robuuste, beheersbare oplossing.
Automatically translated with AI from the original post. Read the English original
Ken je dat ongemakkelijke moment in een vergadering, wanneer iemand vraagt: “Kunnen we bewijzen waar dit getal vandaan komt?” en de kamer ineens stil wordt? Ik heb die stilte zien aanhouden in bedrijven die “alle data” hadden, maar geen enkel bewijsstuk. Een lakehouse belooft één platform voor alles: gestructureerde tabellen, rommelige bestanden, realtime datastromen en ML-features. Maar die belofte geldt alleen als je het kunt governen zonder je teams de handen te binden. Deze blog put sterk uit de studie “Data Governance in Lakehouse” (Shah & Jain) van het Stallion Journal uit oktober 2024, en voegt daar de menselijke kant aan toe: de kortere wegen waarvoor je zult bezwijken, de politiek waar je tegenaan loopt, en de eenvoudige gewoonten die je uit de paniek houden wanneer een audit er aankomt.
8 verrassende feiten over governance in een Microsoft Fabric lakehouse- Governance over alle artefacten heen: De governance van Fabric geldt uniform voor lakehousetabellen, bestanden, notebooks, pipelines en dashboards. Zo kun je gecentraliseerd beleid toepassen op zowel data- als analytics-artefacten.
- Automatisch vastleggen van lineage: Lineage wordt voor veel bewerkingen automatisch vastgelegd (inlezen, transformaties, notebooks en dashboards). Zo krijg je bijna realtime inzicht in de herkomst van data, zonder extra instrumentatie.
- Integratie van row-level en column-level security: Een lakehouse ondersteunt fijnmazige toegangsbeheersing (op rij- en kolomniveau) die tijdens het bevragen wordt afgedwongen. Daardoor reist de beveiligde toegang mee met de data, ongeacht welke verwerkingsengine je gebruikt.
- Ingebouwde dataclassificatie en vertrouwelijkheidslabels: Fabric toont dataclassificatie (gevoelige informatietypen) en integreert met Microsoft Purview-vertrouwelijkheidslabels, zodat governance de ontdekte classificaties kan gebruiken om beleid af te dwingen.
- Policy-as-code voor levenscyclusbeheer: Governancebeleid (bewaartermijnen, kwaliteitscontroles, versleuteling, toegestane compute) kan programmatisch worden beschreven en toegepast. Zo wordt de handhaving over de hele levenscyclus van het lakehouse geautomatiseerd.
- Naadloze isolatie van tenant en werkruimte: Het governancemodel van Fabric ondersteunt isolatie over meerdere werkruimten heen en beleid dat tenant-bewust is. Je kunt het delen van data en het verplaatsen ervan tussen projecten beperken en toch beheerde samenwerking mogelijk maken.
- Controleerbare logs van wijzigingen en toegang: Alle governancerelevante bewerkingen (lezen en schrijven van data, wijzigingen in beleid, roltoewijzingen) zijn controleerbaar. De logs integreren met Microsoft Sentinel en SIEM-oplossingen voor compliancemonitoring.
- Governance-ondersteunde datacontracten: Fabric maakt het mogelijk datacontracten en schema’s te maken met afdwingbare compatibiliteitscontroles. Consumenten krijgen zo stabiele, beheerde interfaces naar lakehousedata, en producenten kunnen veilig evolueren.
1) Het “stille vergadering”-probleem: waarom lakehouses governance nodig hebben
Je zit in een leiderschapsreview. Op het scherm verschijnt een KPI: klantbehoud, wachttijd van patiënten, churnrisico. Iemand vraagt: “Waar komt dit getal vandaan?” De kamer wordt stil. Je kunt de dataset, de transformatie of de persoon die vorige week de logica heeft aangepast niet traceren. Op dat moment heb je geen analyseprobleem, maar een probleem met datavertrouwen.
Wat is een lakehouse in gewone taal: één dak, twee beloftes
Een lakehouse is een praktische combinatie: de flexibiliteit van een data lake (alles opslaan, snel) plus de betrouwbaarheid van een datawarehouse (consistente tabellen, sterke prestaties). Onder één dak beheer je gestructureerde en ongestructureerde data, draai je realtime analytics en ondersteun je machine learning-workloads. Die “alles-in-één”-waarde is ook de reden waarom je strategie voor de lakehouse-architectuur vanaf dag één governance moet bevatten.
Waarom lakehouses de behoefte aan data governance in het lakehouse vergroten
Lakehouses bewegen snel: streaming-datastromen, frequente hertraining van modellen en veel teams die tegelijk dashboards opleveren. Die snelheid vermenigvuldigt het risico. Gemengde datatypen en veel tools maken het makkelijker om het overzicht te verliezen over definities, machtigingen en lineage. Als je een metriek niet kunt verklaren, stoppen stakeholders met het vertrouwen in het dashboard, ook als het getal wel klopt.
- Realtime data vergroot de kans op inconsistente momentopnames en KPI’s die steeds van waarde veranderen.
- ML-pipelines voegen nieuwe assets toe die je moet governen: features, trainingsets, modeloutput en drift-signalen.
- Meer gebruikers (analisten, datawetenschappers, productteams) betekent meer toegangswegen, en dus ook meer manieren om beleid te omzeilen.
Governance is geen papierwerk, maar de manier waarop je veilig blijft leveren
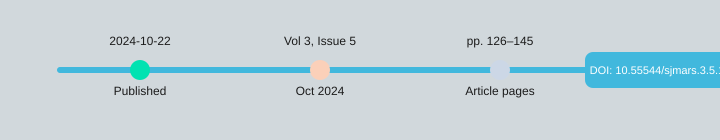
De peer-reviewed studie “Data Governance in Lakehouse” in het Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), gepubliceerd op 22-10-2024 in Volume 3, Issue 5 (blz. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), beschouwt governance als zowel een strategische noodzaak als een operationele must-have. De boodschap is eenvoudig: governance beschermt je op het gebied van compliance (GDPR, HIPAA, CCPA), verlaagt risico’s en houdt de datakwaliteit en het vertrouwen van belanghebbenden op peil.
Samarth Shah: “In een lakehouse is snelheid zonder governance geen wendbaarheid, maar gewoon sneller verwarring.”
In de praktijk betekent data governance in een lakehouse dat je de vraag “wat is deze KPI?” kunt beantwoorden met bewijs: metadata, catalogusvermeldingen, toegangscontroles (zoals RBAC), auditlogboeken en lineage. Het is geen bureaucratie. Het is het systeem waarmee je analyses snel kunt leveren, zonder de wet of het vertrouwen te schenden.
| Metadata-item | Waarde |
|---|---|
| Publicatiedatum | 22-10-2024 |
| Nummer van het tijdschrift | Volume 3, Issue 5 (okt 2024) |
| Pagina’s | 126–145 |
| ISSN | 2583-3340 |
2) Hoe “goede governance” eruitziet als je data overal staat
In een lakehouse staat je data niet “op één plek”. Ze verspreid zich over tabellen, bestanden, streams en ML-features, vaak op platformen zoals AWS, Snowflake of Databricks. Goede governance zorgt dat je data bruikbaar en veilig blijft, zonder teams te vertragen. Zie het als vangrails, geen poortjes: je maakt realtime analyses mogelijk en voldoet tegelijk aan de verwachtingen van GDPR, HIPAA en CCPA.
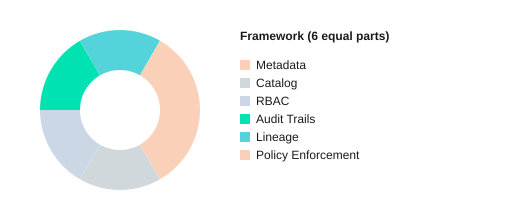
De 6 bouwblokken die je daadwerkelijk gaat implementeren
- Metadatagedreven governance: definieer eigenaren, gevoeligheid, bewaartermijnen en kwaliteitsregels in metadata, zodat je controles meeschalen met volume en verandering.
- Best practices voor de datacatalogus: één doorzoekbare plek voor definities, tags en betrouwbare datasets, zodat mensen niet meer hoeven te gissen.
- RBAC-toegangsbeheer: rollen sluiten aan op wat mensen doen (analist, engineer, clinicus), niet op ad-hocmachtigingen.
- Tracking van data lineage: laat zien waar data vandaan komt, hoe ze is veranderd en wat ervan afhankelijk is.
- Auditlogboeken: wie heeft wat wanneer geopend en wat heeft die persoon gedaan? Essentieel voor onderzoeken en audits.
- Handhaving van beleid: geautomatiseerde controles (maskering, bewaring, goedkeuringen) die standaard draaien en niet op verzoek.
Gedocumenteerde versus afgedwongen governance (alleen het ene voorkomt incidenten)
Gedocumenteerde governance is een wikipagina met de tekst “PII moet worden gemaskeerd”. Afgedwongen governance betekent dat je lakehouse PII op basis van metadatatags automatisch maskeert, riskante exports blokkeert en toegang vastlegt in auditlogboeken. Het onderzoek naar moderne lakehouse-governance laat zien dat automatisering en metadata de handmatige handhavingstijd en fouten verminderen, omdat het platform regels consequent toepast.
Unified governance wanneer je tabellen, bestanden, streams en features beheert
Je hebt één controlelaag nodig die werkt over batchtabellen, bestanden in object storage, Kafka-achtige streams en ML-featuresets heen. Wanneer governance geünificeerd is, volgen dezelfde RBAC-toegangscontrole, tags en beleidsregels de data. Zo blijven je dashboards, notebooks en modellen op één lijn en compliant.
Kleine zijstap: hoe “één gedeelde dataset” 12 versies wordt
Zonder tracking van data lineage wordt een “klant”-dataset gekopieerd naar customer_v2, customer_clean, customer_final en “final_final”. Al snel discussiëren teams over cijfers omdat niemand kan aantonen welke versie in welk rapport terechtkwam.
Shubham Jain: “Lineage maakt het verschil tussen ‘ik denk’ en ‘ik kan het bewijzen’ wanneer iemand je cijfers in twijfel trekt.”
Zelfcheck van 5 minuten
- Kun je in de catalogus de eigenaar en het gevoeligheidslabel vinden van je top 10-datasets?
- Bepalen rollen (en niet individuen) via RBAC wie toegang heeft?
- Kun je een KPI binnen 2 minuten via lineage terugleiden naar de bronnen?
- Geven auditlogboeken vandaag antwoord op de vraag “wie heeft dit bekeken/geëxporteerd”?
- Worden beleidsregels automatisch afgedwongen (maskering, bewaring, goedkeuringen) en niet handmatig?
Elke controle levert resultaat op: minder toegangsincidenten (RBAC + beleid), snellere audits (auditlogboeken + catalogus) en schonere analyses (metadata + lineage).
3) De cijfers die governance minder “overhead” doen lijken
Als governance klinkt als “extra proces”, helpen de resultaten uit het paper je om het te zien als meetbaar operationeel voordeel. Wanneer je metadatagedreven governance toepast met automatisering en ML in een lakehouse, voeg je niet zomaar “extra controles” toe. Je wint er tijd mee, verbetert het vertrouwen in je data en verkleint compliancerisico’s, op een manier die een CFO kan volgen.
Metadatagedreven governance: ROI die je op een dia kunt zetten
De studie rapporteert drie belangrijke uitkomsten wanneer teams sterk leunen op goede metadata, catalogisering, lineage en toegangscontroles:
- Tot 40% verbetering van de governance-efficiëntie
- 35% hogere datakwaliteit
- 92% naleving van GDPR- en HIPAA-eisen (GDPR/HIPAA)
In de praktijk betekent die winst van 40% vaak minder handmatige reviews, minder “wie is eigenaar van deze dataset?”-discussies en snellere goedkeuringen voor toegang en delen. Je achterstand krimpt omdat routinecontroles van mensen naar systemen verschuiven, en je incidentenwachtrij wordt korter omdat er minder problemen in productie terechtkomen.
Geautomatiseerde handhaving van beleid: het voor en na dat het gesprek verandert
Het duidelijkste bewijs voor “overhead versus opbrengst” is de overstap van handmatige controles naar geautomatiseerde handhaving van beleid:
- Tijd voor handhaving van beleid: 72% → 28%
- Foutpercentage: 45% → 15%
Dit is geen kleine optimalisatie. Het is het verschil tussen governance als poort en governance als vangrail. Je besteedt minder tijd aan het najagen van uitzonderingen en meer tijd aan veilig self-service mogelijk maken.
“Unified governance houdt alleen stand als de werkwijze makkelijker is dan de workaround.” —Taylor, Singh, & Green (2021)
Adoptie in de praktijk: sterk bij technische gebruikers, lastiger voor de rest
De bruikbaarheidsscores waren hoog bij data scientists, business analysts en IT-beheerders (4,2–4,7/5). Maar het paper wijst ook op een veelvoorkomend gat: niet-technische gebruikers hebben eenvoudigere interfaces, duidelijkere definities en begeleide werkstromen nodig. Als je de cijfers hierboven wilt halen, moet je budget reserveren voor enablement, niet alleen voor tooling.
Belangrijkste cijfers in één oogopslag
| Metriek | Resultaat |
|---|---|
| Verbetering governance-efficiëntie | Tot 40% |
| Toename datakwaliteit | 35% |
| Naleving GDPR/HIPAA | 92% |
| Tijd voor handhaving van beleid | 72% (handmatig) vs 28% (geautomatiseerd) |
| Foutpercentage | 45% (handmatig) vs 15% (geautomatiseerd) |
| Bruikbaarheidsscore | 4,2–4,7 van 5 |
| Reductie verwerkingstijd | 25% |
4) Tools, prototypes en de rommelige realiteit van implementatie
Wat het onderzoek concreet deed
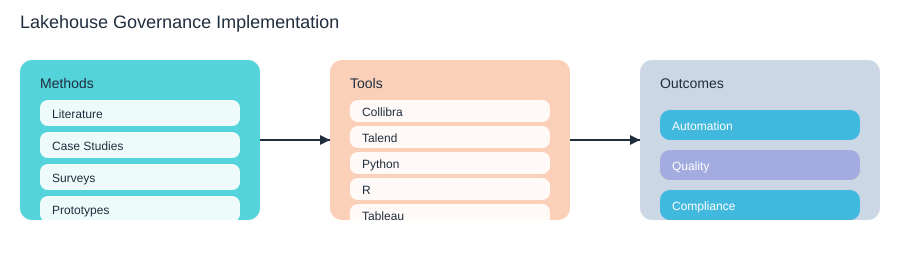
De studie van Stallion Journal behandelde governance niet als een probleem voor een slide deck. Er werden vier methoden gebruikt die je herkent uit echt werk: ze las de literatuur (systematische reviews), keek naar praktijkcases uit de industrie, bevroeg stakeholders en testte prototypes. Dat laatste is belangrijk, want lakehouse-governance breekt in de gaten tussen beleid en pipelines, zeker wanneer je data snel binnenkomt, vaak verandert en van veel teams komt.
Prototypestack: wat ze echt probeerden
In de experimenten gebruikte de studie Collibra en Talend voor governance- en integratiepatronen, plus analysetools (Python, R, Tableau) om bruikbaarheid en resultaten te valideren. Je kunt deze aanpak spiegelen, of je nu bezig bent met Databricks-governance, een Snowflake-lakehouse-opzet of bredere cloud-native datagovernance met Kubernetes, Docker, Kafka, Postgres, PySpark en Elasticsearch erbij.
Een uitrolpad dat je kunt kopiëren (en behapbaar houden)
Succesvolle implementatie hangt af van tooling-ondersteunde governance en van je capaciteit om snelheid, complexiteit en beperkte resources aan te kunnen. Een praktische volgorde is:
- Begin met catalogus + RBAC: pas best practices voor datacatalogi toe (duidelijk eigenaarschap, zakelijke termen en ‘golden’ datasets). Breng daarna de toegang in kaart met RBAC.
- Voeg lineage toe: leg upstream- en downstream-impact vast, zodat wijzigingen analisten of auditors niet verrassen.
- Automatiseer handhaving: ga waar mogelijk van handmatige goedkeuringen over naar policy-as-code, met audittrails.
Harris & Nguyen (2020): “RBAC is op papier eenvoudig; het wordt echt zodra je het koppelt aan teams, niet aan functietitels.”
Je dagelijkse vijand: snelheid en inconsistente datastromen
Snelle datafeeds (denk aan streams zoals Kafka) zorgen voor ‘schema drift’, late events en dubbele records. Daar voelt governance rommelig aan: je catalogus zegt dat een veld verplicht is, maar de stream laat het weg; je kwaliteitsregels verwachten één tijdstempel, maar producers sturen er drie. Het onderzoek noemt dit een terugkerend knelpunt, zeker wanneer teams onderbezet zijn.
Toolwildgroei: wanneer systemen elkaar tegenspreken
Let op het klassieke split-brain-probleem: je catalogus toont dat Dataset A ‘beperkt’ is, maar IAM-groepen geven nog steeds brede toegang. Of je Databricks-governancebeleid komt niet overeen met wat er in cloud-IAM is ingesteld. Behandel ‘één bron van waarheid’ als ontwerpdoel, niet als loze slogan.
| Beslisperspectief | Houd het simpel |
|---|---|
| Zelf kopen of zelf bouwen | Koop voor catalogus en workflows; bouw alleen dunne connectors en controles. |
| Voorkom een governance-doolhof | Eén catalogus, één beleidsmodel, minimale maatwerkrollen en geautomatiseerde audits. |
5) De belangrijkste governance-pijnpunten (en hoe je ze triageert)
Als governance moeilijker voelt dan het ‘zou moeten’, ben je niet de enige. In de onderzoekssynthese noemt 78% van de organisaties de uitdaging van metadatabeheer als het belangrijkste pijnpunt. Dat cijfer mag je een gevoel van herkenning geven, want in een lakehouse gaat alles snel, en metadata is de kaart die je moet bijwerken terwijl de wegen nog worden aangelegd.
Waarom metadata als eerste breekt (en blijft breken)
Metadata is lastig omdat:
- Definities verschuiven: ‘actieve klant’ betekent voor Finance iets anders dan voor Growth.
- Eigenaarschap is vaag: niemand weet zeker wie een nieuw veld, een nieuwe tabel of een nieuwe bewaarregel goedkeurt.
- Pipelines veranderen wekelijks: nieuwe bronnen, nieuwe joins, nieuwe ML-features. Je catalogus en tags lopen achter.
En toch levert investeren in governance meetbaar resultaat op: 88% meldt betere datakwaliteitsgovernance, en 81% meldt betere lakehouse-beveiligingsgovernance. Dat is de beloning voor het onopvallende werk.
Governance-triage: los de juiste dingen in de juiste volgorde op
- Eerst metadata en eigenaarschap: definieer kritieke dataelementen, wijs een dataeigenaar en een datastewart aan, en standaardiseer zakelijke termen in je catalogus.
- Dan toegangsbeheer: implementeer RBAC met minimale rechten, plus duidelijke goedkeuringsroutes voor uitzonderingen.
- Lineage en auditlogs: leg vast waar data vandaan komt, hoe het is veranderd en wie er aan heeft gezeten. Hiermee beantwoord je vragen over GDPR, HIPAA en CCPA snel.
- Automatisering als laatste (maar gestaag): automatiseer beleidscontroles, tagging en anomaliedetectie, zodat handhaving niet afhangt van heldendaden.
Wat breekt er wanneer HIPAA en CCPA samenkomen?
Stel je een lakehouse voor waarin een door HIPAA gereguleerde zorgdataset (patiëntcontacten) wordt gekoppeld aan een door CCPA gedekte marketingdataset (webgedrag). Wat dan meestal als eerste breekt, is classificatie en toestemming: PHI-tags ontbreken, toestemmingsvlaggen worden niet doorgegeven via joins, en een downstream-dashboard toont meer dan de bedoeling is. Zonder lineage kun je niet bewijzen waar de data naartoe is gegaan; zonder RBAC kun je brede toegang niet stoppen; zonder auditlogs en identity management kun je geen verantwoordelijkheid aantonen.
“De echte uitdaging is niet AI laten werken, maar het verantwoord laten werken binnen de systemen die je al hebt.”
— Dr. Fei-Fei Li
Een simpel ritueel dat je gezond houdt: de maandelijkse governance-retro
Houd elke maand een retro van 45 minuten met IT-, security- en zakelijke eigenaren. Bespreek: de top 3 metadata-gaten, de top 3 toegangsuitzonderingen, één lineage-fout en één automatiseringswinst. Leg acties vast in een gedeelde tracker en wijs per item één eigenaar aan.
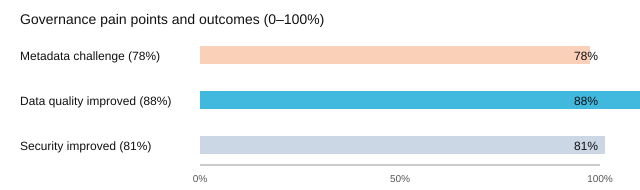
6) Compliance zonder paranoia: GDPR, HIPAA, CCPA in het lakehouse
Behandel compliance in een lakehouse als ontwerpvoorwaarde, niet als last-minute gehaast. Wanneer je controles vanaf dag één in opname, opslag en toegang bouwt, voelen GDPR HIPAA-compliance en CCPA-datagovernance niet langer als brandoefeningen, maar als normale operatie. De studie van Stallion Journal over ‘Data Governance in Lakehouse’ laat zien waarom: organisaties die metadatagedreven governance, automatisering en ML gebruiken, zagen de compliancegraad voor GDPR en HIPAA oplopen tot 92%. Gebruik dat als richtinggevende benchmark, niet als garantie.
“Beveiliging is een proces, geen product, en governance is de manier waarop je dat proces eerlijk houdt.”
— Bruce Schneier
Breng controles in kaart naar regelgeving: je kernset aan compliancetools
Je “doet GDPR” of “doet HIPAA” niet door alleen beleid op papier te zetten. Je koppelt de vereisten aan herhaalbare controles binnen de lakehouse:
- RBAC (op rollen gebaseerd toegangsbeheer): beperk wie PHI/PII mag inzien en wie die mag exporteren.
- Auditlogboeken lakehouse: bewijs wie wat heeft benaderd, wanneer, vanaf welke locatie en wat diegene daarmee heeft gedaan.
- Datalineage: laat zien waar gevoelige velden vandaan komen, hoe ze zijn veranderd en waar ze terechtgekomen zijn.
- Afdwingen van beleid: pas maskering, bewaartermijnen en doelbinding consequent toe over alle tools heen.
- Metadatabeheer + catalogus: classificeer data, label de gevoeligheid en stuur automatisering aan.
| Regelgeving | Waar auditors naar kijken | Controle in het lakehouse |
|---|---|---|
| GDPR | Rechtmatige toegang, minimalisatie, bewaartermijnen | RBAC, maskering, bewaarbeleid, lineage |
| HIPAA | Toegangslogboeken, waarborgen, least privilege | Auditlogboeken, RBAC, versleuteling, monitoring |
| CCPA | Gegevensinventaris, afhandeling van toegang en verwijdering | Catalogus + metadata, lineage, beleidsworkflows |
De volgende golf: regiospecifieke regels en legacybeperkingen
Het paper wijst op toekomstig werk waar je nu al rekening mee moet houden: regiospecifieke compliance en betere aanpasbaarheid voor legacy of beperkte omgevingen. Opereer je over staten of landen heen, bouw dan beleid dat per regio kan verschillen (bewaarperiodes, toestemmingsregels, meldplicht bij datalekken). Draai je nog oudere systemen, begin dan met een kleinere scope en integreer geleidelijk. Automatisering helpt, maar de complexiteit is reëel.
“Auditdag” doorlopen: wat je moet kunnen laten zien
- Gegevensinventaris: waar PII/PHI staat, wie de eigenaar is en met welk doel (
catalog + tags). - Bewijs van toegang: RBAC-rollen, goedkeuringen en exports van auditlogboeken lakehouse.
- Bewijs van lineage: paden van bron tot rapport voor belangrijke datasets en gevoelige kolommen.
- Bewijs van beleid: maskering, bewaartermijnen, verwijderworkflows en logboeken van afgedwongen beleid.
- Wie er aan tafel zitten: de dataeigenaar, security, platformbeheerder, compliance/legal en één analist die de data gebruikt.
Radarweergave: baseline versus gegoverneerd lakehouse
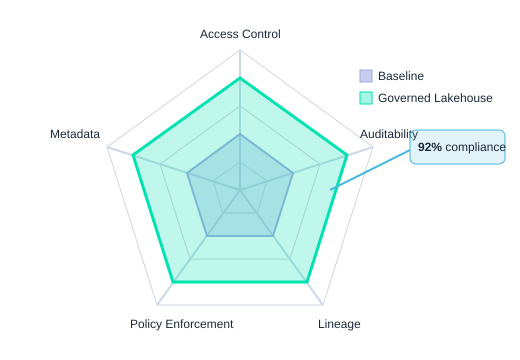
Kort en eerlijk zijdelings opmerking: ben je een kleinere organisatie, begin dan met een eenvoudige baseline—RBAC, logging en een lichtgewicht catalogus—voordat je dure enterprise-tooling aanschaft. De studie is duidelijk dat implementatiecomplexiteit een echte drempel kan zijn, zeker wanneer de middelen beperkt zijn.
7) Leveranciersbias, politiek en wat governance-presentaties overslaan
Je kunt op papier een strak governancemodel voor het lakehouse ontwerpen en dan zien hoe het verbuigt zodra data governance-tooling de kamer binnenkomt. De ongemakkelijke waarheid is simpel: tools en leveranciers bepalen mede hoe “best practice” eruitziet, omdat ze bepalen wat makkelijk te demonstreren, makkelijk aan te schaffen en makkelijk te rapporteren is.
De Stallion Journal-studie naar het lakehouse noemt dit rechtstreeks in de paragraaf over belangenconflicten. Er worden drie bronnen van bias genoemd waarvan je moet aannemen dat ze in elk governanceprogramma aanwezig zijn: leveranciersbias (voorkeur voor platforms zoals Collibra Talend governance-stacks of andere commerciële suites), bias in rapportage binnen de organisatie (alleen “succesvolle” metrics delen), en financiële/regeldruk (kiezen wat er voor auditors het veiligst uitziet, niet wat past bij je architectuur). Het onderzoeksinzicht is duidelijk: transparantie en openheid zijn noodzakelijk om de integriteit van het onderzoek te waarborgen en om je governancekeuzes bruikbaar te houden buiten de verhalen van leveranciers.
Satya Nadella: “Vertrouwen is de ultieme valuta—en in data verdien je het door expliciet te zijn over wat je hebt gedaan en waarom.”
Bias-risico’s die je hardop moet benoemen
Governance-onderzoek & tooling-biasrisico’sLeveranciersbias 40%Rapportagebias 35%Financieel/regelgeving 25%LeveranciersbiasRapportagebiasFinancieel/regelgeving
Je anti-biaschecklist (praktisch, niet politiek)
- Steekproef: vergelijk minstens één commerciële suite en één open optie binnen de AWS-, Snowflake-, Databricks-, SAP- en Oracle Cloud Infrastructure-ecosystemen.
- Openheid: documenteer sponsors, de redenen voor de toolkeuze en wat je niet hebt getest.
- Evaluatiecriteria: diepte van lineage, geschiktheid van RBAC/ABAC, auditlogboeken, API-toegang, exportformaten en integratie met je lakehouse-tabellen.
- Proof-of-value: draai een pilot met vaste tijdsduur op één domein; meet de tijd tot afdwingen van beleid, het foutpercentage en de wrijving voor gebruikers.
- Controle op leveranciersrisico voor het dataplatform: vraag hoe lock-in zich laat zien in metadata, catalogi en workflowregels.
Mini-verhaal: jij bemiddelt bij de echte beslissing
Inkoop duwt op één leverancier voor “standaardisatie.” Engineers willen open source voor controle. Compliance wil “gecertificeerde” functies en een sluitend auditspoor. Jouw taak is vertalen: je kunt aan compliance voldoen met sterke controles en audit trails, engineers tegemoetkomen met API’s en portabiliteit, en inkoop overtuigen met een helder rendement, zonder dat één groep governance laat bepalen door “wat de tool verkoopt”.
Wat als jouw tool wordt overgenomen en de prijs verdrievoudigt?
Reken erop dat het kan gebeuren. Test de portabiliteit nu: kun je je zakelijke glossary, lineage en beleidsregels exporteren in bruikbare formaten? Als je metadata niet kan verhuizen, is je governance geen programma, maar een abonnement.
8) Toekomstbestendigheid: IoT, edge, gedecentraliseerde data en het lakehouse dat je erft
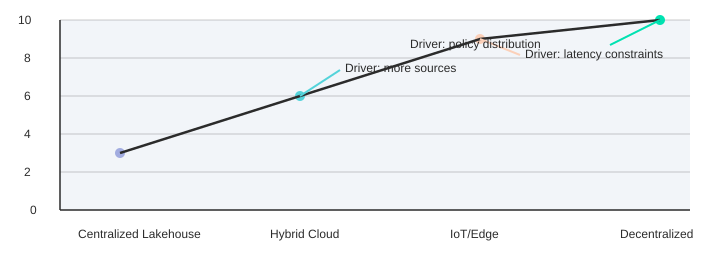
Lakehouse-governance werkt het best wanneer data grotendeels gecentraliseerd is, geschikt is voor batchverwerking en door een paar platformen wordt beheerd. IoT- en edge computing-governance doorbreekt die aannames snel: je krijgt meer bronnen (apparaten, gateways, apps), minder centrale controle (teams rollen onafhankelijk uit) en strengere latencylimieten (je kunt niet “wachten op de nachtelijke job” om toegang of kwaliteit te bepalen). De Stallion Journal-studie wijst deze druk expliciet aan en adviseert governance-uitbreidingen voor drie opkomende domeinen: IoT-datalakes, gedecentraliseerde architecturen en edge computing.
Waarom IoT en edge je huidige model onder druk zetten
Bij IoT-streams kan dezelfde “klant”-gebeurtenis van meerdere sensoren komen, in verschillende formaten en op verschillende momenten. Als je beleid afhankelijk is van één centrale catalogusupdate, vertraag je de operatie of accepteer je blinde vlekken. Edge-locaties maken ook lokale kopieën van data voor snelheid en veerkracht. Daarom moeten je audit trails, lineage en bewaarregels met de data meereizen en niet vastzitten in één control plane à la datawarehouse.
Gedecentraliseerde dataarchitectuur heeft portabele governance nodig
In een gedecentraliseerde dataarchitectuur publiceren domeinen data products en ontwikkelen ze schema’s op hun eigen tempo. Dat is gezond voor de snelheid van levering, maar riskant als je definities van “PII”, “toestemming” of “HIPAA-scope” niet consistent zijn. Toekomstbestendigheid betekent dat je governance ontwerpt als gedeelde service: uitbreidbare metadata, versiebeheer van beleid en identiteitscontroles die werken over teams en regio’s heen, in lijn met de oproep uit het paper om regiospecifieke compliance aanpasbaar te maken.
Bouw op cloud-native bouwstenen die je kunt erven
De referentieset rond de studie wijst naar praktische bouwstenen: Docker voor het verpakken van beleidsservices, Kubernetes om ze overal te draaien, Kafka voor het streamen van handhavingshaken, Elasticsearch voor snelle detectie en Postgres/PySpark voor governed verwerking. Je kiest deze tools niet om de mode; je kiest wat in de cloud, on-premises en aan de edge met dezelfde controles kan draaien.
“Alles faalt, altijd – ontwerp governance alsof je verandering verwacht, niet stabiliteit.” — Werner Vogels
Een roadmap met kleine stappen die je in beweging houdt
Je hoeft edge-governance vandaag niet volledig op te lossen. Wel heb je metadata- en beleidssystemen nodig die kunnen groeien zonder herschrijvingen. Begin met een pilot voor AI-gestuurde anomaliedetectie op governance-signalen (schema drift, ongebruikelijke toegangspaden, exports die buiten het patroon vallen) en breid daarna uit naar geautomatiseerde beleidscontroles bij inname en bij query’s. Naarmate je footprint groeit, voeg je sterkere identiteitsbeheer toe, overweeg je blockchain-achtige manipulatiebestendigheid voor kritieke audit trails en plan je disaster recovery die past bij je risicoklasse.
| Omgeving | Governance-complexiteitsindex (illustratief) |
|---|---|
| Gecentraliseerd lakehouse | 3 |
| Hybride cloud | 6 |
| IoT/Edge | 9 |
| Gedecentraliseerd | 10 |
Schrijf je governanceprincipes alsof je morgen wordt vervangen: heldere definities, portabele beleidsregels en beslislogboeken die reorganisaties overleven. Het lakehouse dat je later erft, wordt rommeliger dan vandaag, en je toekomstige zelf slaapt beter als je daar nu al op ontwerpt.
microsoft fabric lakehouse-architectuur: begrijp microsoft fabric voor analytics en data engineering
Wat is de lakehouse-architectuur van Microsoft Fabric?
De lakehouse-architectuur van Microsoft Fabric is een uniform dataplatformontwerp dat elementen van data lakes en datawarehouses combineert om ruwe data en gestructureerde, getransformeerde datasets op één locatie op te slaan. Het maakt gebruik van Azure Data Lake Storage voor de datavolumes, Fabric-rekenengines voor de verwerking en medallion-architectuurpatronen om de ruwe, verrijkte en gecureerde lagen te beheren, zodat teams data kunnen analyseren, datasciencewerkbelastingen kunnen uitvoeren en rapporten in Power BI kunnen voeden zonder data te dupliceren.
Hoe werkt de medallion-architectuur in een lakehouse van Fabric?
De medallion-architectuur in Fabric organiseert data in lagen: doorgaans brons (ruwe data), zilver (opgeschoond en verrijkt) en goud (gecureerd, klaar voor analyse en BI). Fabric integreert tools voor data-ingestie en datatransformatie om data tussen de lagen te verplaatsen en te transformeren. Zo ontstaan workflows voor data engineering en datavoorbereiding die één kopie van je data behouden en dataduplicatie beperken, terwijl analyse en datascience worden ondersteund.
Hoe implementeer ik een lakehouse in Microsoft Fabric en hoe maak ik er een aan?
Om een lakehouse in Microsoft Fabric te implementeren, begin je met het koppelen van je gegevensbronnen en het inlezen van data in een Azure Data Lake met de mogelijkheden voor data-ingestie van Fabric. Gebruik Fabric-rekenengines of dataflow-transformaties om de medallion-architectuur toe te passen, catalogiseer datasets in OneLake en beveilig de toegang. Integreer Power BI en andere analysetools voor rapportage. Het platform vereenvoudigt het datamanagement, ondersteunt dataintegratie over bestaande data en big data heen, en laat je data transformeren zonder onnodig data te verplaatsen.
Wat is het verschil tussen een lakehouse en een traditioneel datawarehouse in Microsoft Fabric?
Een lakehouse combineert de flexibiliteit van data lakes voor ruwe en semigestructureerde data met de prestaties en het schemabeheer van een datawarehouse. In Microsoft Fabric kun je met het lakehouse data opslaan in Azure Data Lake Storage en tegelijk queryprestaties bieden die vergelijkbaar zijn met een datawarehouse, via Fabric-rekenengines. Zo krijg je de mogelijkheden van een datawarehouse, zoals gecureerde, gestructureerde data voor analyse, zonder de flexibiliteit van een data lake voor moderne data- en data engineeringtaken te verliezen.
Hoe gaat Fabric om met data-ingestie en het voorkomen van dataduplicatie?
Fabric ondersteunt meerdere patronen voor data-ingestie, zoals streaming, batch en connectors naar zakelijke gegevensbronnen, allemaal naar een centraal lake (Azure Data Lake). Met de medallion-architectuur en OneLake stimuleert Fabric één kopie van je data en logische datasets in plaats van fysieke kopieën. Tools voor dataintegratie en -transformatie laten je data inlezen en ter plaatse transformeren, en zorgen voor consistente toegang tot data voor analyse- en datasciencewerkbelastingen. Zo beperk je het dupliceren van data over systemen heen.
Kan ik bestaande datawarehouses en Azure-data gebruiken naast een lakehouse van Fabric?
Ja. Fabric integreert met systemen van Microsoft en van derden, waardoor je queries kunt federeren naar bestaande datawarehouses, Synapse en Azure Data Lake Storage, terwijl je de toegang tot je dataomgeving bundelt. Je kunt bestaande data inlezen of ernaar verwijzen, datamesh-patronen implementeren en kiezen of je data naar het lakehouse verplaatst of er direct toegang toe krijgt, afhankelijk van governance, kosten en prestatie-eisen.
Wat zijn de veelvoorkomende toepassingen van een lakehouse van Fabric voor analyse en datascience?
Veelvoorkomende toepassingen zijn het uniform beheren van data voor BI met Power BI, het voorbereiden van grote ruwe datasets voor machine learning en datascience, het bouwen van ELT-pijplijnen met de medallion-architectuur, het analyseren van data over bedrijfssystemen heen en het creëren van één locatie voor gestructureerde en ongestructureerde data. Fabric vereenvoudigt de dataverwerking, maakt schaalbare analyse mogelijk en ondersteunt moderne dataarchitecturen zoals datamesh en zakelijke datacatalogi.
Hoe werken beveiliging, governance en gegevenstoegang in een lakehouse van Fabric?
Fabric biedt op rollen gebaseerd toegangsbeheer, databeleid en integratie met Microsoft Purview en Microsoft Entra ID voor governance en datalineage. OneLake en lakehouse-constructies maken fijnmazige machtigingen mogelijk op data die is opgeslagen in Azure Data Lake Storage, wat zorgt voor veilige gegevenstoegang, naleving en beheerde datavoorbereidingsworkflows, met controleerbaarheid over de stappen van data-ingestie en -transformatie heen.
Welke Fabric-rekenengines moet ik gebruiken voor verschillende werkbelastingen in het lakehouse?
Fabric biedt meerdere rekenengines die zijn geoptimaliseerd voor specifieke workloads: interactieve SQL-query's voor analyse en BI, Spark voor verwerking van big data en data engineering, en gespecialiseerde engines voor realtime ingestie. Kies de Fabric-rekenengines op basis van de kenmerken van de workload: gebruik Spark voor transformaties op grote schaal, warehouse-SQL voor BI-query's en streamingengines voor continue ingestie, zodat je kosten, prestaties en verwerking van gegevens in balans houdt.
Waar kan ik meer leren over de architectuur van een lakehouse in Microsoft Fabric en hoe begin ik ermee?
Om aan de slag te gaan, volg je de tutorials op Microsoft Learn, bestudeer je de documentatie over de lakehouse-architectuur in Microsoft Fabric en bekijk je voorbeelden van de medallion-architectuur in Fabric. Begin met het koppelen van een gegevensbron, het opnemen van ruwe gegevens in Azure Data Lake Storage, het implementeren van een eenvoudige medallion-pipeline en het visualiseren van de resultaten in Power BI. Zo ontdek je hoe Fabric het makkelijker maakt om een lakehouse te bouwen en analyses te leveren vanuit één uniforme gegevensomgeving.