 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Opanowanie Azure Event Hubs: partycje, grupy konsumentów i skalowanie
By Mirko Peters ·
Witamy ponownie w naszym cyklu poświęconym architekturze chmurowej i inżynierii danych w czasie rzeczywistym. We współczesnych aplikacjach korporacyjnych ilość danych generowanych przez użytkowników, urządzenia IoT, mikrousługi i agregatory logów jest ogromna. Organizacje nie chcą już tylko przechowywać danych do przetworzenia wsadowego w nocy; potrzebują praktycznych wniosków natychmiast. Aby spr
Automatically translated with AI from the original post. Read the English original
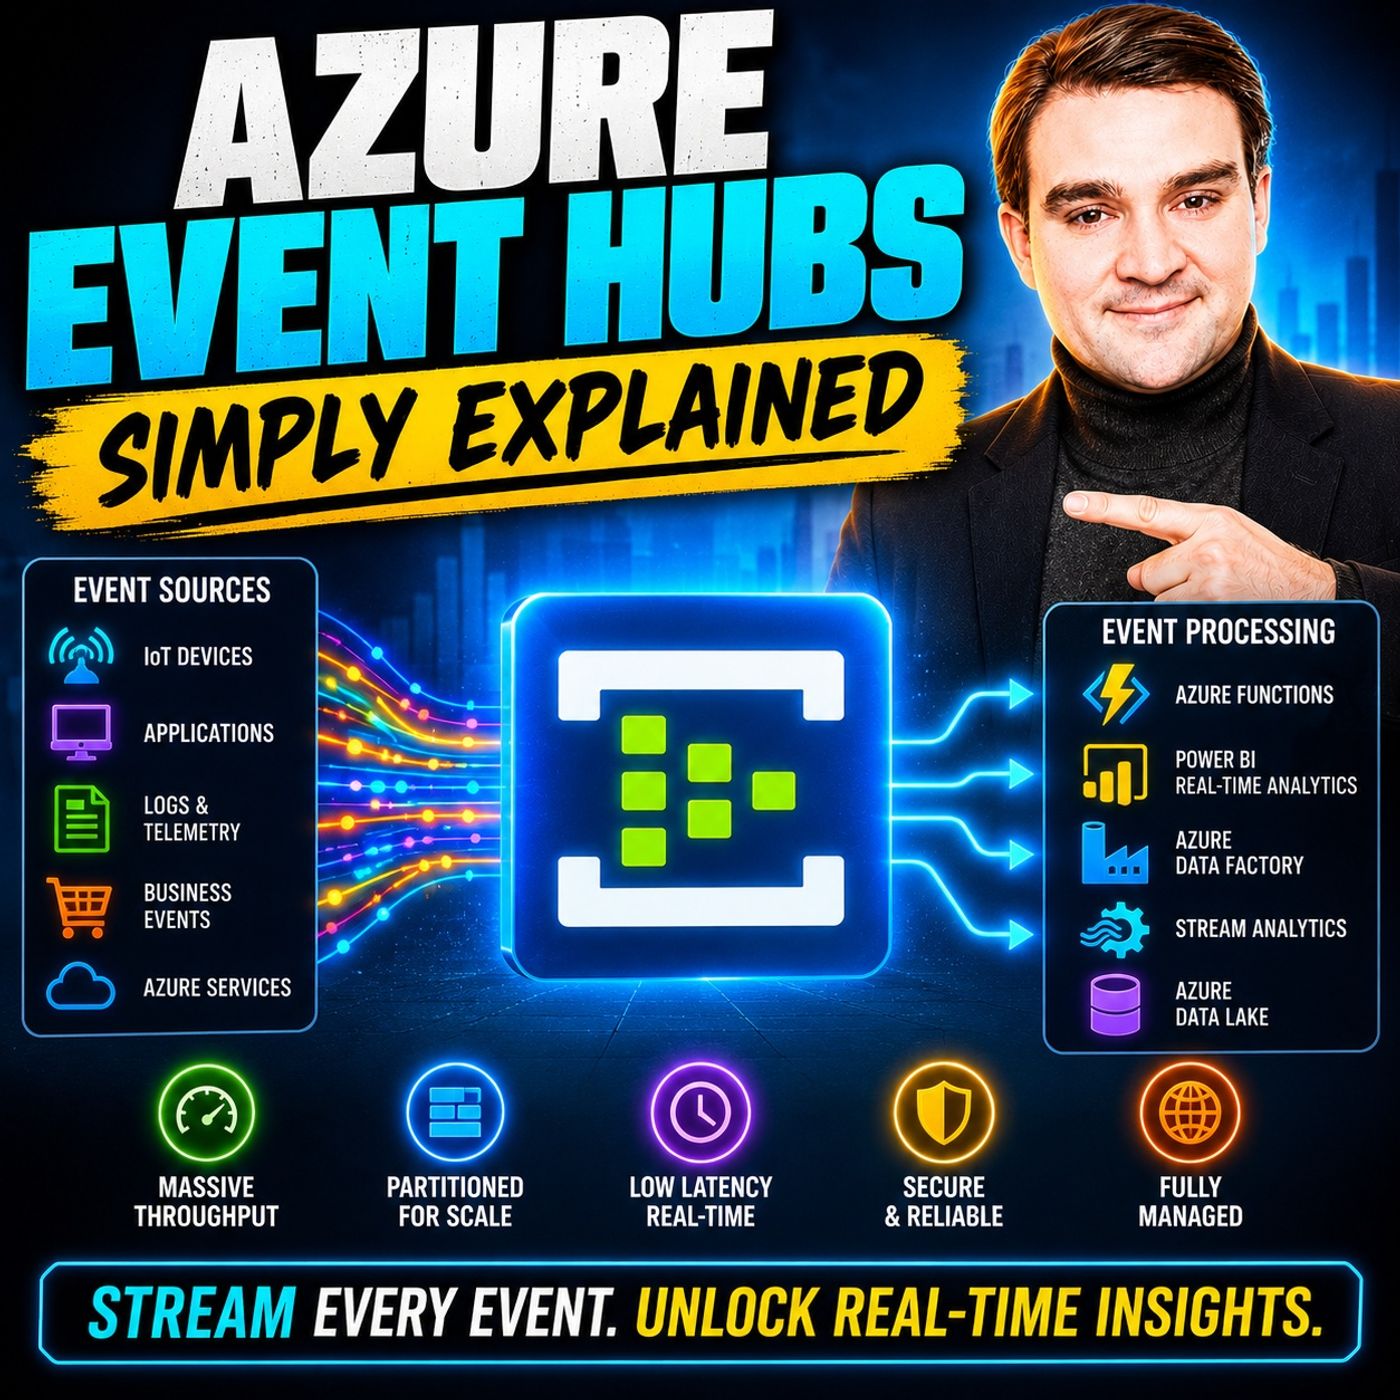
Witamy ponownie w naszym cyklu poświęconym architekturze chmurowej i inżynierii danych w czasie rzeczywistym. We współczesnych aplikacjach korporacyjnych ilość danych generowanych przez użytkowników, urządzenia IoT, mikrousługi i agregatory logów jest ogromna. Organizacje nie chcą już tylko przechowywać danych do przetworzenia wsadowego w nocy; potrzebują praktycznych wniosków natychmiast. Aby sprostać temu zapotrzebowaniu, architekci chmury sięgają po solidne platformy do strumieniowania zdarzeń. Jeśli budujesz rozwiązania w ekosystemie Microsoft Azure, Azure Event Hubs wyróżnia się jako najlepsza w pełni zarządzana usługa do pozyskiwania danych na dużą skalę.
W tym kompleksowym przewodniku zajmiemy się dokładnie podstawowymi komponentami architektonicznymi, dzięki którym Azure Event Hubs działa tak sprawnie. Omówimy, jak partycje umożliwiają masowe przetwarzanie równoległe, przyjrzymy się temu, jak grupy konsumentów pozwalają wielu aplikacjom odczytywać ten sam strumień bez wzajemnego przeszkadzania sobie, oraz przeanalizujemy strategie skalowania, takie jak jednostki przepustowości i automatyczne zwiększanie. Niezależnie od tego, czy projektujesz system wykrywania oszustw finansowych, czy globalny potok telemetrii, zrozumienie tych podstawowych koncepcji ma kluczowe znaczenie dla powodzenia Twojego projektu.
Jeśli wolisz wersję audio, koniecznie zajrzyj do powiązanego odcinka podcastu: Azure Event Hubs - Simply Explained, w którym w jasny i praktyczny sposób omawiamy te wzorce architektoniczne.
Wprowadzenie do architektury Azure Event Hubs
W swojej istocie Azure Event Hubs to silnik pozyskiwania zdarzeń, zaprojektowany z myślą o masowej skalowalności. Potrafi odbierać i przetwarzać miliony zdarzeń na sekundę z ultraniskim opóźnieniem, pełniąc rolę głównego wejścia do potoków przetwarzania dużych danych w chmurze. Wyobraź sobie go jako ogromny, doskonale zorganizowany parking dla pakietów danych. Producenci, tacy jak aplikacje mobilne, logi serwerów czy czujniki w fabrykach, umieszczają swoje ładunki w centrum, a konsumenci, tacy jak Azure Stream Analytics, Azure Functions czy niestandardowe usługi robocze, odbierają je do przetworzenia.
W przeciwieństwie do tradycyjnych kolejek komunikatów, które przechowują wiadomości do momentu, aż poszczególny konsument je potwierdzi (wtedy wiadomość jest usuwana), Azure Event Hubs działa w modelu strumieniowym. Dane są dopisywane do niezmiennego dziennika. Oznacza to, że wiele systemów docelowych może niezależnie odczytywać dokładnie ten sam strumień danych we własnym tempie, bez niszczenia danych dla pozostałych odbiorców. Aby obsłużyć ogromną prędkość przepływu danych typową dla współczesnych obciążeń, Event Hubs opiera się na rozproszonej architekturze zbudowanej wokół dwóch podstawowych koncepcji: partycji i grup konsumentów.
Zrozumienie partycji na potrzeby przetwarzania równoległego
Jeśli chcesz osiągnąć wysoką przepustowość, nie możesz kierować wszystkich przychodzących danych przez jedno wąskie gardło przetwarzania. Właśnie tutaj do gry wchodzą partycje. Partycja to w istocie odrębna sekwencja zdarzeń przechowywana w centrum zdarzeń. Tworząc centrum zdarzeń, musisz określić liczbę partycji, która w przypadku warstw standardowych zwykle mieści się w przedziale od 2 do 32, choć w dedykowanych środowiskach dostępne są znacznie wyższe limity.
Gdy producenci wysyłają zdarzenia, mogą dołączać klucz partycji, taki jak identyfikator urządzenia, identyfikator użytkownika lub region transakcji. Event Hubs oblicza skrót tego klucza i kieruje zdarzenie do konkretnej partycji. Gwarantuje to, że wszystkie zdarzenia o tym samym kluczu zawsze trafiają do tej samej partycji, zachowując ścisłą kolejność powiązanych danych.
Prawdziwa magia partycji tkwi w przetwarzaniu równoległym. Dzieląc cały strumień danych na wiele niezależnych fragmentów, wiele instancji konsumentów może jednocześnie odczytywać z różnych partycji. Na przykład, jeśli Twoje centrum zdarzeń ma 16 partycji, możesz wdrożyć aplikację konsumencką z 16 odrębnymi instancjami odczytu, z których każda obsługuje jedną partycję. Ten model skalowania poziomego zapewnia, że zdolność przetwarzania danych rośnie liniowo wraz ze wzrostem obciążenia.
Wykorzystanie grup konsumentów do niezależnego odczytu danych
W złożonym środowisku przedsiębiorstwa jeden strumień danych rzadko wykorzystuje tylko jeden zespół. Centrum operacji bezpieczeństwa może chcieć skanować dzienniki pod kątem anomalii, zespół data science może chcieć przesyłać telemetrię do modelu uczenia maszynowego, a dział rozliczeń może śledzić wskaźniki wykorzystania — wszystko to na podstawie dokładnie tego samego strumienia zdarzeń.
Azure Event Hubs rozwiązuje to wyzwanie za pomocą grup odbiorców. Grupa odbiorców reprezentuje pełny widok całego centrum zdarzeń (event hub). Działa jak kursor lub zbieracz zakładek. Dzięki utworzeniu wielu grup odbiorców kilka aplikacji konsumujących może równolegle i niezależnie odczytywać strumień zdarzeń od początku do końca.
Ponieważ każda grupa odbiorców utrzymuje własne, oddzielne przesunięcie (offset), czyli wskaźnik, który zdarzenia zostały już odczytane, aplikacja konsumująca A może przetwarzać zdarzenia w czasie rzeczywistym, podczas gdy aplikacja konsumująca B może pozostawać w tyle lub odtwarzać dane historyczne z wcześniejszej części dnia — bez wzajemnego zakłócania się. To rozdzielenie producentów i konsumentów sprawia, że Event Hubs jest tak wszechstronnym centrum integracji dla nowoczesnych architektur przedsiębiorstw.
Strategie skalowania: jednostki przepustowości, jednostki przetwarzania i auto-inflacja
Efektywne zarządzanie pojemnością to jedna z najważniejszych odpowiedzialności architekta chmury. Azure Event Hubs oferuje elastyczne poziomy cenowe i mechanizmy skalowania, które pomagają utrzymać wydajność i opłacalność architektury przy zmiennym obciążeniu.
W warstwie Standard pojemność mierzy się w jednostkach przepustowości (Throughput Units, TU). Pojedyncza jednostka przepustowości zapewnia 1 MB/s przepustowości przychodzącej i 2 MB/s wychodzącej, a także do 1000 zdarzeń przychodzących na sekundę na jednostkę TU. Jeśli ruch gwałtownie wzrasta, ręczne skalowanie bywa żmudne i podatne na błędy ludzkie. Na szczęście Event Hubs oferuje natywną funkcję automatycznego skalowania znaną jako Auto-Inflate.
Gdy funkcja Auto-Inflate jest włączona, Azure automatycznie zwiększa liczbę jednostek przepustowości w zależności od obciążenia ruchem, zapobiegając ograniczaniu przepustowości (throttling) i zapewniając, że potok pozyskiwania danych nigdy nie straci pakietów podczas nieoczekiwanych skoków ruchu. Dla organizacji wymagających dedykowanych, odizolowanych zasobów obliczeniowych z przewidywalną wydajnością warstwy Premium i Dedicated wprowadzają jednostki przetwarzania (Processing Units, PU), oferując wyższe limity, brak zakłóceń ze strony sąsiednich najemców (noisy neighbor) oraz izolację klasy korporacyjnej.
Niezawodność danych, przechowywanie i odzyskiwanie po awarii
Przy danych telemetrycznych o dużej szybkości i krytycznych dziennikach biznesowych utrata danych po prostu nie wchodzi w grę. Azure Event Hubs zawiera solidne mechanizmy gwarantujące trwałość danych i wysoką dostępność.
Dane zapisane w Event Hubs są domyślnie replikowane w wielu domenach awarii w obrębie regionu Azure. Ponadto warstwa Standard przechowuje dane przez maksymalnie 7 dni, a warstwy Premium i Dedicated wydłużają ten okres do 90 dni. Takie okno retencji pozwala aplikacjom odzyskiwać sprawność po długotrwałych awariach dzięki odtworzeniu danych od określonego momentu.
Dla aplikacji krytycznych, wymagających ochrony przed awariami regionalnymi, Azure oferuje funkcje odzyskiwania po awarii geograficznej (Geo-Disaster Recovery) i geo-replikacji. Dzięki połączeniu przestrzeni nazw podstawowej z przestrzenią nazw zapasową w sparowanym regionie Azure organizacje mogą szybko przełączać potoki danych w razie katastrofy, spełniając rygorystyczne wymagania dotyczące docelowego czasu odtworzenia (RTO) i docelowego punktu odtworzenia (RPO).
Porównanie Azure Event Hubs, Service Bus i Apache Kafka
Architekci często mają trudności z wyborem właściwej usługi komunikacyjnej w Azure, ponieważ portfolio obejmuje kilka wydajnych opcji. Aby podjąć właściwą decyzję, warto zrozumieć, jak Event Hubs wypada na tle Azure Service Bus i Apache Kafka.
Azure Service Bus został zaprojektowany z myślą o wzorcach komunikacji w przedsiębiorstwach, koncentrując się na solidnych gwarancjach, takich jak transakcje, kolejkowanie wiadomości nieprzetworzonych (dead-lettering), sesje oraz złożone trasowanie pub/sub, przy stosunkowo umiarkowanych wolumenach danych. Natomiast Azure Event Hubs jest stworzony specjalnie do masowego pozyskiwania telemetrii i przetwarzania strumieniowego o dużej przepustowości. Jeśli potrzebujesz przetwarzać miliony lekkich zdarzeń na sekundę, Event Hubs jest znacznie bardziej opłacalny i wydajny niż Service Bus.
W porównaniu z oprogramowaniem open source Apache Kafka usługa Azure Event Hubs ma wyraźną przewagę operacyjną: jest w pełni zarządzana. Nie musisz zarządzać klastrami, konfigurować usługi Zookeeper ani zajmować się aktualizacjami systemu operacyjnego. Event Hubs udostępnia nawet punkt końcowy zgodny z Kafką, dzięki czemu istniejące aplikacje Kafka mogą łączyć się z usługą Azure Event Hubs przy minimalnych zmianach w kodzie, co daje to, co najlepsze z obu światów.
Najlepsze praktyki projektowania niezawodnych potoków przetwarzania strumieniowego
Projektowanie potoku strumieniowego klasy korporacyjnej wymaga starannego planowania i przestrzegania sprawdzonych najlepszych praktyk. Na zakończenie naszych rozważań architektonicznych warto mieć na uwadze następujące kluczowe rekomendacje:
- Starannie zaplanuj liczbę partycji: pamiętaj, że choć jednostki przepustowości można skalować dynamicznie, liczba partycji jest stała od momentu utworzenia centrum zdarzeń. Wybierz liczbę partycji, która uwzględni przyszły wzrost, nie wprowadzając przy tym niepotrzebnego narzutu koordynacji.
- Wybieraj odpowiednie klucze partycji: stosuj znaczące klucze partycji, aby zapewnić równomierne rozłożenie danych między partycjami i uniknąć „gorących partycji”, w których pojedynczy klucz monopolizuje zasoby.
- Wdróż solidną obsługę błędów: zbuduj zasady ponawiania prób i mechanizmy kierowania wiadomości do kolejki martwych liter w aplikacjach konsumenckich, aby łagodnie radzić sobie z wiadomościami uszkodzonymi i przejściowymi awariami sieci.
- Monitoruj ograniczanie przepustowości: używaj usługi Azure Monitor do śledzenia metryk, takich jak żądania przychodzące, żądania ograniczone oraz kondycja partycji, aby aplikacja działała z zapasem w ramach przydzielonych limitów.
Opanowując partycje, grupy konsumentów i strategie skalowania, możesz budować potoki przetwarzania strumieniowego, które są nie tylko błyskawiczne, ale także odporne, skalowalne i gotowe obsłużyć każdy wolumen danych, z jakim zetknie się Twoja organizacja.
W tym wpisie na blogu omówiliśmy podstawową architekturę usługi Azure Event Hubs, opisując, jak partycje umożliwiają równoległe wykonywanie zadań, jak grupy konsumentów oddzielają niezależne obciążenia oraz jak mechanizmy automatycznego skalowania pozwalają utrzymać płynne działanie aplikacji pod dużym obciążeniem. Aby zacząć, utwórz przestrzeń nazw Event Hubs w portalu Azure, skonfiguruj pierwszą grupę konsumentów i podłącz procesor strumieni.
Aby pogłębić swoją wiedzę i posłuchać rzeczywistych dyskusji na ten temat, koniecznie posłuchaj naszego odcinka podcastu: Azure Event Hubs - Simply Explained. Przyjmij moc przetwarzania strumieniowego danych w czasie rzeczywistym i przekształć dziś procesy inżynierii danych w swojej organizacji! 🚀
Często zadawane pytania
Czym jest Azure Event Hubs?
Azure Event Hubs to w pełni zarządzana platforma do strumieniowego przesyłania zdarzeń o wysokiej przepustowości, zdolna do przyjmowania i przetwarzania milionów zdarzeń na sekundę przy niskim opóźnieniu, co czyni ją idealnym rozwiązaniem dla nowoczesnych potoków danych w czasie rzeczywistym.
Jak działają partycje w Azure Event Hubs?
Partycje dzielą cały strumień danych na niezależne sekwencje. Producenci kierują zdarzenia do partycji za pomocą klucza partycji, co pozwala wielu instancjom konsumentów odczytywać dane równolegle i maksymalizować przepustowość przetwarzania.
Jaka jest różnica między centrum zdarzeń a grupą konsumentów?
Centrum zdarzeń to centralny magazyn dziennika przychodzących zdarzeń, natomiast grupa konsumentów reprezentuje odrębny widok tego strumienia zdarzeń. Wiele grup konsumentów pozwala różnym aplikacjom niezależnie odczytywać te same dane bez wzajemnego zakłócania się.
Czy mogę automatycznie skalować usługę Azure Event Hubs?
Tak. Po włączeniu funkcji Auto-Inflate w przestrzeniach nazw warstwy Standard platforma Azure automatycznie zwiększa przydzieloną liczbę jednostek przepustowości (Throughput Units) w miarę wzrostu obciążenia ruchem, zapobiegając ograniczaniu wydajności.
Jak długo dane są przechowywane w Azure Event Hubs?
Czas przechowywania danych zależy od warstwy cenowej. Warstwa Standard przechowuje dane przez maksymalnie 7 dni, natomiast warstwy Premium i Dedicated umożliwiają przechowywanie danych przez maksymalnie 90 dni.
Czy Azure Event Hubs jest zgodne z Apache Kafka?
Tak. Azure Event Hubs udostępnia natywny punkt końcowy zgodny z Kafką, dzięki czemu istniejące aplikacje klienckie i narzędzia Apache Kafka mogą komunikować się z Event Hubs bez konieczności przepisywania bazy kodu.
🎧 Posłuchaj tego odcinka
Chcesz praktycznego, mówionego wyjaśnienia usługi Azure Event Hubs? Ten odcinek w przystępny sposób omawia architekturę i pokazuje, dlaczego ma ona znaczenie dla nowoczesnego tworzenia aplikacji w chmurze, analityki korporacyjnej i skalowalnych aplikacji.
Posłuchaj tego odcinka, jeśli chcesz:
- Poznaj podstawowe mechanizmy partycji i skalowania w usłudze Azure Event Hubs
- Zobacz, jak architektury strumieniowe wpisują się w szerszy ekosystem Microsoft Azure
- Dowiedz się, gdzie strumieniowanie zdarzeń przynosi praktyczną wartość biznesową w Twojej organizacji
Może Cię też zainteresować następujący odcinki M365 FM:
Odkryj więcej praktycznych rozmów o chmurze i technologiach Microsoft na M365 FM.
Ostatnia weryfikacja: lipiec 2026.
Dla kogo jest ten odcinek
Ten odcinek jest niezbędny dla administratorów Azure, architektów przedsiębiorstw, deweloperów oprogramowania i liderów technicznych, którzy potrzebują solidnych, praktycznych podstaw przed projektowaniem, zarządzaniem lub eksploatacją architektur strumieniowania danych w czasie rzeczywistym.
🎧 Warto też posłuchać
- Azure Event Grid — Praktyczny kolejny krok w poznawaniu reaktywnej komunikacji w chmurze.
- Azure Service Bus — Dowiedz się, kiedy używać kolejek komunikatów, a kiedy strumieni zdarzeń.
- Azure Functions — Sprawdź, jak przetwarzać strumienie zdarzeń w modelu bezserwerowym.