 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Opanowanie architektury zdarzeniowej dzięki wyzwalaczom Azure Functions
By Mirko Peters ·
Witajcie ponownie, architekci chmury i programiści! Jeśli kiedykolwiek chcieliście tworzyć aplikacje, które natychmiast reagują na zdarzenia ze świata rzeczywistego, bez konieczności przydzielania, łatania czy zarządzania maszynami wirtualnymi, to trafiliście we właściwe miejsce. Dziś zagłębimy się w podstawowe mechanizmy przetwarzania bezserwerowego. Konkretnie przyjrzymy się temu, jak opanować a
Automatically translated with AI from the original post. Read the English original
Witajcie ponownie, architekci chmury i programiści! Jeśli kiedykolwiek chcieliście tworzyć aplikacje, które natychmiast reagują na zdarzenia ze świata rzeczywistego, bez konieczności przydzielania, łatania czy zarządzania maszynami wirtualnymi, to trafiliście we właściwe miejsce. Dziś zagłębimy się w podstawowe mechanizmy przetwarzania bezserwerowego. Konkretnie przyjrzymy się temu, jak opanować architekturę zdarzeniową przy użyciu wyzwalaczy Azure Functions. Niezależnie od tego, czy tworzycie interfejsy API o dużym natężeniu ruchu, przetwarzacie w tle przesyłane pliki, czy zarządzacie złożonymi korporacyjnymi kolejkami komunikatów, wybór odpowiedniego wyzwalacza to klucz do budowania skalowalnych, responsywnych i opłacalnych rozwiązań chmurowych.
W tym wpisie pokażemy, jak wyzwalacze działają jak bijące serce Waszych aplikacji bezserwerowych, pozwalając kodowi uruchamiać się wyłącznie wtedy, gdy wydarzy się coś istotnego. Od prostych webhooków HTTP, przez asynchroniczne wyzwalacze magazynu, po wyzwalacze czasowe, omówimy wszystko, co warto wiedzieć, aby podnieść swoje umiejętności w zakresie programowania w Azure.
Wprowadzenie do architektury zdarzeniowej z Azure Functions
Architektura zdarzeniowa (EDA, event-driven architecture) to wzorzec projektowy, w którym rozłączone aplikacje i usługi komunikują się asynchronicznie, wytwarzając i konsumując zdarzenia. Zamiast tego, by systemy nieustannie odpytywały się nawzajem, czy coś się zmieniło, model zdarzeniowy odwraca ten schemat: gdy wystąpi jakaś czynność, na przykład użytkownik prześle awatar, klient złoży formularz zamówienia albo zegar wybije północ, emitowane jest zdarzenie.
Azure Functions doskonale wpisuje się w ten styl architektoniczny. Jako usługa obliczeniowa bezserwerowa pozwala uruchamiać wydzielone fragmenty logiki biznesowej w odpowiedzi na te zdarzenia. Nie musicie martwić się systemami operacyjnymi, siecią ani skalowaniem sprzętu. Piszecie kod, podłączacie wyzwalacz, a resztą zajmuje się Azure. Dzięki EDA w Azure Functions możecie rozdzielić mikrousługi, ograniczyć koszty bezczynnych zasobów obliczeniowych i budować z natury odporne systemy, które bez problemu radzą sobie z nieprzewidywalnymi skokami ruchu.
Zrozumienie Azure Functions i przetwarzania bezserwerowego
Przetwarzanie bezserwerowe nie oznacza, że serwerów nie ma; oznacza, że zarządzanie nimi jest całkowicie ukryte przed codzienną pracą. Azure Functions realizuje tę obietnicę, oferując środowisko przyjazne dla programistów, w którym skupiacie się wyłącznie na logice aplikacji.
Jedną z najważniejszych zalet tego modelu jest automatyczne skalowanie. W standardowym planie Consumption Azure skaluje instancje funkcji poziomo w chwili napływu lawiny zdarzeń, a gdy ruch ustaje, sprowadza je z powrotem do zera. Oznacza to, że nigdy nie płacicie za bezczynną pojemność. Ponadto Azure Functions oferuje szerokie wsparcie dla języków: czy preferujecie C#, JavaScript, TypeScript, Python, PowerShell czy Javę, możecie pisać kod bezserwerowy w znanym Wam stosie technologicznym. W połączeniu z płynną integracją z całym ekosystemem Azure przetwarzanie bezserwerowe fundamentalnie zmienia tempo, w jakim zespoły mogą prototypować, iterować i wdrażać rozwiązania produkcyjne.
Moc wyzwalaczy: reagowanie na zdarzenia ze świata rzeczywistego
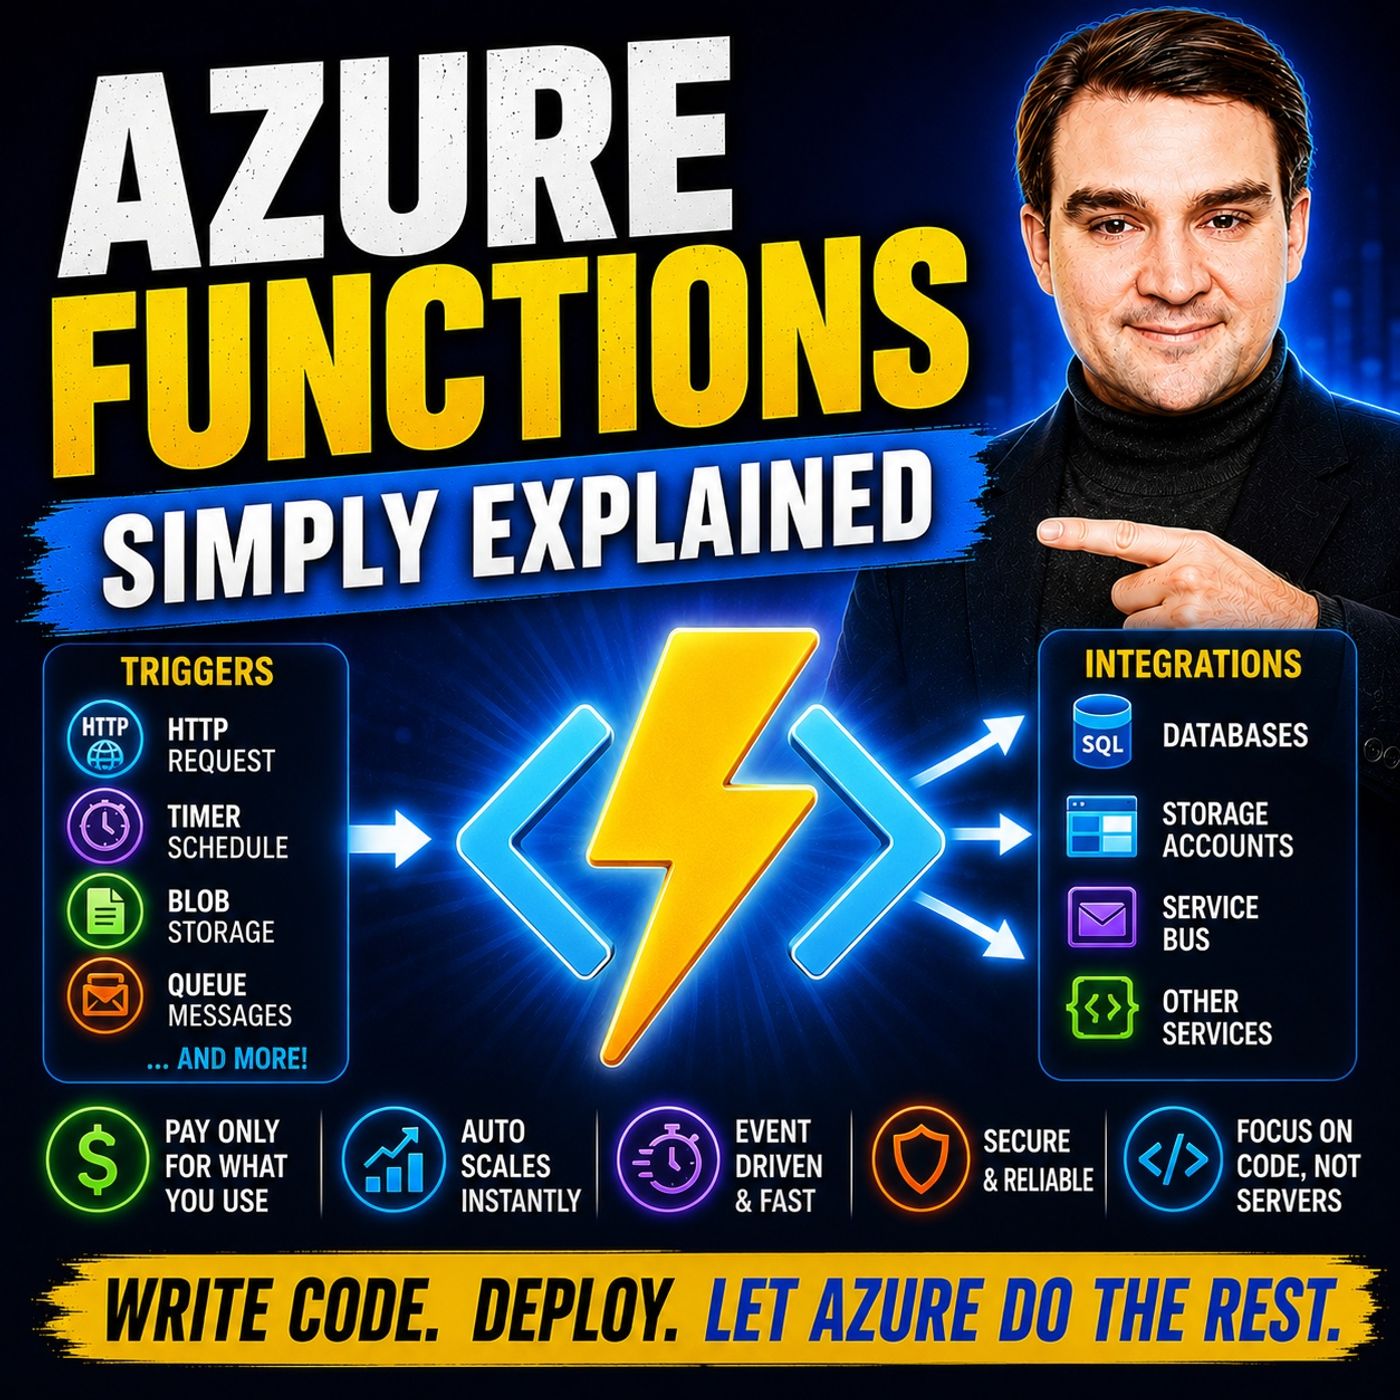
U podstaw każdej funkcji Azure leży wyzwalacz. Mówiąc wprost, wyzwalacz określa, w jaki sposób funkcja jest wywoływana. Każda funkcja musi mieć dokładnie jeden wyzwalacz, a opcjonalnie może mieć wiele powiązań służących do odczytu i zapisu danych.
Wyzwalacze sprawiają, że Wasz kod przestaje być statycznym skryptem, a staje się aktywnym uczestnikiem ekosystemu zdarzeniowego. Zamiast tradycyjnej aplikacji działającej nieprzerwanie w tle i czekającej na pracę, funkcja zdarzeniowa śpi cicho, dopóki przychodzący wyzwalacz jej nie obudzi. Ta zmiana architektoniczna zapewnia maksymalnie efektywne wykorzystanie zasobów obliczeniowych. Niezależnie od tego, czy zdarzenie pochodzi z żądania sieciowego, zaplanowanego wyrażenia cron, komunikatu trafiającego do magistrali usług czy dokumentu zmienionego w bazie danych, wyzwalacze gwarantują, że aplikacja zareaguje w ciągu milisekund.
Szczegółowo o wyzwalaczach HTTP i czasowych
Przyjrzyjmy się bliżej dwóm najczęściej używanym wyzwalaczom w zestawie narzędzi Azure Functions: wyzwalaczowi HTTP oraz wyzwalaczowi czasowemu.
Wyzwalacze HTTP to brama do tworzenia niezawodnych, bezserwerowych interfejsów API REST i webhooków. Po skonfigurowaniu wyzwalacza HTTP Azure udostępnia funkcji bezpieczny punkt końcowy w postaci adresu URL. Za każdym razem, gdy klient wyśle żądanie HTTP, czy to GET, POST, PUT, czy DELETE, funkcja zostaje uruchomiona, przetwarza ładunek i zwraca odpowiedź. Dzięki temu wyzwalacze HTTP idealnie nadają się do zasilania nowoczesnych aplikacji jednostronicowych, zaplecza aplikacji mobilnych oraz integracji webhooków z zewnętrznymi platformami SaaS.
Z drugiej strony wyzwalacze czasowe pozwalają na wykonywanie kodu w oparciu o czas, bez korzystania z zewnętrznej infrastruktury harmonogramowania. Definiując proste wyrażenie cron w konfiguracji, możesz sprawić, że funkcja uruchomi się co pięć minut, raz dziennie lub zgodnie ze złożonymi harmonogramami kalendarzowymi. Wyzwalacze czasowe są podstawowym wyborem dla zautomatyzowanych zadań konserwacyjnych, nocnych raportów agregujących dane, czyszczenia pamięci podręcznej i cyklicznego porządkowania baz danych.
Obsługa asynchronicznych przepływów pracy za pomocą wyzwalaczy kolejek i obiektów blob
Podczas tworzenia aplikacji dla przedsiębiorstw cykle synchronicznego żądania i odpowiedzi często nie wystarczają. Potrzebujesz asynchronicznych, rozprzęgniętych przepływów pracy, aby zapewnić niezawodność systemu w scenariuszach dużego obciążenia. Właśnie tutaj świetnie sprawdzają się wyzwalacze kolejek i magazynu obiektów blob.
Wyzwalacz Blob Storage nasłuchuje zdarzeń w kontenerach i automatycznie uruchamia funkcję w chwili przesłania lub zmodyfikowania pliku. To prawdziwy przełom w potokach przetwarzania multimediów, na przykład przy zmianie rozmiaru przesyłanych zdjęć profilowych, skanowaniu przychodzących dokumentów pod kątem złośliwego oprogramowania czy analizie zbiorczych plików CSV. Z kolei wyzwalacze kolejek, takie jak te połączone z Azure Queue Storage lub Azure Service Bus, pozwalają funkcjom pobierać wiadomości z kolejki sekwencyjnie lub wsadowo. Dzięki temu producenci po stronie wejściowej zostają oddzieleni od konsumentów po stronie wyjściowej, a system nawet wtedy, gdy tysiące zamówień zostanie złożonych jednocześnie, łagodnie absorbuje obciążenie bez utraty ani jednej wiadomości.
Zwiększanie skalowalności i wydajności dzięki właściwym wyzwalaczom
Wybór odpowiedniego wyzwalacza dla danego obciążenia to nie tylko szczegół implementacyjny, lecz krytyczna decyzja dotycząca wydajności. Źle dobrany wyzwalacz może wprowadzić wąskie gardła, zwiększyć opóźnienia lub podnieść koszty chmury.
Na przykład jeśli spróbujesz synchronicznie przetwarzać kosztowne transformacje plików wewnątrz interfejsu API uruchamianego wyzwalaczem HTTP, klienci będą doświadczać przekroczeń czasu oczekiwania i słabego doświadczenia użytkownika. Zamiast tego wydajnym wzorcem architektonicznym jest użycie wyzwalacza HTTP do szybkiego przyjęcia ładunku i zapisania go w magazynie obiektów blob lub w kolejce Azure, natychmiastowe zwrócenie odpowiedzi 202 Accepted, a następnie pozostawienie ciężkiego przetwarzania asynchronicznie w tle wyzwalaczowi Blob lub kolejki. Zrozumienie charakterystyki każdego wyzwalacza pozwala projektować potoki, które skalują się liniowo i utrzymują błyskawiczne czasy odpowiedzi pod dużym obciążeniem.
Pierwsze kroki: tworzenie pierwszej funkcji sterowanej zdarzeniami
Gotowy, by zabrać się do pracy? Uruchomienie pierwszej funkcji sterowanej zdarzeniami w Azure jest zaskakująco proste. Proces możesz rozpocząć bezpośrednio w portalu Azure, wybierając zasób, wskazując usługę Function App i wybierając plan hostingu Consumption.
Podczas kreatora konfiguracji określisz stos środowiska uruchomieniowego, wybierzesz preferowany system operacyjny i region oraz połączysz konto magazynu i wystąpienie Application Insights do zbierania danych telemetrycznych. Po utworzeniu zasobów możesz korzystać z lokalnych narzędzi deweloperskich, takich jak Azure Functions Core Tools i Visual Studio Code, aby pisać, testować i debugować funkcje lokalnie, zanim wdrożysz je bezpośrednio w chmurze. Pamiętaj, aby funkcje były małe, modularne i skupione na jednej odpowiedzialności, co zmaksymalizuje tempo pracy i ułatwi debugowanie.
Monitorowanie i rozwiązywanie problemów w aplikacjach bezserwerowych
Ponieważ aplikacje bezserwerowe są rozproszone i efemeryczne, tradycyjne techniki debugowania, takie jak podłączanie lokalnego debuggera do działającego serwera, rzadko wchodzą w grę. Dlatego solidne monitorowanie i logowanie są absolutnie niezbędne do sukcesu produkcyjnego.
Integracja Azure Functions z Azure Monitor i Application Insights zapewnia szczegółową telemetrię od razu po wdrożeniu, obejmującą czasy wykonania, wskaźniki błędów i wywołania zależności. Aby w pełni wykorzystać te dane, stosuj ustrukturyzowane logowanie i używaj unikalnych identyfikatorów korelacji w każdym wykonaniu funkcji. Gdy usługa zależna ulegnie awarii lub wystąpi wyjątek, identyfikatory korelacji pozwalają prześledzić cykl życia pojedynczego zdarzenia w wielu rozproszonych funkcjach, co znacząco skraca średni czas rozwiązania problemu (MTTR).
Najlepsze praktyki organizacji kodu i zabezpieczeń
Wraz ze wzrostem środowiska serverless – od pojedynczej funkcji do rozbudowanego ekosystemu kilkudziesięciu mikrousług – utrzymanie uporządkowanego i bezpiecznego kodu staje się kluczowe. Grupuj powiązane funkcje w jednej aplikacji funkcji, jeśli mają ten sam cykl życia, ustawienia konfiguracji i harmonogram wdrożeń. I odwrotnie: jeśli funkcje wymagają zasadniczo różnych konfiguracji lub odrębnych granic zabezpieczeń, umieść je w osobnych aplikacjach funkcji.
Jeśli chodzi o bezpieczeństwo, nigdy nie umieszczaj na stałe ciągów połączeń ani sekretów w kodzie źródłowym. Wykorzystaj Azure Key Vault wraz z tożsamościami zarządzanymi, aby bezpiecznie uwierzytelniać funkcje w innych zasobach platformy Azure bez osadzania poświadczeń. Dodatkowo ogranicz punkty końcowe HTTP, stosując klucze funkcji, tokeny sieciowe JSON (JWT) lub integrację z Azure Active Directory, i zabezpiecz granice sieci wirtualnej, aby chronić wrażliwe wewnętrzne interfejsy API przed nieautoryzowanym dostępem z publicznej sieci.
Podsumowanie i kolejne kroki dla Twoich rozwiązań chmurowych
Architektura sterowana zdarzeniami i Azure Functions to ogromny krok naprzód w nowoczesnym tworzeniu aplikacji chmurowych. Dzięki możliwości natychmiastowej reakcji kodu na rzeczywiste wyzwalacze, bez obciążenia związanego z aprowizacją serwerów, zyskujesz niespotykany dotąd poziom skalowalności, efektywności operacyjnej i opłacalności. Czy budujesz potoki danych w czasie rzeczywistym, bezserwerowe interfejsy API internetowe, czy zautomatyzowane procesory działające w tle, opanowanie wyzwalaczy jest kluczem do pełnego wykorzystania potencjału chmury.
Aby zgłębić ten temat i poznać praktyczne decyzje projektowe przy budowie nowoczesnych rozwiązań w Azure, koniecznie posłuchaj powiązanego odcinka podcastu: Azure Functions - Simply Explained. Posłuchaj ekspertów o wyzwalaczach, powiązaniach, wyborze hostingu i praktycznych wzorcach projektowania serverless, które możesz już dziś zastosować w swojej architekturze!