 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Demaskowanie mitu o opóźnieniach: lokalny proces a korporacyjne HTTP
By Mirko Peters ·
Witamy ponownie w naszym cyklu technicznych analiz architektury przedsiębiorstw i nowoczesnego projektowania systemów. W tym wpisie rozwijamy temat, który regularnie wywołuje dyskusje wśród inżynierów oprogramowania i architektów systemów: czym tak naprawdę jest opóźnienie w aplikacjach rozproszonych w porównaniu z procesami lokalnymi. Projektując systemy o wysokiej przepustowości, zwłaszcza łączą
Automatically translated with AI from the original post. Read the English original
Witamy ponownie w naszym cyklu technicznych analiz architektury przedsiębiorstw i nowoczesnego projektowania systemów. W tym wpisie rozwijamy temat, który regularnie wywołuje dyskusje wśród inżynierów oprogramowania i architektów systemów: czym tak naprawdę jest opóźnienie w aplikacjach rozproszonych w porównaniu z procesami lokalnymi. Projektując systemy o wysokiej przepustowości, zwłaszcza łączące asystentów AI na komputerach z backendowymi platformami danych w chmurze, deweloperzy często wpadają w pułapkę mikrobenchmarków. Patrzą na surową szybkość transportu i zakładają, że lokalna komunikacja międzyprocesowa jest zawsze lepsza od korporacyjnego HTTP opartego na sieci. Jak jednak pokazujemy w tym artykule, to założenie jest mitem.
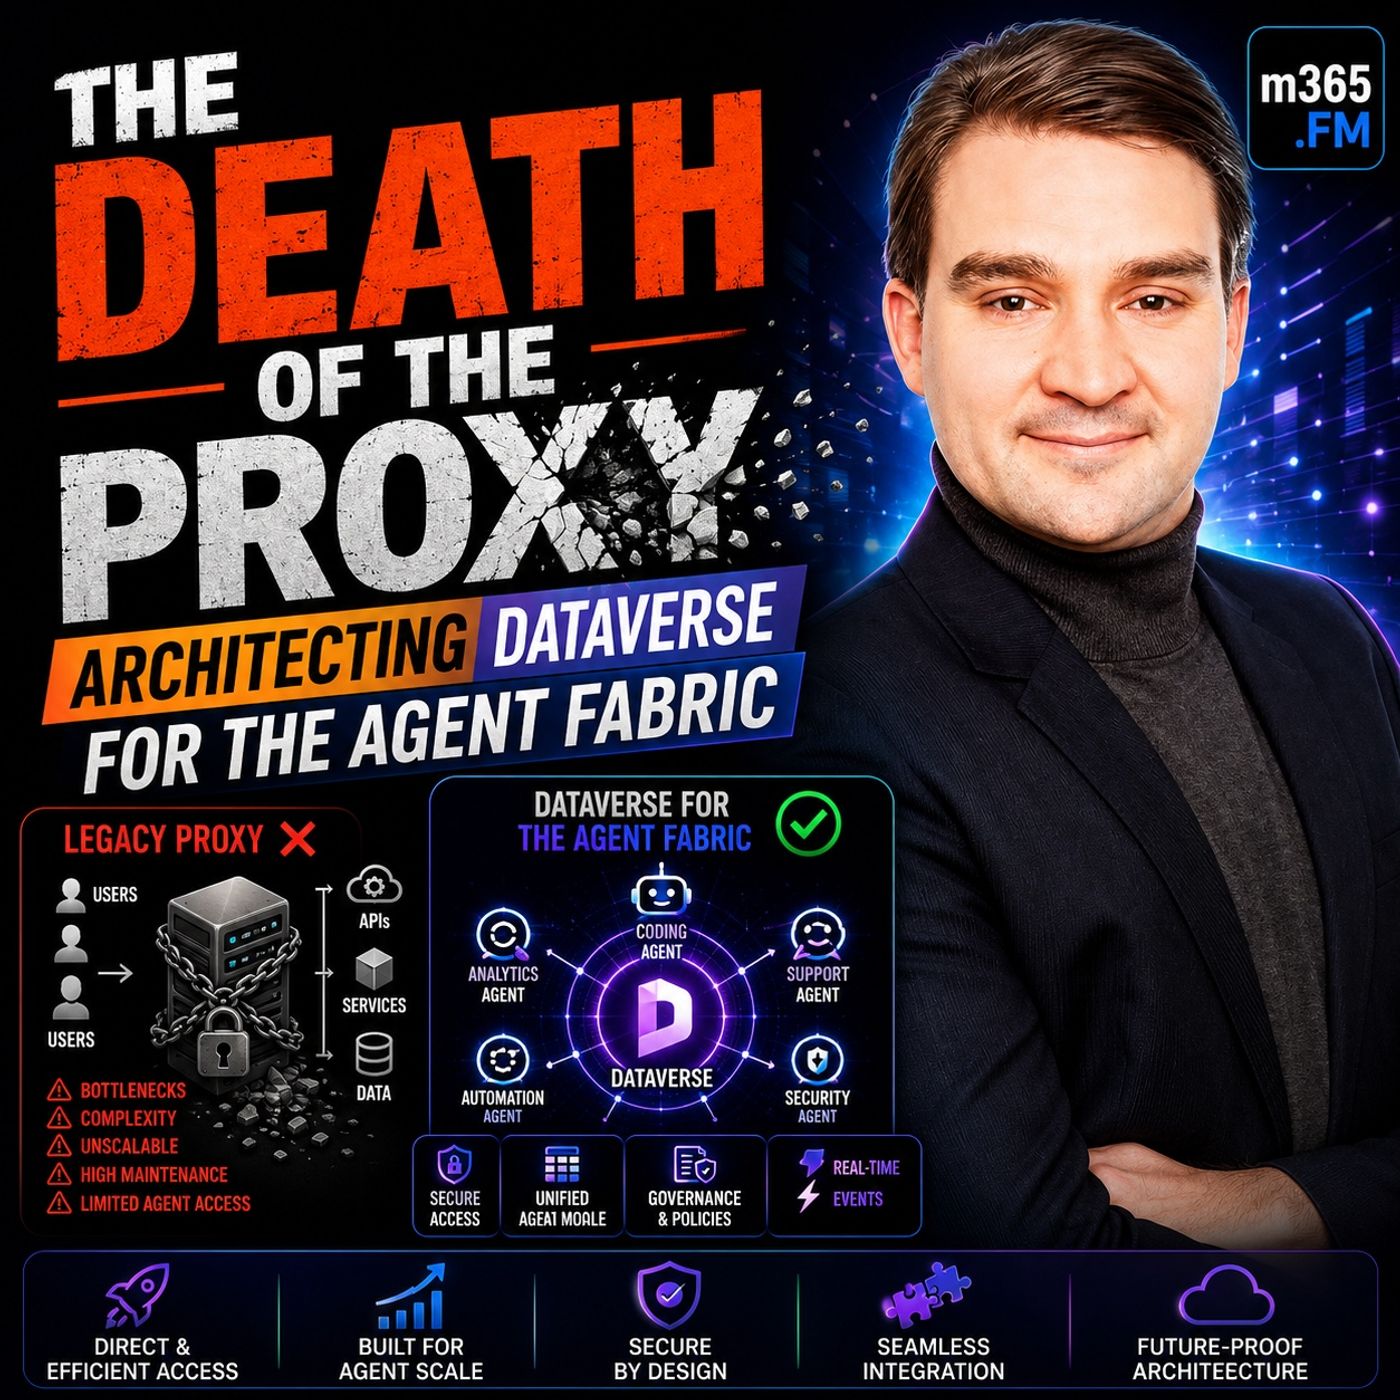
Ten temat bezpośrednio nawiązuje do naszej niedawnej rozmowy w podcaście. Jeśli jeszcze jej nie słuchałeś, koniecznie sprawdź THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric, w którym omawiamy, jak nowoczesne architektury odchodzą od kruchych lokalnych proxy na rzecz solidnych, skalowalnych korporacyjnych punktów końcowych HTTP.
Wprowadzenie do mitu o opóźnieniach w korporacyjnej AI
Rozwój oprogramowania dla przedsiębiorstw wymusił przemyślenie sposobu, w jaki obsługujemy komunikację między klientami a systemami backendowymi. Najbardziej widać to w architekturze integracji AI w firmach. Przez lata lokalne narzędzia, takie jak proxy STDIO, były standardowym zaleceniem łączenia aplikacji desktopowych z bazami danych w chmurze. Były proste w instalacji, wymagały minimalnej infrastruktury i w lokalnych testach działały niemal natychmiast.
Gdy jednak organizacje przechodzą od izolowanych eksperymentów deweloperów do wdrożeń obejmujących setki lub tysiące agentów AI, te lokalne założenia zaczynają pękać. Inżynierowie broniący lokalnych procesów najczęściej wskazują opóźnienie transportu jako ostateczny czynnik decydujący. Twierdzą, że HTTP wprowadza narzut sieciowy, uzgadnianie połączeń TCP i negocjację TLS, podczas gdy lokalne przekazywanie danych działa w mikrosekundach. Ten argument opiera się jednak na fundamentalnym niezrozumieniu tego, gdzie naprawdę przepada czas w rzeczywistej transakcji korporacyjnej. Aby naprawdę zrozumieć wydajność, musimy spojrzeć poza warstwę transportu i przeanalizować całe obciążenie.
Mikrobenchmarki a rzeczywiste obciążenia korporacyjne
Mikrobenchmarki są notorycznie mylące. W izolowanym środowisku testowym pomiar surowego czasu przekazania payloadu JSON przez lokalny potok STDIO w porównaniu z interfejsem pętli zwrotnej HTTP niemal zawsze wypadnie na korzyść procesu lokalnego. Liczby wyglądają jednoznacznie: pojedyncze milisekundy dla lokalnych potoków wobec dwucyfrowych milisekund dla pętli sieciowych.
Problem polega na tym, że mikrobenchmarki pomijają rzeczywistość działania oprogramowania korporacyjnego. Gdy agent AI żąda danych z solidnej platformy, takiej jak Dataverse, mechanizm transportu stanowi zaledwie ułamek całego równania. Za tym punktem końcowym kryje się złożony łańcuch operacji:
- Weryfikacja tożsamości i walidacja tokenów za pomocą Microsoft Entra ID
- Kontrola dostępu oparta na rolach (RBAC) i sprawdzanie granic bezpieczeństwa
- Wykonywanie złożonej logiki biznesowej, wtyczek i niestandardowych przepływów pracy
- Kompilacja zapytań do bazy danych, ocena indeksów i fizyczne pobieranie danych
- Serializacja i deserializacja bogatych modeli danych przedsiębiorstwa
Gdy zapytanie do bazy danych i logika biznesowa wykonują się trzysta milisekund, oszczędność czterech milisekund na narzucie transportu jest całkowicie pomijalna. Wąskim gardłem nigdy nie jest przewód sieciowy, lecz moc obliczeniowa potrzebna do realizacji żądania biznesowego. Gdy architekci optymalizują warstwę transportu, ignorując koszt operacyjny logiki backendowej, optymalizują niewłaściwą część stosu.
Prawdziwy koszt narzutu transportu
Choć komunikacja przez lokalne procesy imponuje teoretyczną szybkością, ukrywa ogromny narzut operacyjny i infrastrukturalny, który kumuluje się wraz ze skalą. Rozważmy, co się dzieje, gdy każdy użytkownik uruchamia własny lokalny proces, aby połączyć klienta AI z usługą w chmurze.
Każda pojedyncza instancja lokalnego proxy generuje własny koszt uruchomienia, własny narzut inicjalizacji procesu oraz odrębny, izolowany cykl życia uwierzytelniania. Ponadto każdy lokalny proces musi samodzielnie zarządzać swoimi połączeniami, poświadczeniami zabezpieczeń oraz stanami błędów. Jeśli organizacja ma pięciuset deweloperów lub zautomatyzowanych agentów uruchamiających lokalne proxy, oznacza to pięćset oddzielnych potoków połączeń, które próbują negocjować z zasobami zaplecza.
W porównaniu z prawidłowo skonfigurowanym korporacyjnym punktem końcowym HTTP ukryte koszty modelu lokalnego stają się bardzo wyraźne. Lokalne procesy nie mogą łatwo współdzielić stanu, globalnie buforować uzgodnień połączeń ani efektywnie łączyć zasobów w puli między różnymi aplikacjami klienckimi. Odczuwalna szybkość lokalnego procesu jest iluzją, która załamuje się w chwili, gdy do gry wchodzą współbieżność i fragmentacja systemu.
Jak pule połączeń wygrywają wyścig o wydajność
Tutaj korporacyjny HTTP radykalnie zmienia obraz wydajności. W przeciwieństwie do efemerycznych procesów lokalnych, które wielokrotnie otwierają i zamykają połączenia, usługi HTTP klasy produkcyjnej korzystają z zaawansowanych pul połączeń, trwałych sesji i długo działającej infrastruktury serwerowej.
Gdy korporacyjny klient HTTP łączy się z usługą współdzieloną, koszty początkowego uzgadniania – takie jak wyszukiwanie DNS, powolny start TCP (TCP slow-start) i negocjacja TLS – ponoszone są jednorazowo. Kolejne żądania korzystają z już ustanowionych, trwałych połączeń. Ponadto, ponieważ połączenia te są pulowane i zarządzane przez scentralizowaną warstwę usługową, system może utrzymywać rozgrzane połączenia z bazami danych, wstępnie uwierzytelnione sesje oraz buforowane schematy metadanych.
W prawidłowo dostrojonym środowisku korporacyjnym te optymalizacje sprawiają, że ciągły strumień żądań HTTP może osiągnąć niższe średnie opóźnienie end-to-end niż rozproszony zbiór niezkoordynowanych procesów lokalnych. Narzut sieciowy rozkłada się na tysiące błyskawicznych, trwałych transakcji, przez co początkowa kara za transport staje się całkowicie nieistotna.
Skalowanie korporacyjnego HTTP a narzut lokalnych procesów
Skalowanie architektury oprogramowania to ostateczny test jej zasad projektowych. Gdy organizacja przechodzi od obsługi kilku asystentów deweloperskich do wdrożenia rozbudowanego ekosystemu narzędzi AI – obejmującego GitHub Copilot, Claude Code, własne orkiestratory i wewnętrzne Copilot CLI – operacyjna rzeczywistość lokalnych procesów staje się nie do utrzymania.
Zarządzanie setkami rozłączonych procesów proxy prowadzi do poważnego administracyjnego dryfu. Brakuje scentralizowanej widoczności, monitorowanie jest rozproszone, a diagnozowanie sporadycznych awarii na różnych lokalnych maszynach to koszmar dla administratorów IT. Zarządzanie bezpieczeństwem staje się zbiorem lokalnych konfiguracji zamiast ujednoliconych, egzekwowalnych zasad.
W przeciwieństwie do tego skalowanie architektury HTTP w organizacji jest liniowe i przewidywalne. Zamiast mnożyć infrastrukturę na każdej stacji roboczej użytkownika, organizacje skalują jedną, wysoko dostępną usługę za korporacyjnym modułem równoważenia obciążenia. Gdy zapotrzebowanie rośnie, wystarczy uruchomić dodatkowe instancje serwerów. Klienci nadal komunikują się z tym samym zarządzanym punktem końcowym, a platforma transparentnie obsługuje skalowanie poziome, rozkład obciążenia i telemetrię. Mechanizmy bezpieczeństwa, takie jak PKCE (Proof Key for Code Exchange), pozwalają publicznym klientom desktopowym uwierzytelniać się bezpiecznie bez przechowywania zakodowanych na stałe sekretów, łącząc solidne zarządzanie korporacyjne z wygodą pracy deweloperów.
Podsumowanie: priorytet dla logiki biznesowej zamiast mikrooptymalizacji
Trwała atrakcyjność komunikacji przez lokalne procesy jest klasycznym przykładem tego, jak mikrooptymalizacja zaślepia architektów na realia makroskopowe. Choć lokalne potoki mogą wygrać syntetyczny benchmark o kilka milisekund, wprowadzają ogromną złożoność operacyjną, osłabiają bezpieczeństwo przedsiębiorstwa i nie skalują się w nowoczesnych środowiskach opartych na AI. Przenosząc uwagę z warstwy transportowej na solidne, z pulowanymi połączeniami architektury HTTP klasy korporacyjnej, budujemy systemy bezpieczne, skalowalne i naprawdę gotowe na wymagania nowoczesnego przedsiębiorstwa.
Aby dowiedzieć się więcej o tym, jak platformy takie jak Dataverse ewoluują, by pełnić rolę wspólnego fundamentu danych dla całej warstwy agentów, koniecznie posłuchaj pełnego odcinka: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. Dziękuję za lekturę i zapraszam do śledzenia kolejnych pogłębionych analiz architektury chmury przedsiębiorstw!