 RU
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Українська
 العربية
 עברית
 日本語
 한국어
Постоянные инструкции против ситуативной экспертизы: перестройка архитектуры вашего ИИ
By Mirko Peters ·
Добро пожаловать обратно в блог-компаньон к нашему подкасту. В сегодняшнем посте мы подробно разбираем техническое препятствие, с которым сталкивается почти каждая корпоративная команда после развёртывания первой волны ИИ-решений. Вы создаёте собственного ИИ-агента, и поначалу это кажется магией. Он быстрый, очень точный и отзывчивый. Но пройдите три–шесть месяцев вперёд, и происходит нечто странн
Automatically translated with AI from the original post. Read the English original
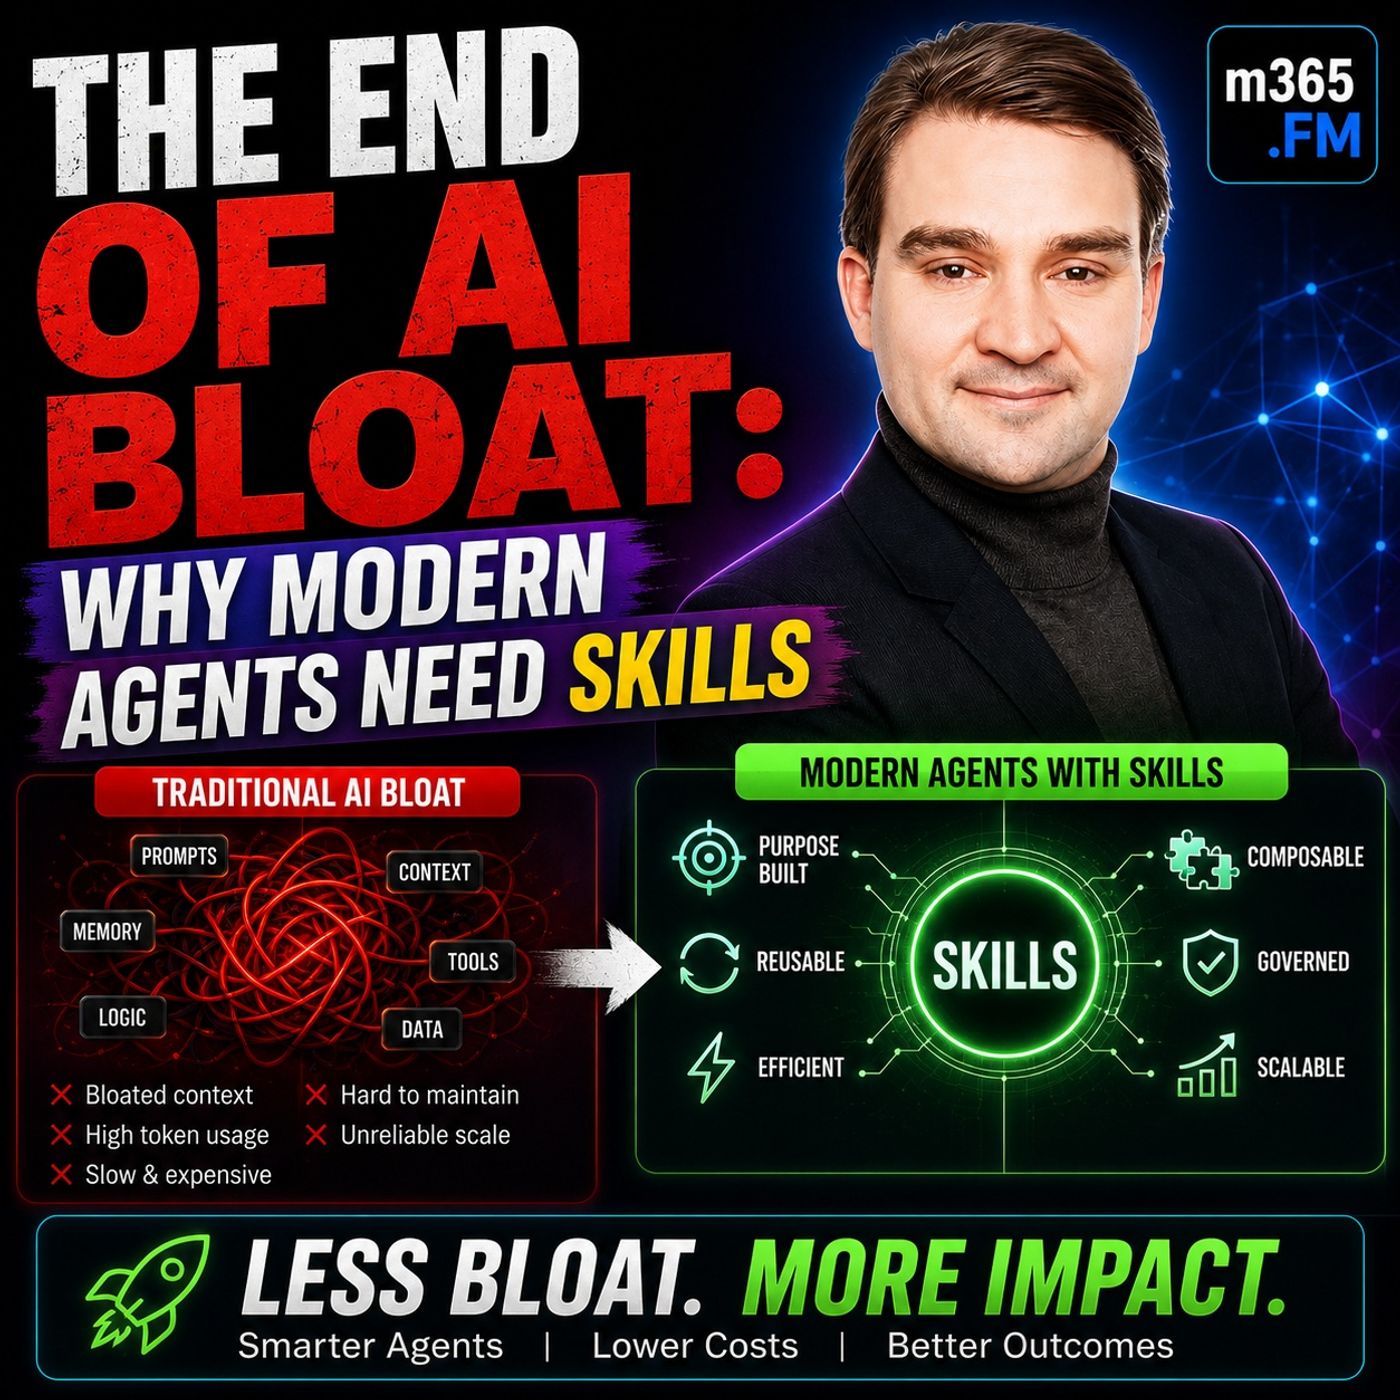
Добро пожаловать обратно в блог-компаньон к нашему подкасту. В сегодняшнем посте мы подробно разбираем техническое препятствие, с которым сталкивается почти каждая корпоративная команда после развёртывания первой волны ИИ-решений. Вы создаёте собственного ИИ-агента, и поначалу это кажется магией. Он быстрый, очень точный и отзывчивый. Но пройдите три–шесть месяцев вперёд, и происходит нечто странное. Время отклика растёт, операционные расходы потихоньку ползут вверх, а агент начинает галлюцинировать или отклоняться от заданного поведения. Стандартная практика во многих организациях — бросить больше вычислительных ресурсов на проблему или перейти на более крупную языковую модель. Но, как мы подробно разбираем, основная проблема не в самой модели, а в архитектуре ваших промптов.
В этом посте мы разберём, почему монолитные промпты приводят к катастрофической деградации контекста, как отделить универсальное базовое поведение от задач под конкретные сценарии и почему модульные шаблоны проектирования меняют ландшафт корпоративного ИИ.
Введение: скрытая цена монолитных промптов
Когда инженерные команды впервые прототипируют диалоговых ИИ-агентов, они обычно опираются на один обширный системный промпт. Этот промпт определяет, кем является агент, как он должен говорить, какие правила обязан соблюдать и как обрабатывать сложные граничные случаи. Это интуитивный способ начать. Однако по мере развития бизнеса меняется и промпт. HR добавляет новые политики отпусков, комплаенс вводит региональные требования, а служба поддержки дополняет его процессами возврата средств.
Не успеете оглянуться, как системный промпт разрастается до тысяч токенов плотных инструкций. Каждый раз, когда пользователь задаёт простой вопрос, например о часах работы офиса, модель ИИ вынуждена получить, обработать и проанализировать каждое правило, политику и граничный случай из всего системного промпта. Хотя девяносто пять процентов этих инструкций совершенно не относятся к вопросу о часах работы, модель всё равно должна их разобрать. Этот скрытый налог на вычисления и рассуждения мы называем «налогом на контекст» (Context Tax), и со временем он принципиально меняет характеристики производительности вашего ИИ-агента.
Понимание налога на контекст и причины деградации агентов со временем
Деградация агентов в производственной среде удивительно предсказуема. Она происходит не потому, что базовая модель разучилась рассуждать, а потому, что мы перегружаем активное окно контекста модели когнитивным шумом. Когда вы заставляете ИИ перебирать горы несвязанной процедурной документации при каждом обращении пользователя, одновременно происходит несколько вещей:
- Потребление токенов резко растёт, напрямую увеличивая стоимость инференса на каждый запрос.
- Задержка ответа возрастает, потому что большие контексты требуют больше времени на обработку.
- Вероятность галлюцинаций растёт, поскольку модели трудно взвешивать противоречивые или нерелевантные инструкции.
- Согласованность рассуждений падает, потому что внимание модели распыляется между слишком большим количеством конкурирующих директив.
Система не стала менее умной; её путь рассуждений просто завяз в ненужных данных. Чтобы решить эту проблему, нужно внимательно посмотреть на то, как мы распределяем информацию внутри наших архитектур.
Постоянные инструкции против ситуативной экспертизы
Один из самых мощных сдвигов мышления, который вы можете сделать в современной разработке ИИ, — это разделение системных инструкций на две различные категории: постоянные инструкции (always-on guidance) и ситуативную экспертизу (situational expertise).
Постоянные инструкции включают универсальные ограничения и маркеры идентичности, которые должны применяться к каждому взаимодействию независимо от намерения пользователя. Сюда входят:
- Идентичность агента, персона и тон общения
- Универсальные требования корпоративной безопасности
- Базовые правила комплаенса и абсолютные границы
- Стандартные предпочтения по форматированию и выводу
Ситуативная экспертиза, напротив, полностью контекстуальна. Это информация, которая становится ценной только тогда, когда запускается конкретный сценарий или рабочий процесс. Примеры включают процедуры онбординга поставщиков, правила расчёта налогов, региональные политики возврата или сложные процедуры реагирования на ИТ-инциденты.
В устаревших архитектурах обе категории сваливаются в один громоздкий промпт. В современной, перестроенной архитектуре постоянно загруженной остается только общая постоянная инструкция. Все остальное упаковывается в модульные компоненты, которые загружаются динамически.
Анатомия Skill: упаковка знаний для ИИ
Чтобы устранить Context Tax, нам нужен механизм, который хранит ситуативную экспертизу вне основного промпта и подгружает ее только тогда, когда это необходимо. Таким механизмом и является AI Skill. Skill — это не просто фрагмент промпта, а комплексный, пригодный для повторного использования пакет инструкций и ресурсов для конкретной задачи. Хорошо спроектированный Skill обычно включает:
- Четкие описания триггеров, которые сообщают оркестратору, когда Skill релевантен
- Структурированные процедурные инструкции для выполнения задачи
- Справочные документы, формы или шаблоны политик
- Необязательные скрипты или определения API для выполнения действий
В центре этого пакета находится основной конфигурационный файл, часто оформленный как файл SKILL.md. В нем описываются точная область применения, назначение и шаги выполнения для данной предметной области знаний. Модуляризируя знания таким образом, вы создаете чистые, поддерживаемые единицы корпоративных возможностей, которые можно обновлять независимо, не рискуя стабильностью основного агента.
Установление четких границ рассуждений
Разбиение ИИ-агента на отдельные Skills дает не только экономию токенов, но и строгие границы рассуждений. Когда модели дается монолитный промпт, она пытается решать любую задачу, одновременно руководствуясь всеми правилами. Когда вы используете Skills, вы изолируете предметную область рассуждений.
Например, когда пользователь запускает процесс закупки, загружается Skill для закупок, и механизм рассуждений агента полностью сосредотачивается на политиках закупок, иерархиях согласования и рекомендациях по поставщикам. Пока этот Skill активен, нерелевантные правила, касающиеся налоговых вычетов или политик управления персоналом, остаются за пределами активного окна контекста. Такая строгая граница заметно повышает и точность, и согласованность результатов ИИ, гарантируя, что он следует специализированным процедурам без влияния других частей бизнеса.
Внедрение постепенного раскрытия для эффективности
Как управлять этими Skills, не перегружая систему? Ответ дает паттерн проектирования, известный как постепенное раскрытие (progressive disclosure). Вместо загрузки всех инструкций и рабочих процессов при старте агент хранит облегченный каталог, в котором есть только названия и описания доступных Skills.
Когда пользователь отправляет запрос, рабочий процесс следует точной последовательности:
- Оркестратор сопоставляет запрос пользователя с облегченным каталогом Skills.
- Он определяет конкретный Skill, необходимый для обработки сценария.
- Система динамически загружает этот единственный Skill в окно контекста.
- Агент выполняет задачу с высокой точностью.
- После завершения задачи Skill выгружается, и агент возвращается в свое облегченное базовое состояние.
Этот паттерн существенно снижает требования к вычислениям, сокращает задержки и держит операционные расходы под контролем, одновременно обеспечивая доступ агентов к глубоким специализированным корпоративным знаниям.
Заключение: перестройка архитектуры ИИ на будущее
Монолитные промпты хорошо послужили в ранние дни экспериментов с генеративным ИИ, но корпоративным внедрениям нужны большая масштабируемость, меньшие задержки и более высокая надежность. Отделяя постоянно действующие инструкции от ситуативной экспертизы и переходя к модульным Skills через постепенное раскрытие, вы сможете устранить Context Tax, предотвратить деградацию агентов и построить надежные ИИ-системы, которые масштабируются вместе с вашей организацией.
Чтобы услышать полный разбор этих архитектурных паттернов, примеры реальных внедрений и то, как эти концепции применяются на платформах вроде Microsoft Copilot Studio, GitHub Copilot и Claude Code, обязательно посмотрите наш связанный эпизод: The End of AI Bloat: Why Modern Agents Need Skills. Слушайте, подписывайтесь и расскажите, как вы структурируете корпоративных ИИ-агентов!