 RU
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Українська
 العربية
 עברית
 日本語
 한국어
Управление данными в lakehouse Microsoft Fabric: архитектура без бессонных ночей
By Mirko Peters · · Updated
Управление данными в архитектуре lakehouse в Microsoft Fabric без бессонных ночей. Упростите аналитику с помощью надёжного и управляемого решения.
Automatically translated with AI from the original post. Read the English original
Знакомый момент: на совещании кто-то спрашивает: «Можем ли мы доказать, откуда взялась эта цифра?», и в комнате повисает тишина. Я видел, как эта тишина затягивалась в компаниях, где было «всё об данных», но не было никаких подтверждений. Lakehouse обещает одну платформу для всего: структурированные таблицы, неупорядоченные файлы, потоки в реальном времени, признаки для ML. Но это обещание работает только тогда, когда вы можете управлять всем этим, не связывая по рукам и ногам свои команды. В этой статье я во многом опираюсь на исследование Stallion Journal от октября 2024 года «Data Governance in Lakehouse» (Shah & Jain), а затем добавляю человеческий слой: соблазнительные短ные пути, политические трения, с которыми вы столкнётесь, и простые привычки, которые помогут не впадать в панику из-за аудита.
8 неожиданных фактов о governance в lakehouse Microsoft Fabric- Единое управление для всех артефактов: управление в Fabric единообразно применяется к таблицам и файлам lakehouse, блокнотам, конвейерам и дашбордам, что позволяет задавать централизованные политики, охватывающие как данные, так и аналитические артефакты.
- Автоматическое отслеживание происхождения: происхождение данных (lineage) фиксируется автоматически для многих операций (загрузка, преобразования, блокноты и дашборды), обеспечивая видимость происхождения данных почти в реальном времени без дополнительной настройки.
- Интеграция безопасности на уровне строк и столбцов: lakehouse поддерживает детализированное управление доступом (на уровне строк и столбцов), которое применяется во время выполнения запроса, поэтому управляемый доступ следует за данными независимо от движка, которым они используются.
- Встроенная классификация данных и метки конфиденциальности: Fabric показывает классификацию данных (типы конфиденциальной информации) и интегрируется с метками конфиденциальности Microsoft Purview, чтобы управление могло использовать обнаруженные классификации для применения политик.
- Policy-as-code для контроля жизненного цикла: политики управления (хранение, контрольные проверки качества, шифрование, допустимые вычислительные ресурсы) можно описывать и применять программно, что обеспечивает автоматическое соблюдение правил на всём протяжении жизненного цикла lakehouse.
- Надёжная изоляция клиента и рабочих областей: модель управления Fabric поддерживает изоляцию нескольких рабочих областей и политики с учётом клиента, поэтому вы можете ограничить совместное использование и перемещение данных между проектами, сохраняя при этом управляемое сотрудничество.
- Аудируемые журналы изменений и доступа: все операции, важные для управления (чтение и запись данных, изменения политик, назначения ролей), можно проверить по журналам аудита; эти журналы интегрируются с Microsoft Sentinel и SIEM-системами для мониторинга соответствия требованиям.
- Контракты данных с поддержкой управления: Fabric позволяет создавать контракты данных и схемы с обязательными проверками совместимости, поэтому потребители получают стабильные управляемые интерфейсы к данным lakehouse, а производители могут безопасно развивать свои решения.
1) Проблема «тихого совещания»: зачем lakehouse нужно управление
Вы на совещании руководства. На экране мигает KPI: удержание выручки, время ожидания пациентов, риск оттока. Кто-то спрашивает: «Откуда взялась эта цифра?» В комнате тишина. Вы не можете проследить набор данных, преобразование или то, кто на прошлой неделе менял логику. В этот момент у вас проблема не в аналитике, а в доверии к данным.
Lakehouse простыми словами: одна крыша, два обещания
Lakehouse — это практичное сочетание: гибкость озера данных (хранить всё, быстро) и надёжность хранилища данных (согласованные таблицы, высокая производительность). Под одной крышей вы можете управлять структурированными и неструктурированными данными, выполнять аналитику в реальном времени и поддерживать нагрузки машинного обучения. Именно эта ценность «всё в одном» и объясняет, почему стратегия архитектуры lakehouse должна включать управление с первого дня.
Почему lakehouse усиливает потребности в управлении данными
Lakehouse быстро меняется: потоковые данные, частое переобучение моделей и множество команд, которые одновременно публикуют дашборды. Эта скорость умножает риски. Разные типы данных и множество инструментов делают легко потерять из виду определения, разрешения и происхождение данных. Когда вы не можете объяснить метрику, заинтересованные стороны перестают доверять дашборду, даже если цифра верна.
- Данные в реальном времени повышают вероятность несогласованных снимков и KPI, которые «движутся» на ходу.
- Конвейеры ML добавляют новые объекты для управления: признаки, обучающие наборы, результаты моделей и сигналы дрейфа.
- Больше пользователей (аналитики, специалисты по данным, продуктовые команды) означает больше путей доступа — и больше способов нарушить политику.
Управление данными — это не бумажная волокита, а способ безопасно выпускать результаты
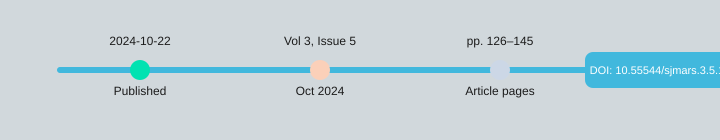
Рецензируемое исследование «Data Governance in Lakehouse» из журнала Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), опубликованное 22-10-2024 в Volume 3, Issue 5 (стр. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), рассматривает управление данными как стратегическую необходимость и операционное требование. Главная мысль проста: управление защищает вас в вопросах соответствия требованиям (GDPR, HIPAA, CCPA), снижает риски и поддерживает качество данных и доверие заинтересованных сторон.
Samarth Shah: «В lakehouse скорость без управления — это не гибкость, а просто более быстрая путаница».
На практике управление данными в lakehouse означает, что вы можете ответить на вопрос «что это за KPI?», опираясь на доказательства: метаданные, записи каталога, средства контроля доступа (например, RBAC), журналы аудита и lineage. Это не бюрократия. Это система, которая позволяет быстро выпускать аналитику, не нарушая законов и не теряя доверия.
| Элемент метаданных | Значение |
|---|---|
| Дата публикации | 22-10-2024 |
| Выпуск журнала | Volume 3, Issue 5 (октябрь 2024) |
| Страницы | 126–145 |
| ISSN | 2583-3340 |
2) Как выглядит «хорошее управление», когда данные повсюду
В lakehouse ваши данные не находятся «в одном месте». Они распределены по таблицам, файлам, потокам и признакам для ML, часто на платформах AWS, Snowflake или Databricks. Хорошее управление — это способ сохранить данные пригодными для использования и безопасными, не замедляя команды. Думайте об этом как о ограждениях, а не шлагбаумах: вы обеспечиваете аналитику в реальном времени и одновременно соблюдаете требования GDPR, HIPAA и CCPA.
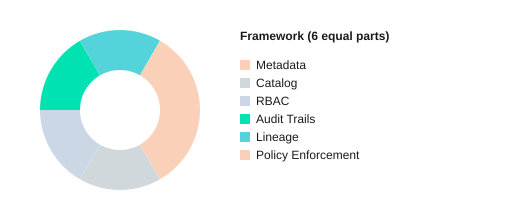
6 строительных блоков, которые вы действительно будете внедрять
- Управление на основе метаданных: определите владельцев, уровни конфиденциальности, сроки хранения и правила качества в метаданных, чтобы контроль масштабировался вместе с объёмом и изменениями.
- Лучшие практики каталога данных: одно место для поиска определений, тегов и проверенных наборов данных, чтобы люди перестали гадать.
- Контроль доступа RBAC: роли соответствуют рабочим задачам (аналитик, инженер, врач), а не разовым разрешениям.
- Отслеживание lineage данных: показывает, откуда пришли данные, как они менялись и что на них опирается.
- Журналы аудита: кто и к чему получил доступ, когда и что сделал — критично для расследований и проверок.
- Принудительное применение политик: автоматические проверки (маскирование, хранение, согласования), которые работают по умолчанию, а не по запросу.
Задокументированное и принудительное управление (предотвращает инциденты только второе)
Задокументированное управление — это страница вики, где написано «PII必须маскировать». Принудительное управление — это когда ваш lakehouse автоматически маскирует PII на основе тегов в метаданных, блокирует рискованные экспорты и записывает доступ в журналы аудита. Исследования современного управления в lakehouse показывают, что автоматизация и метаданные сокращают время ручного контроля и количество ошибок, поскольку платформа применяет правила единообразно.
Единое управление, когда вы работаете с таблицами, файлами, потоками и признаками
Нужна единая плоскость управления, которая работает с пакетными таблицами, файлами в объектном хранилище, потоками в стиле Kafka и наборами признаков для ML. Когда управление унифицировано, одни и те же RBAC, теги и политики следуют за данными, поэтому ваши дашборды, блокноты и модели остаются согласованными и соответствующими требованиям.
Небольшое отступление: как один общий набор данных превращается в 12 версий
Без отслеживания lineage данных набор «customer» копируют в customer_v2, customer_clean, customer_final и «final_final». Вскоре команды спорят о цифрах, потому что никто не может доказать, какая версия питала какой отчёт.
Shubham Jain: «Lineage отличает «я думаю» от «я могу доказать», когда кто-то ставит под сомнение ваши цифры».
Самопроверка за 5 минут
- Можете ли вы найти владельца и тег конфиденциальности для ваших 10 основных наборов данных в каталоге?
- Управляют ли роли (а не отдельные люди) доступом через RBAC?
- Можете ли вы проследить KPI до источников с помощью lineage меньше чем за 2 минуты?
- Отвечают ли сегодня журналы аудита на вопрос «кто просматривал или экспортировал это»?
- Применяются ли политики автоматически (маскирование, хранение, согласования), а не вручную?
Каждый механизм контроля связан с результатом: меньше инцидентов с доступом (RBAC и политики), быстрее аудиты (журналы аудита и каталог), чище аналитика (метаданные и lineage).
3) Цифры, которые делают управление менее похожим на «накладные расходы»
Если governance кажется «лишним процессом», результаты исследования помогут переосмыслить его как измеримую операционную выгоду. Когда вы применяете metadata-driven governance с автоматизацией и ML в lakehouse, вы не просто «добавляете контроли» — вы возвращаете время, повышаете доверие к данным и снижаете комplaенс-риски так, что их может отслеживать финансовый директор.
Metadata-driven governance: ROI, который можно вынести на слайд
Исследование называет три главных результата, когда команды опираются на сильные метаданные, каталогизацию, lineage и контроль доступа:
- До 40% повышение эффективности governance
- 35% рост качества данных
- 92% достижение соответствия GDPR и HIPAA (GDPR/HIPAA)
На практике прирост эффективности в 40% часто означает меньше ручных проверок, меньше циклов вида «кто владеет этим набором данных?» и более быстрые согласования доступа и обмена данными. Backlog сокращается, потому что рутинные проверки переходят от людей к системам, а очередь инцидентов уменьшается, поскольку до продакшена доходит меньше проблем.
Автоматизированное применение политик: сравнение «до» и «после», которое меняет разговор
Самое наглядное доказательство соотношения «затраты и отдача» — переход от ручных контролей к автоматизированному применению политик:
- Время применения политик: 72% → 28%
- Частота ошибок: 45% → 15%
Это не небольшая оптимизация. Разница в том, будет ли governance воротами или ограждением. Вы тратите меньше времени на разбор исключений и больше — на безопасное самообслуживание.
«Единый governance приживается только тогда, когда рабочий процесс проще обходного пути.» —Taylor, Singh, & Green (2021)
Реальность внедрения: хорошо для технических пользователей, сложнее для остальных
Оценки удобства были высокими среди data scientists, бизнес-аналитиков и ИT-администраторов (4,2–4,7 из 5). Однако в статье также отмечен типичный разрыв: нетехническим пользователям нужны более простые интерфейсы, более понятные определения и управляемые сценарии работы. Если вы хотите получить указанные выше показатели, закладывайте бюджет на обучение и поддержку, а не только на инструменты.
Ключевые показатели в одном взгляде
| Показатель | Результат |
|---|---|
| Повышение эффективности governance | До 40% |
| Рост качества данных | 35% |
| Уровень соответствия GDPR и HIPAA | 92% |
| Время применения политик | 72% (вручную) и 28% (автоматически) |
| Частота ошибок | 45% (вручную) и 15% (автоматически) |
| Оценка удобства | 4,2–4,7 из 5 |
| Сокращение времени обработки | 25% |
4) Инструменты, прототипы и непростая правда о внедрении
Что на самом деле делало исследование
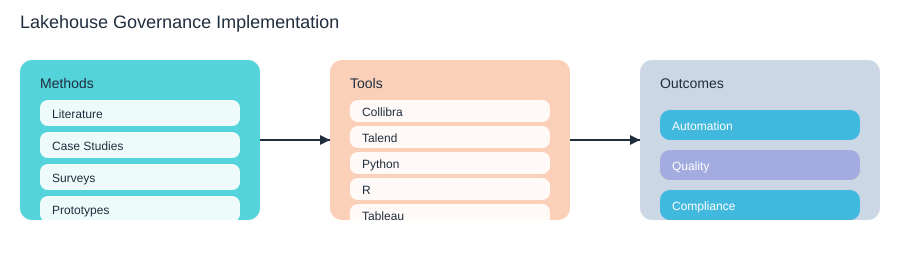
Исследование в Stallion Journal рассматривало governance не как проблему для презентации. Оно использовало четыре метода, которые вы узнаете из реальной работы: оно изучало литературу (систематические обзоры), анализировало отраслевые кейсы, опрашивало заинтересованные стороны и затем тестировало прототипы. Последний пункт важен, потому что governance в lakehouse ломается в зазорах между политикой и пайплайнами, особенно когда данные поступают быстро, часто меняются и приходят от множества команд.
Стек прототипов: что именно пробовали
В экспериментах исследование использовало Collibra и Talend для governance и шаблонов интеграции, а также аналитические инструменты (Python, R, Tableau) для проверки удобства и результатов. Этот подход можно повторить, будь то Databricks governance, настройка Snowflake lakehouse или более широкий cloud-native data governance с Kubernetes, Docker, Kafka, Postgres, PySpark и Elasticsearch.
Путь внедрения, который можно повторить (и не сойти с ума)
Успех внедрения зависит от governance, поддержанного инструментами, и от вашей способности справляться со скоростью, сложностью и ограничениями ресурсов. Практическая последовательность такая:
- Начните с каталога и RBAC: примените лучшие практики каталогизации данных (понятное владение, бизнес-термины и «золотые» наборы данных). Затем сопоставьте доступ через RBAC.
- Добавьте lineage: отслеживайте влияние upstream и downstream, чтобы изменения не заставали врасплох аналитиков и аудиторов.
- Автоматизируйте применение политик: там, где это возможно, переходите от ручных согласований к policy-as-code с журналами аудита.
Harris & Nguyen (2020): «RBAC в теории прост; на практике он становится реальным в тот день, когда вы сопоставляете его с командами, а не с должностями.»
Ваш ежедневный враг: скорость и нестабильные потоки данных
Потоки с высокой скоростью поступления данных (например, потоки в стиле Kafka) порождают «дрейф схемы», запоздалые события и дублирующиеся записи. Именно здесь управление данными становится запутанным: каталог говорит, что поле обязательно, а поток его не передаёт; правила качества ожидают одну временную метку, а производители присылают три. По данным исследования, это повторяющееся препятствие, особенно когда команды недостаточно укомплектованы.
Разрастание инструментов: когда системы расходятся
Остерегайтесь классической проблемы «расщеплённого мозга»: каталог показывает, что набор данных A имеет статус «ограниченный», но группы IAM по-прежнему разрешают широкий доступ. Или политики управления в Databricks не совпадают с настройками в облачном IAM. Считайте «единый источник истины» целью проектирования, а не лозунгом.
| Призма принятия решений | Держите всё просто |
|---|---|
| Купить или построить | Покупайте решение для каталога и рабочих процессов; разрабатывайте только тонкие коннекторы и проверки. |
| Избегайте лабиринта управления | Один каталог, одна модель политик, минимум пользовательских ролей и автоматический аудит. |
5) Главные болевые точки управления данными и порядок их устранения
Если вам кажется, что управление данными сложнее, чем «должно» быть, вы не одиноки. По результатам обобщения исследований, 78% организаций называют проблему управления метаданными главной болевой точкой. Эта статистика должна вас успокоить: в лейкхаусе всё движется быстро, а метаданные — это карта, которую вы пытаетесь обновлять, пока дороги ещё строятся.
Почему метаданные ломаются первыми (и продолжают ломаться)
Метаданные сложно поддерживать, потому что:
- Определения расходятся: «активный клиент» означает одно для финансистов и другое для отдела роста.
- Владение размыто: никто точно не знает, кто утверждает новое поле, новую таблицу или новое правило хранения.
- Конвейеры меняются каждую неделю: новые источники, новые соединения, новые признаки для ML — каталог и теги отстают.
И всё же инвестиции в управление данными приносят измеримую отдачу: 88% отмечают улучшение управления качеством данных, а 81% — улучшение управления безопасностью лейкхауса. Такова отдача от этой неброской, но важной работы.
Приоритизация управления: исправляйте нужное в нужном порядке
- Сначала метаданные и владение: определите критически важные элементы данных, назначьте владельца данных и хранителя, стандартизируйте бизнес-термины в каталоге.
- Далее контроль доступа: внедрите RBAC по принципу наименьших привилегий и чёткие процедуры согласования исключений.
- Происхождение данных и журналы аудита: отслеживайте, откуда пришли данные, как они менялись и кто с ними работал. Именно это позволяет быстро ответить на вопросы по GDPR, HIPAA и CCPA.
- Автоматизация в последнюю очередь (но постоянно): автоматизируйте проверки политик, тегирование и обнаружение аномалий, чтобы соблюдение правил не зависело от героических усилий.
Что ломается, когда HIPAA встречается с CCPA?
Представьте лейкхаус, где набор медицинских данных, регулируемый HIPAA (случаи обращения пациентов), объединяется с набором маркетинговых данных, подпадающим под CCPA (поведение в вебе). Первым обычно ломается классификация и согласие: теги PHI отсутствуют, флаги согласия не передаются через соединения, а итоговый дашборд раскрывает больше, чем предполагалось. Без происхождения данных вы не докажете, куда они попали; без RBAC вы не сможете ограничить широкий доступ; без журналов аудита и управления идентификацией вы не покажете подотчётность.
«Настоящая задача не в том, чтобы заставить ИИ работать, а в том, чтобы заставить его работать ответственно в уже существующих системах».
— д-р Фей-Фей Ли
Простой ритуал, который помогает сохранять здравомыслие: ежемесячная ретроспектива по управлению данными
Проводите 45-минутную ежемесячную ретроспективу с представителями ИТ, безопасности и бизнеса. Разберите: три главных пробела в метаданных, три главных исключения в доступе, один сбой происхождения данных и одну победу в автоматизации. Фиксируйте действия в общем трекере и назначайте одного ответственного на каждый пункт.
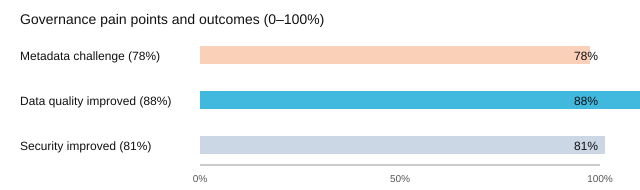
6) Соответствие без паранойи: GDPR, HIPAA, CCPA в лейкхаусе
В лейкхаусе относитесь к соответствию требованиям как к ограничению проектирования, а не как к спешной работе в последний момент. Когда вы встраиваете средства контроля в приём данных, хранение и доступ с самого начала, соответствие GDPR и HIPAA и управление данными по CCPA перестают быть авральной работой и становятся обычной эксплуатацией. Исследование Stallion Journal «Data Governance in Lakehouse» показывает, почему: организации, использующие управление на основе метаданных, автоматизацию и ML, сообщали о росте уровня соответствия до 92% для GDPR и HIPAA. Используйте это как ориентир «северной звезды», а не как гарантию.
«Безопасность — это процесс, а не продукт, и управление — это то, как вы сохраняете этот процесс честным».
— Брюс Шнайер
Сопоставьте средства контроля с нормативами: ваш базовый инструментарий соответствия
Одни только политики не делают вас соответствующими GDPR или HIPAA. Нужно сопоставить требования с повторяемыми средствами контроля внутри lakehouse:
- RBAC (контроль доступа на основе ролей): ограничьте, кто может видеть PHI/PII и кто может их экспортировать.
- Аудит-трейлы lakehouse: докажите, кто, к чему, когда, откуда получил доступ и что он с этим сделал.
- Линейдж данных: покажите, откуда появились чувствительные поля, как они менялись и куда попали.
- Применение политик: последовательно применяйте маскирование, хранение и ограничения по целям использования во всех инструментах.
- Управление метаданными и каталог: классифицируйте данные, присваивайте метки конфиденциальности и запускайте автоматизацию.
| Регулятор | Что проверяют аудиторы | Средство контроля в lakehouse |
|---|---|---|
| GDPR | Законность доступа, минимизация, хранение | RBAC, маскирование, политики хранения, линейдж |
| HIPAA | Журналы доступа, защитные меры, принцип наименьших привилегий | Аудит-трейлы, RBAC, шифрование, мониторинг |
| CCPA | Инвентаризация данных, обработка запросов на доступ и удаление | Каталог и метаданные, линейдж, рабочие процессы политик |
Следующая волна: региональные правила и устаревшие ограничения
В статье отмечены направления, к которым стоит готовиться уже сейчас: соответствие региональным требованиям и лучшая адаптация к устаревшим или ограниченным средам. Если вы работаете в нескольких штатах или странах, стройте политики, которые могут различаться по регионам (сроки хранения, правила согласия, уведомления о нарушениях). Если вы всё ещё используете старые системы, начните с меньшего объёма и интегрируйте постепенно: автоматизация помогает, но сложность реальна.
«День аудита»: что нужно будет показать
- Инвентаризация данных: где хранятся PII/PHI, кто владельцы и для чего они используются (
catalog + tags). - Доказательства доступа: роли RBAC, согласования и выгрузки аудит-трейлов lakehouse.
- Подтверждение линейджа: пути от источника до отчёта для ключевых наборов данных и чувствительных столбцов.
- Подтверждение политик: маскирование, хранение, процессы удаления и журналы применения политик.
- Участники: владелец данных, специалист по безопасности, администратор платформы, сотрудник по соответствию требованиям или юрист и один аналитик, который работает с данными.
Обзор радара: базовый уровень и управляемый lakehouse
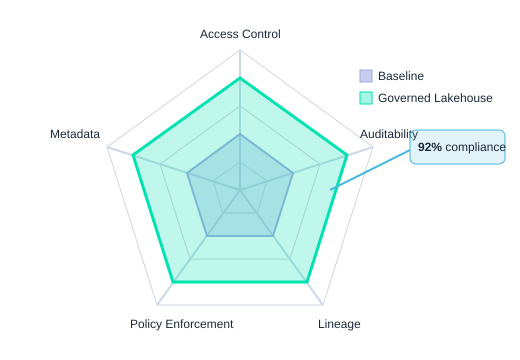
Небольшое, но честное отступление: если вы работаете в небольшой организации, начните с простой базовой конфигурации — RBAC, логирование и облегчённый каталог — прежде чем покупать корпоративные инструменты. Исследование ясно показывает, что сложность внедрения может быть серьёзным барьером, особенно когда ресурсы ограничены.
7) Предвзятость поставщиков, политика и то, о чём умалчивают презентации по управлению данными
Можно на бумаге разработать чистую модель управления lakehouse, а потом наблюдать, как она искажается, как только в дело вступают инструменты управления данными. Неприятная правда проста: инструменты и поставщики определяют, как выглядит «лучшая практика», потому что они определяют, что легко показать, легко купить и легко отчитаться.
В разделе о конфликте интересов исследования Stallion Journal по lakehouse это прямо отмечено. В нём выделены три источника предвзятости, которые стоит считать присутствующими в любой программе управления: предвзятость в пользу поставщика (предпочтение платформам, таким как стеки Collibra Talend governance, или другим коммерческим комплексам), организационная предвзятость отчётности (передача только «успешных» метрик) и финансовое и нормативное давление (выбор того, что выглядит самым безопасным для аудиторов, а не того, что подходит вашей архитектуре). Вывод исследования однозначен: прозрачность и раскрытие информации необходимы для сохранения научной добросовестности и делают ваши решения по управлению полезными за пределами маркетинговых историй поставщиков.
Сатья Наделла: «Доверие — главная валюта, и в работе с данными вы его зарабатываете, четко объясняя, что сделали и почему».
Риски предвзятости, которые нужно назвать вслух
Исследования управления и инструментов: риски предвзятости. Предвзятость поставщика 40%. Предвзятость отчётности 35%. Финансовое и нормативное давление 25%. Предвзятость поставщика, Предвзятость отчётности, Финансовое и нормативное давление
Ваш чек-лист против предвзятости (практичный, а не политический)
- Выборка: сравните хотя бы один коммерческий комплекс и одно открытое решение в экосистемах AWS, Snowflake, Databricks, SAP и Oracle Cloud Infrastructure.
- Раскрытие информации: документируйте спонсоров, причины выбора инструментов и то, что вы не тестировали.
- Критерии оценки: глубина линейджа, соответствие RBAC/ABAC, аудит-трейлы, доступ по API, форматы экспорта и интеграция с таблицами вашего lakehouse.
- Доказательство ценности: проведите ограниченный по времени пилот в одном домене; измеряйте время применения политик, частоту ошибок и неудобства для пользователей.
- Проверка рисков привязки к платформе данных: спросите, как привязка к поставщику проявляется в метаданных, каталогах и правилах рабочих процессов.
Короткая история: вы влияете на реальное решение
Закупки выступают за одного поставщика ради «стандартизации». Инженеры хотят открытый код для контроля. Комплаенс требует «сертифицированных» функций и понятных аудиторских доказательств. Ваша задача — перевести эти требования на общий язык: можно обеспечить соответствие требованиям с помощью жёстких мер контроля и журналов аудита, удовлетворить инженеров API и переносимостью, а закупки — понятной окупаемостью, не позволяя ни одной группе определять управление как «то, что продаёт инструмент».
Что, если ваш инструмент купят и цены вырастут втрое?
Считайте, что такое может случиться. Проверьте переносимость прямо сейчас: сможете ли вы экспортировать бизнес-глоссарий, происхождение данных (lineage) и правила политик в пригодных для использования форматах? Если ваши метаданные нельзя перенести, управление данными — это не программа, а подписка.
8) Перспективная готовность: IoT, периферийные вычисления, децентрализованные данные и lakehouse, который вам достанется в наследство
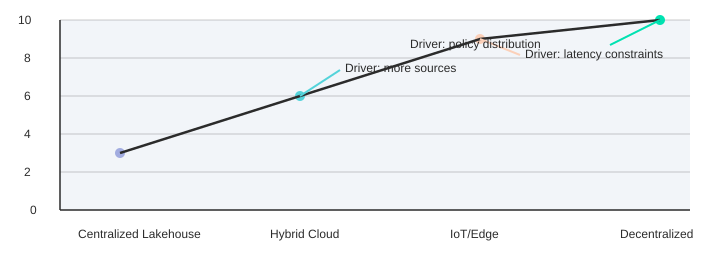
Управление вашим lakehouse работает лучше всего, когда данные в основном централизованы, ориентированы на пакетную обработку и контролируются несколькими платформами. Управление IoT и периферийными вычислениями быстро ломает эти допущения: вы сталкиваетесь с большим числом источников (устройства, шлюзы, приложения), меньшим центральным контролем (команды развёртывают решения самостоятельно) и более жёсткими ограничениями по задержке (вы не можете «ждать ночного задания», чтобы решить вопрос доступа или качества). Исследование Stallion Journal прямо указывает на это давление и рекомендует расширить подходы к управлению для трёх новых направлений: озёр данных IoT, децентрализованных архитектур и периферийных вычислений.
Почему IoT и периферийные вычисления нагружают текущую модель
В потоках IoT одно и то же событие «клиент» может поступать от нескольких датчиков, в разных форматах и в разное время. Если ваши политики зависят от обновления одного центрального каталога, вы либо замедлите работу, либо смиритесь со слепыми зонами. Периферийные площадки также создают локальные копии данных ради скорости и отказоустойчивости, поэтому журналы аудита, происхождение данных и правила хранения должны следовать за данными, а не оставаться в одной управляющей плоскости в духе классического хранилища.
Децентрализованной архитектуре данных нужно переносимое управление
В децентрализованной архитектуре данных домены публикуют продукты данных и развивают схемы по собственному графику. Это полезно для скорости поставки, но рискованно, если определения «персональных данных», «согласия» или «области действия HIPAA» не согласованы. Перспективная готовность означает, что управление строится как общий сервис: расширяемые метаданные, версионируемые политики и средства управления идентификацией, которые работают между командами и регионами, что соответствует призыву исследования к адаптивности соблюдения региональных требований.
Опирайтесь на облачно-нативные блоки, которые можно унаследовать
Набор ссылок вокруг исследования указывает на практичные строительные блоки: Docker для упаковки сервисов политик, Kubernetes для их запуска везде, Kafka для потоковых точек применения политик, Elasticsearch для быстрого поиска и Postgres/PySpark для управляемой обработки. Вы выбираете инструменты не из моды, а из соображений того, что может работать в облаке, локально и на периферии с одинаковыми мерами контроля.
«Всё ломается, всё время — проектируйте управление, рассчитывая на изменения, а не на стабильность.» — Вернер Фогельс
Дорожная карта из небольших шагов, которая держит вас в движении
Не обязательно решать задачу управления периферией целиком уже сегодня. Но нужны системы метаданных и политик, которые можно расширять без переписывания. Начните с пилота ИИ-обнаружения аномалий по сигналам управления (дрейф схемы, необычные пути доступа, экспорт вне обычного шаблона), затем расширьте автоматические проверки политик на этапе загрузки и во время запросов. По мере роста инфраструктуры добавьте более сильное управление идентификацией, рассмотрите защиту журналов критичных аудитов от подделки по принципу блокчейна и спланируйте аварийное восстановление в соответствии с уровнем риска.
| Среда | Индекс сложности управления (иллюстративный) |
|---|---|
| Централизованный lakehouse | 3 |
| Гибридное облако | 6 |
| IoT/Edge | 9 |
| Децентрализованная | 10 |
Пишите принципы управления так, будто вас скоро заменят: понятные определения, переносимые политики и журналы решений, которые переживают реорганизации. Lakehouse, который вы унаследуете позже, будет беспорядочнее, чем сегодня, и вашему будущему «я» будет спокойнее, если вы проектируете с учётом этого уже сейчас.
microsoft fabric lakehouse architecture: понимание Microsoft Fabric для аналитики и инженерии данных
Что такое архитектура lakehouse в Microsoft Fabric?
Архитектура lakehouse в Microsoft Fabric — это единая платформа данных, которая сочетает элементы озера данных и хранилища данных. Она хранит как исходные данные, так и структурированные, преобразованные наборы данных в одном месте. Для хранения данных используется Azure Data Lake Storage, для обработки — вычислительные движки Fabric, а для управления исходным, обогащённым и курированным слоями применяются паттерны архитектуры medallion. Благодаря этому команды могут анализировать данные, выполнять задачи data science и строить отчёты в Power BI без дублирования данных.
Как работает архитектура medallion в lakehouse Fabric?
Архитектура medallion в Fabric организует данные по слоям, обычно это бронзовый (исходные данные), серебряный (очищенные и обогащённые) и золотой (курированные, готовые для аналитики и BI). Fabric объединяет инструменты приёма и преобразования данных, которые перемещают и трансформируют данные между слоями. Это поддерживает рабочие процессы инженерии и подготовки данных, позволяет хранить единственную копию данных, сокращает дублирование и при этом поддерживает аналитику и data science.
Как внедрить lakehouse в Microsoft Fabric и как его создать?
Чтобы внедрить lakehouse в Microsoft Fabric, начните с подключения источников данных и загрузки данных в Azure Data Lake с помощью возможностей приёма данных Fabric. Далее используйте вычислительные движки Fabric или трансформации через dataflow, чтобы применить обработку по архитектуре medallion, каталогизируйте наборы данных в OneLake и настройте безопасный доступ. Затем подключите Power BI и другие инструменты аналитики для построения отчётов. Платформа упрощает управление данными, поддерживает интеграцию существующих данных и больших данных, а также позволяет преобразовывать данные без лишних перемещений.
Чем lakehouse отличается от традиционного хранилища данных в Microsoft Fabric?
Lakehouse сочетает гибкость озёр данных для необработанных и полуструктурированных данных с производительностью и управлением схемами, которые характерны для хранилища данных. В Microsoft Fabric lakehouse позволяет хранить данные в Azure Data Lake Storage и при этом обеспечивает производительность запросов, сравнимую с хранилищем, благодаря вычислительным движкам Fabric. Так становятся доступны возможности хранилища данных, например курированные структурированные данные для аналитики, при сохранении гибкости озера данных для современных задач работы с данными и инженерии данных.
Как Fabric организует приём данных и избегает их дублирования?
Fabric поддерживает несколько паттернов приёма данных: потоковый, пакетный и коннекторы к корпоративным источникам данных, которые загружают данные в центральное озеро (Azure Data Lake). Используя архитектуру medallion и OneLake, Fabric опирается на единственную копию данных и логические наборы данных, а не на физические копии. Инструменты интеграции и преобразования позволяют принимать данные, трансформировать их на месте и обеспечивать единообразный доступ к данным для задач аналитики и data science, сводя к минимуму дублирование данных между системами.
Можно ли использовать существующие хранилища данных и данные Azure вместе с lakehouse Fabric?
Да. Fabric интегрируется с системами Microsoft и сторонними системами, что позволяет выполнять федеративные запросы к существующим хранилищам данных, Synapse и Azure Data Lake Storage и при этом консолидировать доступ к корпоративному ландшафту данных. Вы можете загружать существующие данные или ссылаться на них, реализовывать паттерны data mesh и выбирать, перемещать ли данные в lakehouse или обращаться к ним напрямую, в зависимости от требований к управлению, стоимости и производительности.
Какие типичные сценарии использования lakehouse Fabric в аналитике и data science?
Типичные сценарии включают единое управление данными для BI в Power BI, подготовку больших необработанных наборов данных для машинного обучения и data science, построение конвейеров ELT по архитектуре medallion, анализ данных из корпоративных систем и создание единого места хранения структурированных и неструктурированных данных. Fabric упрощает обработку данных, обеспечивает масштабируемый анализ и поддерживает современные архитектуры данных, такие как data mesh и корпоративные каталоги данных.
Как устроены безопасность, управление и доступ к данным в lakehouse Fabric?
Fabric предоставляет ролевую модель доступа (RBAC), политики данных и интеграцию с Microsoft Purview и Azure Active Directory для управления и отслеживания происхождения данных (data lineage). OneLake и конструкции lakehouse позволяют задавать детальные разрешения для данных, хранящихся в Azure Data Lake Storage. Это обеспечивает безопасный доступ к данным, соответствие требованиям и контролируемые рабочие процессы подготовки данных, а также аудит на всех этапах приёма и преобразования данных.
Какие вычислительные движки Fabric следует использовать для разных рабочих нагрузок в lakehouse?
Fabric предоставляет несколько вычислительных движков, оптимизированных под конкретные рабочие нагрузки: интерактивные SQL-запросы для аналитики и BI, Spark для обработки больших данных и инжиниринга данных, а также специализированные движки для приёма данных в реальном времени. Выбирайте вычислительные движки Fabric с учётом характера нагрузки: используйте Spark для масштабных преобразований, SQL-движок хранилища для BI-запросов и потоковые движки для непрерывной загрузки, чтобы сбалансировать стоимость, производительность и потребности в обработке данных.
Где можно узнать больше и начать работу с архитектурой lakehouse в Microsoft Fabric?
Чтобы начать, пройдите учебные материалы Microsoft Learn, изучите документацию по архитектуре lakehouse в Microsoft Fabric и разберите примеры архитектуры medallion в Fabric. Начните с подключения источника данных, загрузки исходных данных в Azure Data Lake Storage, реализации простого конвейера medallion и визуализации результатов в Power BI. Так вы поймёте, как Fabric упрощает создание lakehouse и доставку аналитики из единого структурированного слоя данных.