 UK
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 العربية
 עברית
 日本語
 한국어
Уникнення пастки розподіленого моноліту в мікросервісах .NET
By Mirko Peters ·
Коли інженерні команди переходять від монолітного застосунку до мікросервісної архітектури, їх зазвичай приваблює цілком конкретний набір обіцянок: швидша доставка функцій, незалежне масштабування, локалізована ізоляція збоїв і свобода експериментувати з сучасними технологічними стеками. Втім, багато організацій на платформі .NET упираються в стіну, і швидкість розробки різко падає. Замість гнучко
Automatically translated with AI from the original post. Read the English original
Коли інженерні команди переходять від монолітного застосунку до мікросервісної архітектури, їх зазвичай приваблює цілком конкретний набір обіцянок: швидша доставка функцій, незалежне масштабування, локалізована ізоляція збоїв і свобода експериментувати з сучасними технологічними стеками. Втім, багато організацій на платформі .NET упираються в стіну, і швидкість розробки різко падає. Замість гнучкої, слабко зв’язаної екосистеми вони отримують розподілений моноліт: архітектуру, що поєднує операційну складність розподілених систем із щільною зв’язаністю традиційного моноліту.
Така проблема рідко виникає навмисно. Зазвичай вона непомітно прокрадається через тонкі архітектурні рішення: спільна база даних для кількох сервісів, надмірна залежність від синхронних HTTP-викликів або перетворення управління API на адміністративне вузьке місце. У цій публікації ми розглянемо ознаки пастки розподіленого моноліту, виявимо приховані проблеми продуктивності на мережевому рівні, знайдемо архітектурні вузькі місця за допомогою сучасних інструментів спостережуваності та пройдемо через практичні стратегії, які допоможуть повернути незалежне масштабування ваших мікросервісів .NET. Якщо ваша команда відчула, як сповільнюється доставка, ви не одні з такою проблемою, а розуміння цих патернів — перший крок до відновлення гнучкості.
Архітектура мікросервісів: прихована складність
Розподілені монолiти
Ознаки
Можна подумати, що розбиття застосунку на мікросервіси автоматично вирішить проблеми з продуктивністю. Втім, ви легко можете отримати розподілений моноліт. Це відбувається тоді, коли сервіси залежать один від одного настільки сильно, що ви втрачаєте справжні переваги розділення. Ви можете помітити такі типові ознаки:
- Сервіси покладаються на синхронні виклики для кожної стандартної бізнес-операції.
- Команді важко розгорнути окремі зміни, не ризикуючи простоєм або порушенням роботи залежних сервісів.
- Спільні бази даних змушують тісно узгоджувати зміни схеми між кількома окремими командами розробки.
- Компоненти залишаються щільно зв’язаними, хоча фізично працюють у різних процесах або контейнерах.
Вплив на швидкодію
Розподілений моноліт може уповільнювати систему у спосіб, якого ви спочатку не очікуєте. Затримка мережі зростатиме, адже кожен виклик між сервісами додає затримку. На відміну від монолітного застосунку, де виклики миттєво відбуваються в пам’яті, мікросервісна архітектура переносить вузькі місця продуктивності з бази даних або ЦП на мережевий рівень. Синхронні виклики між мікросервісами накопичують затримку, тоді як монолit обробляє такі виклики всередині процесу. Як наслідок, ви втрачаєте можливість незалежно масштабувати сервіси та ефективно ізолювати збої, а проблеми з продуктивністю посилюються разом із зростанням дерева залежностей.
Коли ви намагаєтеся розподілити монолітний застосунок без належного проєктування меж, ви часто стикаєтеся з серйозними проблемами продуктивності. Компоненти залишаються сильно залежними один від одного, і ви не отримуєте переваг незалежного масштабування чи ізоляції збоїв, які дають добре структуровані мікросервіси.
Накладні витрати на координацію
Управління API
Архітектура мікросервісів вимагає сильного управління API. Потрібно переглядати й затверджувати кожну зміну, щоб уникнути накопичення технічного боргу та дублювання зусиль. Якщо управління надто жорстке, розробка гальмує майже до повної зупинки. Якщо ж воно надто лояльне, ви ризикуєте майже миттєво накопичити структурний технічний борг.
Коли управління є або надто лояльним, або надто жорстким, це може призвести до технічного боргу, дублювання зусиль і суттєвого уповільнення процесу розробки.
По суті, ви дуже швидко нарощуєте величезний технічний борг. І зрештою доводиться витрачати більше грошей і часу на те, щоб усе це демонтувати й почати знову.
Модель управління потрібно проєктувати так, щоб вона активно працювала на розробників. Автоматизація допомагає покращувати якість, безпеку й узгодженість API без зайвого адміністративного тягаря.
Коли управління розробляється з урахуванням інтересів розробників і підкріплюється автоматизацією, воно стає каталізатором для підвищення якості, безпеки та узгодженості API.
API відіграють критичну роль у вашій ширшій бізнес-стратегії. До них потрібно ставитися як до елементів першого класу.
У останньому звіті про стан інтеграції API 84 відсотки компаній заявили, що API мають критичне або дуже критичне значення для їхньої основної бізнес-стратегії.
Командна співпраця
Мікросервіси потребують постійної координації між командами. Ви витрачаєте години на підготовку до нарад, перемикання контексту між доменами та уточнення ролей між командами. Ці дії легко можуть поглинути значну частину вашого робочого тижня.
| Фактори вартості координації | Опис |
|---|---|
| Затримка рішень | Затримки через численних зацікавлених сторін і громіздкі ланцюжки погоджень |
| Перемикання контексту | Розпорошена увага через численні міжфункційні точки координації |
| Втрата інформації | Втрата або спотворення критично важливих знань через організаційні рівні |
| Неоднозначність ролей | Нечітка відповідальність призводить до прогалин і дублювання зусиль розробки |
| Діяльність з координації | Витрачений час |
|---|---|
| Підготовка до нарад | Понад 8 годин на тиждень |
| Заходи координації | 35–80% робочого часу спеціалістів з знань |
Ви маєте усвідомлювати, що накладні витрати на координацію можуть непомітно підірвати швидкість поставки. Чіткі межі відповідальності та налагоджені канали комунікації є обов’язковими, щоб уникнути прогалин і дублювання зусиль.
Виклики екосистеми .NET
Платформна інженерія
Архітектура мікросервісів в екосистемі .NET створює специфічні інженерні виклики. Ви часто стикаєтеся з дублюванням коду та надмірністю, що збільшує витрати на супровід і ризик неузгодженості даних. Розробники часто мають справу з надмірною кількістю шаблонного коду лише для того, щоб запустити інфраструктуру. Організація вихідного коду стає надзвичайно складною, якщо доменні моделі неправильно використовуються спільно між сервісами. Антишаблони «копіювати й вставити» затримують виправлення помилок і суттєво ускладнюють довгострокову підтримку.
- Дублювання коду призводить до вищих постійних витрат на супровід.
- Спільні моделі між сервісами роблять оновлення схеми небезпечними.
- Розробники можуть копіювати й вставляти логіку сервісів, що уповільнює критичні виправлення помилок.
Межі доменів
Під час створення мікросервісів у .NET ви маєте чітко визначити межі доменів. Якщо цього не зробити, суттєво зросте когнітивне навантаження на розробників. Надто багато одночасних архітектурних вимог перевантажують вашу команду. Дотримання стандартів і відповідності вимогам стає складним, що може спричинити проблеми з надійністю та послабити загальний рівень безпеки.
- Когнітивне навантаження різко зростає, коли розробники жонглюють кількома взаємопов’язаними сервісами.
- Стандарти та корпоративна відповідність вимогам стає важче послідовно забезпечувати.
- Надійність і безпека страждають, коли межі доменів визначено погано.
Хоча архітектура мікросервісів має переконливі переваги, ви маєте проактивно враховувати її приховану складність. Стежте за ознаками розподіленого монолiту, керуйте накладними витратами на координацію та рішуче вирішуйте специфічні для .NET платформні виклики.
Бомба із затримкою: проблеми продуктивності
Можна припустити, що мікросервіси автоматично прискорять систему, але без ретельного проєктування вони можуть стати бомбою із затримкою для вашої інфраструктури. Багато інженерних команд виявляють типові проблеми продуктивності лише після розгортання у продуктивному середовищі. Ці проблеми приховані на поверхні й чекають, щоб уповільнити вашу застосунок під піковим навантаженням. Вам потрібно розуміти, як затримка мережі, каскадні точки відмов і конкуренція за доступ до бази даних перетворюють архітектуру на джерело хронічних проблем у продуктивному середовищі.
Затримка мережі
Внутрішньопроцесні виклики проти мережевих
Коли ви розбиваєте монолiт на мікросервіси, ви переходите від викликів функцій у межах процесу до мережевих викликів. Цей архітектурний зсув вносить неминучу затримку. У монолітному застосунку виклик функції відбувається майже миттєво. У мікросервісах кожен виклик між сервісами має пройти через мережу, додаючи мілісекунди затримки.
| Тип архітектури | Середня затримка |
|---|---|
| Виклик функції в процесі (моноліт) | 0,001 мс (1 мікросекунда) |
| HTTP-виклик у межах одного дата-центру (мікросервіси) | 1–5 мс (1 000–5 000 мікросекунд) |
Мережеві виклики на порядки повільніші за виклики функцій у межах одного процесу. Ця різниця швидко накопичується з ростом системи. Кожен новий сервіс у ланцюжку запиту додає затримку і перетворює прості операції на повільний, дратівний досвід для кінцевих користувачів.
Використання ресурсів
Мережеві виклики шкодять не лише затримкою, а й споживають цінні системні ресурси. Кожен виклик витрачає такти процесора, буфери пам'яті та пропускну здатність мережі. Чим більше мікросервісів ви додаєте, тим експоненційно зростає мережевий трафік. Це додаткове навантаження призводить до вищих витрат на хмарну інфраструктуру та млявих часів відгуку.
Продуктивність можна покращити, рішуче скорочуючи непотрібні міжсервісні виклики. Деякі просунуті команди використовують інтелектуальне керування трафіком, щоб знизити затримку та підвищити стійкість:
- Підхід MCG покращив час відгуку на 15% за підвищеної мережевої затримки завдяки меншим затримкам міжсервісної взаємодії.
- За пікового навантаження конфігурація з MCG показала вищу стійкість і меншу кількість помилок порівняно зі стандартними конфігураціями service mesh.
- Результати оцінювання продуктивності показали, що стратегії розумного розміщення трафіку зменшили накладні витрати sidecar-проксі, знизили час відгуку та стабілізували пропускну здатність.
Ви маєте постійно відстежувати, як мережевий трафік впливає на продуктивність системи. Невеликі накопичені затримки легко переростають у серйозні вузькі місця.
Точки відмов
Ризики поширення збоїв
Мікросервіси принципово змінюють профіль відмов системи. Оскільки кожен сервіс залежить від інших, один збій може поширитися на всю вашу інфраструктуру.
| Тип архітектури | Ризик поширення збоїв | Ізоляція відмов | Стійкість системи |
|---|---|---|---|
| Монолітна | Високий | Ні | Низька |
| Мікросервісна | Низький | Так | Висока |
У монолітній системі одна критична помилка може звалити весь процес застосунку. Мікросервіси забезпечують значно кращу ізоляцію відмов: якщо некритичний сервіс зламається, інші можуть продовжувати працювати. Патерни стійкості, як-от circuit breaker, допомагають не дати збоям поширитися на всю систему.
- У монолітi одна помилка може спричинити повну відмову, створюючи єдину точку відмови.
- Мікросервіси забезпечують справжню відмовостійкість: збої некритичних компонентів не топлять платформу.
- Патерни на кшталт circuit breaker підвищують стійкість, ізолюючи залежні сервіси, що відмовляють.
Труднощі спостережуваності
Для виявлення та усунення проблем продуктивності в розгалуженій мережі мікросервісів потрібна комплексна спостережуваність. Пошук першопричини затримок або періодичних помилок стає експоненційно складнішим зі зростанням кількості сервісів. Потрібно агрегувати логи, метрики інфраструктури та розподілені трасування з кожного запущеного екземпляра. Без надійних інструментів спостережуваності ви втратите безліч годин на пошук джерела уповільнень у продакшені.
Типові вузькі місця продуктивності часто ховаються в складних асинхронних ланцюжках викликів. Варто використовувати розподілене трасування, щоб відстежувати запити між межами сервісів і виявляти вузькі місця до того, як вони вплинуть на користувачів.
Остерігайтеся цих класичних антипатернів:
- God Service (забагато відповідальності): сервіс, що обробляє кілька різнорідних бізнес-доменів, порушуючи базові принципи архітектури.
- Тісний зв'язок між сервісами: жорстко закодовані залежності, які ламають суміжні системи щоразу, коли змінюється схема даних.
Конкуренція за базу даних
Спільні сховища даних
Багато команд роблять критичну помилку, коли використовують одну базу даних для кількох мікросервісів. Така практика створює серйозну залежність через схему даних. Зміна структури бази стає небезпечною, бо може зламати зовнішні сервіси, знищуючи швидкість розробки та незалежну масштабованість.
Головна проблема спільних баз даних полягає в тому, що вони створюють зв'язність через схему. Вартість змін різко зростає, адже стає важко визначити, коли можна безпечно вносити зміни, не зламавши інший сервіс. Це має каскадний вплив на масштабованість системи. Ви не можете масштабувати сервіси окремо, якщо вони залежать від спільного сховища даних. Оскільки масштабованість сервісу обмежена його найповільнішим компонентом, спільна база даних дуже швидко стає масивним вузьким місцем.
Слід повністю відмовитися від спільних сховищ даних. Призначте кожному мікросервісу власну виділену базу даних, щоб розділити шари даних і відновити продуктивність.
Проблеми масштабованості
Конкуренція за доступ до бази даних є бомбою з годинниковим механізмом для корпоративних застосунків. Коли кілька мікросервісів конкурують за один і той самий рушій бази даних, ви створюєте серйозне вузьке місце продуктивності. Найповільніший запит або сервіс обмежує потужність усієї системи, що призводить до вичерпання пулу з'єднань, зростання затримок і катастрофічних збоїв під час пікових навантажень.
Виявлення вузьких місць в архітектурі мікросервісів
Інструменти моніторингу
Метрики
Потрібно відстежувати правильні операційні метрики, щоб вчасно помічати деградацію продуктивності. Метрики дають миттєвий знімок стану системи й допомагають помітити тренди до того, як вони вплинуть на продуктивне середовище. Зробіть акцент на бізнес-показниках поряд із технічними метриками: відстежуйте час відгуку p99, частку помилок і пропускну здатність запитів.
Прозорість
Прозорість є обов'язковою для розподілених систем. Не можна виправити те, чого не видно. Впроваджуйте інструменти моніторингу, які збирають телеметрію з кожного екземпляра сервісу:
- Prometheus, Datadog і Grafana для моніторингу інфраструктури та застосунків у реальному часі.
- Elasticsearch, Logstash, Kibana (ELK) або Graylog для централізованого агрегування журналів.
- Інструменти APM (Application Performance Monitoring), як-от New Relic або Dynatrace, для профілювання викликів на рівні коду.
- Kubernetes або оркестратори контейнерів для спостережуваності базового кластера.
- API-шлюзи, як-от Kong або Zuul, для аналітики трафіку на периферії.
Розподілене трасування
Потоки запитів
Розподілене трасування дозволяє простежити HTTP-запит, коли він проходить через вашу архітектуру мікросервісів. Інструменти трасування, як-от OpenTelemetry, Jaeger і Zipkin, пов'язують ці виклики між собою, показуючи наскрізний шлях виконання та виділяючи точні місця найбільших затримок.
- Розподілене трасування забезпечує глибоку видимість на межах сервісів.
- Воно виявляє приховані вузькі місця і суттєво прискорює процес налагодження.
- Інженерні команди використовують трасування, щоб знаходити джерела затримок і підвищувати надійність.
Джерела затримок
Затримки накопичуються, коли запити переходять між сервісами. Звичайних журналів і метрик інфраструктури самих по собі недостатньо, щоб побачити такий рівень деталізації транзакцій. Трасування зберігає контекст запиту під час переходів мережею, тож ви можете точно визначити метод або запит до бази даних, що спричиняє уповільнення.
Виявлення прихованих уповільнень
Симптоми
Приховані уповільнення можуть погіршити користувацький досвід, навіть коли повних збоїв немає. Звертайте увагу на зростання часу відгуку, підвищену частку помилок і збільшене споживання пам'яті. Використовуйте ідентифікатори кореляції, щоб простежувати запити крізь ваші системи, і налаштуйте проактивне сповіщення на основі суворих цільових рівнів сервісу (SLO).
Реальні кейси
Реальні інженерні кейси показують, наскільки важливим є проактивне виявлення вузьких місць. Наприклад, високонавантажений мікросервіс на Spring Boot зазнав серйозної деградації продуктивності. За допомогою глибоких інструментів APM і профілювання інженерна команда виявила неоптимізований цикл запитів. Завдяки додаванню конкретного оператора для пакетної обробки операцій з базою даних кількість запитів за секунду знизили з 300 до 30, миттєво стабілізувавши використання CPU і усунувши навантаження від збирання сміття.
Порада: завжди поєднуйте метрики, журнали та трасування в єдиний конвеєр спостережуваності. Таке поєднання дає миттєвий цілісний погляд на стан вашої системи.
Рішення для проблем продуктивності мікросервісів
Асинхронна взаємодія
Переваги обміну повідомленнями
Багато проблем масштабування в мікросервісній архітектурі можна розв'язати, перейшовши на асинхронну взаємодію. Розв'язуючи запити через черги повідомлень, сервіси обробляють роботу у власному темпі, безпечно поглинаючи сплески трафіку без втрати запитів.
| Підвищення продуктивності | Опис |
|---|---|
| Масштабованість | Асинхронний обмін повідомленнями дозволяє масштабувати систему на великі обсяги, використовуючи черги для буферизації сплесків трафіку. |
| Надійність | Асинхронні брокери підтримують повторні спроби доставки та черги недоставлених повідомлень, що гарантує відсутність втрати повідомлень під час простоїв. |
| Придатність до тестування | Тестувати стає простіше, адже споживачам сервісів потрібна лише імітаційна черга для перевірки корисного навантаження. |
Впровадження
Впроваджуйте асинхронну взаємодію за допомогою надійних брокерів повідомлень, таких як RabbitMQ, Azure Service Bus або Apache Kafka. Використовуйте шаблони публікації та підписки, щоб чисто розсилати доменні події між незалежними сервісами.
Перегородки та автоматичні вимикачі
Стратегії ізоляції
Захищайте мікросервіси від каскадних збоїв за допомогою перегородок і автоматичних вимикачів. Перегородки розділяють пули ресурсів так, щоб збій в одному сервісі не міг вичерпати потоки або з'єднання в усій системі.
Перегородки призначені для ізоляції доменів збоїв шляхом створення окремих пулів ресурсів або квот для різних сервісів, що не дає локальним збоям призвести до відмови всього застосунку.
Пом'якшення збоїв
Автоматичні вимикачі відстежують частоту помилок і миттєво відхиляють запити до несправних залежностей, запобігаючи каскадним відмовам у вашій мережі.
Шаблон перегородок у мікросервісній архітектурі використовується для того, щоб запобігти поширенню збоїв з однієї частини системи на всю платформу, ефективно ізолюючи збої в їх джерелі.
Кешування та масштабування
Вибір сховища даних
Кешування є важливим інструментом для високопродуктивних мікросервісів. Переносьте повторювані читання з бази даних і ресурсомісткі обчислення API у швидкі кеші в оперативній пам'яті, такі як Redis або Memcached.
| Перевага | Опис |
|---|---|
| Детальний контроль | Кешуйте фрагменти домену залежно від їх мінливості та частоти оновлень. |
| Менше витрат на анулювання кешу | Мінімізує накладні витрати на очищення, оновлюючи лише змінені сегменти даних. |
| Вищий відсоток влучань у кеш | Дозволяє використовувати менші, добре оптимізовані записи кешу для вищого відсотка влучань в оперативній пам'яті. |
| Гібридна обробка динамічних і статичних даних | Підтримує кешування статичних записів, одночасно динамічно отримуючи статистику в реальному часі. |
Незалежне масштабування
Кешування та окремі сховища даних дозволяють масштабувати окремі сервіси незалежно, усуваючи вузькі місця через конкуренцію за ресурси.
- Покращена масштабованість системи
- Вища гнучкість розробки та швидший вихід на ринок
- Надійна ізоляція збоїв і стійкість системи
- Економічне використання хмарних ресурсів
- Краща інтеграція з DevOps і конвеєри безперервного розгортання
Зменшення залежностей
Роз'єднання
Справжні мікросервіси потребують радикального роз'єднання. Коли сервіси працюють незалежно, без блокувальних синхронних викликів, ви усуваєте штучні вузькі місця.
Роз'єднання означає, що кожен мікросервіс обробляє своє внутрішнє навантаження, не чекаючи синхронно на зовнішні процеси. Така незалежність усуває вузькі місця і дозволяє платформі працювати стабільно.
Ключові архітектурні переваги зменшення залежностей включають:
- Незалежне масштабування сервісів залежно від навантаження в реальному часі.
- Мінімізований ризик каскадних збоїв через межі команд.
- Автономність команд розробки, які випускають код за власним графіком.
- Швидше виявлення першопричини під час реагування на інциденти.
Спрощення
Спрощення графа залежностей знижує когнітивне навантаження та значно полегшує тестування, моніторинг і захист вашої архітектури.
| Підхід | Що це означає | Чому це важливо |
|---|---|---|
| Індивідуальні SLO | Відстежуйте надійність кожного мікросервісу окремо | Можуть пропустити погіршення користувацького досвіду на рівні всієї системи |
| Комплексні SLO | Поєднують цілі надійності для взаємозалежних сервісів | Відображають реальний стан системи від початку до кінця |
Оцінка придатності мікросервісної архітектури
Вибір правильної архітектурної моделі визначає швидкість розробки та операційні витрати. Microsoft Development Podcast часто досліджує цю напругу і вказує на зростаючу тенденцію: організації об'єднують надмірно фрагментовані мікросервіси назад у керовані модульні монолiти.
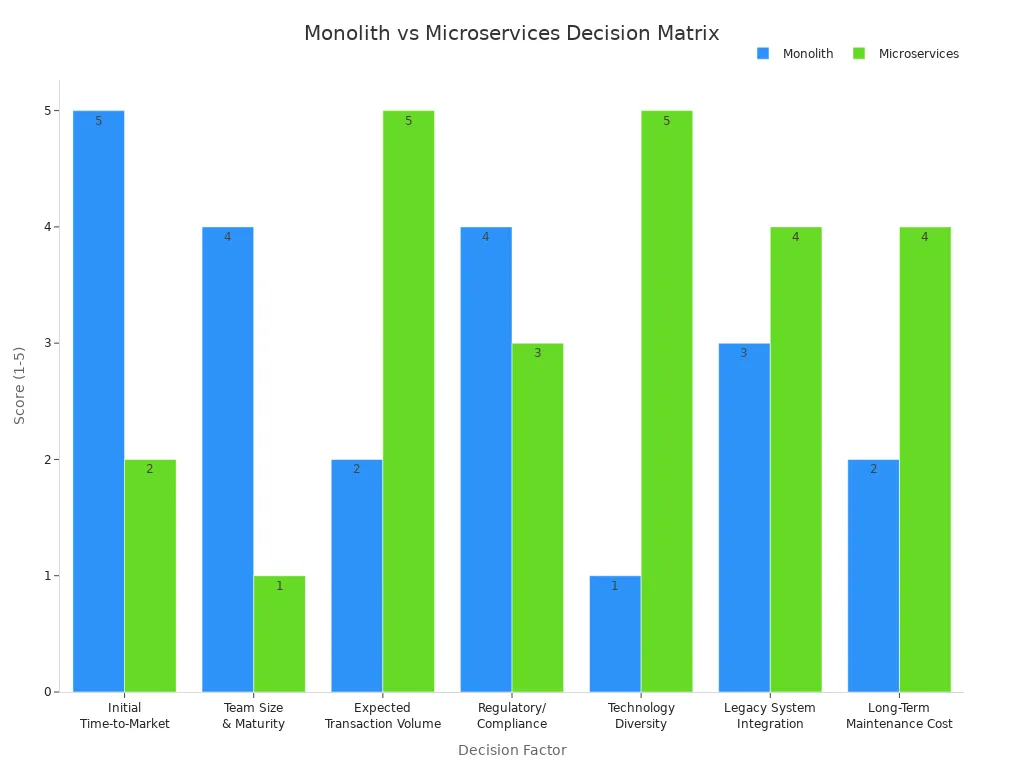
Матриця рішень
Скористайтеся структурованою матрицею рішень, щоб оцінити, чи справді мікросервіси відповідають зрілості вашої організації:
| Фактор рішення | Оцінка монолiту (1–5) | Оцінка мікросервісів (1–5) | Стратегічне обґрунтування |
|---|---|---|---|
| Початковий час виходу на ринок (швидкість) | 5 | 2 | Монолітам потрібна мінімальна початкова конфігурація інфраструктури. |
| Розмір команди та зрілість (DevOps) | 4 | 1 | Мікросервіси потребують просунутих CI/CD, автоматизації та спостережуваності. |
| Очікуваний обсяг транзакцій (масштаб) | 2 | 5 | Мікросервіси дозволяють точно і незалежно масштабувати ресурсомісткі вузькі місця. |
| Регуляторна складність і відповідність вимогам | 4 | 3 | Єдині артефакти спрощують початковий аудит безпеки та перевірки відповідності. |
| Різноманітність технологій та експерименти | 1 | 5 | Мікросервіси дозволяють командам використовувати спеціалізовані технологічні стеки для кожної предметної області сервісу. |
| Інтеграція з унаслідуваними системами | 3 | 4 | Мікросервіси добре підходять для обгортання та модернізації застарілих компонентів. |
| Довгострокова вартість супроводу (TCO) | 2 | 4 | Мікросервіси з часом знижують вартість функцій, але ціною вищих операційних накладних витрат. |
Ключові питання для оцінки
- Чи має ваша команда розробки міцні навички DevOps, platform engineering та SRE?
- Чи маєте ви екстремальні вимоги до масштабу, які виправдовують накладні витрати розподіленої системи?
- Чи потрібні вам поліглотна персистентність і різноманітність технологій?
- Чи готова культура вашої організації витримувати високі витрати на координацію між командами?
Ознаки, що варто переглянути
Зверніть увагу на ці червоні прапорці, які свідчать про те, що архітектуру мікросервісів потрібно перебудувати:
- Швидкість доставки повністю зупиняється через постійні залежності між командами.
- Операційні витрати на хмару зростають швидше, ніж доходи бізнесу.
- Збої легко каскадно поширюються між кількома доменами.
Монолiт проти мікросервісів
| Тип архітектури | Рекомендований розмір команди | Ключові характеристики |
|---|---|---|
| Монолітна | < 8–10 розробників | Прості розгортання, низькі операційні накладні витрати |
| Мікросервісна | > 10–15 розробників | Незалежна автономія команд, складна розподілена координація |
Під час впровадження мікросервісної архітектури ви стикаєтеся з прихованою складністю та ризиками для продуктивності. Вузькі місця неминуче з'являються в несподіваних мережевих і знеособлених шарах даних. Microsoft Development Podcast наголошує, що швидка доставка вимагає суворої архітектурної дисципліни. Щоб ваші .NET-системи залишалися здоровими, пам'ятайте про таке:
- Уважно керуйте міжсервісними запитами та політиками тайм-аутів.
- Впровадьте еластичне балансування навантаження та автоматичне масштабування.
- Розділіть сховища даних так, щоб кожен сервіс володів власною базою даних.
- Агресивно кешуйте повторювані запити до API та баз даних.
Вам також варто забезпечити архітектурне управління, використовувати надійні API-шлюзи та регулярно проводити архітектурні перегляди. Постійна оцінка гарантує, що ваш технологічний стек масштабуватиметься разом із бізнесом.
Поширені запитання
Що таке розподілений монолiт?
Розподілений монолiт — це антипатерн, коли застосунок фізично розбитий на кілька мікросервісів, але логічно залишається пов'язаним через синхронні HTTP-виклики, спільні бази даних і жорсткі залежності під час розгортання, втрачаючи ключові переваги мікросервісів.
Як виявити вузькі місця продуктивності в мікросервісах?
Відстежуйте час відповіді p99, частоту помилок і пропускну здатність запитів. Використовуйте інструменти розподіленого трасування, щоб відстежувати запити через межі сервісів і виявляти повільні мережеві переходи або запити до баз даних.
Чому затримка мережі важлива в мікросервісній архітектурі?
Затримка мережі додає мілісекунди до кожного міжсервісного виклику. На відміну від миттєвих викликів у пам'яті всередині монолiту, мережеві переходи в розподіленій системі швидко накопичуються і погіршують загальну чутливість застосунку.
Як зменшити накладні витрати на координацію між командами?
Чітко визначте межі відповідальності за домени, автоматизуйте перевірки управління API, скоротіть непотрібні статусні наради та переходьте до асинхронної комунікації, щоб команди могли працювати самостійно.
Які інструменти допомагають із спостережуваністю в мікросервісах .NET?
Популярні інструменти спостережуваності включають Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin та платформи централізованого логування на кшталт ELK stack, які разом збирають метрики, логи та розподілені трасування.
Коли варто розглянути консолідацію мікросервісів?
Розгляньте консолідацію, якщо швидкість випуску нових функцій падає, витрати на хмарну інфраструктуру неконтрольовано зростають або каскадні збої регулярно впливають на вашу здатність підтримувати доступність сервісів.
Який найкращий спосіб працювати зі спільними даними в мікросервісах?
Надайте кожному мікросервісу власну приватну базу даних. Не використовуйте спільні бази даних між сервісами, щоб усунути зв'язність через схему та відновити незалежне масштабування баз даних.
Як асинхронна комунікація покращує продуктивність мікросервісів?
Асинхронна комунікація через брокери повідомлень дозволяє сервісам обробляти події у власному темпі, буферизувати сплески трафіку та усувати блокувальні синхронні вузькі місця.
🎧 Слухайте цей епізод
Хочете практичного, детального пояснення того, чому архітектура мікросервісів сповільнює випуск програмного забезпечення? Цей епізод просто й зрозуміло розбирає ключові архітектурні питання та показує, чому вони важливі для Microsoft 365, Azure, Power Platform, корпоративної безпеки, ШІ та сучасної інженерії програмного забезпечення.
Слухайте цей епізод, якщо хочете:
- Зрозуміти основні концепції того, чому мікросервіси можуть сповільнювати випуск програмного забезпечення
- Побачити, як архітектура вписується в ширшу екосистему технологій Microsoft
- Дізнатися, де вона може принести практичну, вимірювану цінність для вашої корпоративної організації
Вам також можуть сподобатися пов'язані епізоди M365 FM:
- Міф про монорепозиторій: чому ваша архітектура фрагментована
- Автоматизація архітектури Microsoft Graph: понад скрипти
- ШІ-агенти на основі Graph: посібник з корпоративної архітектури
- Розширюваність .NET і чиста архітектура з Мігелем Кастро [MVP]
- Корпоративна архітектура ШІ-агентів: архітектура понад чат-ботами
Відкривайте більше практичних розмов про інженерію Microsoft на M365 FM.