 ES
 English
 Deutsch
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Desmontando el mito de la latencia: proceso local frente a HTTP empresarial
By Mirko Peters ·
Bienvenido de nuevo a nuestras series de análisis técnicos sobre arquitectura empresarial y diseño de sistemas modernos. En este artículo ampliamos un tema que suele generar debate entre ingenieros de software y arquitectos de sistemas: la verdadera naturaleza de la latencia en aplicaciones distribuidas frente a procesos locales. Al diseñar sistemas de alto rendimiento, sobre todo los que conectan
Automatically translated with AI from the original post. Read the English original
Bienvenido de nuevo a nuestras series de análisis técnicos sobre arquitectura empresarial y diseño de sistemas modernos. En este artículo ampliamos un tema que suele generar debate entre ingenieros de software y arquitectos de sistemas: la verdadera naturaleza de la latencia en aplicaciones distribuidas frente a procesos locales. Al diseñar sistemas de alto rendimiento, sobre todo los que conectan los asistentes de IA de escritorio con las plataformas de datos en la nube, los desarrolladores suelen caer en la trampa de los microbenchmarks. Miran las velocidades de transporte en bruto y asumen que la comunicación entre procesos locales es universalmente superior al HTTP empresarial basado en red. Pero, como explicamos en este artículo, esa suposición es un mito.
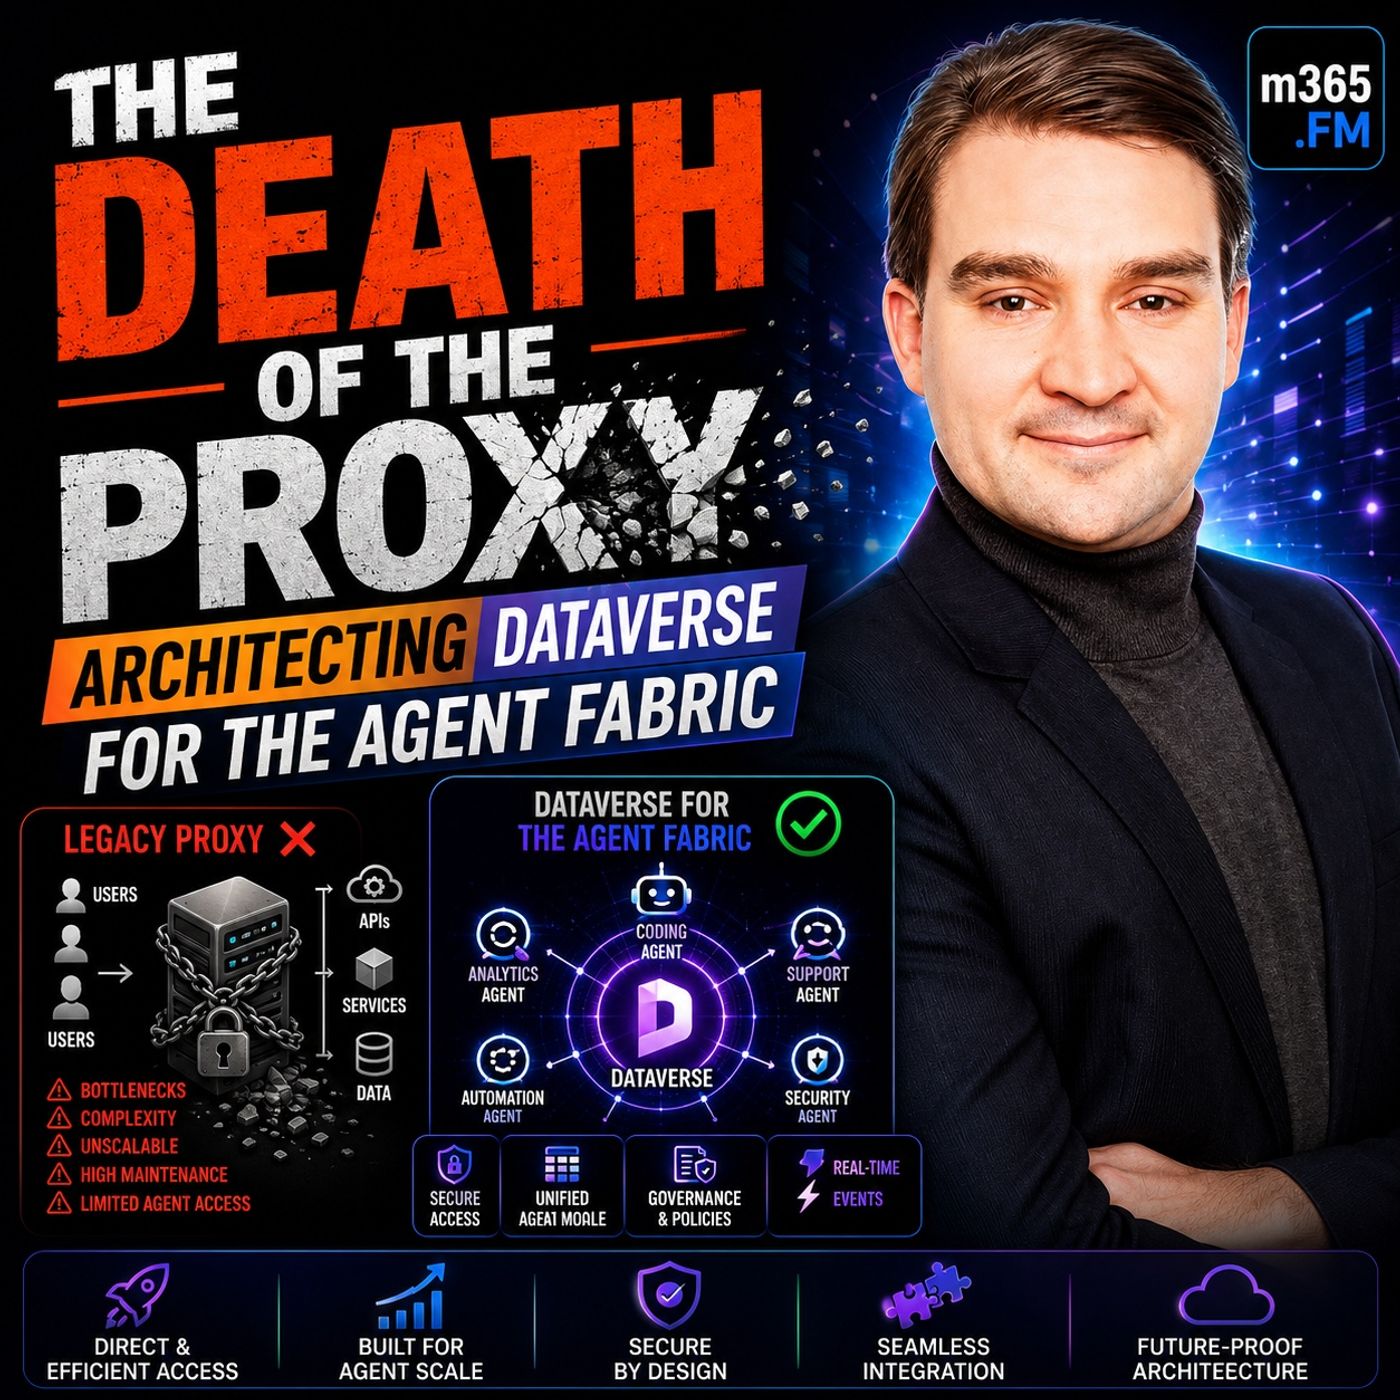
Esta discusión está directamente relacionada con nuestra reciente conversación en el podcast. Si aún no lo has escuchado, no te pierdas THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric, donde analizamos cómo las arquitecturas modernas están dejando atrás los proxies locales frágiles para avanzar hacia endpoints HTTP empresariales robustos y escalables.
Introducción al mito de la latencia en la IA empresarial
La evolución del software empresarial ha obligado a replantear cómo gestionamos la comunicación entre los clientes y los sistemas de backend. Esto se hace especialmente evidente en la arquitectura de la integración de la IA empresarial. Durante años, herramientas locales como los proxies STDIO fueron la recomendación habitual para conectar aplicaciones de escritorio con bases de datos en la nube. Eran sencillas de instalar, requerían una infraestructura mínima y parecían instantáneas durante las pruebas locales.
Sin embargo, a medida que las organizaciones pasan de los experimentos aislados de desarrolladores a implementaciones en toda la empresa con cientos o miles de agentes de IA, estas suposiciones locales empiezan a resquebrajarse. Los ingenieros que defienden los procesos locales suelen señalar la latencia de transporte como el factor decisivo. Argumentan que HTTP introduce sobrecarga de red, handshakes TCP y negociación TLS, mientras que la comunicación local por tuberías opera en apenas microsegundos. Sin embargo, este argumento se basa en un malentendido fundamental sobre dónde se invierte realmente el tiempo en una transacción empresarial real. Para entender de verdad el rendimiento, hay que mirar más allá de la capa de transporte y analizar la carga de trabajo en su conjunto.
Microbenchmarks frente a cargas de trabajo empresariales reales
Los microbenchmarks son notoriamente engañosos. En un entorno de prueba aislado, medir el tiempo que tarda en transferirse un payload JSON por una tubería STDIO local frente a una interfaz de loopback HTTP casi siempre favorecerá al proceso local. Las cifras son incontestables: de un solo dígito en milisegundos para las tuberías locales frente a dos dígitos en milisegundos para los bucles de red.
El problema es que los microbenchmarks eliminan la realidad de la ejecución del software empresarial. Cuando un agente de IA solicita datos de una plataforma robusta como Dataverse, el mecanismo de transporte es solo una fracción de la ecuación. Detrás de ese endpoint hay una cadena compleja de operaciones:
- Verificación de identidad y validación de tokens mediante Microsoft Entra ID
- Control de acceso basado en roles (RBAC) y comprobaciones de los límites de seguridad
- Ejecución de lógica de negocio compleja, plugins y flujos de trabajo personalizados
- Compilación de consultas de base de datos, evaluación de índices y recuperación física de los datos
- Serialización y deserialización de modelos de datos empresariales ricos
Cuando tu consulta a la base de datos y la lógica de negocio tardan trescientos milisegundos en ejecutarse, ahorrar cuatro milisegundos en la sobrecarga de transporte es totalmente irrelevante. El cuello de botella nunca es la red, sino el cómputo necesario para atender la solicitud de negocio. Cuando los arquitectos optimizan la capa de transporte e ignoran el peso operativo de la lógica del backend, están optimizando la parte equivocada de la pila.
El coste real de la sobrecarga de transporte
Aunque la comunicación entre procesos locales presume de una velocidad teórica impresionante, oculta una enorme cantidad de sobrecarga operativa e infraestructural que se acumula a escala. Piensa en lo que ocurre cuando cada usuario ejecuta su propio proceso local para conectar un cliente de IA con un servicio en la nube.
Cada instancia de un proxy local tiene su propio coste de arranque, su propia inicialización de procesos y su propio ciclo de vida de autenticación aislado. Además, cada proceso local debe gestionar por su cuenta sus conexiones, sus credenciales de seguridad y sus estados de error. Si una organización tiene quinientos desarrolladores o agentes automatizados ejecutando proxies locales, eso significa quinientos canales de conexión independientes intentando negociar con los recursos de backend.
Si lo comparamos con un endpoint HTTP empresarial bien configurado, los costes ocultos del modelo local resultan evidentes. Los procesos locales no pueden compartir estado con facilidad, almacenar en caché los handshakes de conexión a nivel global ni agrupar recursos de forma eficiente entre distintas aplicaciones cliente. La velocidad percibida de un proceso local es una ilusión que se desmorona en cuanto entran en juego la concurrencia y la fragmentación del sistema.
Cómo el pooling de conexiones gana la carrera de rendimiento
Aquí es donde HTTP empresarial cambia de forma notable la historia del rendimiento. A diferencia de los procesos locales efímeros, que se inician y se cierran repetidamente con sus conexiones, los servicios HTTP de nivel productivo aprovechan un pooling de conexiones sofisticado, sesiones persistentes e infraestructuras de servidor de larga duración.
Cuando un cliente HTTP empresarial se conecta a un servicio compartido, los costes del handshake inicial, como la resolución DNS, el slow-start de TCP y la negociación TLS, se producen una sola vez. Las solicitudes posteriores utilizan conexiones persistentes ya establecidas. Además, como estas conexiones se agrupan y gestionan mediante una capa de servicio centralizada, el sistema puede mantener conexiones de base de datos ya calentadas, sesiones preautenticadas y esquemas de metadatos en caché.
En un entorno empresarial bien ajustado, estas optimizaciones permiten que un flujo sostenido de solicitudes HTTP consiga una latencia media de extremo a extremo menor que una maraña dispersa de procesos locales no coordinados. La sobrecarga de red se reparte entre miles de transacciones persistentes y muy rápidas, lo que hace que la penalización inicial de transporte sea totalmente irrelevante.
Escalar HTTP empresarial frente a la sobrecarga de los procesos locales
Escalar una arquitectura de software es la prueba definitiva de sus principios de diseño. Cuando una empresa pasa de dar soporte a un puñado de asistentes para desarrolladores a desplegar un ecosistema completo de herramientas de IA, que incluye GitHub Copilot, Claude Code, orquestadores personalizados y Copilot CLI internos, la realidad operativa de los procesos locales se vuelve insostenible.
Gestionar cientos de procesos proxy desconectados provoca una deriva administrativa grave. No hay visibilidad centralizada, la monitorización está fragmentada y diagnosticar fallos intermitentes en máquinas locales dispares es una pesadilla para los administradores de TI. La gobernanza de seguridad se convierte en un conjunto de configuraciones locales inconexas en lugar de una directiva unificada y exigible.
En cambio, escalar una arquitectura HTTP empresarial es lineal y predecible. En lugar de multiplicar la infraestructura en cada estación de trabajo, las organizaciones escalan un único servicio altamente disponible detrás de un balanceador de carga empresarial. Cuando aumenta la demanda, basta con añadir más instancias de servidor. Los clientes siguen comunicándose con el mismo endpoint gobernado, mientras la plataforma gestiona de forma transparente el escalado horizontal, la distribución de carga y la telemetría. Funciones de seguridad como PKCE (Proof Key for Code Exchange) permiten que los clientes de escritorio públicos se autentiquen de forma segura sin almacenar secretos codificados, combinando una gobernanza empresarial sólida con una ergonomía para desarrolladores sin fricciones.
Conclusión: priorizar la lógica de negocio frente a las micro-optimizaciones
El atractivo duradero de la comunicación por procesos locales es un ejemplo clásico de cómo las micro-optimizaciones pueden cegar a los arquitectos ante las realidades a nivel macro. Aunque las tuberías locales puedan ganar un benchmark sintético por unos pocos milisegundos, introducen una complejidad operativa enorme, fracturan la seguridad empresarial y no escalan con elegancia en los entornos modernos impulsados por IA. Al desplazar nuestro foco de la capa de transporte hacia arquitecturas HTTP empresariales robustas y con pooling de conexiones, construimos sistemas seguros, escalables y realmente preparados para las exigencias de la empresa moderna.
Para profundizar en cómo plataformas como Dataverse evolucionan hasta convertirse en la columna vertebral de datos unificada de todo el agent fabric, escucha el episodio completo: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. ¡Gracias por leer y mantente atento a más análisis en profundidad sobre arquitectura cloud empresarial!