 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Het latencymythe ontmaskeren: lokaal proces versus enterprise HTTP
By Mirko Peters ·
Welkom terug bij onze doorlopende technische verdiepingen in enterprise-architectuur en moderne systeemontwerp. In dit artikel gaan we dieper in op een onderwerp dat bij softwareontwikkelaars en systeemarchitecten vaak tot discussie leidt: wat latency in gedistribueerde applicaties werkelijk betekent ten opzichte van lokale processen. Bij het ontwerpen van systemen met een hoge doorvoer, zeker wan
Automatically translated with AI from the original post. Read the English original
Welkom terug bij onze doorlopende technische verdiepingen in enterprise-architectuur en moderne systeemontwerp. In dit artikel gaan we dieper in op een onderwerp dat bij softwareontwikkelaars en systeemarchitecten vaak tot discussie leidt: wat latency in gedistribueerde applicaties werkelijk betekent ten opzichte van lokale processen. Bij het ontwerpen van systemen met een hoge doorvoer, zeker wanneer die de brug slaan tussen desktop-AI-assistenten en cloud-dataplatformen in de backend, trappen ontwikkelaars vaak in de val van microbenchmarks. Ze kijken naar de ruwe transportsnelheid en gaan ervan uit dat lokale interprocescommunicatie altijd beter is dan netwerkgebonden enterprise HTTP. Maar zoals we in dit artikel laten zien, is die aanname een mythe.
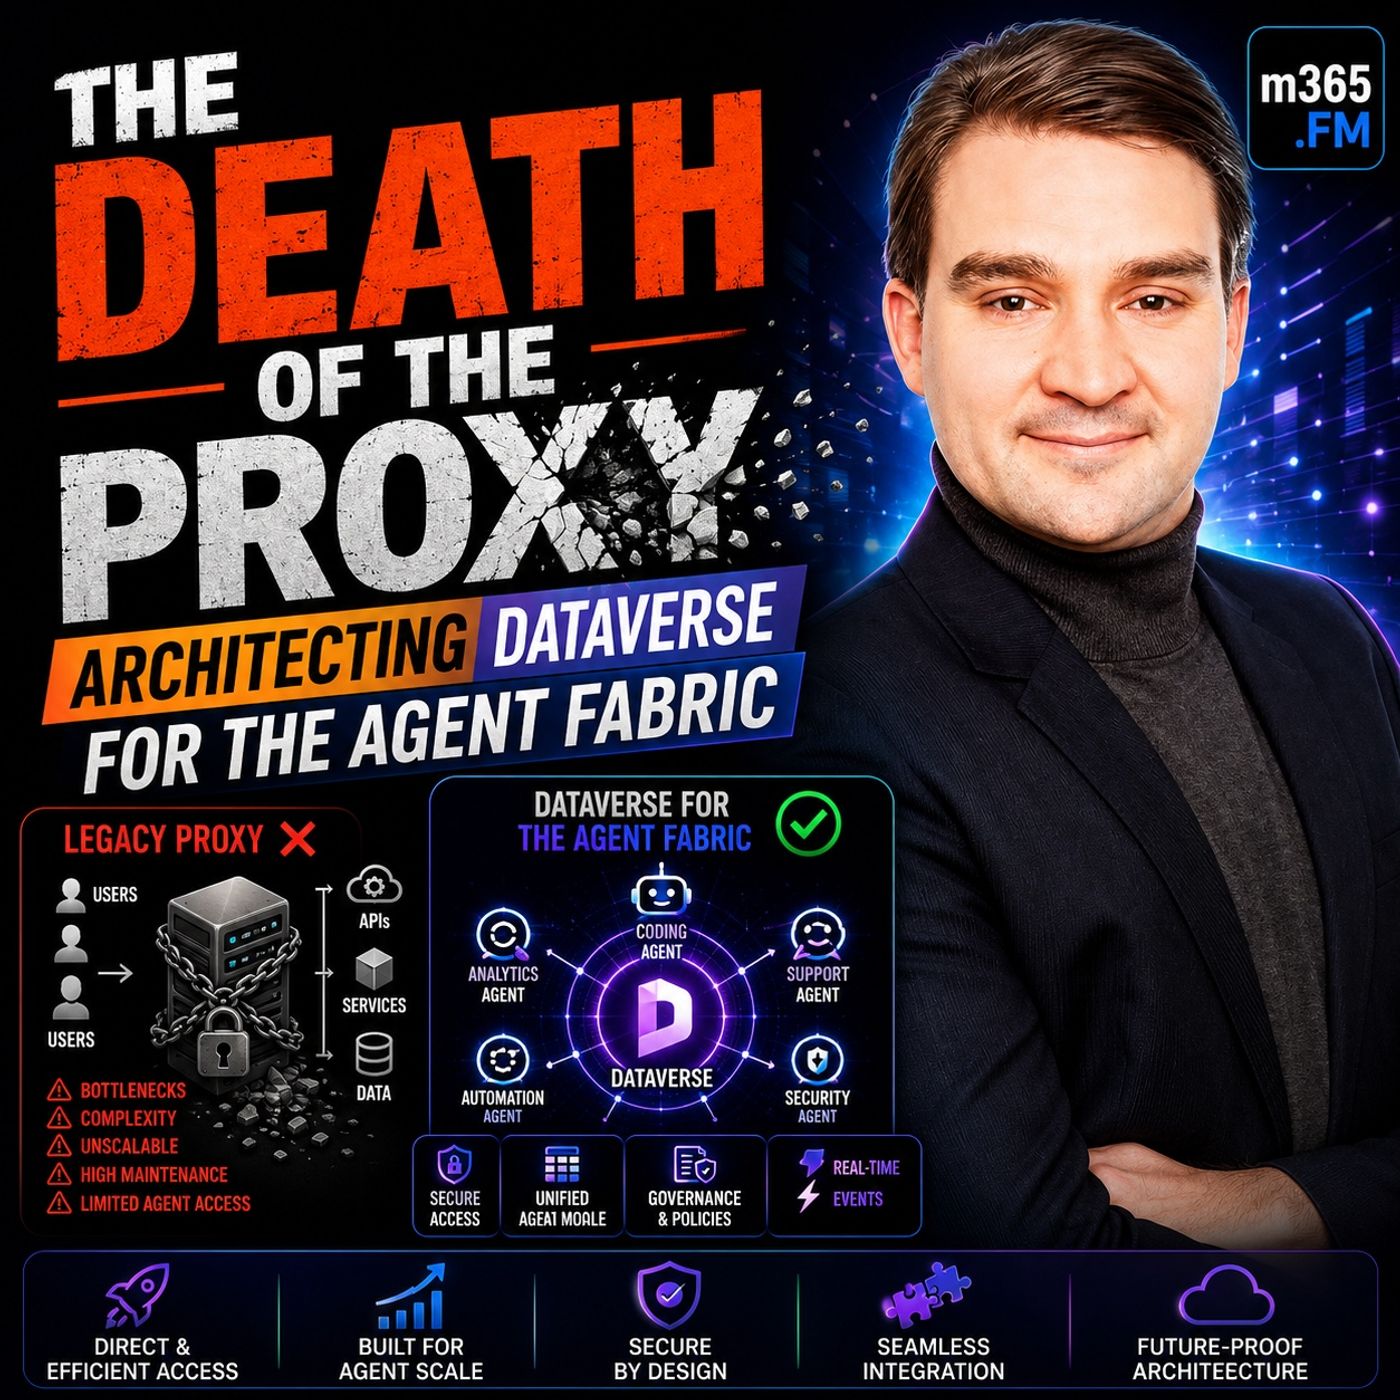
Dit onderwerp sluit direct aan op ons recente podcastgesprek. Als je hem nog niet hebt beluisterd, bekijk dan zeker THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric, waarin we uitleggen hoe moderne architecturen wegbewegen van kwetsbare lokale proxies naar robuuste, schaalbare enterprise HTTP-endpoints.
Inleiding tot het latencymythe in enterprise-AI
De evolutie van enterprisesoftware heeft ons gedwongen kritisch te kijken naar hoe clients en backendsystemen met elkaar communiceren. Nergens is dat duidelijker dan in de architectuur van enterprise-AI-integratie. Jarenlang waren lokale tools zoals STDIO-proxies de standaardaanbeveling om desktopapplicaties te verbinden met clouddatabases. Ze waren eenvoudig te installeren, vereisten weinig infrastructuur en voelden tijdens lokaal testen direct en snel aan.
Naarmate organisaties echter overstappen van geïsoleerde ontwikkelexperimenten naar uitrol over het hele bedrijf, met honderden of duizenden AI-agents, beginnen die lokale aannames te barsten. Ingenieurs die lokale processen verdedigen, wijzen vaak op transportlatency als de doorslaggevende factor. Ze stellen dat HTTP netwerkoverhead, TCP-handshakes en TLS-onderhandeling met zich meebrengt, terwijl lokale piping in slechts microseconden werkt. Toch berust dit argument op een fundamenteel misverstand over waar de tijd in een echte enterprise-transactie daadwerkelijk verloren gaat. Om de prestaties echt te begrijpen, moeten we voorbij de transportlaag kijken en de volledige workload bekijken.
Microbenchmarks versus echte enterprise-workloads
Microbenchmarks zijn berucht misleidend. In een geïsoleerde testomgeving zal het meten van de ruwe tijd die nodig is om een JSON-payload over een lokale STDIO-pipe te sturen, vergeleken met een HTTP-loopbackinterface, bijna altijd in het voordeel van het lokale proces uitvallen. De cijfers spreken boekdelen: enkele milliseconden voor lokale pipes tegenover tientallen milliseconden voor netwerklussen.
Het probleem is dat microbenchmarks de realiteit van enterprisesoftware-uitvoering negeren. Wanneer een AI-agent gegevens opvraagt bij een robuust platform zoals Dataverse, is het transportmechanisme slechts een fractie van de vergelijking. Achter dat endpoint schuilt een complexe keten van bewerkingen:
- Identiteitsverificatie en tokenvalidatie via Microsoft Entra ID
- Rolgebaseerd toegangsbeheer (RBAC) en controles op beveiligingsgrenzen
- Uitvoering van complexe bedrijfslogica, plug-ins en aangepaste workflows
- Compilatie van databasequery's, evaluatie van indexen en fysiek ophalen van gegevens
- Serialisatie en deserialisatie van rijke enterprise-datamodellen
Wanneer je databasequery en bedrijfslogica driehonderd milliseconden nodig hebben om uit te voeren, is het besparen van vier milliseconden aan transportoverhead volkomen verwaarloosbaar. Het knelpunt ligt nooit op de draad; het zit in de rekenkracht die nodig is om het zakelijke verzoek af te handelen. Wanneer architecten optimaliseren voor de transportlaag en de operationele zwaarte van de backendlogica negeren, optimaliseren ze het verkeerde deel van de stack.
De werkelijke kosten van transportoverhead
Hoewel lokale procescommunicatie indrukwekkende theoretische snelheid biedt, verbergt ze een grote hoeveelheid operationele en infrastructurele overhead die op schaal snel oploopt. Denk eens aan wat er gebeurt wanneer elke afzonderlijke gebruiker een eigen lokaal proces draait om een AI-client met een cloudservice te verbinden.
Elke afzonderlijke lokale proxy brengt zijn eigen opstarttijd, zijn eigen initialisatie-overhead en zijn eigen geïsoleerde authenticatiecyclus met zich mee. Bovendien moet elk lokaal proces zijn verbindingen, beveiligingsreferenties en foutstatussen zelfstandig beheren. Als een organisatie vijfhonderd ontwikkelaars of geautomatiseerde agents heeft die lokale proxies draaien, betekent dat vijfhonderd afzonderlijke verbindingspijplijnen die elk proberen te onderhandelen met backend-resources.
Vergeleken met een goed geconfigureerd enterprise HTTP-endpoint vallen de verborgen kosten van het lokale model meteen op. Lokale processen kunnen niet eenvoudig status delen, verbindingshandshakes wereldwijd cachen of resources efficiënt poolen over verschillende clienttoepassingen heen. De ervaren snelheid van een lokaal proces is een illusie die uiteenvalt zodra concurrency en systeemfragmentatie in beeld komen.
Hoe connection pooling de prestatiewedstrijd wint
Hier draait enterprise HTTP het prestatieverhaal echt om. In tegenstelling tot kortstondige lokale processen die steeds opnieuw verbindingen opzetten en afbreken, maken productiewaardige HTTP-services gebruik van geavanceerde connection pooling, persistente sessies en langlopende serverinfrastructuur.
Wanneer een enterprise HTTP-client verbinding maakt met een gedeelde service, vallen de initiële handshake-kosten, zoals DNS-lookup, TCP slow-start en TLS-onderhandeling, slechts één keer. Volgende verzoeken gebruiken de bestaande, persistente verbindingen. Omdat deze verbindingen bovendien worden gepoold en beheerd door een centrale servicelaag, kan het systeem warme databaseverbindingen, vooraf geauthenticeerde sessies en gecachte metadataschema's aanhouden.
In een goed afgestemde enterprise-omgeving betekenen deze optimalisaties dat een constante stroom HTTP-verzoeken een lagere gemiddelde end-to-end latentie kan halen dan een wirwar van ongecoördineerde lokale processen. De netwerk-overhead wordt verdeeld over duizenden razendsnelle, persistente transacties, waardoor de initiële transportkost volledig irrelevant wordt.
Enterprise HTTP schalen versus overhead van lokale processen
Een softwarearchitectuur schalen is de ultieme test van je ontwerpprincipes. Wanneer een organisatie overstapt van een handvol ontwikkelassistenten naar een uitgebreid ecosysteem van AI-tools, waaronder GitHub Copilot, Claude Code, eigen orchestrators en interne Copilot CLI's, wordt de operationele realiteit van lokale processen onhoudbaar.
Het beheren van honderden losgekoppelde proxyprocessen leidt tot ernstige administratieve drift. Er is geen gecentraliseerd overzicht, monitoring is versnipperd en het oplossen van intermitterende fouten op verspreide lokale machines is voor IT-beheerders een nachtmerrie. Beveiligingsbeleid wordt een lappendeken van lokale configuraties in plaats van één uniform, afdwingbaar beleid.
Schalen van een enterprise HTTP-architectuur daarentegen is lineair en voorspelbaar. In plaats van infrastructuur te vermenigvuldigen op elke werkplek van gebruikers, schaal je één hoog beschikbare service achter een enterprise load balancer. Wanneer de vraag toeneemt, start je simpelweg extra serverinstanties op. Clients blijven communiceren met exact hetzelfde beheerde endpoint, terwijl het platform horizontale schaling, load distribution en telemetrie transparant afhandelt. Beveiligingsfuncties zoals PKCE (Proof Key for Code Exchange) stellen publieke desktopclients in staat veilig te authenticeren zonder hardcoded geheimen op te slaan, waarmee robuuste enterprise-governance samengaat met een naadloze developer-ervaring.
Conclusie: bedrijfslogica belangrijker dan micro-optimalisatie
De blijvende aantrekkingskracht van lokale proces-communicatie is een klassiek voorbeeld van hoe micro-optimalisatie architecten blind maakt voor macro-niveau realiteiten. Lokale pipes winnen misschien een synthetische benchmark met enkele milliseconden, maar ze brengen enorme operationele complexiteit met zich mee, ondermijnen de beveiliging van de enterprise en schalen niet goed in moderne, AI-gedreven omgevingen. Door de focus te verleggen van de transportlaag naar robuuste, connection-pooled enterprise HTTP-architecturen, bouwen we systemen die veilig, schaalbaar en echt klaar zijn voor de eisen van de moderne enterprise.
Om dieper in te gaan op hoe platforms zoals Dataverse zich ontwikkelen tot de uniforme databackbone voor de hele agent fabric, zorg je dat je de volledige aflevering beluistert: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. Bedankt voor het lezen, en blijf op de hoogte voor meer deep dives over enterprise cloudarchitectuur!