 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Sześciokrotnie szybsza analityka: dogłębne spojrzenie na natywny silnik wykonawczy Microsoft Fabric
By Mirko Peters ·
Witamy ponownie w podcaście! W dzisiejszym wpisie rozwijamy temat ostatniego odcinka podcastu, w którym omawiamy ukryte architektoniczne fundamenty napędzające nowoczesne platformy danych…
Automatically translated with AI from the original post. Read the English original
Witamy ponownie w podcaście! W dzisiejszym wpisie rozwijamy temat ostatniego odcinka podcastu, w którym omawiamy ukryte architektoniczne fundamenty napędzające nowoczesne platformy danych. Jeśli zastanawiałeś się, jak obciążenia analityczne w przedsiębiorstwie mogą nagle działać wielokrotnie szybciej bez konieczności całkowitego przepisywania kodu, trafiłeś we właściwe miejsce. Przyglądamy się kompleksowo natywnemu silnikowi wykonawczemu Microsoft Fabric's — przełomowemu rozwiązaniu, które zmienia sposób, w jaki inżynierowie danych, naukowcy danych i analitycy biznesowi myślą o skalowaniu w chmurze, optymalizacji wydajności i realnych oszczędnościach kosztów.
W polecanym odcinku podcastu Speed Power BI with OneLake and Direct Lake przyglądamy się mechanizmom, dzięki którym te silniki współpracują z narzędziami takimi jak OneLake i Direct Lake, przyspieszając raportowanie w przedsiębiorstwie. W tym dogłębnym omówieniu rozłożymy na czynniki pierwsze podstawowe komponenty tej architektury, przyjrzymy się magii wykonywania wektorowego, przeanalizujemy przykłady z życia wzięte i zastanowimy się, co przyniesie przyszłość nowoczesnym platformom danych.
Najważniejsze wnioski
- Natywny silnik wykonawczy w Microsoft Fabric zwiększa szybkość przetwarzania danych nawet sześciokrotnie w porównaniu z tradycyjnymi środowiskami uruchomieniowymi Spark.
- Dzięki natywnemu silnikowi wykonawczemu organizacje mogą zaoszczędzić około 83% na klastrach o stałym rozmiarze, co prowadzi do znaczących redukcji kosztów.
- Silnik obsługuje różne formaty danych, w tym Parquet i Delta, co pozwala na wydajne wykonywanie zapytań bez zmian w kodzie.
- Wykonywanie wektorowe przetwarza dane w partiach, co zwiększa wydajność i zmniejsza zużycie procesora, a to kluczowe przy obsłudze dużych zbiorów danych.
- Integracja natywnego silnika wykonawczego z istniejącymi aplikacjami Spark nie wymaga żadnych modyfikacji, co ułatwia jego wdrożenie.
- Możliwości analityki w czasie rzeczywistym zapewniają natychmiastowe wglądy, pomagając firmom podejmować terminowe decyzje na podstawie bieżących danych.
- Modułowa konstrukcja silnika umożliwia bezproblemową integrację z istniejącymi przepływami pracy z danymi, zwiększając ogólną efektywność.
- Przyszłe rozwiązania, takie jak narzędzia wspomagane sztuczną inteligencją i zoptymalizowane zarządzanie pamięcią, mają dodatkowo poprawić możliwości przetwarzania danych.
Przegląd Microsoft Fabric
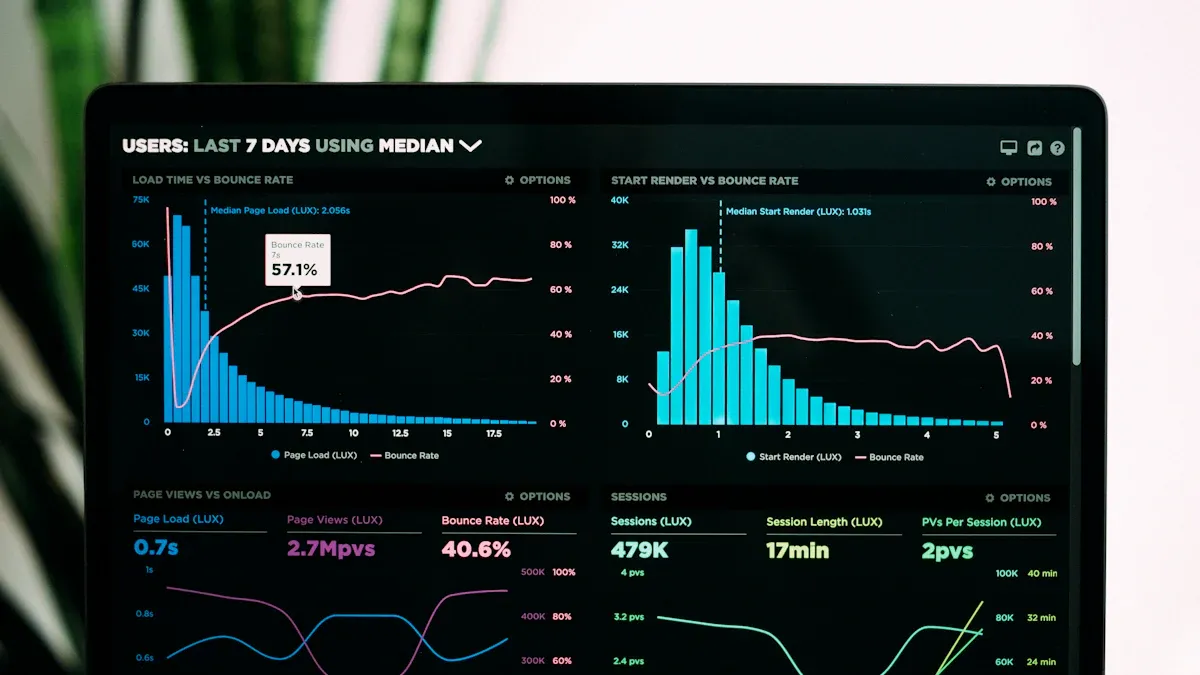
Microsoft Fabric stanowi istotny krok naprzód w zarządzaniu danymi i analityce. Jego architektura łączy różne komponenty, które współpracują ze sobą bezproblemowo, wzmacniając możliwości przetwarzania danych. Przyjrzyjmy się bliżej jego architekturze i kluczowym komponentom.
Architektura
Architektura Microsoft Fabric składa się z kilku istotnych komponentów, które wspierają wydajne przetwarzanie danych. Są to:
- OneLake Data Lake: ten scentralizowany magazyn danych obsługuje różne formaty danych. Zapewnia bezpieczeństwo i zarządzanie, dzięki czemu jest wiarygodnym źródłem danych.
- Data Engineering (Synapse): ten komponent umożliwia transformacje danych na dużą skalę z wykorzystaniem Apache Spark. Idealnie nadaje się do złożonych zadań przygotowania danych.
- Data Warehouse (Synapse): ta część zapewnia wysokowydajną analitykę opartą na SQL. Jest głęboko zintegrowana z OneLake w obciążeniach związanych z danymi ustrukturyzowanymi.
- Real-Time Analytics (Synapse): ta funkcja umożliwia analitykę o dużej przepustowości, dzięki czemu można natychmiast uzyskiwać wnioski ze strumieniowych danych.
- Data Factory: ten komponent oferuje rozbudowane możliwości integracji danych. Dzięki ponad 200 łącznikom jest niezbędny w procesach ETL i ELT.
- Power BI: to narzędzie pozwala tworzyć interaktywne raporty i pulpity nawigacyjne. Zapewnia aktualność danych dzięki integracji z innymi usługami.
Kluczowe komponenty
Integracja usług OneLake i Direct Lake znacząco wzmacnia architekturę Microsoft Fabric. Poniżej przedstawiono kilka korzyści wynikających z tej integracji:
| Korzyść | Opis |
|---|---|
| Wydajność zapytań | Zapytania Direct Lake są przetwarzane przez silnik VertiPaq, co zapewnia wydajność porównywalną z trybem importu, bez obciążenia związanego z cyklami odświeżania danych. |
| Bezproblemowa integracja | Direct Lake integruje się z istniejącymi zasobami Fabric, dzięki czemu idealnie sprawdza się w warstwie analitycznej (gold) architektury lakehouse typu medallion. |
| Maksymalizacja zwrotu z inwestycji | Do pamięci ładowane są wyłącznie niezbędne dane, co umożliwia analizę wolumenów danych przekraczających limity pamięci. |
| Mniejsze opóźnienia | Model semantyczny jest automatycznie synchronizowany ze źródłami, dzięki czemu nowe dane są dostępne bez harmonogramów odświeżania. |
Ta architektura pozwala usłudze Microsoft Fabric na bezproblemową integrację z istniejącą infrastrukturą danych. Scentralizowane jezioro danych obsługuje różne formaty danych i zapewnia ujednoliconą pamięć masową. Ponadto rozbudowane możliwości integracji danych usługi Data Factory umożliwiają płynną orkiestrację w całym ekosystemie danych.
Wykorzystując te komponenty, możesz usprawnić procesy związane z danymi i zwiększyć możliwości analityczne. Microsoft Fabric nie tylko upraszcza zarządzanie danymi, ale także pozwala podejmować świadome decyzje w oparciu o analizy w czasie rzeczywistym.
Przegląd natywnego silnika wykonawczego
Natywny silnik wykonawczy (Native Execution Engine) to zaawansowany komponent usługi Microsoft Fabric, który optymalizuje przetwarzanie danych i analitykę. Zwiększa wydajność, wykorzystując natywne możliwości bazowych źródeł danych. Silnik obsługuje różne operatory i typy danych, w tym rollup hash aggregate oraz broadcast nested loop join. Efektywnie przetwarza dane w formatach Parquet i Delta, dzięki czemu idealnie nadaje się do zapytań wymagających dużych nakładów obliczeniowych.
Funkcjonalność
Działanie w usłudze Microsoft Fabric
Natywny silnik wykonawczy działa bezproblemowo w ramach szerszej architektury Microsoft Fabric. Zwiększa wydajność Apache Spark, zastępując tradycyjne operatory wykonywane na maszynie JVM implementacjami natywnymi w języku C++. Tę zmianę umożliwiają technologie Velox i Apache Gluten, które optymalizują wykonywanie zapytań dzięki przetwarzaniu kolumnowemu i wektoryzacji. Ta integracja pozwala istniejącym aplikacjom Spark działać bez modyfikacji, a jednocześnie znacząco zwiększa efektywność złożonych transformacji i agregacji danych.
Integracja z lakehouse
Integracja natywnego silnika wykonawczego z architekturą lakehouse to prawdziwa rewolucja. Zapytania Spark można wykonywać bezpośrednio w infrastrukturze lakehouse, bez konieczności zmiany kodu. Ta możliwość obsługuje zarówno formaty Parquet, jak i Delta, co pozwala w pełni wykorzystać potencjał danych. Usprawnienia wydajności silnika mogą sięgać do 4 razy szybszego działania niż w tradycyjnym Sparku typu open source, co redukuje koszty operacyjne i zwiększa efektywność w różnych zadaniach związanych z danymi.
Kluczowe funkcje
Wykonywanie wektoryzowane
Jedną z najważniejszych cech natywnego silnika wykonawczego jest możliwość wykonywania wektoryzowanego. Pozwala ona silnikowi przetwarzać dane wsadowo, a nie wiersz po wierszu. Dzięki kolumnowym układom danych i zaawansowanym technikom przetwarzania w pamięci silnik może przewyższać tradycyjne silniki oparte na JVM, szczególnie w środowiskach chmurowych. Na przykład wewnętrzne testy porównawcze na zbiorze danych zawierającym miliard wierszy wykazały skrócenie czasu wykonania zapytania o 20–32 sekundy, co przekłada się na poprawę wydajności o 20–27%.
Usprawnienia wydajności
Natywny silnik wykonawczy oferuje kilka usprawnień wydajności, które wyróżniają go spośród innych silników wykonawczych. Oto najważniejsze z nich:
| Źródło | Opis | Poprawa wydajności |
|---|---|---|
| Apache Hudi | Zapytania do tabel Copy-on-Write | Skrócenie czasu wykonania o 33% |
| Google DataProc | Wydajność natywnego wykonywania | Do 2,7 razy szybciej |
| Microsoft Fabric | Wewnętrzne testy porównawcze na zbiorze danych zawierającym miliard wierszy | Skrócenie czasu wykonania o 20–32 sekundy na zapytanie, poprawa o 20–27% |
Te usprawnienia sprawiają, że Native Execution Engine jest solidnym wyborem dla organizacji, które chcą zoptymalizować przepływy pracy związane z przetwarzaniem danych. Dzięki sprawnej obsłudze złożonych transformacji i agregacji pozwala szybciej i skuteczniej wyciągać wnioski z danych.
Korzyści wydajnościowe Microsoft Fabric
Usprawnienia efektywności
Gdy pracujesz z dużymi wolumenami danych, efektywność staje się kluczowa. Native Execution Engine w usłudze Microsoft Fabric eliminuje typowe wąskie gardła, które spowalniają przetwarzanie danych. Przyspiesza obciążenia związane z formatami Parquet i Delta, płynnie obsługuje złożone transformacje i optymalizuje analityczne zapytania wymagające intensywnych obliczeń procesora. Oznacza to, że mniej czasu spędzasz na czekaniu, a więcej na analizie.
| Aspekt wydajności | Opis |
|---|---|
| Przyspieszenie działania | Znaczne przyspieszenie obciążeń Parquet i Delta, złożonych transformacji oraz zapytań wymagających intensywnych obliczeń procesora. |
| Wyniki testów porównawczych | Do 6× szybsze działanie w obciążeniach TPC-DS SF1000, co znacząco obniża koszty obliczeń. |
| Efektywność dostępu do pamięci | Wykorzystuje przetwarzanie kolumnowe i instrukcje SIMD, co zapewnia efektywny dostęp do pamięci i równoległość. |
| Integracja z optymalizatorem Spark | Zachowuje adaptacyjne wykonywanie zapytań, predicate pushdown i pozostałe optymalizacje Spark. |
| Widoczność przełączeń awaryjnych w czasie rzeczywistym | Pokazuje, kiedy nieobsługiwane operacje przełączają się z powrotem na wykonanie JVM, co pomaga monitorować wydajność. |
Ta efektywność ogranicza ukryte koszty, które często wiążą się z zarządzaniem środowiskami danych na dużą skalę. Nie marnujesz zasobów na zbędne cykle procesora ani narzut pamięci. Przetwarzanie kolumnowe i wektorowe wykonanie w Native Execution Engine pozwala szybciej skanować dane i zużywać mniej cykli procesora. Obniża to koszt pojedynczego zapytania i poprawia ogólną responsywność systemu.
Usprawnienia szybkości
Szybkość ma znaczenie, gdy chcesz otrzymywać terminowe wnioski z danych. Native Execution Engine zapewnia imponujące przyspieszenie bez konieczności zmiany istniejących aplikacji. Wiele organizacji raportuje, że zapytania działają 2× do 3× szybciej w różnych obciążeniach analitycznych, wystarczy po prostu włączyć ten silnik.
Oto, jak silnik osiąga te przyspieszenia:
- Spark tworzy logiczny i zoptymalizowany fizyczny plan, jak zwykle.
- Gluten identyfikuje operatory obsługiwane natywnie i zastępuje je szybszymi natywnymi odpowiednikami.
- Velox wykonuje te natywne operatory, korzystając z silnie zoptymalizowanych jąder C++.
- Jeśli operacja nie jest obsługiwana, silnik przełącza się na wykonanie JVM Spark, zapewniając płynne działanie.
Testy porównawcze na zbiorze danych z miliardem wierszy pokazują skrócenie czasu wykonania o 20–32 sekundy na zapytanie przy użyciu klastrowania z Native Execution Engine. Przekłada się to na wzrost wydajności o 20–27% w różnych kombinacjach kolumn klastrowanych. Takie usprawnienia pozwalają szybciej prowadzić analizy i ograniczają ukryte koszty związane z długotrwałymi zapytaniami.
⚡ Wskazówka: Wykorzystując te usprawnienia szybkości, możesz przyspieszyć przepływy pracy analitycznej i szybciej podejmować decyzje oparte na danych bez inwestowania w dodatkowy sprzęt.
Architektura Microsoft Fabric zapewnia, że korzyści te skalują się wraz z danymi. Wraz z rozrostem zbiorów danych silnik utrzymuje wysoką wydajność i efektywność kosztową. Ta skalowalność sprawia, że Fabric jest doskonałym wyborem dla przedsiębiorstw, które chcą optymalizować potoki analityczne, kontrolując przy tym wydatki.
Zastosowania Native Execution Engine
Native Execution Engine w usłudze Microsoft Fabric oferuje liczne zastosowania w praktyce, które usprawniają przetwarzanie danych i analitykę. Organizacje z różnych sektorów wykorzystują jego możliwości, aby usprawnić działanie i zyskiwać cenne wnioski.
Zastosowania w praktyce
Usługi finansowe: Banki i instytucje finansowe wykorzystują Native Execution Engine do szybkiego przetwarzania dużych zbiorów danych. Analizują dane transakcyjne w czasie rzeczywistym, dzięki czemu skuteczniej wykrywają oszustwa i oceniają ryzyko. Szybkość silnika zapewnia natychmiastowe wnioski, co ma kluczowe znaczenie w dynamicznym środowisku finansowym.
Opieka zdrowotna: Placówki opieki zdrowotnej używają tego silnika do zarządzania danymi pacjentów i przeprowadzania złożonych analiz. Dzięki przetwarzaniu danych z różnych źródeł mogą poprawiać wyniki leczenia pacjentów, wykorzystując analitykę predykcyjną. Zdolność silnika do efektywnej obsługi dużych wolumenów danych wspiera lepsze podejmowanie decyzji w warunkach klinicznych.
Handel detaliczny: Sprzedawcy detaliczni czerpią korzyści z Native Execution Engine dzięki optymalizacji łańcucha dostaw i zarządzania zapasami. Analizują dane o sprzedaży, aby prognozować popyt i odpowiednio dostosowywać poziom zapasów. Ta możliwość pomaga obniżać koszty i zwiększać zadowolenie klientów, zapewniając dostępność produktów.
Telekomunikacja: Firmy telekomunikacyjne wykorzystują silnik do analizy rekordów danych połączeń oraz metryk wydajności sieci. Ta analiza pomaga identyfikować trendy i optymalizować świadczenie usług. Wydajność silnika umożliwia monitorowanie w czasie rzeczywistym, co jest niezbędne do utrzymania jakości usług.
Scenariusze branżowe
Native Execution Engine doskonale sprawdza się w różnych scenariuszach branżowych, oferując dopasowane rozwiązania, które odpowiadają na konkretne wyzwania:
Inżynieria danych: W inżynierii danych silnik upraszcza przekształcanie surowych danych w użyteczne wnioski. Obsługuje złożone potoki danych, dzięki czemu organizacje mogą automatyzować swoje przepływy pracy z danymi. Ta możliwość ogranicza nakład pracy ręcznej i zwiększa produktywność.
Analityka dużych zbiorów danych: Firmy zajmujące się dużymi zbiorami danych korzystają ze zdolności silnika do szybkiego przetwarzania ogromnych ilości informacji. Pozwala on uruchamiać zaawansowane zapytania analityczne bez utraty wydajności. Ta efektywność ma kluczowe znaczenie dla organizacji, które opierają strategie na danych.
Business Intelligence: Silnik usprawnia aplikacje business intelligence, zapewniając szybsze odpowiedzi na zapytania. Użytkownicy mogą tworzyć interaktywne pulpity i raporty odzwierciedlające dane w czasie rzeczywistym. Ta natychmiastowość pozwala decydentom szybko działać na podstawie najnowszych wniosków.
Mimo swoich zalet wdrożenie Native Execution Engine może wiązać się z wyzwaniami. Na przykład złożoność ścieżek wykonania może wynikać z istnienia wielu silników wykonawczych. Taka złożoność utrudnia śledzenie zależności w potokach danych. Dodatkowo odpowiedzialność operacyjna rośnie, ponieważ zespoły zarządzają strojeniem wydajności i kontrolą kosztów w różnych silnikach.
⚡ Wskazówka: Zrozumienie tych wyzwań może pomóc w przygotowaniu płynniejszego wdrożenia Native Execution Engine w Twojej organizacji.
Wykorzystując Native Execution Engine, możesz przekształcić swoje strategie danych i w pełni odblokować potencjał możliwości analitycznych.
Porównanie z innymi silnikami wykonawczymi
Porównując Native Execution Engine z innymi silnikami wykonawczymi, zauważysz kilka różnic funkcjonalnych. Pokazują one, jak Native Execution Engine wyróżnia się pod względem wydajności i efektywności.
Różnice funkcjonalne
Model wykonania: Tradycyjne silniki wykonawcze często opierają przetwarzanie na Java Virtual Machine (JVM). Native Execution Engine natomiast wykorzystuje do swoich operacji język C++. Takie rozwiązanie przyspiesza wykonanie i zmniejsza narzut.
Przetwarzanie danych: Wiele silników przetwarza dane wiersz po wierszu. Native Execution Engine stosuje natomiast wykonanie wektorowe. Metoda ta przetwarza dane partiami, co znacząco przyspiesza zapytania analityczne.
Możliwości integracji: Podczas gdy niektóre silniki wymagają gruntownych modyfikacji, aby zintegrować się z istniejącymi systemami, Native Execution Engine oferuje modułową konstrukcję. Dzięki temu łatwiej jest włączyć go do bieżących przepływów danych bez większych zmian.
Przewagi konkurencyjne
Native Execution Engine zapewnia kilka przewag konkurencyjnych nad alternatywnymi silnikami wykonawczymi. Przewagi te wzmacniają możliwości przetwarzania danych i poprawiają ogólną wydajność. Oto podsumowanie tych korzyści:
| Przewaga konkurencyjna | Opis |
|---|---|
| Natywne wektorowe wykonywanie | Zwiększa efektywność wykorzystania zasobów procesora i ogranicza narzut związany z wykonywaniem opartym na JVM. |
| Zaawansowane optymalizacje | Obejmuje SIMD, leniwą ewaluację i adaptacyjne wykonywanie zapytań, które dodatkowo zwiększają wydajność. |
| Modułowa budowa | Umożliwia wielokrotne użycie komponentów, co ułatwia integrację z istniejącymi systemami. |
Dzięki tym przewagom konkurencyjnym możesz osiągnąć lepszą wydajność i skalowalność w zadaniach analitycznych na danych. Native Execution Engine nie tylko przyspiesza przetwarzanie, ale także optymalizuje wykorzystanie zasobów. Ta efektywność przekłada się na oszczędności kosztów i wyższą produktywność w organizacji.
⚡ Wskazówka: Oceniając silniki wykonawcze, zastanów się, jak ich unikalne funkcje odpowiadają konkretnym potrzebom w zakresie przetwarzania danych. Trafny wybór może znacząco wpłynąć na możliwości analityczne.
Przyszłość Native Execution Engine
Nadchodzące funkcje
Przyszłość Native Execution Engine rysuje się obiecująco, ponieważ na horyzoncie widać kilka interesujących funkcji. Te zmiany mają na celu wzmocnienie możliwości przetwarzania danych i poprawę ogólnej wydajności. Oto najważniejsze nadchodzące funkcje:
- Materialized Lake Views (MLV): Te widoki wzmocnią wdrażanie architektury medalionowej. Sprawią, że potoki będą gotowe do użycia produkcyjnego, co umożliwi bardziej efektywne przepływy danych.
- Narzędzia inżynierskie wspomagane AI: Wprowadzenie ulepszonych narzędzi, takich jak Copilot, wskazuje na silne dążenie do integracji możliwości AI z przepływami pracy inżynierii danych. Ta integracja usprawni procesy i zwiększy produktywność.
- Zunifikowane zarządzanie pamięcią: Silnik zoptymalizuje zarządzanie pamięcią, co znacząco poprawi wydajność dla inżynierów danych i naukowców danych. Dzięki ominięciu mechanizmu odzyskiwania pamięci (garbage collector) maszyny wirtualnej Java ograniczy wąskie gardła wydajności.
Te funkcje wpisują się w aktualne trendy w chmurowym przetwarzaniu danych. Pomogą sprostać wymaganiom czasu rzeczywistego i niskiego opóźnienia, niezbędnym w nowoczesnych aplikacjach.
Znaczenie dla analityki
Rozwój Native Execution Engine będzie miał istotne znaczenie dla analityki i business intelligence. W miarę jego rozwoju możesz spodziewać się następujących korzyści:
- Wyższa wydajność: Native Execution Engine już teraz zapewnia 6-krotnie wyższą wydajność w porównaniu z otwartoźródłowym Sparkiem, bez konieczności zmian w kodzie. Ta poprawa pozwoli uruchamiać złożone analizy sprawniej.
- Wgląd w czasie rzeczywistym: Dzięki zdolności do obsługi zróżnicowanych typów danych silnik będzie wspierał wysokoprzepustowe pozyskiwanie danych oraz zapytania hybrydowe o bardzo niskim opóźnieniu. Ta możliwość ma kluczowe znaczenie dla analityki w czasie rzeczywistym i procesów napędzanych przez AI.
- Zoptymalizowane wykorzystanie zasobów: Architektura będzie nadal optymalizować wykorzystanie zasobów, zgodnie z zasadami natywnymi dla chmury. Ta optymalizacja pomoże kontrolować koszty przy zachowaniu wysokiej wydajności.
Wraz z wdrażaniem tych funkcji przekonasz się, że Native Execution Engine nie tylko wzmacnia możliwości analityczne, ale także pozwala szybciej podejmować decyzje oparte na danych. Przyszłość analityki danych rysuje się w jasnych barwach dzięki tym innowacjom.
⚡ Wskazówka: Śledź na bieżąco te zmiany, aby w pełni wykorzystać potencjał Native Execution Engine w swoich procesach analitycznych.
Podsumowując, Native Execution Engine w usłudze Microsoft Fabric odgrywa kluczową rolę w zwiększaniu możliwości przetwarzania danych. Dzięki technologiom takim jak Apache Gluten i Velox silnik koncentruje się na wykonywaniu wektorowym oraz kompilacji just-in-time (JIT). Taka konstrukcja znacząco przyspiesza wykonywanie zapytań i ogranicza opóźnienia, dzięki czemu możesz sprawnie obsługiwać złożone zadania na danych.
Patrząc w przyszłość, Native Execution Engine obiecuje jeszcze więcej usprawnień. Przezwycięża ograniczenia tradycyjnego wykonywania Spark, zapewniając szybsze wykonywanie zapytań i znaczne oszczędności kosztów. Według testów porównawczych, które pokazują nawet sześciokrotne przyspieszenie i redukcję kosztów o około 83%, ten silnik sprawdza się jako skalowalne i wydajne rozwiązanie dla nowoczesnej analityki danych. Jeśli chcesz zgłębić, jak te koncepcje przekładają się na raportowanie i wydajność OneLake, koniecznie posłuchaj naszego powiązanego odcinka podcastu: Speed Power BI with OneLake and Direct Lake!
⚡ Wskazówka: Wykorzystaj Native Execution Engine, aby w pełni odblokować potencjał swoich procesów analitycznych i utrzymać przewagę w świecie opartym na danych.
Najczęściej zadawane pytania
Czym jest Native Execution Engine w usłudze Microsoft Fabric?
Native Execution Engine to warstwa o wysokiej wydajności w usłudze Microsoft Fabric, która przyspiesza przetwarzanie danych dzięki natywnemu kodowi C++. Usprawnia wykonywanie zapytań i obniża koszty bez konieczności zmieniania istniejących aplikacji.
Jak Native Execution Engine poprawia wydajność?
Silnik korzysta z wykonywania wektorowego i przetwarzania danych w formie kolumnowej, dzięki czemu szybciej obsługuje duże zbiory danych. Takie podejście zmniejsza zużycie procesora i przyspiesza złożone zapytania, co pozwala szybciej uzyskiwać wnioski.
Czy mogę używać Native Execution Engine z istniejącymi obciążeniami Spark?
Tak, możesz. Silnik bezproblemowo integruje się z Spark, zastępując część operacji JVM kodem natywnym. Aby skorzystać z lepszej wydajności, nie musisz przepisywać swojego kodu.
Jakie formaty danych obsługuje Native Execution Engine?
Silnik obsługuje popularne formaty, takie jak Parquet i Delta. Ta zgodność pozwala wydajnie wykonywać zapytania bezpośrednio na danych w lakehouse w usłudze Microsoft Fabric.
Jak Native Execution Engine wpływa na zarządzanie kosztami?
Dzięki przyspieszeniu zapytań i ograniczeniu zużycia zasobów silnik obniża koszty obliczeniowe. Oszczędzasz pieniądze, zyskując jednocześnie szybszy dostęp do wniosków z danych.
Czy Native Execution Engine nadaje się do analityki w czasie rzeczywistym?
Zdecydowanie tak. Obsługuje zapytania o niskim opóźnieniu i pozyskiwanie danych o dużej przepustowości, co pozwala uzyskiwać wnioski w czasie rzeczywistym i podejmować terminowe decyzje.
Które branże najbardziej korzystają z Native Execution Engine?
Branże takie jak finanse, ochrona zdrowia, handel detaliczny i telekomunikacja zyskują dzięki szybszemu przetwarzaniu danych i lepszej analityce, co pomaga szybko reagować na wnioski.
Jak mogę monitorować wydajność Native Execution Engine?
Usługa Microsoft Fabric udostępnia narzędzia do śledzenia, kiedy wykonanie natywne jest uruchamiane, a kiedy przechodzi na JVM. Ta widoczność pomaga skutecznie optymalizować przepływy pracy z danymi.