 RU
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Українська
 العربية
 עברית
 日本語
 한국어
Разоблачаем миф о задержках: локальный процесс против корпоративного HTTP
By Mirko Peters ·
Добро пожаловать в очередной технический разбор архитектуры корпоративных систем и современного системного дизайна. В этой статье мы развиваем тему, которая часто вызывает споры among разработчиков ПО и системных архитекторов: какова на самом деле задержка в распределённых приложениях по сравнению с локальными процессами. При проектировании высокопроизводительных систем, особенно тех, что связываю
Automatically translated with AI from the original post. Read the English original
Добро пожаловать в очередной технический разбор архитектуры корпоративных систем и современного системного дизайна. В этой статье мы развиваем тему, которая часто вызывает споры между разработчиками ПО и системными архитекторами: какова на самом деле задержка в распределённых приложениях по сравнению с локальными процессами. При проектировании высокопроизводительных систем, особенно тех, что связывают десктопных ИИ-ассистентов с облачными платформами данных, разработчики нередко попадают в ловушку микробенчмарков. Они смотрят на чистую скорость передачи и считают, что межпроцессное взаимодействие на локальной машине по определению быстрее сетевого корпоративного HTTP. Но, как мы разберём в этой статье, это миф.
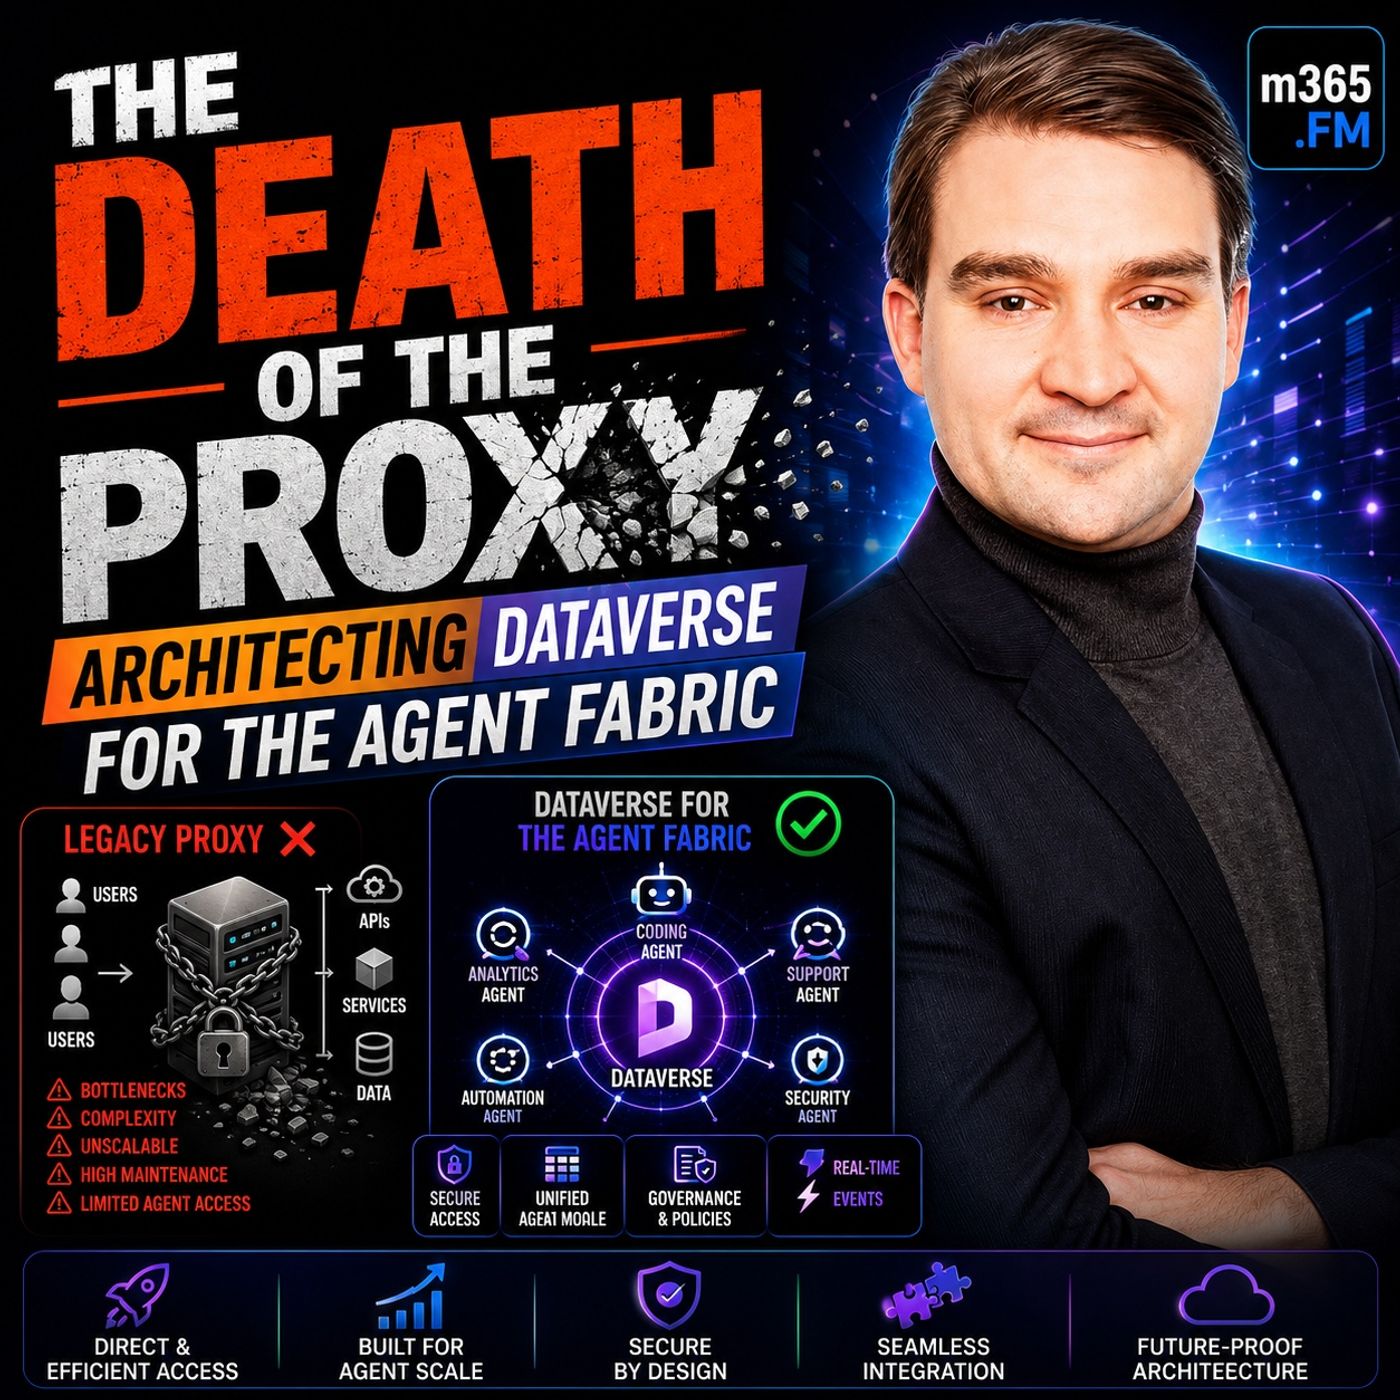
Эта тема напрямую связана с нашим недавним подкастом. Если вы его ещё не слушали, обязательно посмотрите THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric, где мы разбираем, как современные архитектуры отходят от хрупких локальных прокси к надёжным масштабируемым корпоративным HTTP-эндпоинтам.
Введение в миф о задержках в корпоративном ИИ
Эволюция корпоративного ПО заставила пересмотреть то, как клиентские приложения взаимодействуют с серверными системами. Нигде это не заметно так явно, как в архитектуре интеграции корпоративного ИИ. Долгие годы локальные инструменты вроде STDIO-прокси считались основным решением для подключения десктопных приложений к облачным базам данных. Их было просто установить, инфраструктура требовалась минимальная, а при локальном тестировании они работали практически мгновенно.
Однако по мере того как организации переходят от изолированных экспериментов разработчиков к развёртыванию на уровне всей компании с сотнями и тысячами ИИ-агентов, эти допущения начинают разрушаться. Инженеры, защищающие локальные процессы, часто называют задержку транспорта главным решающим фактором. Они утверждают, что HTTP добавляет сетевые накладные расходы, TCP-рукопожатия и согласование TLS, тогда как локальная передача данных занимает считаные микросекунды. Однако этот аргумент опирается на фундаментальное непонимание того, где на самом деле уходит время в реальной корпоративной транзакции. Чтобы по-настоящему понять производительность, нужно выйти за пределы транспортного уровня и рассмотреть всю нагрузку целиком.
Микробенчмарки против реальных корпоративных нагрузок
Микробенчмарки обманчивы, и это хорошо известно. В изолированной тестовой среде измерение чистого времени передачи JSON-нагрузки через локальный STDIO-канал и через петлевой HTTP-интерфейс почти always окажется в пользу локального процесса. Цифры выглядят неоспоримо: единицы миллисекунд для локальных каналов против десятков миллисекунд для сетевых петель.
Проблема в том, что микробенчмарки отбрасывают реальность выполнения корпоративного ПО. Когда ИИ-агент запрашивает данные у такой надёжной платформы, как Dataverse, транспортный механизм составляет лишь малую часть уравнения. За этим эндпоинтом стоит сложная цепочка операций:
- Проверка личности и валидация токенов через Microsoft Entra ID
- Контроль доступа на основе ролей (RBAC) и проверки границ безопасности
- Выполнение сложной бизнес-логики, плагинов и пользовательских рабочих процессов
- Компиляция запросов к базе данных, оценка индексов и физическое извлечение данных
- Сериализация и десериализация богатых корпоративных моделей данных
Когда выполнение запроса к базе данных и бизнес-логики занимает триста миллисекунд, экономия четырёх миллисекунд на транспорте становится совершенно незначительной. Узкое место никогда не в проводе, а в вычислениях, необходимых для выполнения бизнес-запроса. Когда архитекторы оптимизируют транспортный уровень, игнорируя операционную нагрузку бэкенд-логики, они оптимизируют не ту часть стека.
Истинная цена накладных расходов на транспорт
Хотя локальное межпроцессное взаимодействие демонстрирует впечатляющую теоретическую скорость, оно скрывает огромные операционные и инфраструктурные издержки, которые накапливаются с ростом масштаба. Представьте, что произойдёт, если каждый пользователь будет запускать собственный локальный процесс, чтобы связать ИИ-клиент с облачным сервисом.
Каждый отдельный экземпляр локального прокси несёт собственные издержки на запуск, собственную инициализацию процесса и собственный изолированный жизненный цикл аутентификации. Кроме того, каждый локальный процесс должен самостоятельно управлять своими подключениями, учётными данными безопасности и состояниями ошибок. Если в организации пятьсот разработчиков или автоматизированных агентов запускают локальные прокси, это означает пятьсот отдельных конвейеров подключений, каждый из которых пытается договориться с серверными ресурсами.
На фоне правильно настроенной корпоративной HTTP-конечной точки скрытые издержки локальной модели становятся очевидны. Локальные процессы не могут легко разделять состояние, глобально кэшировать рукопожатия соединений или эффективно объединять ресурсы между разными клиентскими приложениями. Кажущаяся скорость локального процесса оказывается иллюзией, которая рушится, как только в картину вступают параллельность и фрагментация системы.
Как пулинг соединений выигрывает гонку производительности
Именно здесь корпоративный HTTP кардинально меняет картину производительности. В отличие от эфемерных локальных процессов, которые многократно поднимают и разрывают соединения, промышленные HTTP-сервисы используют продвинутый пулинг соединений, постоянные сессии и долгоживущую серверную инфраструктуру.
Когда корпоративный HTTP-клиент подключается к общему сервису, первоначальные затраты на рукопожатие, такие как DNS-поиск, TCP slow-start и согласование TLS, происходят один раз. Последующие запросы идут по уже установленным постоянным соединениям. Кроме того, поскольку эти соединения объединены в пул и управляются централизованным сервисным уровнем, система может поддерживать «прогретые» подключения к базам данных, предварительно аутентифицированные сессии и кэшированные схемы метаданных.
В правильно настроенной корпоративной среде эти оптимизации означают, что непрерывный поток HTTP-запросов может фактически обеспечить более низкую среднюю сквозную задержку, чем разросшееся созвездие несогласованных локальных процессов. Накладные расходы на сеть распределяются между тысячами молниеносных постоянных транзакций, и первоначальная транспортная задержка становится полностью несущественной.
Масштабирование корпоративного HTTP и накладные расходы локальных процессов
Масштабирование программной архитектуры — главный тест её принципов проектирования. Когда компания переходит от поддержки нескольких помощников разработчиков к развёртыванию полноценной экосистемы ИИ-инструментов, включая GitHub Copilot, Claude Code, собственные оркестраторы и внутренние Copilot CLI, операционная реальность локальных процессов становится неустойчивой.
Управление сотнями разрозненных прокси-процессов ведёт к серьёзному административному дрейфу. Централизованной видимости нет, мониторинг фрагментирован, а поиск периодических сбоев на разных локальных машинах превращается для ИТ-администраторов в кошмар. Управление безопасностью становится набором локальных конфигураций, а не единой, применимой политикой.
Напротив, масштабирование корпоративной HTTP-архитектуры линейно и предсказуемо. Вместо того чтобы умножать инфраструктуру на каждом пользовательском рабочем месте, организации масштабируют один высокодоступный сервис за корпоративным балансировщиком нагрузки. Когда спрос растёт, вы просто запускаете дополнительные серверные экземпляры. Клиенты продолжают обращаться к той же управляемой конечной точке, а платформа прозрачно обеспечивает горизонтальное масштабирование, распределение нагрузки и телеметрию. Механизмы безопасности, такие как PKCE (Proof Key for Code Exchange), позволяют публичным десктопным клиентам безопасно проходить аутентификацию без хранения жёстко заданных секретов, сочетая надёжное корпоративное управление с удобством для разработчиков.
Вывод: приоритет бизнес-логики над микрооптимизациями
Устойчивая привлекательность межпроцессного взаимодействия через локальные каналы — классический пример того, как микрооптимизация заслоняет архитекторам макроуровневые реалии. Локальные каналы могут выиграть синтетический бенчмарк на несколько миллисекунд, но они создают колоссальную операционную сложность, разрушают корпоративную безопасность и плохо масштабируются в современных средах, построенных на ИИ. Смещая фокус с транспортного уровня на надёжные корпоративные HTTP-архитектуры с пулингом соединений, мы создаём системы, которые безопасны, масштабируемы и действительно готовы к требованиям современного предприятия.
Чтобы глубже разобраться в том, как такие платформы, как Dataverse, эволюционируют и становятся единой основой данных для всей агентной фабрики (agent fabric), обязательно послушайте выпуск целиком: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. Спасибо, что читаете, и следите за новыми глубокими разборами корпоративной облачной архитектуры!