 UK
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 العربية
 עברית
 日本語
 한국어
Розвінчуємо міф про затримку: локальний процес проти корпоративного HTTP
By Mirko Peters ·
Вітаємо знову в наших технічних розборах корпоративної архітектури та сучасного проєктування систем. У цьому дописі ми розвиваємо тему, яка часто викликає суперечки серед інженерів програмного забезпечення та системних архітекторів: справжня природа затримки в розподілених застосунках порівняно з локальними процесами. Проєктуючи високопродуктивні системи, особливо ті, що з'єднують настільні ШІ-аси
Automatically translated with AI from the original post. Read the English original
Вітаємо знову в наших технічних розборах корпоративної архітектури та сучасного проєктування систем. У цьому дописі ми розвиваємо тему, яка часто викликає суперечки серед інженерів програмного забезпечення та системних архітекторів: справжня природа затримки в розподілених застосунках порівняно з локальними процесами. Проєктуючи високопродуктивні системи, особливо ті, що з'єднують настільні ШІ-асистенти з хмарними платформами даних на бекенді, розробники часто потрапляють у пастку мікробенчмарків. Вони дивляться на чисту швидкість передавання даних і вважають, що локальна взаємодія між процесами універсально краща за мережевий корпоративний HTTP. Але, як ми розберемо в цій статті, це міф.
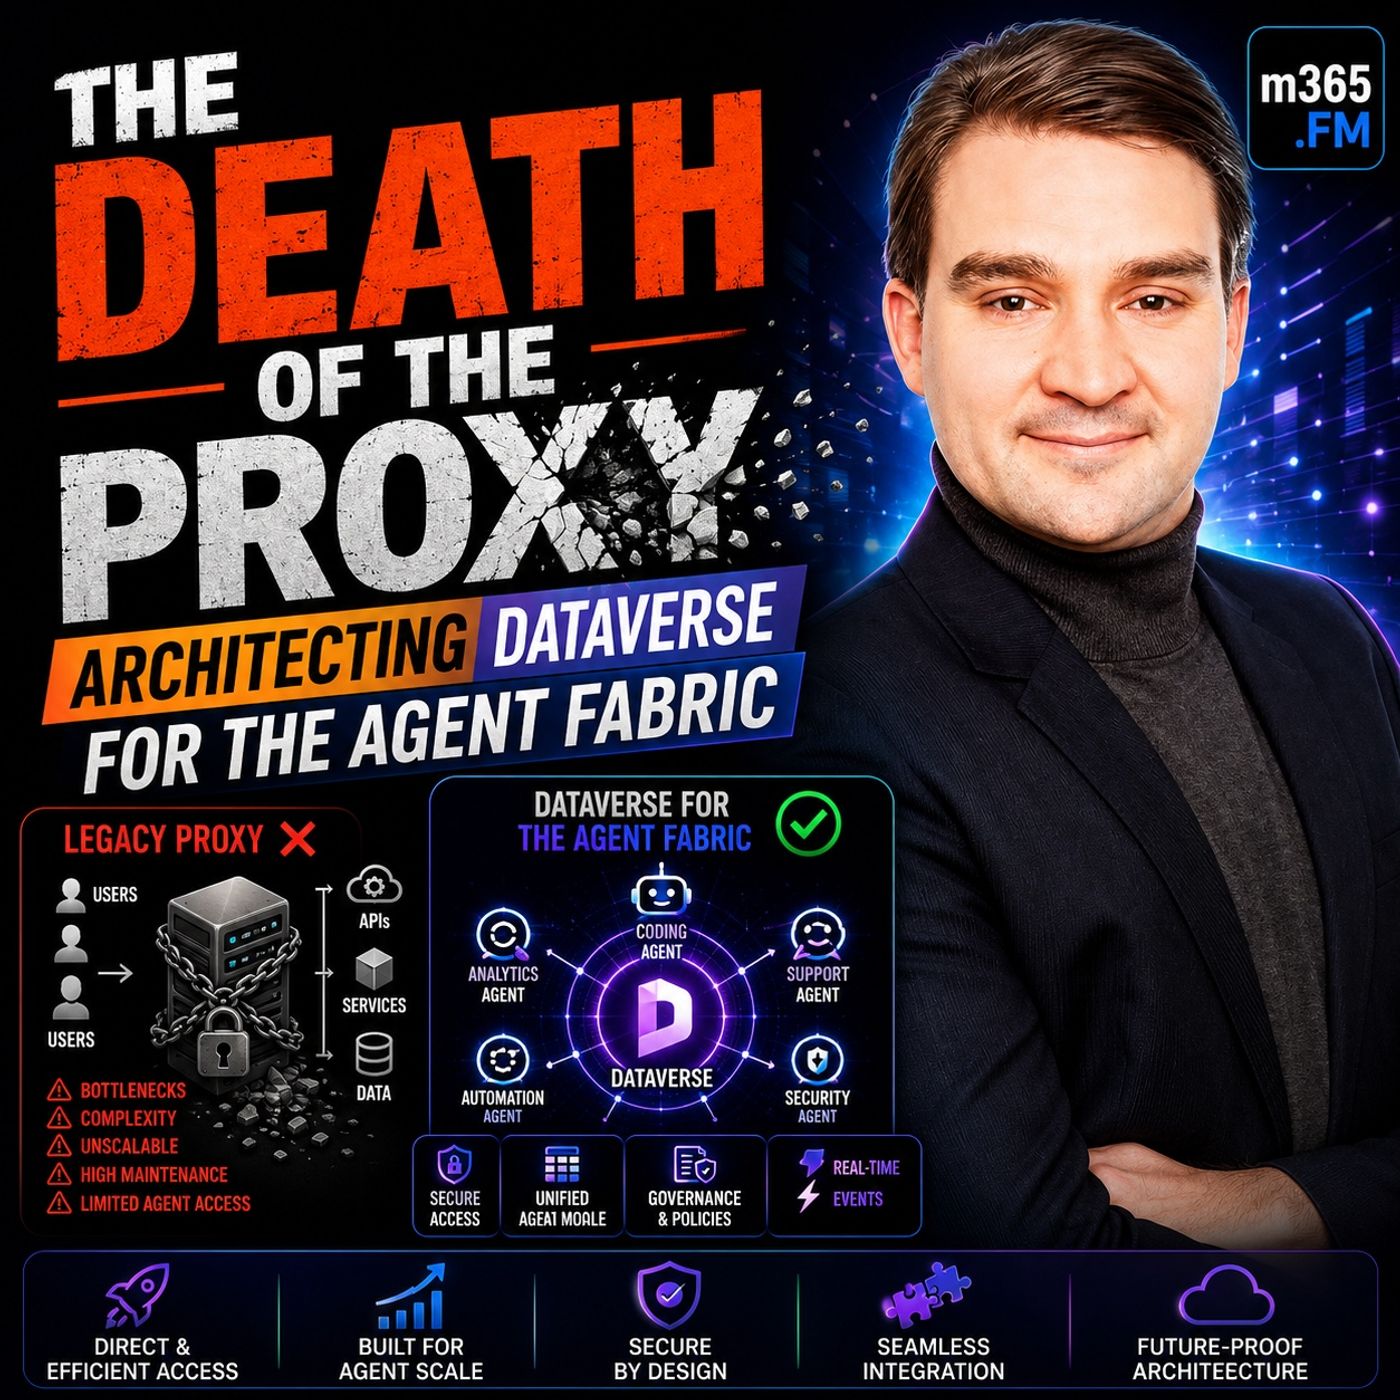
Ця тема безпосередньо пов'язана з нещодавньою розмовою з нашого подкасту. Якщо ви ще не слухали, обов'язково перегляньте THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric, де ми розбираємо, як сучасні архітектури відходять від крихких локальних проксі до надійних, масштабованих корпоративних HTTP-endpoint'ів.
Вступ: міф про затримку в корпоративному ШІ
Розвиток корпоративного програмного забезпечення змусив переглянути підхід до взаємодії між клієнтами та бекенд-системами. Найочевидніше це видно в архітектурі інтеграції ШІ в підприємствах. Упродовж багатьох років локальні інструменти на кшталт STDIO-проксі були основною рекомендацією для підключення настільних застосунків до хмарних баз даних. Їх було просто встановити, вони потребували мінімальної інфраструктури й здавалися миттєвими під час локального тестування.
Проте щойно організації переходять від ізольованих експериментів розробників до розгортань у масштабах підприємства, де працюють сотні чи тисячі ШІ-агентів, ці локальні припущення починають давати тріщини. Інженери, які відстоюють локальні процеси, часто називають затримку транспорту вирішальним фактором. Вони стверджують, що HTTP додає мережеві накладні витрати, TCP-рукостискання та узгодження TLS, тоді як локальна передача працює лічені мікросекунди. Проте цей аргумент ґрунтується на фундаментальному непорозумінні того, де насправді витрачається час у реальній корпоративній транзакції. Щоб по-справжньому зрозуміти продуктивність, потрібно вийти за межі транспортного рівня і подивитися на загальне навантаження.
Мікробенчмарки проти реальних корпоративних навантажень
Мікробенчмарки на диво оманливі. В ізольованому тестовому середовищі вимірювання чистого часу передавання JSON-пейлоада через локальний STDIO-канал порівняно з HTTP-петлею loopback майже завжди виграватиме локальний процес. Цифри виглядають переконливо: одиниці мілісекунд для локальних каналів проти десятків мілісекунд для мережевих петель.
Проблема в тому, що мікробенчмарки відкидають реальність виконання корпоративного програмного забезпечення. Коли ШІ-агент запитує дані з потужної платформи на кшталт Dataverse, транспортний механізм становить лише частку рівняння. За цим endpoint'ом стоїть складний ланцюжок операцій:
- Перевірка особи та валідація токенів через Microsoft Entra ID
- Контроль доступу на основі ролей (RBAC) і перевірка меж безпеки
- Виконання складної бізнес-логіки, плагінів і власних робочих процесів
- Компіляція запитів до бази даних, оцінка індексів і фізичне отримання даних
- Серіалізація та десеріалізація багатих моделей корпоративних даних
Коли ваш запит до бази даних і бізнес-логіка виконуються триста мілісекунд, economy чотирьох мілісекунд на накладних витратах транспорту стає абсолютно несуттєвою. Вузьке місце ніколи не в каналі зв'язку, а в обчисленнях, необхідних для виконання бізнес-запиту. Коли архітектори оптимізують транспортний рівень і ігнорують операційне навантаження бекенд-логіки, вони оптимізують не ту частину стеку.
Справжня ціна транспортних накладних витрат
Хоча локальна взаємодія між процесами має вражаючу теоретичну швидкість, вона приховує величезні операційні та інфраструктурні накладні витрати, які накопичуються в масштабі. Подумайте, що відбувається, коли кожен окремий користувач запускає власний локальний процес, щоб з'єднати ШІ-клієнт із хмарним сервісом.
Кожен окремий екземпляр локального проксі має власні витрати на запуск, власні накладні витрати на ініціалізацію процесу та власний ізольований життєвий цикл автентифікації. Крім того, кожен локальний процес мусить самостійно керувати своїми підключеннями, обліковими даними безпеки та станами помилок. Якщо в організації п’ятсот розробників або автоматизованих агентів запускають локальні проксі, це означає п’ятсот окремих каналів з’єднання, які намагаються встановити зв’язок із серверними ресурсами.
Порівняно з правильно налаштованою корпоративною HTTP-кінцевою точкою, приховані витрати локальної моделі стають очевидними. Локальні процеси не можуть легко спільно використовувати стан, глобально кешувати рукостискання з’єднань або ефективно об’єднувати ресурси для різних клієнтських застосунків. Відчуття швидкості локального процесу є ілюзією, яка руйнується, щойно на сцену виходять конкурентність і фрагментація системи.
Як пулінг з’єднань виграє гонку продуктивності
Саме тут корпоративний HTTP суттєво змінює картину продуктивності. На відміну від короткочасних локальних процесів, які щоразу піднімають і закривають з’єднання, промислові HTTP-сервіси використовують продумане пулінг з’єднань, постійні сесії та довготривалу серверну інфраструктуру.
Коли корпоративний HTTP-клієнт підключається до спільного сервісу, початкові витрати на рукостискання, зокрема пошук DNS, TCP slow-start і узгодження TLS, відбуваються лише один раз. Наступні запити передаються через уже встановлені постійні з’єднання. Крім того, оскільки ці з’єднання пулються й керуються централізованим сервісним рівнем, система може підтримувати теплі підключення до баз даних, попередньо автентифіковані сесії та кешовані схеми метаданих.
У правильно налаштованому корпоративному середовищі ці оптимізації означають, що безперервний потік HTTP-запитів може забезпечити нижчу середню затримку від початку до кінця, ніж розрізнений набір некоординованих локальних процесів. Накладні витрати мережі розподіляються на тисячі блискавичних постійних транзакцій, і початковий штраф за транспорт стає повністю неістотним.
Масштабування корпоративного HTTP проти накладних витрат локальних процесів
Масштабування архітектури програмного забезпечення є найсуворішим випробуванням її принципів проєктування. Коли організація переходить від підтримки кількох помічників розробників до розгортання повноцінної екосистеми ШІ-інструментів, зокрема GitHub Copilot, Claude Code, власних оркестраторів і внутрішніх Copilot CLI, операційна реальність локальних процесів стає неприйнятною.
Керування сотнями розрізнених проксі-процесів призводить до серйозного адміністративного дрейфу. Централізованої видимості немає, моніторинг фрагментований, а усунення періодичних збоїв на різних локальних машинах перетворюється на кошмар для ІТ-адміністраторів. Управління безпекою стає лоскутною ковдрою локальних конфігурацій замість єдиної, придатної до примусового застосування політики.
На противагу цьому, масштабування корпоративної HTTP-архітектури є лінійним і передбачуваним. Замість того щоб множити інфраструктуру на кожній робочій станції користувача, організації масштабують один високодоступний сервіс за корпоративним балансувальником навантаження. Коли попит зростає, ви просто піднімаєте додаткові серверні екземпляри. Клієнти продовжують звертатися до тієї самої керованої кінцевої точки, а платформа прозоро забезпечує горизонтальне масштабування, розподіл навантаження й телеметрію. Засоби безпеки на кшталт PKCE (Proof Key for Code Exchange) дозволяють публічним настільним клієнтам безпечно автентифікуватися без зберігання жорстко закодованих секретів, поєднуючи надійне корпоративне управління з зручністю для розробників.
Висновок: пріоритет бізнес-логіки над мікрооптимізаціями
Стійка привабливість локальної взаємодії процесів є класичним прикладом того, як мікрооптимізації заслоняють архітекторам макрорівневі реалії. Хоча локальні канали можуть виграти синтетичний бенчмарк на кілька мілісекунд, вони створюють величезну операційну складність, підривають безпеку підприємства та погано масштабуються в сучасних середовищах, керованих ШІ. Переходячи від транспортного рівня до надійних корпоративних HTTP-архітектур із пулінгом з’єднань, ми будуємо системи, які є безпечними, масштабованими й справді готовими до вимог сучасного підприємства.
Щоб глибше розібратися в тому, як такі платформи, як Dataverse, еволюціонують у єдину основу даних для всієї агентної фабрики, обов’язково послухайте повний епізод: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. Дякую, що читаєте, і слідкуйте за новими глибокими розборами корпоративної хмарної архітектури!