 FR
 English
 Deutsch
 Español
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Pourquoi les modèles sémantiques et les ontologies de Microsoft Fabric sont indispensables pour la préparation de l’IA en entreprise
By Mirko Peters ·
Découvrez pourquoi connecter directement des LLM à un stockage brut échoue. Découvrez comment les modèles sémantiques, les métadonnées et les ontologies de Microsoft Fabric garantissent la préparation de l’IA en entreprise.
Automatically translated with AI from the original post. Read the English original
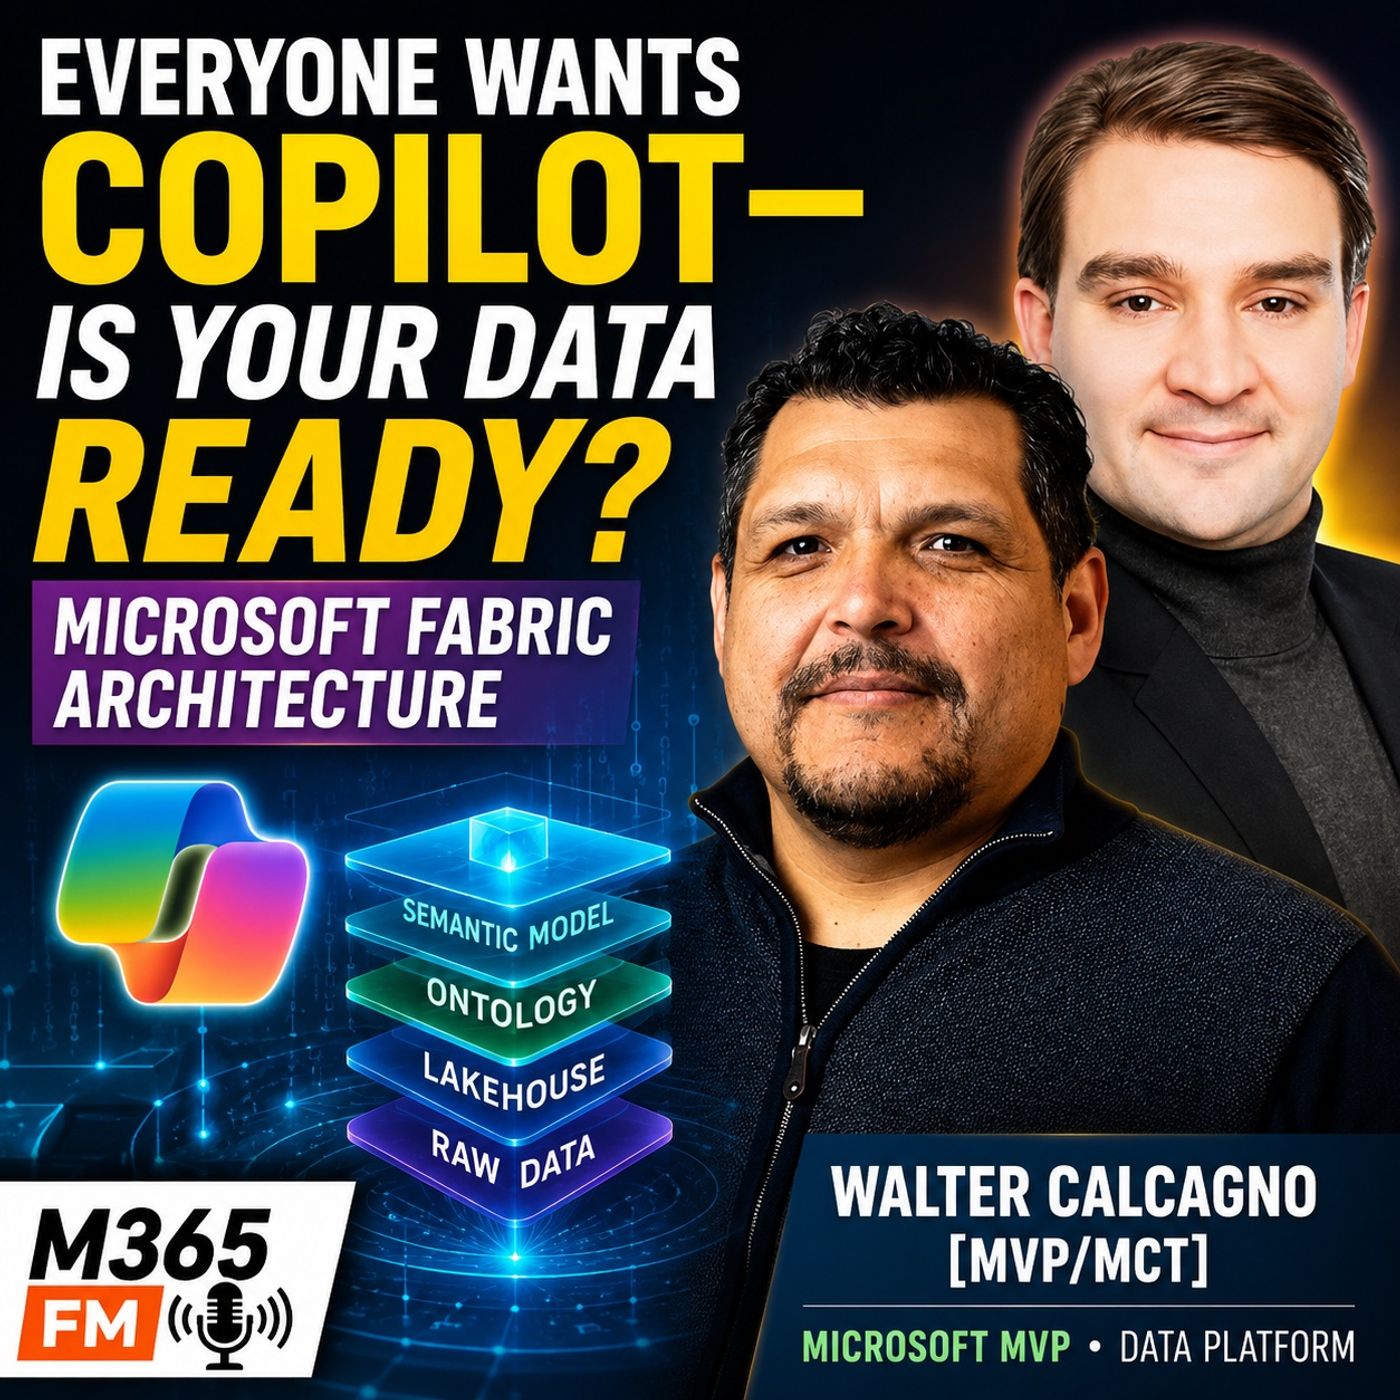
Découvrez pourquoi connecter un grand modèle de langage directement à un stockage de base de données brut entraîne une consommation coûteuse de tokens, des hallucinations et des risques de sécurité. Apprenez comment les modèles sémantiques, les cartes de métadonnées et les ontologies de Microsoft Fabric comblent le fossé entre des données d’entreprise désordonnées et des agents IA fiables.
Points clés
- Connecter directement des LLM à un stockage cloud brut contourne les couches architecturales critiques nécessaires à la compréhension du contexte métier.
- Les modèles sémantiques de Microsoft Fabric structurent les données métier, mais les grandes organisations ont besoin d’ontologies pour cartographier les relations entre des domaines disparates.
- Les métadonnées jouent le rôle d’un GPS pour les systèmes d’IA : elles réduisent la consommation coûteuse de tokens en orientant directement les modèles vers les informations pertinentes, au lieu d’analyser l’ensemble des données.
- L’IA en entreprise exige des définitions métier explicites pour des indicateurs comme le chiffre d’affaires ou le taux d’attrition, afin d’éviter que les modèles n’inventent des métriques contradictoires.
- Une gouvernance des données solide et des autorisations appropriées sont indispensables avant de déployer des interfaces en langage naturel sur des actifs sensibles de l’entreprise.
L’illusion d’une connectivité directe de l’IA dans les environnements d’entreprise
Les organisations se précipitent pour adopter Copilot et des agents IA personnalisés, séduites par la promesse d’une interaction en langage naturel avec leurs données. Les dirigeants souhaitent que les collaborateurs posent des questions simples, comme « Quelles ont été nos gammes de produits les plus performantes au dernier trimestre ? », et obtiennent des réponses immédiates et fiables. Toutefois, un écueil architectural majeur apparaît lorsque les équipes supposent qu’il suffit de diriger un LLM ou un système de génération augmentée par récupération (RAG) vers des comptes de stockage cloud, des data lakes ou des tables non organisées existants.
Les données brutes manquent de contexte. Sans couches structurées, un grand modèle de langage ne comprend pas nativement si une colonne intitulée « revenue » inclut les remboursements, les taxes ou les produits différés. Laisser un modèle d’IA interpréter seul les lignes et les colonnes brutes introduit des risques sérieux, notamment des hallucinations, des calculs erronés et un surcoût coûteux en tokens. Atteindre une véritable préparation à l’IA exige une architecture de données réfléchie, qui commence bien avant la rédaction du premier prompt.
Au-delà des modèles sémantiques : le rôle des ontologies dans Microsoft Fabric
Dans l’écosystème Microsoft Fabric, les modèles sémantiques fournissent des représentations structurées des données métier, optimisées pour l’analyse et le reporting. Ils transforment des tables delta brutes en entités métier reconnaissables. Toutefois, les grandes entreprises fonctionnent rarement avec un seul modèle sémantique. Les différents services, comme la finance, les ventes, les ressources humaines ou la chaîne d’approvisionnement, disposent souvent de modèles sémantiques distincts, adaptés à leurs besoins opérationnels spécifiques.
Tenter de résoudre cette fragmentation en regroupant toute une entreprise dans un seul modèle sémantique massif et monolithique réussit rarement. Les architectes de données modernes s’appuient plutôt sur une couche d’ontologie. Une ontologie décrit les relations, les dépendances et les parcours contextuels entre plusieurs modèles. En combinant des modèles sémantiques structurés et une couche d’ontologie robuste, les organisations fournissent aux systèmes d’IA une feuille de route de navigation qui préserve le sens métier, les relations structurelles et les contrôles d’accès.
Les métadonnées comme carte pour une navigation efficace des LLM
L’un des aspects les plus négligés de l’implémentation de l’IA en entreprise est la réalité économique de la consommation de jetons. Envoyer d’énormes volumes de données inutiles et de fichiers non structurés dans la fenêtre de contexte d’un LLM fait grimper les coûts d’exploitation tout en dégradant la qualité des réponses du modèle.
Une analogie utile consiste à voyager dans un pays inconnu. Vous ne parcourez pas chaque rue résidentielle à la recherche de votre destination ; vous empruntez les autoroutes, les routes régionales et des cartes locales pour arriver directement à la bonne adresse. Les métadonnées jouent exactement le même rôle de carte de navigation pour un système d’IA. Des balises de métadonnées solides, des définitions de schéma et un catalogage aident le modèle à localiser précisément l’endroit où se trouvent les informations fiables. Sans métadonnées, les agents d’IA doivent travailler davantage, consommer plus de ressources de calcul et deviner l’emplacement des données, ce qui conduit à une business intelligence peu fiable.
Lever l’ambiguïté : des définitions partagées pour l’IA d’entreprise
Des termes métier essentiels comme « client », « employé actif », « marge » et « churn » ont souvent des sens différents selon l’interlocuteur au sein d’une organisation. Par exemple, le marketing peut définir un prospect actif autrement que les ventes ne définissent un compte actif. Demander à un LLM d’arbitrer seul ces définitions contradictoires est une recette pour le désastre.
Les organisations doivent codifier explicitement leurs définitions métier, leurs indicateurs clés de performance (KPI) et leurs règles de calcul avant d’exposer les données aux outils d’IA. Fournir des instructions claires dans les métadonnées et des garde-fous sémantiques garantit que l’IA apprend la manière dont les concepts sont définis au sein de cette culture d’entreprise spécifique. Des règles métier claires protègent l’organisation contre la désinformation automatisée et maintiennent la cohérence de chaque interaction utilisateur.
Conclusion
Adopter l’IA d’entreprise est avant tout un cheminement de maturité organisationnelle et de rigueur architecturale, plutôt qu’une simple installation logicielle. En investissant dans des couches sémantiques adaptées, une cartographie complète des métadonnées et une gouvernance stricte des données au sein de plateformes comme Microsoft Fabric, les entreprises peuvent transformer des silos de données fragmentés en actifs fiables capables d’alimenter en toute sécurité les outils d’IA modernes.
Pour approfondir ces concepts d’architecture des données, notamment l’évaluation de la préparation à l’IA en cinq dimensions et le modèle d’architecture de données en sept couches, Écoutez l’épisode complet et découvrez comment un accompagnement d’experts peut préparer les données de votre entreprise à l’avenir du travail.
Questions fréquentes
Pourquoi ne puis-je pas connecter un LLM directement à mon data lake ?
Connecter un LLM directement au stockage brut d’un data lake contourne des couches de contexte essentielles. Les données brutes ne contiennent ni définitions métier, ni normes de mise en forme, ni structures de relations, ce qui amène les modèles d’IA à peiner sur l’exactitude, à halluciner des réponses et à consommer un nombre excessif de jetons.
Quelle est la différence entre un modèle sémantique et une ontologie ?
Un modèle sémantique structure les données d’un domaine ou d’un service spécifique en tables, mesures et relations. Une ontologie fournit un cadre de plus haut niveau qui relie plusieurs modèles sémantiques et décrit la façon dont les différentes entités et domaines métier sont liés les uns aux autres dans l’ensemble de l’organisation.
Comment les métadonnées réduisent-elles les coûts opérationnels de l’IA ?
Les métadonnées agissent comme une carte de navigation précise pour les modèles d’IA. Au lieu de contraindre le LLM à parcourir de gros volumes de données brutes et de fichiers, les métadonnées le guident directement vers les tables et colonnes précises nécessaires pour répondre à une requête, ce qui réduit considérablement la consommation de jetons et les coûts de traitement.
Pourquoi les définitions métier partagées sont-elles importantes pour l’IA d’entreprise ?
Différents services utilisent souvent les mêmes termes, comme « ventes », « marge » ou « utilisateur actif », avec des définitions contradictoires. Définir explicitement ces KPI empêche les modèles d’IA de deviner ou de produire des réponses incohérentes, et garantit des analyses d’entreprise fiables et dignes de confiance.