 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Perché i modelli semantici e le ontologie di Microsoft Fabric sono essenziali per la preparazione dell'AI in azienda
By Mirko Peters ·
Scopri perché collegare direttamente gli LLM allo storage grezzo non funziona. Scopri come i modelli semantici, i metadati e le ontologie di Microsoft Fabric garantiscono la preparazione dell'AI in azienda.
Automatically translated with AI from the original post. Read the English original
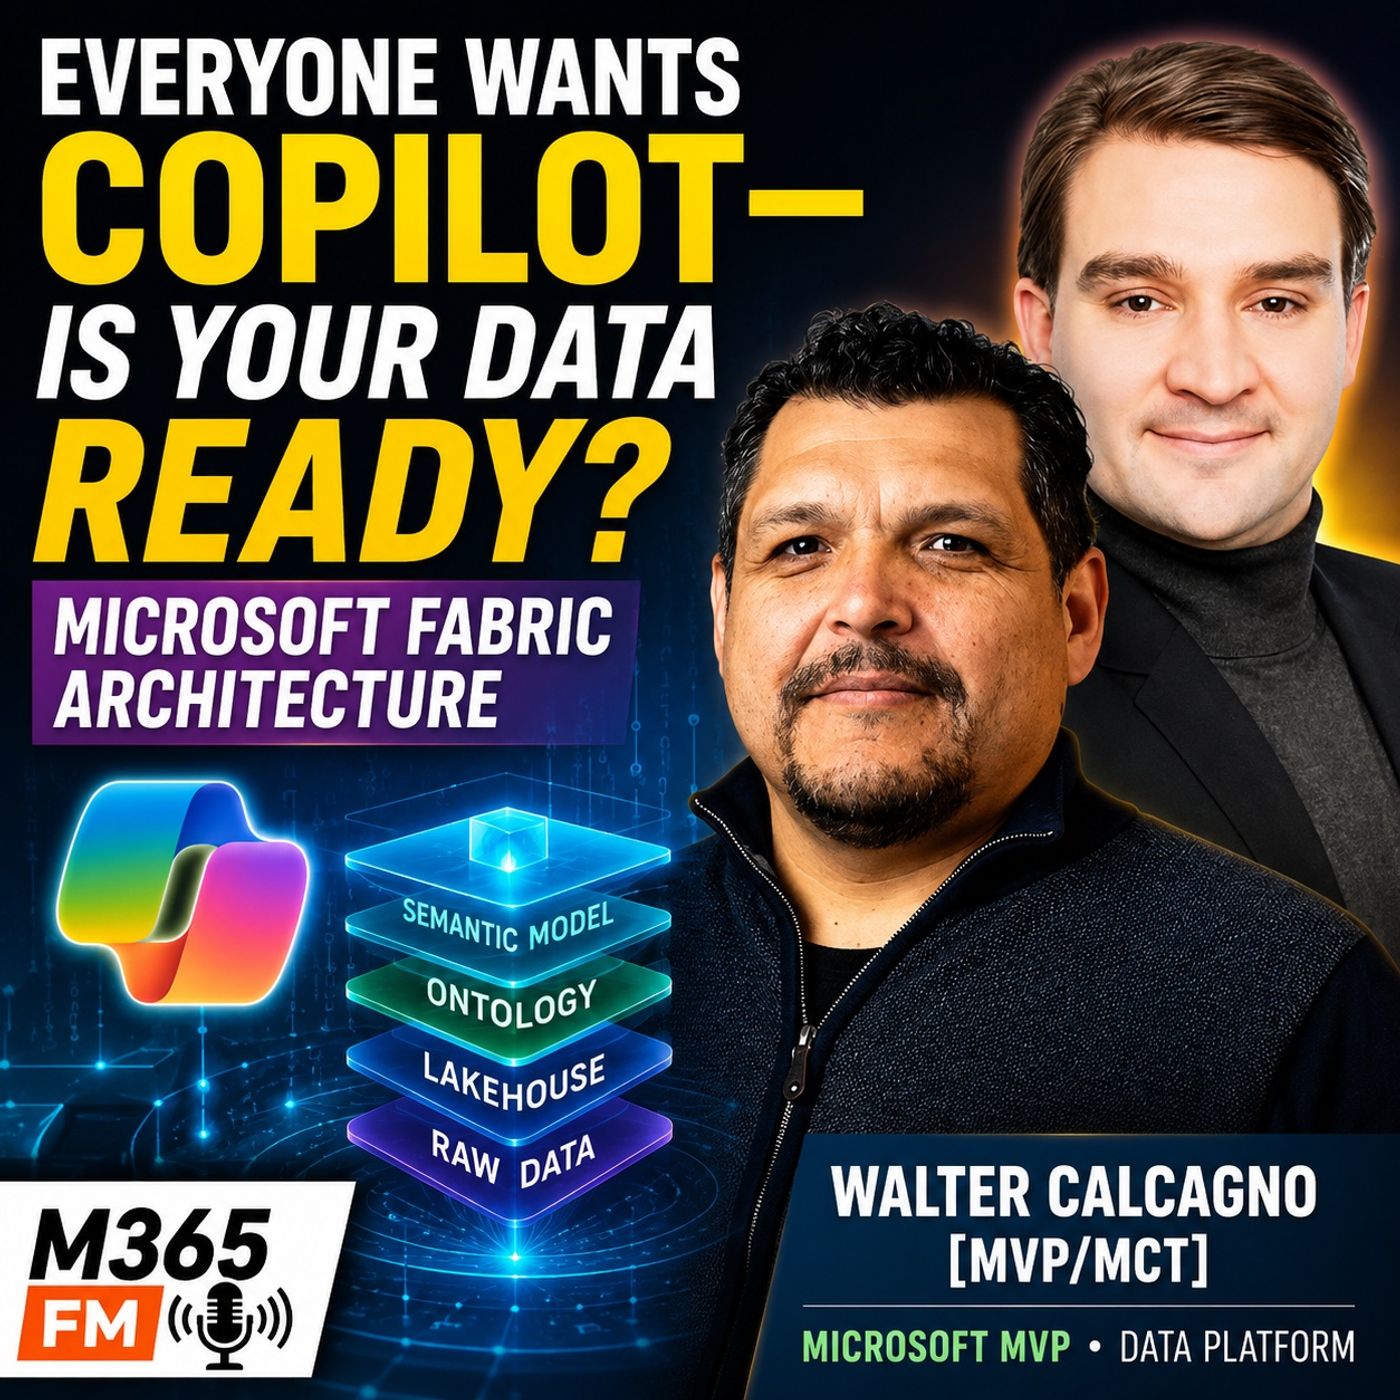
Scopri perché collegare un Large Language Model direttamente allo storage grezzo di un database porta a un consumo costoso di token, allucinazioni e rischi per la sicurezza. Scopri come i modelli semantici, le mappe dei metadati e le ontologie di Microsoft Fabric colmano il divario tra dati aziendali disordinati e agenti di AI affidabili.
Punti chiave
- Collegare gli LLM direttamente allo storage cloud grezzo salta livelli architetturali critici necessari per il contesto di business.
- I modelli semantici di Microsoft Fabric strutturano i dati di business, ma le grandi organizzazioni hanno bisogno di ontologie per mappare le relazioni tra domini diversi.
- I metadati funzionano come un GPS per i sistemi di AI: riducono il costoso consumo di token guidando i modelli direttamente verso le informazioni pertinenti, invece di scansionare tutto.
- L'AI in azienda richiede definizioni di business esplicite per KPI come ricavi e churn, per evitare che i modelli inventino metriche in conflitto tra loro.
- Una solida governance dei dati e autorizzazioni corrette sono indispensabili prima di distribuire interfacce in linguaggio naturale su asset aziendali sensibili.
L'illusione della connettività diretta dell'AI negli ambienti aziendali
Le organizzazioni si stanno affrettando ad adottare Copilot e agenti di AI personalizzati, spinte dalla promessa di interagire con i dati in linguaggio naturale. I dirigenti vogliono che i dipendenti pongano domande semplici come "Quali sono state le linee di prodotto con le migliori prestazioni lo scorso trimestre?" e ricevano risposte immediate e affidabili. Tuttavia, un grave errore architetturale si verifica quando i team presumono di poter semplicemente puntare un LLM o un sistema di Retrieval-Augmented Generation (RAG) direttamente su account di storage cloud esistenti, data lake o tabelle non organizzate.
I dati grezzi non hanno contesto. Senza livelli strutturati, un large language model non ha una comprensione nativa del fatto che una particolare colonna denominata "ricavi" includa resi, tasse o proventi differiti. Consentire a un modello di AI di interpretare autonomamente righe e colonne grezze introduce rischi gravi, tra cui allucinazioni, calcoli errati e un costoso sovraccarico di token. Ottenere una vera preparazione all'AI richiede un'architettura dei dati intenzionale, che inizia ben prima che venga scritto qualsiasi prompt.
Oltre i modelli semantici: il ruolo delle ontologie in Microsoft Fabric
All'interno dell'ecosistema di Microsoft Fabric, i modelli semantici forniscono rappresentazioni strutturate dei dati di business ottimizzate per analisi e reporting. Trasformano le tabelle delta grezze in entità di business riconoscibili. Tuttavia, le grandi aziende raramente operano con un unico modello semantico. Reparti diversi, come finanza, vendite, risorse umane e supply chain, mantengono spesso modelli semantici separati, costruiti sulle proprie specifiche esigenze operative.
Cercare di risolvere questa frammentazione racchiudendo un'intera azienda in un unico modello semantico enorme e monolitico raramente funziona. I data architect moderni si affidano invece a un livello di ontologia. Un'ontologia descrive le relazioni, le dipendenze e i percorsi contestuali tra più modelli. Combinando modelli semantici strutturati con un solido livello di ontologia, le organizzazioni forniscono ai sistemi di AI una mappa di navigazione che preserva il significato di business, le relazioni strutturali e i controlli di accesso.
I metadati come mappa per una navigazione efficiente degli LLM
Uno degli aspetti più trascurati dell'implementazione dell'AI aziendale è la realtà economica del consumo di token. Inviare nella finestra di contesto di un LLM grandi quantità di dati inutili e di file non strutturati fa salire i costi operativi e al tempo stesso peggiora la qualità dell'output del modello.
Un'analogia utile è il viaggio in un Paese sconosciuto. Non percorri ogni strada residenziale alla ricerca della destinazione: usi autostrade, strade regionali e mappe locali per arrivare direttamente all'indirizzo giusto. I metadati svolgono esattamente la stessa funzione di mappa di navigazione per un sistema di AI. Tag di metadati ben strutturati, definizioni di schema e catalogazione aiutano il modello a individuare con precisione dove risiedono le informazioni affidabili. Senza metadati, gli agenti di AI devono lavorare di più, consumare più risorse di calcolo e tirare a indovinare la posizione dei dati, con il risultato di una business intelligence inaffidabile.
Eliminare le ambiguità: definizioni condivise per l'AI aziendale
Termini di business critici come «cliente», «dipendente attivo», «margine» e «churn» hanno spesso significati diversi a seconda di chi interpelli all'interno dell'organizzazione. Ad esempio, il marketing potrebbe definire un lead attivo in modo diverso da come il team vendite definisce un account attivo. Pretendere che sia un LLM ad arbitrare da solo queste definizioni in conflitto è una ricetta per il disastro.
Le organizzazioni devono codificare esplicitamente le proprie definizioni di business, gli indicatori chiave di prestazione (KPI) e le regole di calcolo prima di esporre i dati agli strumenti di AI. Fornire istruzioni chiare sui metadati e guardrail semantici assicura che l'AI apprenda come vengono definiti i concetti all'interno della specifica cultura aziendale. Regole di business chiare proteggono l'organizzazione dalla disinformazione automatizzata e mantengono la coerenza in ogni interazione dell'utente.
Conclusione
Adottare l'AI aziendale è, in ultima analisi, un percorso di prontezza organizzativa e di disciplina architetturale, non una semplice installazione software. Investendo in livelli semantici adeguati, in una mappatura completa dei metadati e in una governance dei dati rigorosa su piattaforme come Microsoft Fabric, le aziende possono trasformare silos di dati frammentati in asset affidabili che alimentano in modo sicuro gli strumenti di AI moderni.
Per approfondire questi concetti di architettura dei dati, inclusa la valutazione della prontezza all'AI su cinque dimensioni e il modello di architettura dei dati a sette livelli, ascolta l'episodio completo e scopri come una guida esperta può preparare i dati della tua azienda al futuro del lavoro.
Domande frequenti
Perché non posso collegare un LLM direttamente al mio data lake?
Collegare un LLM direttamente allo storage grezzo di un data lake salta livelli di contesto essenziali. I dati grezzi non hanno definizioni di business, standard di formattazione né strutture di relazione, quindi i modelli di AI faticano a essere accurati, generano risposte inventate e consumano un numero eccessivo di token.
Qual è la differenza tra un modello semantico e un'ontologia?
Un modello semantico struttura i dati di un dominio o di un reparto specifico in tabelle, misure e relazioni. Un'ontologia fornisce un framework di livello superiore che collega più modelli semantici, descrivendo come entità di business e domini diversi si relazionano tra loro in tutta l'organizzazione.
In che modo i metadati riducono i costi operativi dell'AI?
I metadati agiscono come una mappa di navigazione precisa per i modelli di AI. Invece di costringere l'LLM a scansionare enormi volumi di dati grezzi e file, i metadati lo guidano direttamente verso le tabelle e le colonne specifiche necessarie per rispondere a un prompt, riducendo in modo significativo il consumo di token e i costi di elaborazione.
Perché le definizioni di business condivise sono importanti per l'AI aziendale?
Reparti diversi usano spesso gli stessi termini, come vendite, margine o utente attivo, con definizioni in conflitto. Definire esplicitamente questi KPI impedisce ai modelli di AI di tirare a indovinare o generare risposte incoerenti, garantendo insight aziendali affidabili e attendibili.