 UK
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 العربية
 עברית
 日本語
 한국어
Чому семантичні моделі та онтології в Microsoft Fabric необхідні для готовності корпоративного ШІ
By Mirko Peters ·
Дізнайтеся, чому пряме підключення LLM до сирого сховища не працює. Розкрийте, як семантичні моделі, метадані та онтології в Microsoft Fabric забезпечують готовність корпоративного ШІ.
Automatically translated with AI from the original post. Read the English original
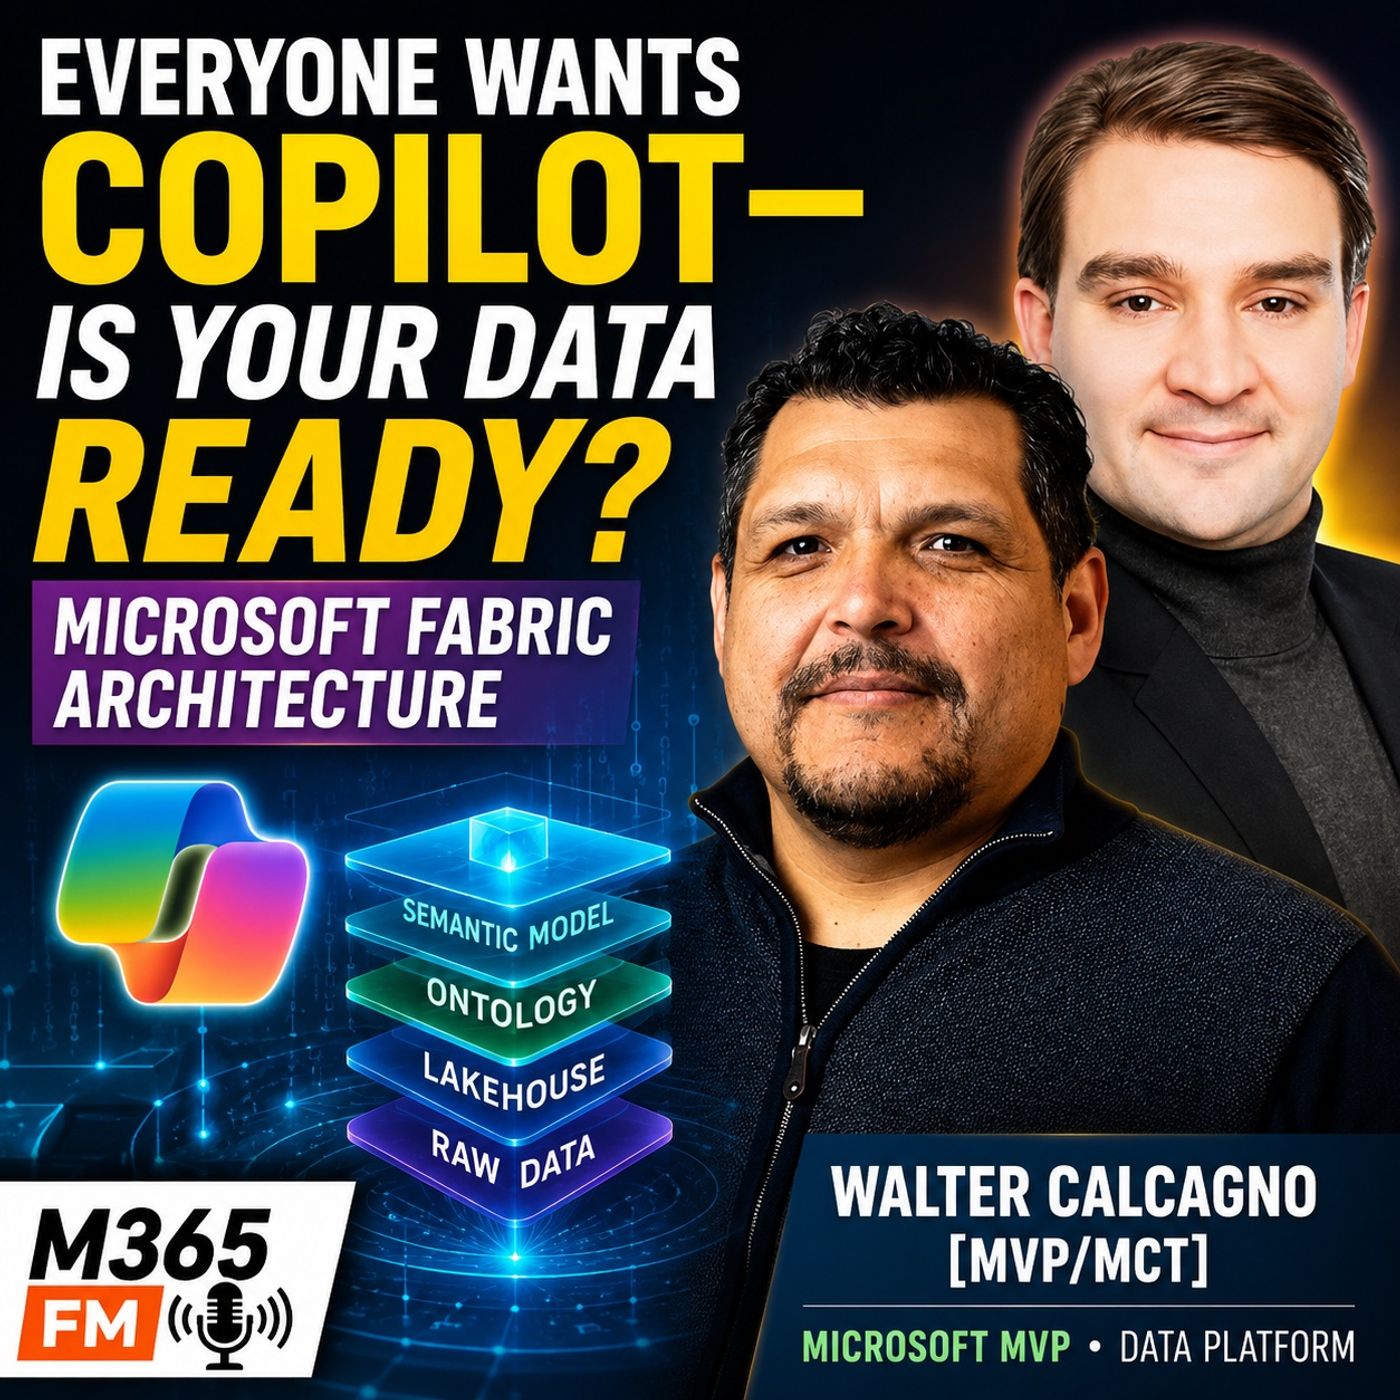
Дізнайтеся, чому пряме підключення великої мовної моделі (LLM) до сирого сховища баз даних призводить до дорогого споживання токенів, галюцинацій і ризиків безпеки. Розкрийте, як семантичні моделі, карти метаданих і онтології Microsoft Fabric долають розрив між хаотичними корпоративними даними та надійними агентами ШІ.
Головне
- Пряме підключення LLM до сирого хмарного сховища оминає критично важливі архітектурні рівні, необхідні для бізнес-контексту.
- Семантичні моделі Microsoft Fabric структурують бізнес-дані, але великим організаціям потрібні онтології, щоб відобразити зв’язки між розрізненими доменами.
- Метадані працюють як GPS для систем ШІ: вони зменшують дороге споживання токенів, спрямовуючи моделі безпосередньо до релевантної інформації замість сканування всього.
- Корпоративному ШІ потрібні явні бізнес-визначення для KPI, як-от дохід і відтік клієнтів, щоб моделі не вигадували суперечливих метрик.
- Перш ніж впроваджувати інтерфейси природною мовою над конфіденційними корпоративними активами, обов’язкові надійне управління даними та правильно налаштовані дозволи.
Ілюзія прямого підключення ШІ в корпоративному середовищі
Організації поспішають впроваджувати Copilot і власних агентів ШІ, спонукані обіцянкою взаємодії з даними природною мовою. Керівники хочуть, щоб співробітники ставили прості запитання на кшталт «Які наші найкращі товарні лінійки минулого кварталу?» і миттєво отримували достовірні відповіді. Проте серйозна архітектурна пастка виникає тоді, коли команди вважають, що можуть просто спрямувати LLM або систему генерації з доповненням пошуком (RAG) безпосередньо на наявні хмарні облікові записи сховищ, data lake чи неструктуровані таблиці.
Сирим даним бракує контексту. Без структурованих рівнів велика мовна модель не має природного розуміння того, чи містить конкретний стовпець із назвою «revenue» повернення коштів, податки чи відстрочені надходження. Дозволяти моделі ШІ самостійно інтерпретувати сирі рядки й стовпці означає ризикувати серйозними проблемами: галюцинаціями, некоректними обчисленнями та витратними токенами. Справжня готовність до ШІ вимагає свідомої архітектури даних, яка починається задовго до написання будь-якого запиту.
Понад семантичні моделі: роль онтологій у Microsoft Fabric
У екосистемі Microsoft Fabric семантичні моделі забезпечують структуроване представлення бізнес-даних, оптимізоване для аналізу та звітності. Вони перетворюють сирі delta-таблиці на зрозумілі бізнес-сутності. Проте великі підприємства рідко обмежуються однією семантичною моделлю. Різні відділи, наприклад фінансовий, продажів, кадровий і ланцюг постачання, часто ведуть окремі семантичні моделі, адаптовані до їхніх операційних потреб.
Спроба вирішити цю фрагментацію шляхом зведення всього підприємства до однієї величезної монолітної семантичної моделі рідко буває успішною. Натомість сучасні архітектори даних покладаються на шар онтології. Онтологія описує зв'язки, залежності та контекстні шляхи між кількома моделями. Поєднуючи структуровані семантичні моделі з надійним шаром онтології, організації надають системам ШІ навігаційну карту, яка зберігає бізнес-зміст, структурні зв'язки та контроль доступу.
Метадані як карта для ефективної навігації LLM
Один із найменш помітних аспектів впровадження ШІ на підприємстві — економіка споживання токенів. Надсилання величезних обсягів непотрібних даних і неструктурованих файлів у контекстне вікно LLM підвищує операційні витрати та погіршує якість відповідей моделі.
Зручна аналогія — подорож незнайомою країною. Ви не їдете кожною житловою вуличкою в пошуках потрібного місця; ви користуєтеся магістралями, регіональними трасами та локальними картами, щоб одразу дістатися правильної адреси. Метадані виконують ту саму функцію навігаційної карти для системи ШІ. Надійні мітки метаданих, визначення схем і каталогізація допомагають моделі точно визначити, де розташована достовірна інформація. Без метаданих агенти ШІ мають працювати важче, споживати більше обчислювальних ресурсів і вгадувати розташування даних, що призводить до ненадійної бізнес-аналітики.
Усунення неоднозначності: спільні визначення для корпоративного ШІ
Ключові бізнес-терміни, як-от «клієнт», «активний співробітник», «маржа» та «відтік», часто мають різне значення залежно від того, кого ви запитаєте в організації. Наприклад, маркетинг може визначати активного лідера інакше, ніж відділ продажів визначає активний обліковий запис. Очікувати, що LLM самостійно розсудить ці суперечливі визначення, — це рецепт катастрофи.
Організації мусять явно закріпити свої бізнес-визначення, ключові показники ефективності (KPI) та правила розрахунків, перш ніж відкривати дані для інструментів ШІ. Чіткі інструкції з метаданих і семантичні обмеження гарантують, що ШІ вивчає, як у цій конкретній корпоративній культурі визначаються поняття. Чіткі бізнес-правила захищають організацію від автоматизованої дезінформації та забезпечують узгодженість кожної взаємодії користувача із системою.
Висновок
Впровадження корпоративного ШІ — це насамперед шлях організаційної готовності та архітектурної дисципліни, а не просте встановлення програмного забезпечення. Інвестуючи в належні семантичні шари, комплексне відображення метаданих і суворе управління даними на платформах на кшталт Microsoft Fabric, компанії можуть перетворити фрагментовані ізольовані масиви даних на надійні активи, які безпечно живлять сучасні інструменти ШІ.
Щоб детальніше ознайомитися з цими концепціями архітектури даних, зокрема з п'ятивимірною оцінкою готовності до ШІ та семирівневою моделлю архітектури даних, послухайте повний епізод і дізнайтеся, як експертні поради можуть підготувати ваші корпоративні дані до майбутнього роботи.
Поширені запитання
Чому я не можу підключити LLM безпосередньо до свого data lake?
Підключення LLM безпосередньо до необроблених даних у сховищі data lake оминає важливі контекстні шари. Сирим даним бракує бізнес-визначень, стандартів форматування та структур зв'язків, через що моделі ШІ гірше дають точні відповіді, вигадують відповіді та споживають надмірну кількість токенів.
Чим семантична модель відрізняється від онтології?
Семантична модель структурує дані в межах конкретного домену або відділу у вигляді таблиць, мір і зв'язків. Онтологія — це вищий рівень абстракції, який поєднує кілька семантичних моделей і описує, як різні бізнес-сутності та домени пов'язані між собою в межах усієї організації.
Як метадані зменшують операційні витрати на ШІ?
Метадані діють як точна навігаційна карта для моделей ШІ. Замість того щоб змушувати LLM переглядати величезні обсяги необроблених даних і файлів, метадані спрямовують модель безпосередньо до конкретних таблиць і стовпців, потрібних для відповіді на запит, що суттєво зменшує споживання токенів і витрати на обробку.
Чому спільні бізнес-визначення важливі для корпоративного ШІ?
Різні відділи часто використовують ті самі терміни — наприклад, продажі, маржа або активний користувач — із суперечливими визначеннями. Чітке визначення цих KPI не дає моделям ШІ вгадувати чи генерувати неузгоджені відповіді, забезпечуючи надійні та достовірні корпоративні інсайти.