 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Waarom Microsoft Fabric-semantic models en ontologieën essentieel zijn voor AI-gereedheid in de onderneming
By Mirko Peters ·
Ontdek waarom het rechtstreeks koppelen van LLM's aan ruwe opslag niet werkt. Lees hoe Microsoft Fabric-semantic models, metadata en ontologieën zorgen voor AI-gereedheid in de onderneming.
Automatically translated with AI from the original post. Read the English original
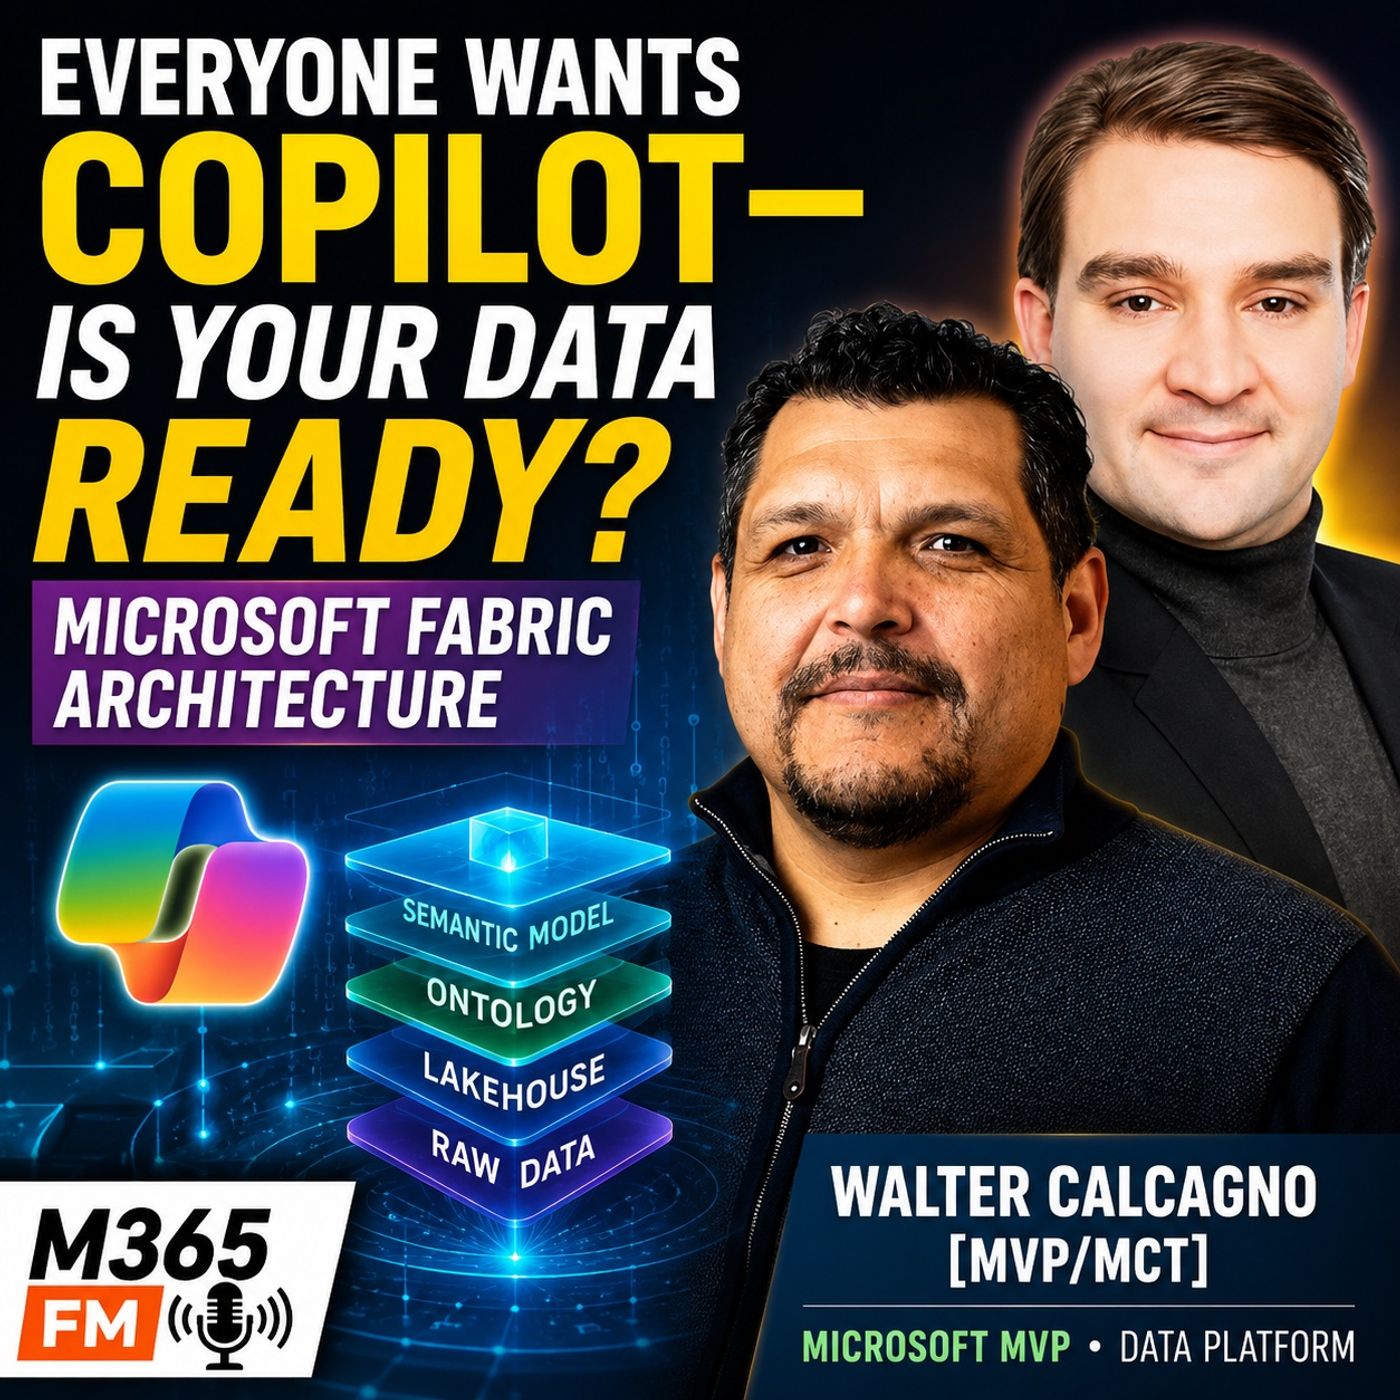
Ontdek waarom het rechtstreeks koppelen van een Large Language Model aan ruwe databaseopslag leidt tot hoog tokenverbruik, hallucinaties en beveiligingsrisico's. Lees hoe Microsoft Fabric-semantic models, metadatakaarten en ontologieën de kloof dichten tussen rommelige bedrijfsdata en betrouwbare AI-agents.
Belangrijkste punten
- LLM's rechtstreeks koppelen aan ruwe cloudopslag slaat kritieke architectuurlagen over die nodig zijn voor zakelijke context.
- Microsoft Fabric-semantic models structureren zakelijke data, maar grote organisaties hebben ontologieën nodig om relaties tussen afzonderlijke domeinen in kaart te brengen.
- Metadata fungeert als een GPS voor AI-systemen. Ze verlaagt het dure tokenverbruik doordat modellen direct naar relevante informatie worden geleid in plaats van alles te scannen.
- Enterprise-AI heeft expliciete zakelijke definities nodig voor KPI's zoals omzet en churn, zodat modellen geen conflicterende metrics verzinnen.
- Sterke datagovernance en goede machtigingen zijn verplicht voordat je natuurlijketaalinterfaces uitrolt over gevoelige bedrijfsgegevens.
De illusie van directe AI-koppeling in zakelijke omgevingen
Organisaties haasten zich om Copilot en eigen AI-agents te adopteren, gedreven door de belofte van datainteractie in natuurlijke taal. Managers willen dat medewerkers eenvoudige vragen stellen, zoals "Welke productlijnen presteerden vorig kwartaal het best?", en direct betrouwbare antwoorden krijgen. Toch gaat het vaak mis op architectuurniveau: teams nemen aan dat ze een LLM of een Retrieval-Augmented Generation (RAG)-systeem gewoon kunnen richten op bestaande cloudopslagaccounts, data lakes of ongeordende tabellen.
Ruwe data mist context. Zonder gestructureerde lagen heeft een large language model geen ingebouwd begrip van de vraag of een kolom met het label "omzet" retourzendingen, belastingen of uitgestelde inkomsten bevat. Als je een AI-model zelfstandig ruwe rijen en kolommen laat interpreteren, loop je serieuze risico's: hallucinaties, onjuiste berekeningen en kostbare extra tokens. Echte AI-gereedheid vraagt om doordachte dataarchitectuur, en die begint lang voordat er ook maar één prompt is geschreven.
Voorbij semantic models: de rol van ontologieën in Microsoft Fabric
Binnen het Microsoft Fabric-ecosysteem bieden semantic models gestructureerde weergaven van zakelijke data, geoptimaliseerd voor analyse en rapportage. Ze zetten ruwe delta-tabellen om in herkenbare zakelijke entiteiten. Grote ondernemingen werken echter zelden met slechts één semantic model. Afdelingen zoals financiën, sales, human resources en supply chain beheren vaak elk hun eigen semantic models, afgestemd op hun specifieke operationele behoeften.
Proberen deze versnippering op te lossen door een hele onderneming samen te vouwen tot één enorm, monolithisch semantisch model, lukt zelden. In plaats daarvan vertrouwen moderne data-architecten op een ontologielaag. Een ontologie beschrijft de relaties, afhankelijkheden en contextuele paden over meerdere modellen heen. Door gestructureerde semantische modellen te combineren met een robuuste ontologielaag geven organisaties AI-systemen een navigatiekaart die de bedrijfsbetekenis, de structurele relaties en de toegangscontroles behoudt.
Metadata als kaart voor efficiënte LLM-navigatie
Een van de meest over het hoofd geziene aspecten van enterprise-AI-implementatie is de economische realiteit van tokenverbruik. Enorme hoeveelheden onnodige data en ongestructureerde bestanden naar het contextvenster van een LLM sturen, drijft de operationele kosten op en verslechtert tegelijkertijd de kwaliteit van de output van het model.
Een handige vergelijking is reizen door een onbekend land. Je rijdt niet door elke woonstraat op zoek naar je bestemming; je gebruikt snelwegen, regionale wegen en lokale kaarten om precies op het juiste adres aan te komen. Metadata fungeert voor een AI-systeem als exact dezelfde navigatiekaart. Sterke metadatatags, schemadefinities en catalogisering helpen het model precies te vinden waar betrouwbare informatie zich bevindt. Zonder metadata moeten AI-agents harder werken, meer rekenkracht verbruiken en gissen naar de locatie van data, wat leidt tot onbetrouwbare business intelligence.
Ambiguïteit wegnemen: gedeelde definities voor enterprise-AI
Kritieke bedrijfstermen zoals "klant", "actieve medewerker", "marge" en "churn" hebben binnen een organisatie vaak verschillende betekenissen, afhankelijk van wie je ernaar vraagt. Marketing definieert een actieve lead bijvoorbeeld vaak anders dan sales een actief account definieert. Verwachten dat een LLM deze tegenstrijdige definities zelf beslecht, is een recept voor een ramp.
Organisaties moeten hun bedrijfsdefinities, kpi's (key performance indicators) en berekeningsregels expliciet vastleggen voordat ze data beschikbaar stellen aan AI-tools. Duidelijke metadata-instructies en semantische vangrails zorgen ervoor dat de AI leert hoe begrippen binnen die specifieke bedrijfscultuur worden gedefinieerd. Heldere bedrijfsregels beschermen de organisatie tegen geautomatiseerde misinformatie en houden de consistentie bij elke gebruikersinteractie op peil.
Conclusie
Enterprise-AI adopteren is uiteindelijk een traject van organisatorische gereedheid en architecturale discipline, en geen eenvoudige softwareinstallatie. Door te investeren in goede semantische lagen, uitgebreide metadatamapping en strikte datagovernance binnen platforms zoals Microsoft Fabric, kunnen bedrijven versnipperde datasilo's omvormen tot betrouwbare assets die moderne AI-tools veilig kunnen aandrijven.
Om deze data-architectuurconcepten verder uit te diepen, inclusief de vijfdimensionale AI-gereedheidsbeoordeling en het zevenlaagse data-architectuurmodel, luister je naar de volledige aflevering en ontdek je hoe deskundige begeleiding je bedrijfsdata kan voorbereiden op de toekomst van werken.
Veelgestelde vragen
Waarom kan ik een LLM niet rechtstreeks aan mijn data lake koppelen?
Een LLM rechtstreeks koppelen aan ruwe opslag in een data lake slaat essentiële contextlagen over. Ruwe data mist bedrijfsdefinities, opmaakstandaarden en relatiestructuren, waardoor AI-modellen moeite krijgen met nauwkeurigheid, antwoorden verzinnen en te veel tokens verbruiken.
Wat is het verschil tussen een semantisch model en een ontologie?
Een semantisch model structureert data binnen een specifiek domein of afdeling in tabellen, measures en relaties. Een ontologie biedt een kader op een hoger niveau dat meerdere semantische modellen met elkaar verbindt en beschrijft hoe verschillende bedrijfsentiteiten en domeinen zich binnen de hele organisatie tot elkaar verhouden.
Hoe verlaagt metadata de operationele kosten van AI?
Metadata fungeert als een nauwkeurige navigatiekaart voor AI-modellen. In plaats van het LLM te dwingen enorme volumes ruwe data en bestanden te scannen, leidt metadata het model rechtstreeks naar de specifieke tabellen en kolommen die nodig zijn om een prompt te beantwoorden. Dat verlaagt het tokenverbruik en de verwerkingskosten aanzienlijk.
Waarom zijn gedeelde bedrijfsdefinities belangrijk voor enterprise-AI?
Verschillende afdelingen gebruiken vaak dezelfde termen—zoals sales, marge of actieve gebruiker—met tegenstrijdige definities. Door deze KPI's expliciet te definiëren, voorkom je dat AI-modellen gaan gissen of inconsistente antwoorden genereren, zodat de inzichten betrouwbaar en vertrouwd blijven.