 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Der versteckte Preis der Bequemlichkeit: Warum Managed Connectors Enterprise-KI ausbremsen
Von Mirko Peters ·
Seit Jahren setzen Unternehmen auf Low-Code-Integrationstools, Automatisierungsengines und Managed Connectors als den absoluten Goldstandard der digitalen Transformation. Sie sind der „Easy Button“ moderner Architektur. Soll Salesforce mit Azure verbunden werden? Ein Managed Connector hinzufügen. Sollen Telemetriedaten in Ihren Data Lake gelangen oder Benachrichtigungen über unternehmensweite Komm
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
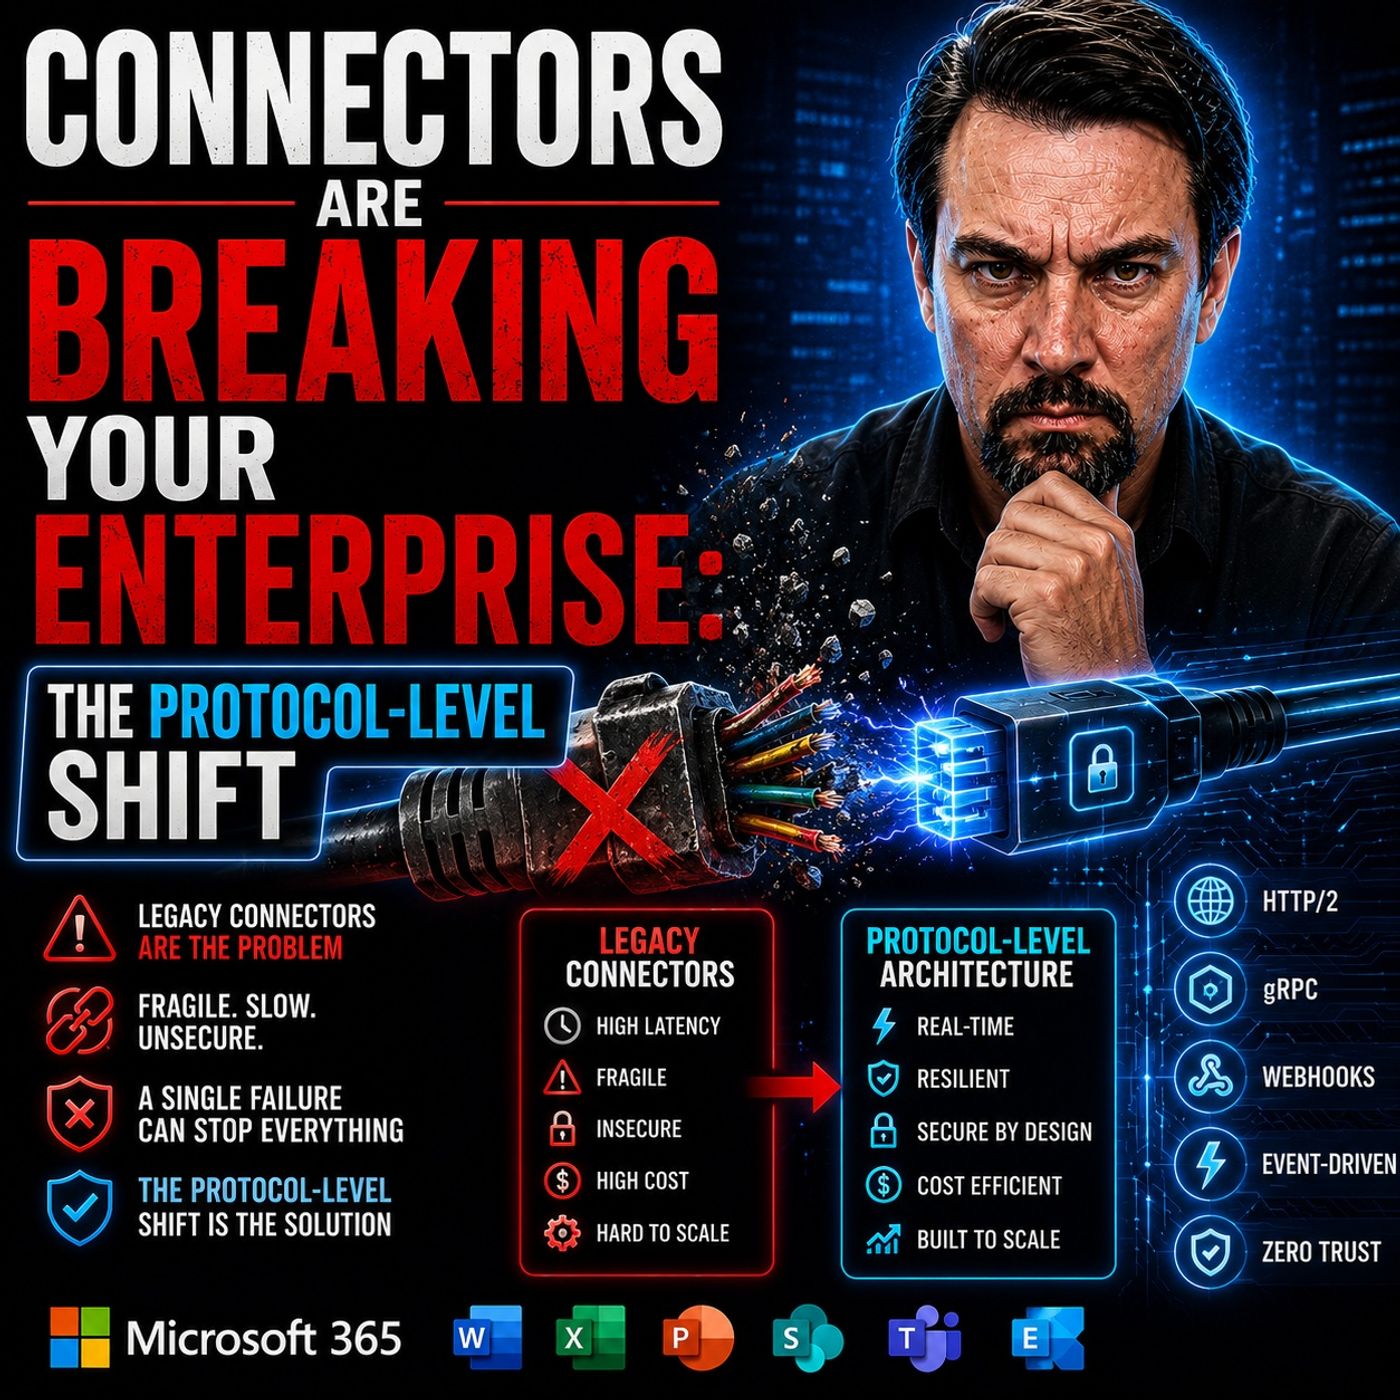
Seit Jahren setzen Unternehmen auf Low-Code-Integrationstools, Automatisierungsengines und Managed Connectors als den absoluten Goldstandard der digitalen Transformation. Sie sind der „Easy Button“ moderner Architektur. Soll Salesforce mit Azure verbunden werden? Ein Managed Connector hinzufügen. Sollen Telemetriedaten in den Data Lake gelangen oder Benachrichtigungen über unternehmensweite Kommunikationskanäle verteilt werden? Einen Low-Code-Wrapper aufsetzen, ein paar Authentifizierungstoken konfigurieren und zusehen, wie die Daten fließen. Diese vorgefertigten Module versprechen schnelle Bereitstellung, weniger Reibung und nur minimalen Bedarf an tiefgehender Engineering-Aufsicht.
Hinter dieser Fassade extremer betrieblicher Bequemlichkeit verbirgt sich jedoch ein fragiles, stark störanfälliges Transportmodell. Moderne Unternehmensarchitekturen – insbesondere das explosive Wachstum von Künstlicher Intelligenz, agentischen Echtzeit-Workflows und Machine-to-Machine-Verkehr mit hoher Parallelität – legen die strukturellen Grenzen klassischer Managed-Integration-Plattformen schonungslos offen. Wenn Workflows unter starker Parallelität scheitern, die Latenz unvorhersehbar ansteigt oder Anwendungen in flächendeckende Ausfälle kaskadieren, zeigen Entwicklungsteams häufig auf die Anwendungslogik oder die Instabilität des Modells. Meist liegt die eigentliche Ursache jedoch tiefer im System verborgen: in der Transportschicht selbst.
Um wirklich zu verstehen, warum Unternehmensautomatisierungen unter Last ins Stocken geraten, müssen wir die Abstraktionsschichten älterer Connectors abtragen und die architektonischen Nachteile betrachten, die wir für Bequemlichkeit in Kauf nehmen. Im Zeitalter von KI-Workloads mit hohem Durchsatz ist es an der Zeit, die versteckten Kosten von Managed Middleware neu zu bewerten und die Engineering-Paradigmen zu erkunden, die für den Aufbau widerstandsfähiger, skalierbarer Systeme erforderlich sind.
Die Bequemlichkeitsfalle von Managed Connectors
Die Grundphilosophie hinter Managed Connectors ist Geschwindigkeit bis zur Marktreife. Indem Anbieter die zugrunde liegenden Netzwerkaufrufe, API-Schemata und Transportprotokolle abstrahieren, können Entwickler komplexe Geschäftsprozesse in wenigen Stunden statt Wochen zusammensetzen. Diese Abstraktion hat jedoch einen hohen architektonischen Preis.
Jeder Managed Connector agiert als aktiver Vermittler mitten zwischen Ihren verteilten Microservices. Wird eine Anfrage gestartet, werden Ihre Daten abgefangen, neu verpackt, serialisiert, über eine gemeinsam genutzte Mandanteninfrastruktur geleitet, Gateway-Drosselungsregeln unterworfen, von Richtlinien-Durchsetzungsschichten geprüft und schließlich übersetzt, bevor sie ihr eigentliches Ziel erreichen. Dieses ständige Abfangen führt zu versteckten architektonischen Abhängigkeiten. Ihr System kommuniziert nicht mehr direkt mit dem Zieldienst, sondern über eine Black-Box-Zwischenstation, deren interne Kapazität, Ressourcenzuteilung und betriebliche Gesundheit vollständig außerhalb Ihrer Kontrolle liegen.
Darüber hinaus führt dieses gemeinsam genutzte Infrastrukturmodell zwangsläufig zu unvorhersehbarer Middleware-Reibung. Da diese Connectors häufig auf Mandanteninfrastruktur laufen, die von Drittanbietern verwaltet wird, konkurrieren Ihre kritischen Unternehmensdaten um CPU-Zyklen, Speicherzuweisungen und Netzwerkbandbreite mit Tausenden anderen Mandanten. Treten weltweit Lastspitzen auf, werden Ihre lokalen Workflows anfällig für Nachbarschaftslärm („Neighbor Noise“) und abrupte Drosselung. Komfortorientiertes Design opfert durchgängig strukturelle Resilienz und ersetzt deterministisches Netzwerkverhalten durch probabilistische Black-Box-Orchestrierung.
Die Latenzsteuer und versteckte architektonische Kosten
Architekten verfallen häufig der Falle, Connectors als transparente Leitungen zu betrachten, neutrale Kanäle, die Daten einfach von Punkt A zu Punkt B weiterreichen. Tatsächlich sind Connectors rechenintensive Integrationsschichten, die dem gesamten Technologie-Stack eine erhebliche, sich aufschaukelnde Performance-Steuer auferlegen.
Betrachten wir die Mechanik einer klassischen REST-basierten Polling-Architektur. Um nach Aktualisierungen oder Datenänderungen zu suchen, muss ein Managed Connector fortlaufend wiederholte Anfrage-Antwort-Zyklen auslösen. Fragt ein System alle paar Sekunden über Hunderte parallele Workflows ab, ist die Verschwendung an Infrastruktur enorm. Millionen HTTP-Anfragen liefern leere Nutzdaten zurück und verbrauchen große Mengen an CPU-Zyklen für Parsing, Verbindungsaufbau und Header-Overhead.
Damit kommen wir zu den hohen Kosten der wiederholten JSON-Serialisierung. Textbasierte Nutzlasten wie JSON sind bemerkenswert gut lesbar, für die Kommunikation zwischen Maschinen aber äußerst ineffizient. Jedes Mal, wenn ein Connector eine Nutzlast verarbeitet, muss er auf der sendenden Seite komplexe Datenstrukturen in aufgeblähte Zeichenketten umwandeln, diese über das Netzwerk übertragen und auf der empfangenden Seite wieder in Speicherobjekte zurückparsen. Mit zunehmender Komplexität verteilter Workflows summiert sich diese Latenz exponentiell.
Noch schlimmer ist der Kaskadeneffekt von Ratenbegrenzungen und Drosselungen mit dem Fehlercode 429. Erkennt eine nachgelagerte API einen Anstieg an Anfragen von einem verwalteten Connector, antwortet sie mit Drosselungscodes. Standardmäßige Integrationsplattformen reagieren darauf mit automatischen Wiederholungsversuchen. Bei hoher Last vervielfachen sich diese Wiederholungen rasant und werden zu zerstörerischen Retry-Stürmen, die faktisch einen lokalen Distributed-Denial-of-Service-Angriff (DDoS) auf Ihre eigenen internen Systeme auslösen. Workflows, die in Staging-Umgebungen bei geringem Testaufkommen einwandfrei funktionieren, brechen unter dem gnadenlosen Gewicht der Parallelität im realen Unternehmensbetrieb zwangsläufig zusammen.
Von REST zu Binärprotokollen: Warum gRPC die Unternehmensintegration verändert
Wenn textbasierte Protokolle und verwaltete REST-Wrapper an eine Leistungsgrenze stoßen, welche Alternative gibt es? Die nächste Generation hochdurchsatzfähiger Unternehmensarchitekturen wendet sich konsequent von ausführlicher textbasierter Kommunikation ab und setzt auf maschinenoptimierte binäre Transportstacks.
Genau hier verändern gRPC und Protocol Buffers (Protobuf) die Grundlagen verteilter Systeme. Statt auf übergroße JSON-Nutzlasten und wiederholte, sehr gesprächige HTTP-Anfragen zu setzen, verwendet gRPC kompakte Binärnachrichten, die gezielt für die leistungsstarke Kommunikation zwischen Maschinen optimiert sind. Die binäre Serialisierung packt Datenstrukturen dicht in Bytes und reduziert die Nutzlastgröße drastisch, oft um eine Größenordnung im Vergleich zu den entsprechenden JSON-Varianten.
Die kleinere Nutzlast wirkt sich direkt auf die CPU-Last aus. Das Parsen binärer Protobuf-Daten erfordert deutlich weniger Rechenaufwand als das Verarbeiten umfangreicher Textdokumente. Außerdem läuft gRPC nativ über HTTP/2 und ermöglicht gemultiplexte Streams über eine einzige TCP-Verbindung. Dadurch sinkt die Latenz beim Verbindungsaufbau deutlich, und unnötige Netzwerk-Hops entfallen.
Ein weiterer großer Vorteil einer protokollnativen Architektur ist die schemabasierte Kommunikation. Klassische REST-Integrationen leiden häufig unter Schnittstellendrift: Nicht dokumentierte Feldänderungen oder fehlende Parameter führen zur Laufzeit zu Fehlern in abhängigen Workflows. gRPC erzwingt stark typisierte Verträge auf Basis kompilierter Protobuf-Definitionen. Client und Server einigen sich vor dem Deployment auf exakt dieselbe Datenstruktur. So werden ganze Klassen von Integrationsfehlern ausgeschlossen und die vollständige Vertragstreue über Unternehmensgrenzen hinweg sichergestellt.
Abschied vom Polling: Persistente Streams und Echtzeit-Transport
Klassische verwaltete Connectors beruhen grundlegend auf einer veralteten architektonischen Annahme: dass Unternehmensarbeit immer mit einer einzelnen, reaktiven Anfrage beginnt. In der modernen Landschaft aus Echtzeit-KI und sofortiger, ereignisgesteuerter Automatisierung sind Wartezeiten, in denen Systeme auf Updates pollen, jedoch nicht mehr hinnehmbar, weil sie unvertretbare Verzögerungen und verschwendete Bandbreite verursachen.
Die architektonische Abkehr vom Polling hin zu persistenten Streaming-Protokollen ist für leistungsstarke Systeme nicht mehr optional. Technologien wie WebSockets, HTTP/3, QUIC und WebTransport ermöglichen es Systemen, dauerhafte, bidirektionale Kommunikationskanäle aufrechtzuerhalten, über die Daten sofort in dem Moment übertragen werden, in dem ein Ereignis eintritt.
Polling erzeugt enorme Mengen leerer Datenverkehr, die Netzwerkschnittstellen sättigen und Rechenressourcen erschöpfen. Persistente Streaming-Modelle hingegen halten eine offene Verbindung aufrecht, über die Kontext kontinuierlich mit minimalem Protokoll-Overhead fließt. Außerdem beseitigen moderne Transportprotokolle wie QUIC große Engpässe im Netzwerk, etwa das Head-of-Line-Blocking. So wird verhindert, dass Paketverluste in einem einzelnen Stream die Übertragung unabhängiger Daten ausbremsen.
Durch den Wechsel zu dauerhaften, ereignisgesteuerten Transportwegen können Organisationen die Zustellung von Ereignissen weltweit in unter 100 Millisekunden erreichen. Diese Fähigkeit ist besonders wichtig für moderne, verteilte Belegschaften und Echtzeit-KI-Agenten, die Kontextinformationen sofort weitergeben müssen, ohne auf periodische Abfrageintervalle zu warten, um den Status zu synchronisieren.
Resilienz aufbauen: Asynchrone Warteschlangen und fehlertolerante Architekturen
Hochgeschwindigkeitssysteme ohne robuste Fehlertoleranz werden zwangsläufig zu Hochgeschwindigkeits-Fehlerquellen. Einer der gefährlichsten Konstruktionsfehler synchroner, connector-basierter Integrationsketten ist die blinde Annahme, dass jeder nachgelagerte Dienst, jede Datenbank und jede SaaS-API eines Drittanbieters dauerhaft verfügbar bleibt.
In realen Unternehmensumgebungen treten in verteilten Systemen ständig Teilausfälle, vorübergehende Netzwerkpartitionierungen, rollierende Datenbankwartungen und plötzliche Lastspitzen auf. Wenn Integrations-Workflows in einer synchronen Kette eng miteinander verbunden sind, führt eine kurzzeitige Verlangsamung eines einzelnen Randdienstes zu einem Rückstau, der sich nach oben fortpflanzt und zentrale Geschäftsanwendungen lahmlegt.
Asynchrone Resilienzmuster beheben diese Schwachstelle, indem sie die Geschwindigkeit der Datenaufnahme von der Verarbeitungsgeschwindigkeit entkoppeln. Durch dauerhafte Nachrichtenwarteschlangen und Event-Broker wie Azure Service Bus, RabbitMQ oder Amazon SQS zwischen Ihren Dienstgrenzen schaffen Sie einen robusten Puffer gegen Volatilität.
Wenn Lastspitzen auf Ihre Integrationsschicht treffen, werden eingehende Ereignisse sicher aufgenommen und in dauerhaftem Speicher vorgehalten, anstatt die sofortige, synchrone Verarbeitung über instabile nachgelagerte Abhängigkeiten zu erzwingen. Nachgelagerte Konsumenten holen Nachrichten in einem gleichmäßigen, kontrollierten Tempo aus der Warteschlange. Geht ein Backend-Dienst zur Wartung offline, hält die Warteschlange die Daten bis zur Wiederherstellung sicher vor. So verhindern Sie Datenverluste, vermeiden katastrophale Kaskadenausfälle und stellen sicher, dass Ihre Unternehmensarchitektur auch unter extremer Belastung belastbar bleibt.
Der Laufzeit-Wechsel: Souveränität zurückgewinnen mit integrierten Connectors
Neben Netzwerkprotokollen und Warteschlangenstrategien müssen Enterprise-Architekten die tatsächliche Ausführungslaufzeit ihrer Integrationsschichten genau prüfen. Einer der am häufigsten missverstandenen Aspekte der Cloud-Automatisierung ist die Frage, wo verwaltete Connectors tatsächlich ausgeführt werden.
Viele Organisationen gehen davon aus, dass ihre Integrationslogik, weil sie im eigenen Cloud-Abonnement gehostet wird – etwa in Azure Logic Apps –, sämtliche Datenverarbeitung sicher innerhalb der vertrauenswürdigen Netzwerkgrenzen isoliert bleibt. Viele klassische verwaltete Connectors laufen jedoch als externe SaaS-Integrationen auf Mandantenübergreifender, gemeinsam genutzter Infrastruktur, vollständig außerhalb Ihres virtuellen Netzwerks (VNet).
Diese architektonische Realität schafft erhebliche Sicherheits- und Zero-Trust-Compliance-Lücken. Wenn Ihre sensiblen Unternehmensdaten die private Netzwerkgrenze verlassen, um von externer Managed-Middleware verarbeitet zu werden, geben Sie die direkte Kontrolle über die Transportschicht aus der Hand. Um diese Lücke zu schließen, setzen Organisationen häufig auf On-Premises Data Gateways, die jedoch oft zu massiven Engpässen im Unternehmen und zu Single Points of Failure werden.
Die Lösung liegt in einem strategischen Laufzeit-Wechsel hin zu integrierten Connectors und isolierten Ausführungsmodellen – etwa Azure Logic Apps Standard auf dedizierten App Service Environments oder containerisierten Laufzeiten. Integrierte Connectors werden direkt in Ihrer eigenen Compute-Laufzeit und innerhalb Ihrer VNet-Grenzen ausgeführt. Das eliminiert externe SaaS-Zwischenstationen, senkt die Latenz deutlich, erfüllt strenge Zero-Trust-Compliance-Vorgaben und gibt Ihnen die volle architektonische Kontrolle über Ihre Datenpipelines im Unternehmen zurück.
Fazit: Resiliente Skalierung im Zeitalter der KI gestalten
Die Ära, in der Integration als Low-Code-Nebensache behandelt wurde, ist endgültig vorbei. Während Unternehmen sich beeilen, anspruchsvolle KI-Modelle, autonome Agenten und Echtzeit-Datenpipelines einzuführen, geraten die fragilen Transportmodelle klassischer verwalteter Connectors unter diesem Druck ins Wanken. Middleware-Reibung, versteckte Latenzkosten, Drosselungsengpässe und unsichere gemeinsam genutzte Laufzeiten sind keine kleinen Unannehmlichkeiten mehr, sondern kritische Geschäftsrisiken, die die Systemstabilität gefährden und digitale Innovation ausbremsen.
Zukunftsfähige Systeme erfordern einen grundlegenden Wandel im Denken. Wir müssen uns von häufigem REST-Polling, sperrigen JSON-Payloads und undurchsichtiger Managed Middleware lösen und stattdessen auf protokollnahe Entwicklung setzen: binäre Serialisierung mit gRPC, dauerhaftes Echtzeit-Streaming, asynchrone, warteschlangenbasierte Ausfallsicherheit und eine konsequente Souveränität zur Laufzeit.
Wenn Sie diese architektonischen Veränderungen genauer verstehen, praxisnahe Entwurfsmuster kennenlernen und erfahren möchten, wie Sie Ihre Integrationsstrategie für die Anforderungen moderner künstlicher Intelligenz zukunftssicher aufstellen, hören Sie sich unbedingt die passende Podcast-Folge an: Custom Connectors vs Model Context Protocol for Enterprise AI. Die Kontrolle über Ihre unternehmensweite Transportschicht zurückzugewinnen ist der wichtigste Schritt überhaupt auf dem Weg zu wirklich belastbaren, skalierbaren Automatisierungssystemen.