 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Il costo nascosto della comodità: perché i connettori gestiti stanno fallendo con l'AI aziendale
By Mirko Peters ·
Per anni le organizzazioni hanno adottato strumenti di integrazione low-code, motori di automazione e connettori gestiti come lo standard d'oro assoluto per la trasformazione digitale…
Automatically translated with AI from the original post. Read the English original
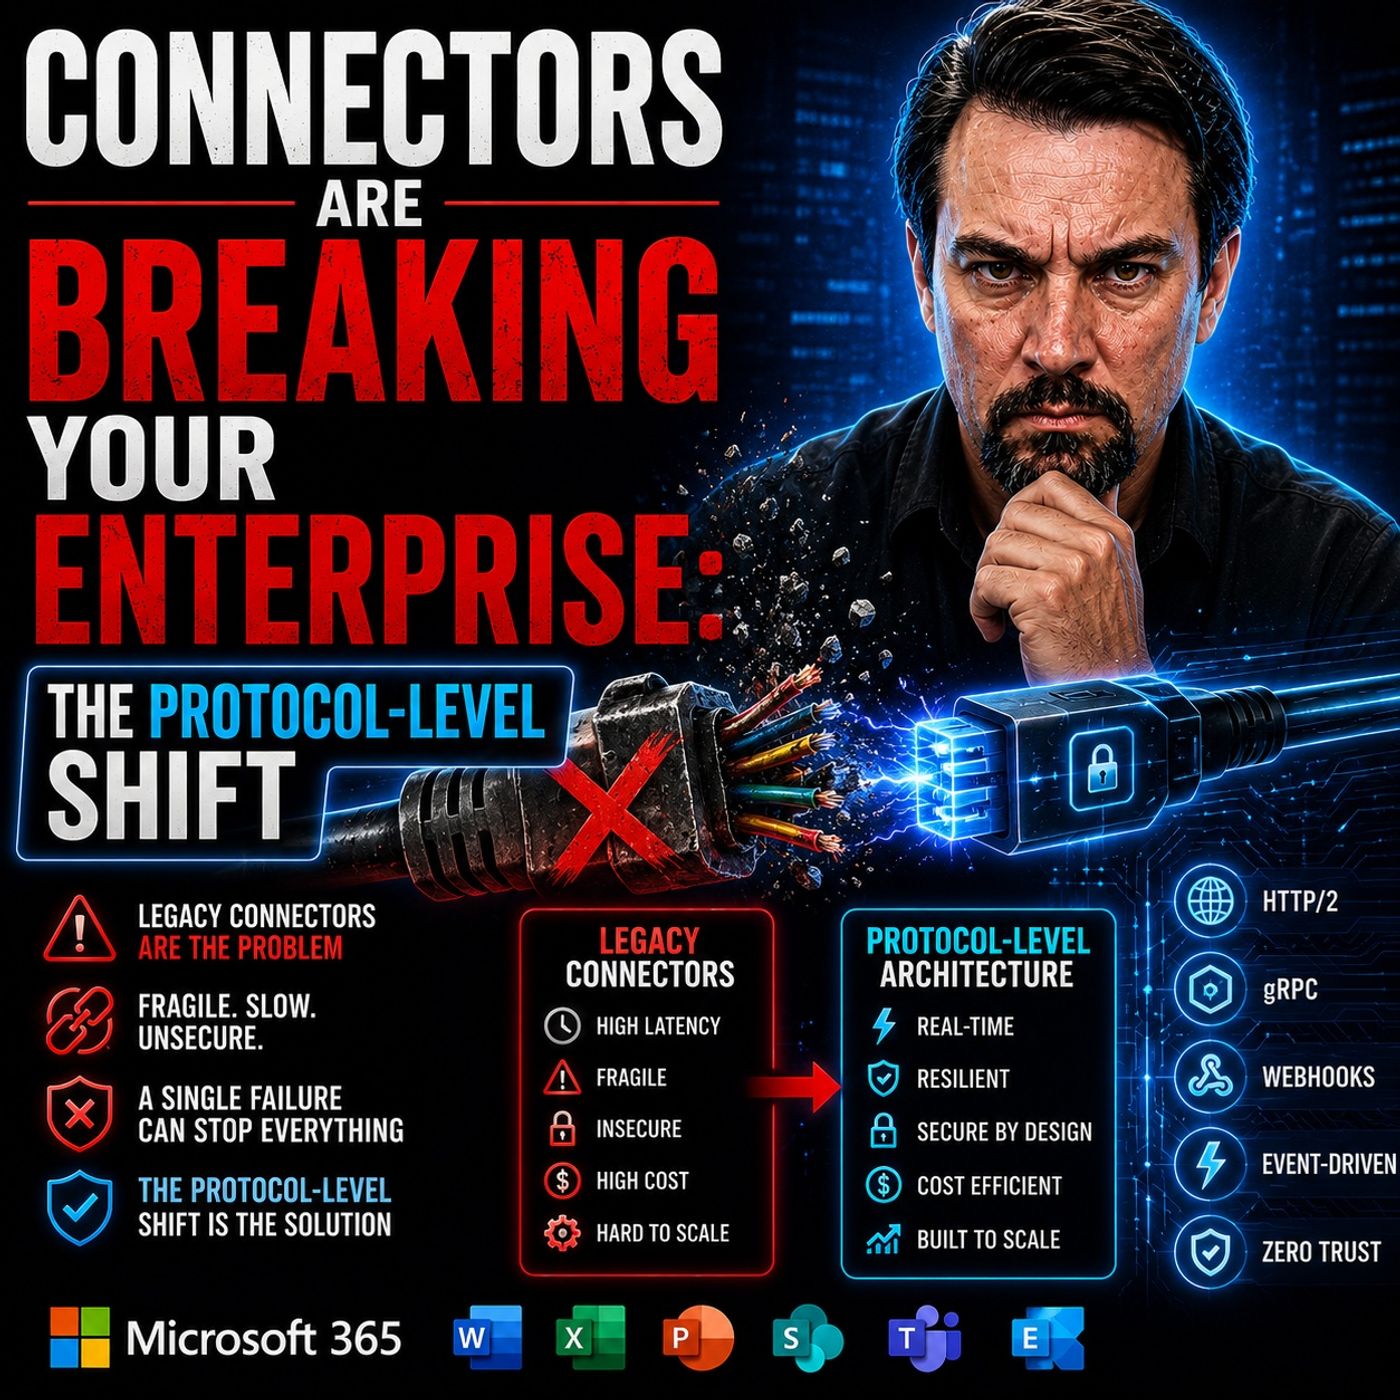
Per anni le organizzazioni hanno adottato strumenti di integrazione low-code, motori di automazione e connettori gestiti come lo standard d'oro assoluto per la trasformazione digitale. Rappresentano il "pulsante facile" dell'architettura moderna. Devi collegare Salesforce ad Azure? Aggiungi un connettore gestito. Devi inserire dati di telemetria nel tuo data lake o instradare notifiche attraverso i canali di comunicazione aziendali? Avvia un wrapper low-code, configura alcuni token di autenticazione e guarda i dati scorrere. Questi moduli predefiniti promettono distribuzione rapida, meno attriti e una necessità minima di supervisione ingegneristica approfondita.
Tuttavia, sotto questa patina di estrema comodità operativa si nasconde un modello di trasporto fragile e molto delicato. L'architettura enterprise moderna, in particolare la crescita esplosiva dell'intelligenza artificiale, dei workflow agentici in tempo reale e del traffico machine-to-machine ad alta concorrenza, sta mettendo a nudo i profondi limiti strutturali delle tradizionali piattaforme di integrazione gestite. Quando i workflow falliscono sotto forte concorrenza, quando la latenza subisce picchi imprevedibili o quando le applicazioni entrano in cascata in interruzioni diffuse, i team di sviluppo spesso puntano il dito contro la logica applicativa o l'instabilità del modello. Ma nella maggior parte dei casi la causa radice si trova più in profondità nel sistema: il livello di trasporto stesso.
Per capire davvero perché l'automazione aziendale si blocca sotto carico, dobbiamo rimuovere gli strati di astrazione forniti dai connettori legacy ed esaminare le penalizzazioni architetturali che paghiamo per la comodità. Mentre passiamo a un'era dominata da carichi di lavoro AI ad alto throughput, è il momento di rivalutare i costi nascosti del middleware gestito ed esplorare i paradigmi ingegneristici necessari per costruire sistemi resilienti e scalabili.
La trappola della comodità dei connettori gestiti
La filosofia di fondo dei connettori gestiti è la rapidità di messa sul mercato. Astraendo le chiamate di rete sottostanti, gli schemi delle API e i protocolli di trasporto, i fornitori permettono agli sviluppatori di assemblare processi aziendali complessi in poche ore anziché in settimane. Tuttavia, questa astrazione ha un prezzo architetturale elevato.
Ogni connettore gestito agisce da intermediario attivo, posizionato proprio tra i tuoi microservizi distribuiti. Quando viene avviata una richiesta, i dati vengono intercettati, reimpacchettati, serializzati, instradati attraverso un'infrastruttura multi-tenant condivisa, sottoposti alle regole di throttling del gateway, valutati dai livelli di applicazione dei criteri e infine tradotti prima di raggiungere la destinazione prevista. Questa intercettazione costante introduce dipendenze architetturali nascoste. Il tuo sistema non comunica più direttamente con il servizio di destinazione; comunica attraverso un intermediario a scatola nera la cui capacità interna, allocazione delle risorse e stato operativo restano completamente al di fuori del tuo controllo.
Inoltre, questo modello di infrastruttura condivisa introduce intrinsecamente un attrito middleware imprevedibile. Poiché questi connettori spesso vengono eseguiti su un'infrastruttura multi-tenant gestita da terzi, i tuoi payload di dati aziendali critici si contendono cicli di CPU, allocazioni di memoria e banda di rete insieme a migliaia di altri tenant. Quando si verificano picchi di traffico a livello globale, i tuoi workflow localizzati diventano vulnerabili al cosiddetto rumore dei vicini e all'applicazione improvvisa dei limiti di throttling. Il design guidato dalla comodità sacrifica sistematicamente la resilienza strutturale, sostituendo un comportamento di rete deterministico con un'orchestrazione probabilistica a scatola nera.
La tassa sulla latenza e i costi architetturali nascosti
Gli architetti cadono spesso nella trappola di considerare i connettori come condotti trasparenti, canali neutri che si limitano a passare i dati dal punto A al punto B. In realtà, i connettori sono livelli di integrazione ad alta intensità di calcolo che impongono una pesante e crescente penalizzazione prestazionale all'intero stack tecnologico.
Consideriamo la meccanica di una tradizionale architettura di polling basata su REST. Per verificare la presenza di aggiornamenti o modifiche dei dati, un connettore gestito deve inviare in continuazione cicli ripetitivi di richiesta-risposta. Se un sistema esegue il polling ogni pochi secondi su centinaia di workflow concorrenti, lo spreco di infrastruttura è enorme. Milioni di richieste HTTP restituiscono payload vuoti, consumando grandi quantità di cicli di CPU per il parsing, gli handshake di connessione e l'overhead degli header.
Ci porta al costo elevato della serializzazione JSON ripetuta. I payload basati su testo come JSON sono straordinariamente leggibili per gli esseri umani, ma sono terribilmente inefficienti per la comunicazione tra macchine. Ogni volta che un connettore elabora un payload, deve serializzare strutture dati complesse in formati di stringa voluminosi sul lato mittente, trasmettere questi payload gonfi attraverso la rete e poi ricostruire quelle stringhe in memoria sul lato destinatario. Con l'aumentare della complessità dei flussi distribuiti, questa latenza cresce in modo esponenziale.
Ancora peggiore è l'effetto a cascata degli errori 429 di limitazione della frequenza e del throttling. Quando un'API a valle rileva un afflusso di richieste da un connettore gestito, risponde con codici di throttling. Le piattaforme di integrazione standard reagiscono a questi segnali avviando nuovi tentativi automatici. Sotto carico intenso, questi tentativi si moltiplicano rapidamente, trasformandosi in tempeste di retry distruttive che di fatto lanciano un attacco Distributed Denial of Service (DDoS) localizzato contro i tuoi stessi sistemi interni. I flussi che funzionano perfettamente negli ambienti di staging, con test a basso volume eseguiti dagli sviluppatori, finiscono inevitabilmente per crollare sotto il peso implacabile della concorrenza di un ambiente aziendale reale.
Da REST al binario: perché gRPC sta ridisegnando l'integrazione aziendale
Se i protocolli basati su testo e i wrapper REST gestiti stanno raggiungendo un muro prestazionale, qual è l'alternativa? La prossima generazione di architetture aziendali ad alto throughput si sta allontanando con decisione dalla comunicazione testuale e verbosa, per orientarsi verso stack di trasporto binari ottimizzati per le macchine.
È qui che gRPC e Protocol Buffers (Protobuf) cambiano radicalmente il quadro dei sistemi distribuiti. Invece di affidarsi a payload JSON sovradimensionati e a richieste HTTP ripetitive e molto frequenti, gRPC utilizza messaggi binari compatti, ottimizzati esplicitamente per la comunicazione ad alte prestazioni tra macchine. La serializzazione binaria comprime le strutture dati in modo molto serrato, riducendo drasticamente le dimensioni dei payload, spesso di un ordine di grandezza rispetto agli equivalenti JSON.
La riduzione delle dimensioni del payload si traduce direttamente in un minore overhead della CPU. Analizzare dati binari Protobuf richiede uno sforzo computazionale minimo rispetto all'analisi di documenti testuali voluminosi. Inoltre, gRPC opera nativamente su HTTP/2, abilitando flussi multiplexati su un'unica connessione TCP, con una forte riduzione della latenza di impostazione della connessione e l'eliminazione di hop di rete non necessari.
Un altro vantaggio importante del passaggio a un'architettura nativa per protocolli è la comunicazione schema-first. Le integrazioni REST tradizionali soffrono spesso di interface drift, in cui modifiche non documentate ai campi o parametri mancanti interrompono i flussi dipendenti durante l'esecuzione. gRPC impone contratti fortemente tipizzati tramite definizioni Protobuf compilate. Sia il client sia il server concordano la struttura esatta dei dati prima del deployment, eliminando intere classi di bug di integrazione e garantendo la piena aderenza al contratto attraverso i confini dei sistemi aziendali distribuiti.
Addio al polling: flussi persistenti e trasporto in tempo reale
I connettori gestiti tradizionali si basano fondamentalmente su un presupposto architetturale superato: che il lavoro aziendale inizi sempre con una richiesta discreta e reattiva. Ma nel panorama moderno dell'AI aziendale in tempo reale e dell'automazione istantanea basata sugli eventi, attendere che i sistemi eseguano il polling per ottenere aggiornamenti introduce ritardi inaccettabili e uno spreco di banda.
Lo spostamento architetturale dal polling verso protocolli di streaming persistenti non è più facoltativo per i sistemi su larga scala. Tecnologie come WebSocket, HTTP/3, QUIC e WebTransport consentono ai sistemi di mantenere canali di comunicazione bidirezionali persistenti, in cui i dati vengono inviati immediatamente nel momento in cui si verifica un evento.
Il polling genera enormi volumi di traffico vuoto che saturano le interfacce di rete ed esauriscono le risorse di calcolo. I modelli di streaming persistente, al contrario, mantengono una connessione aperta in cui il contesto scorre in modo continuo con un overhead di protocollo minimo. Inoltre, protocolli di trasporto moderni come QUIC eliminano i principali colli di bottiglia di rete, come il blocco Head-of-Line, garantendo che la perdita di pacchetti su un singolo flusso non blocchi la trasmissione di dati non correlati.
Passando a trasporti persistenti basati su eventi, le organizzazioni possono ottenere una consegna degli eventi inferiore a 100 millisecondi su scala globale. Questa capacità è particolarmente importante per supportare le forze di lavoro distribuite moderne e gli agenti AI in tempo reale, che richiedono la propagazione immediata del contesto senza attendere intervalli di polling periodici per sincronizzare lo stato.
Costruire resilienza: code asincrone e architetture tolleranti ai guasti
I sistemi ad alta velocità privi di una solida tolleranza ai guasti diventano inevitabilmente motori di errori ad alta velocità. Uno dei difetti di progettazione più pericolosi delle catene di integrazione sincrone basate su connettori è la cieca convinzione che ogni servizio a valle, database e API SaaS di terze parti rimanga sempre disponibile.
Negli ambienti aziendali reali, i sistemi distribuiti sperimentano continuamente guasti parziali, interruzioni temporanee di rete, manutenzioni dei database in sequenza e improvvisi picchi di traffico. Quando i flussi di integrazione sono fortemente accoppiati in una catena sincrona, un rallentamento temporaneo di un singolo servizio periferico genera una contropressione che si propaga a monte, paralizzando le applicazioni aziendali core.
I pattern di resilienza asincrona risolvono questa vulnerabilità disaccoppiando la velocità di acquisizione dalla velocità di elaborazione. Introducendo code di messaggi durevoli e broker di eventi, come Azure Service Bus, RabbitMQ o Amazon SQS, tra i confini dei tuoi servizi, crei un buffer robusto contro l'instabilità.
Quando il layer di integrazione è investito da picchi di traffico, gli eventi in arrivo vengono acquisiti in sicurezza e conservati in uno storage durevole, anziché costringere a un'elaborazione sincrona immediata su dipendenze a valle instabili. I consumer a valle prelevano i messaggi dalla coda a una velocità sostenibile e controllata. Se un servizio di backend va offline per manutenzione, la coda conserva al sicuro i dati fino al ripristino, evitando la perdita di dati, eliminando i guasti a cascata catastrofici e garantendo che l'architettura aziendale resti resiliente anche sotto stress estremo.
Il cambio di runtime: riprendere il controllo con connettori integrati
Oltre ai protocolli di rete e alle strategie di accodamento, gli architetti aziendali devono esaminare con attenzione il runtime di esecuzione fisico dei layer di integrazione. Uno degli aspetti più fraintesi dell'automazione cloud riguarda il luogo in cui i connettori gestiti vengono effettivamente eseguiti.
Molte organizzazioni presumono che, poiché la logica di integrazione è ospitata all'interno della propria sottoscrizione cloud aziendale, come in Azure Logic Apps, tutta l'elaborazione dei dati resti al sicuro entro i confini della rete fidata. Tuttavia, molti connettori gestiti tradizionali operano come integrazioni SaaS esterne, eseguite su infrastrutture multi-tenant condivise e completamente al di fuori della tua Virtual Network (VNet).
Questa realtà architetturale crea gravi vulnerabilità di sicurezza e di conformità allo zero-trust. Quando i dati aziendali sensibili lasciano il perimetro della rete privata per essere elaborati da middleware gestito di terze parti, si perde il controllo diretto sul livello di trasporto. Per colmare questo divario, le organizzazioni spesso ricorrono agli On-Premises Data Gateway, che però diventano frequentemente enormi colli di bottiglia aziendali e singoli punti di guasto.
La soluzione sta in un cambio strategico di runtime verso connettori integrati e modelli di esecuzione isolati, come Azure Logic Apps Standard in esecuzione su App Service Environment dedicati o runtime containerizzati. I connettori integrati vengono eseguiti direttamente nel proprio runtime di calcolo e all'interno dei confini della propria VNet. Questo elimina i salti verso servizi SaaS esterni, riduce drasticamente la latenza, soddisfa i rigidi requisiti di conformità allo zero-trust e restituisce il pieno controllo architetturale sulle pipeline di dati aziendali.
Conclusione: progettare per una scalabilità resiliente nell'era dell'AI
L'epoca in cui l'integrazione veniva trattata come un ripensamento low-code è ufficialmente finita. Mentre le aziende corrono per distribuire modelli AI sofisticati, agenti autonomi e pipeline di dati in tempo reale, i modelli di trasporto fragili su cui si basano i connettori gestiti tradizionali stanno cedendo sotto la pressione. Attriti del middleware, costi nascosti di latenza, colli di bottiglia dovuti al throttling e runtime condivisi non sicuri non sono più piccoli inconvenienti: sono rischi aziendali critici che compromettono la stabilità del sistema e bloccano l'innovazione digitale.
Costruire per il futuro richiede un cambio di mentalità profondo. Dobbiamo allontanarci dal polling REST continuo, dai payload JSON ingombranti e dal middleware gestito "a scatola nera", puntando invece su un'ingegneria nativa del protocollo: serializzazione binaria con gRPC, streaming persistente in tempo reale, resilienza asincrona con code di messaggi e una sovranità rigorosa sul runtime.
Per approfondire questi cambiamenti architetturali, esplorare pattern di progettazione pratici e capire come rendere la tua strategia di integrazione pronta per le esigenze dell'intelligenza artificiale moderna, ascolta l'episodio del podcast di approfondimento: Custom Connectors vs Model Context Protocol for Enterprise AI. Riprendere il controllo del livello di trasporto aziendale è il passo più importante che puoi compiere per costruire sistemi di automazione davvero resilienti e scalabili.