 ES
 English
 Deutsch
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
El coste oculto de la comodidad: por qué los conectores gestionados están fallando en la IA empresarial
By Mirko Peters ·
Durante años, las organizaciones han adoptado las herramientas de integración low-code, los motores de automatización y los conectores gestionados como el estándar de oro absoluto de la transformación digital…
Automatically translated with AI from the original post. Read the English original
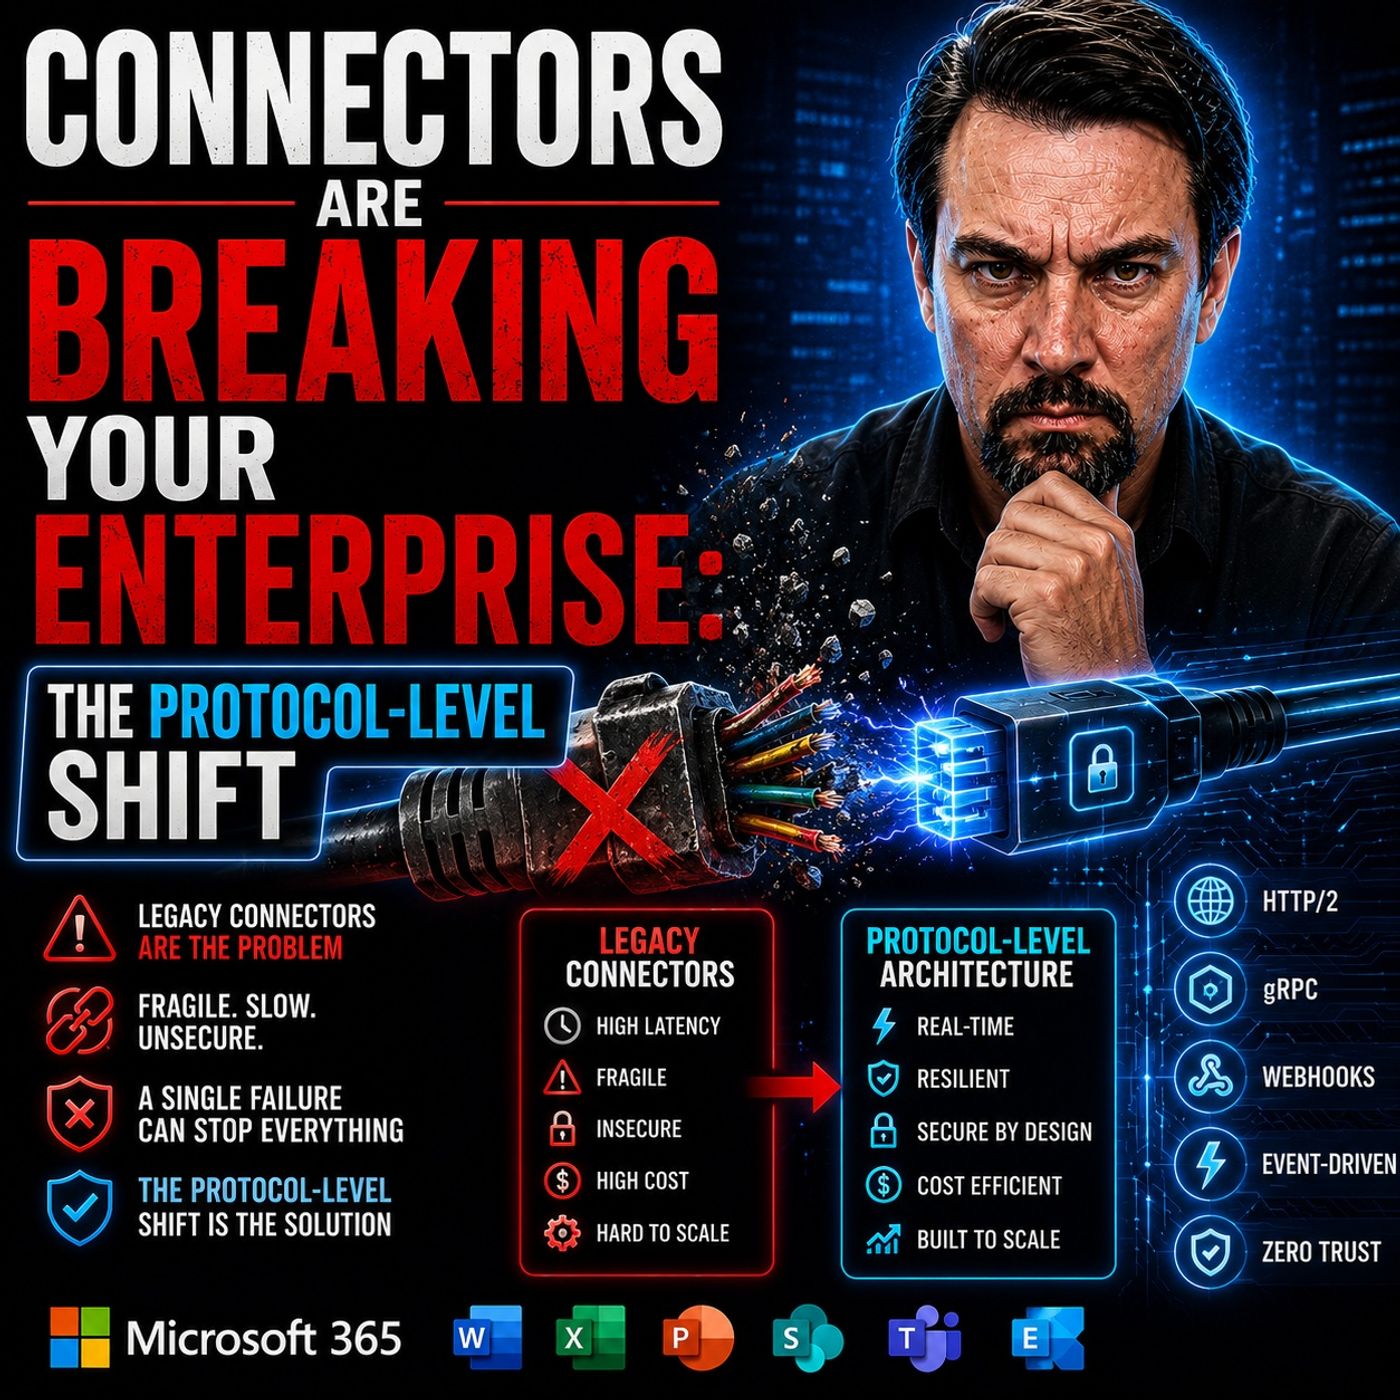
Durante años, las organizaciones han adoptado las herramientas de integración low-code, los motores de automatización y los conectores gestionados como el estándar de oro absoluto para la transformación digital. Representan el "botón fácil" de la arquitectura moderna. ¿Necesitas conectar Salesforce con Azure? Añade un conector gestionado. ¿Necesitas ingerir telemetría en tu data lake o enrutar notificaciones a través de canales de comunicación empresariales? Crea un envoltorio low-code, configura unos cuantos tokens de autenticación y observa cómo fluyen los datos. Estos módulos prefabricados prometen un despliegue rápido, menos fricción y una necesidad mínima de supervisión de ingeniería avanzada.
Sin embargo, bajo esta capa de comodidad operativa extrema se esconde un modelo de transporte frágil y muy quebradizo. La arquitectura empresarial moderna, en particular el crecimiento explosivo de la inteligencia artificial, los flujos de trabajo agénticos en tiempo real y el tráfico máquina a máquina de alta concurrencia, está poniendo al descubierto las profundas limitaciones estructurales de las plataformas de integración gestionadas tradicionales. Cuando los flujos de trabajo fallan bajo una concurrencia elevada, cuando la latencia se dispara de forma impredecible o cuando las aplicaciones entran en cascada hacia caídas generalizadas, los equipos de desarrollo suelen señalar la lógica de la aplicación o la inestabilidad del modelo. Pero, en la mayoría de los casos, la causa raíz está más escondida en el sistema: en la propia capa de transporte.
Para entender de verdad por qué la automatización empresarial se atasca bajo carga, debemos retirar las capas de abstracción que proporcionan los conectores heredados y examinar las penalizaciones arquitectónicas que pagamos por la comodidad. Al entrar en una era dominada por cargas de trabajo de IA de alto rendimiento, es momento de revisar los costes ocultos del middleware gestionado y explorar los paradigmas de ingeniería necesarios para construir sistemas resilientes y escalables.
La trampa de la comodidad de los conectores gestionados
La filosofía central de los conectores gestionados es la velocidad de salida al mercado. Al abstraer las llamadas de red subyacentes, los esquemas de API y los protocolos de transporte, los proveedores permiten a los desarrolladores componer procesos de negocio complejos en cuestión de horas en lugar de semanas. Sin embargo, esta abstracción tiene un precio arquitectónico elevado.
Cada conector gestionado actúa como un intermediario activo situado justo entre tus microservicios distribuidos. Cuando se inicia una solicitud, tus datos son interceptados, reempaquetados, serializados, enrutados a través de una infraestructura compartida multiinquilino, sometidos a las reglas de limitación de la puerta de enlace, evaluados por las capas de aplicación de directivas y, finalmente, traducidos antes de llegar a su destino previsto. Esta interceptación constante introduce dependencias arquitectónicas ocultas. Tu sistema ya no se comunica directamente con el servicio de destino; se comunica a través de un intermediario de caja negra cuya capacidad interna, asignación de recursos y estado operativo quedan totalmente fuera de tu control operativo.
Además, este modelo de infraestructura compartida introduce de forma inherente una fricción de middleware impredecible. Como estos conectores suelen ejecutarse en una infraestructura multiinquilino gestionada por terceros, tus cargas de datos empresariales críticas compiten por ciclos de CPU, asignaciones de memoria y ancho de banda de red junto a miles de otros inquilinos. Cuando se producen picos de tráfico a nivel global, tus flujos de trabajo localizados quedan expuestos al ruido de los vecinos y a limitaciones de ejecución repentinas. El diseño orientado a la comodidad sacrifica de forma sistemática la resiliencia estructural, sustituyendo un comportamiento de red determinista por una orquestación probabilística y de caja negra.
El impuesto de latencia y los costes arquitectónicos ocultos
Los arquitectos caen con frecuencia en la trampa de ver los conectores como tuberías transparentes, conductos neutrales que simplemente pasan datos del punto A al punto B. En realidad, los conectores son capas de integración intensivas en cómputo que imponen un pesado impuesto de rendimiento acumulativo sobre toda tu pila tecnológica.
Considera la mecánica de una arquitectura tradicional de sondeo (polling) basada en REST. Para comprobar si hay actualizaciones o cambios de datos, un conector gestionado debe enviar de forma continua ciclos repetitivos de solicitud y respuesta. Si un sistema sondea cada pocos segundos en cientos de flujos de trabajo concurrentes, el desperdicio de infraestructura es asombroso. Millones de solicitudes HTTP devuelven cargas vacías, consumiendo enormes cantidades de ciclos de CPU en el análisis, los handshakes de conexión y la sobrecarga de cabeceras.
Aquí llegamos al alto coste de la serialización repetitiva de JSON. Las cargas basadas en texto, como JSON, son notablemente legibles para las personas, pero resultan terriblemente ineficientes para la comunicación máquina a máquina. Cada vez que un conector procesa una carga, debe serializar estructuras de datos complejas en formatos de cadena voluminosos en el extremo emisor, transmitir esas cargas infladas por la red y, después, volver a analizar esas cadenas en memoria en el extremo receptor. A medida que los flujos de trabajo distribuidos aumentan en complejidad, esta latencia se acumula de forma exponencial.
Peor aún es el efecto en cascada de los errores 429 de limitación de tasa y de throttling. Cuando una API de destino detecta una afluencia de solicitudes procedente de un conector administrado, responde con códigos de throttling. Las plataformas de integración estándar responden a estas señales iniciando reintentos automáticos. Bajo un tráfico intenso, estos reintentos se multiplican rápidamente y se convierten en tormentas de reintentos destructivas que, en la práctica, lanzan un ataque de denegación de servicio distribuido (DDoS) localizado contra tus propios sistemas internos. Los flujos de trabajo que funcionan a la perfección en entornos de pruebas, con pruebas de desarrollo de bajo volumen, acaban colapsando bajo el peso implacable de la concurrencia empresarial del mundo real.
De REST a binario: por qué gRPC está transformando la integración empresarial
Si los protocolos basados en texto y los envoltorios REST administrados están topando con un muro de rendimiento, ¿cuál es la alternativa? La próxima generación de arquitecturas empresariales de alto rendimiento se está alejando de forma decidida de la comunicación textual y verbosa para orientarse hacia pilas de transporte binario optimizadas para máquinas.
Aquí es donde gRPC y Protocol Buffers (Protobuf) cambian fundamentalmente el planteamiento de los sistemas distribuidos. En lugar de depender de cargas JSON sobredimensionadas y de solicitudes HTTP repetitivas y muy habladoras, gRPC utiliza mensajes binarios compactos, optimizados explícitamente para la comunicación de alto rendimiento entre máquinas. La serialización binaria empaqueta las estructuras de datos de forma densa en bytes, lo que reduce drásticamente el tamaño de las cargas, a menudo en un orden de magnitud en comparación con sus equivalentes en JSON.
La reducción del tamaño de las cargas se traduce directamente en una menor sobrecarga de CPU. Analizar datos binarios de Protobuf exige un esfuerzo computacional mínimo en comparación con analizar documentos de texto extensos. Además, gRPC funciona de forma nativa sobre HTTP/2, lo que permite flujos multiplexados sobre una única conexión TCP, reduciendo drásticamente la latencia de establecimiento de conexión y eliminando saltos de red innecesarios.
Otra ventaja importante de pasar a una arquitectura nativa de protocolo es la comunicación basada en esquemas (schema-first). Las integraciones REST tradicionales suelen sufrir de deriva de interfaz, donde cambios no documentados en los campos o parámetros que faltan rompen los flujos de trabajo dependientes en tiempo de ejecución. gRPC impone contratos fuertemente tipados mediante definiciones de Protobuf compiladas. Tanto el cliente como el servidor acuerdan la forma exacta de los datos antes del despliegue, eliminando clases enteras de errores de integración y garantizando una fidelidad absoluta del contrato en los límites de los sistemas empresariales distribuidos.
Adiós al sondeo: flujos persistentes y transporte en tiempo real
Los conectores administrados tradicionales se apoyan fundamentalmente en una suposición arquitectónica obsoleta: que el trabajo empresarial siempre comienza con una solicitud discreta y reactiva. Pero en el panorama actual de la IA empresarial en tiempo real y de la automatización instantánea basada en eventos, esperar a que los sistemas consulten si hay actualizaciones introduce retrasos inaceptables y desperdicia ancho de banda.
El cambio arquitectónico, alejándose del sondeo y acercándose a los protocolos de streaming persistente, ya no es opcional para los sistemas de alta escala. Tecnologías como WebSockets, HTTP/3, QUIC y WebTransport permiten a los sistemas mantener canales de comunicación bidireccionales y persistentes, en los que los datos se envían al instante en cuanto se produce un evento.
El sondeo genera enormes volúmenes de tráfico vacío que saturan las interfaces de red y agotan los recursos de cómputo. Los modelos de streaming persistente, en cambio, mantienen una conexión abierta por la que el contexto fluye de forma continua con una sobrecarga de protocolo mínima. Además, protocolos de transporte modernos como QUIC eliminan cuellos de botella de red importantes, como el bloqueo de cabecera de línea (Head-of-Line blocking), garantizando que la pérdida de paquetes en un flujo no detenga la transmisión de datos no relacionados.
Al pasar a transportes de eventos persistentes, las organizaciones pueden lograr una entrega de eventos inferior a 100 milisegundos a escala global. Esta capacidad es especialmente importante para dar soporte a las plantillas distribuidas modernas y a los agentes de IA en tiempo real, que necesitan propagar el contexto al instante, sin esperar a intervalos de sondeo periódicos para sincronizar el estado.
Crear resiliencia: colas asíncronas y arquitecturas tolerantes a fallos
Los sistemas de alta velocidad que no cuentan con una tolerancia a fallos sólida acaban convirtiéndose, inevitablemente, en motores de fallos de alta velocidad. Uno de los defectos de diseño más peligrosos de las cadenas de integración síncronas basadas en conectores es suponer ciegamente que todos los servicios posteriores, bases de datos y API SaaS de terceros van a estar disponibles de forma continua.
En entornos empresariales reales, los sistemas distribuidos sufren fallos parciales constantes, particiones de red transitorias, operaciones de mantenimiento de bases de datos en rodaje y picos repentinos de tráfico. Cuando los flujos de integración están fuertemente acoplados en una cadena síncrona, una ralentización temporal en un único servicio periférico provoca una contrapresión que se propaga hacia arriba y paraliza las aplicaciones de negocio críticas.
Los patrones de resiliencia asíncrona resuelven esta vulnerabilidad desacoplando la velocidad de ingesta de la velocidad de procesamiento. Al introducir colas de mensajes duraderas y brokers de eventos, como Azure Service Bus, RabbitMQ o Amazon SQS, entre los límites de tus servicios, creas un colchón sólido frente a la volatilidad.
Cuando una ráfaga de tráfico llega a tu capa de integración, los eventos entrantes se ingieren de forma segura y se almacenan en un almacenamiento duradero, en lugar de forzar un procesamiento síncrono inmediato a través de dependencias posteriores inestables. Los consumidores posteriores extraen los mensajes de la cola a un ritmo sostenible y controlado. Si un servicio de backend se desconecta por mantenimiento, la cola conserva los datos a salvo hasta que se recupere, lo que evita la pérdida de datos, elimina los fallos en cascada catastróficos y garantiza que la arquitectura empresarial siga siendo resiliente bajo una presión extrema.
El cambio de runtime: recuperar la soberanía con conectores integrados
Más allá de los protocolos de red y las estrategias de colas, los arquitectos empresariales deben examinar con detenimiento el runtime de ejecución física de sus capas de integración. Uno de los aspectos más incomprendidos de la automatización en la nube es dónde se ejecutan realmente los conectores gestionados.
Muchas organizaciones dan por hecho que, como su lógica de integración está alojada dentro de su suscripción de nube empresarial (por ejemplo, en Azure Logic Apps), todo el procesamiento de datos permanece aislado de forma segura dentro de sus límites de red de confianza. Sin embargo, muchos conectores gestionados tradicionales funcionan como integraciones SaaS externas que se ejecutan en infraestructura multiinquilino compartida, completamente fuera de tu red virtual (VNet).
Esta realidad arquitectónica genera graves vulnerabilidades de seguridad y de cumplimiento del modelo de confianza cero. Cuando tus datos corporativos sensibles salen del perímetro de tu red privada para ser procesados por middleware gestionado de terceros, renuncias al control directo de la capa de transporte. Para salvar esta brecha, las organizaciones suelen recurrir a las puertas de enlace de datos locales, que con frecuencia se convierten en enormes cuellos de botella empresariales y en puntos únicos de fallo.
La solución pasa por un cambio estratégico de runtime hacia conectores integrados y modelos de ejecución aislados, como Azure Logic Apps Standard ejecutándose en entornos de App Service dedicados o en runtimes en contenedores. Los conectores integrados se ejecutan directamente dentro de tu propio runtime de cómputo y de tu límite de VNet. Así se eliminan los saltos SaaS externos, se reduce drásticamente la latencia, se cumplen las exigentes normativas de confianza cero y se recupera el control total de la arquitectura sobre tus canalizaciones de datos empresariales.
Conclusión: diseñar para escalar con resiliencia en la era de la IA
La época de tratar la integración como un añadido de bajo código ha terminado oficialmente. Mientras las empresas se apresuran a desplegar modelos de IA sofisticados, agentes autónomos y canalizaciones de datos en tiempo real, los modelos de transporte frágiles que sustentan los conectores gestionados tradicionales se están resquebrajando bajo la presión. La fricción del middleware, los costes ocultos de latencia, los cuellos de botella por limitación de peticiones y los runtimes compartidos inseguros ya no son molestias menores: son riesgos empresariales críticos que comprometen la estabilidad del sistema y frenan la innovación digital.
Construir para el futuro exige un cambio profundo de mentalidad. Debemos alejarnos del sondeo REST constante, de las cargas JSON voluminosas y del middleware gestionado de caja negra, y orientarnos en su lugar hacia la ingeniería nativa de protocolos, la serialización binaria con gRPC, el streaming persistente en tiempo real, la resiliencia asíncrona respaldada por colas y una soberanía estricta sobre el entorno de ejecución.
Para profundizar en estos cambios de arquitectura, explorar patrones de diseño prácticos y aprender a preparar tu estrategia de integración frente a las exigencias de la inteligencia artificial moderna, no dejes de escuchar el episodio del podcast que lo acompaña: Custom Connectors vs Model Context Protocol for Enterprise AI. Recuperar el control de la capa de transporte de tu empresa es el paso más importante que puedes dar para construir sistemas de automatización verdaderamente resilientes y escalables.