 PT
 English
 Deutsch
 Español
 Français
 Italiano
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
O custo oculto da conveniência: por que os conectores gerenciados estão falhando na IA corporativa
By Mirko Peters ·
Há anos, as organizações têm adotado ferramentas de integração low-code, mecanismos de automação e conectores gerenciados como o padrão-ouro absoluto para a transformação digital…
Automatically translated with AI from the original post. Read the English original
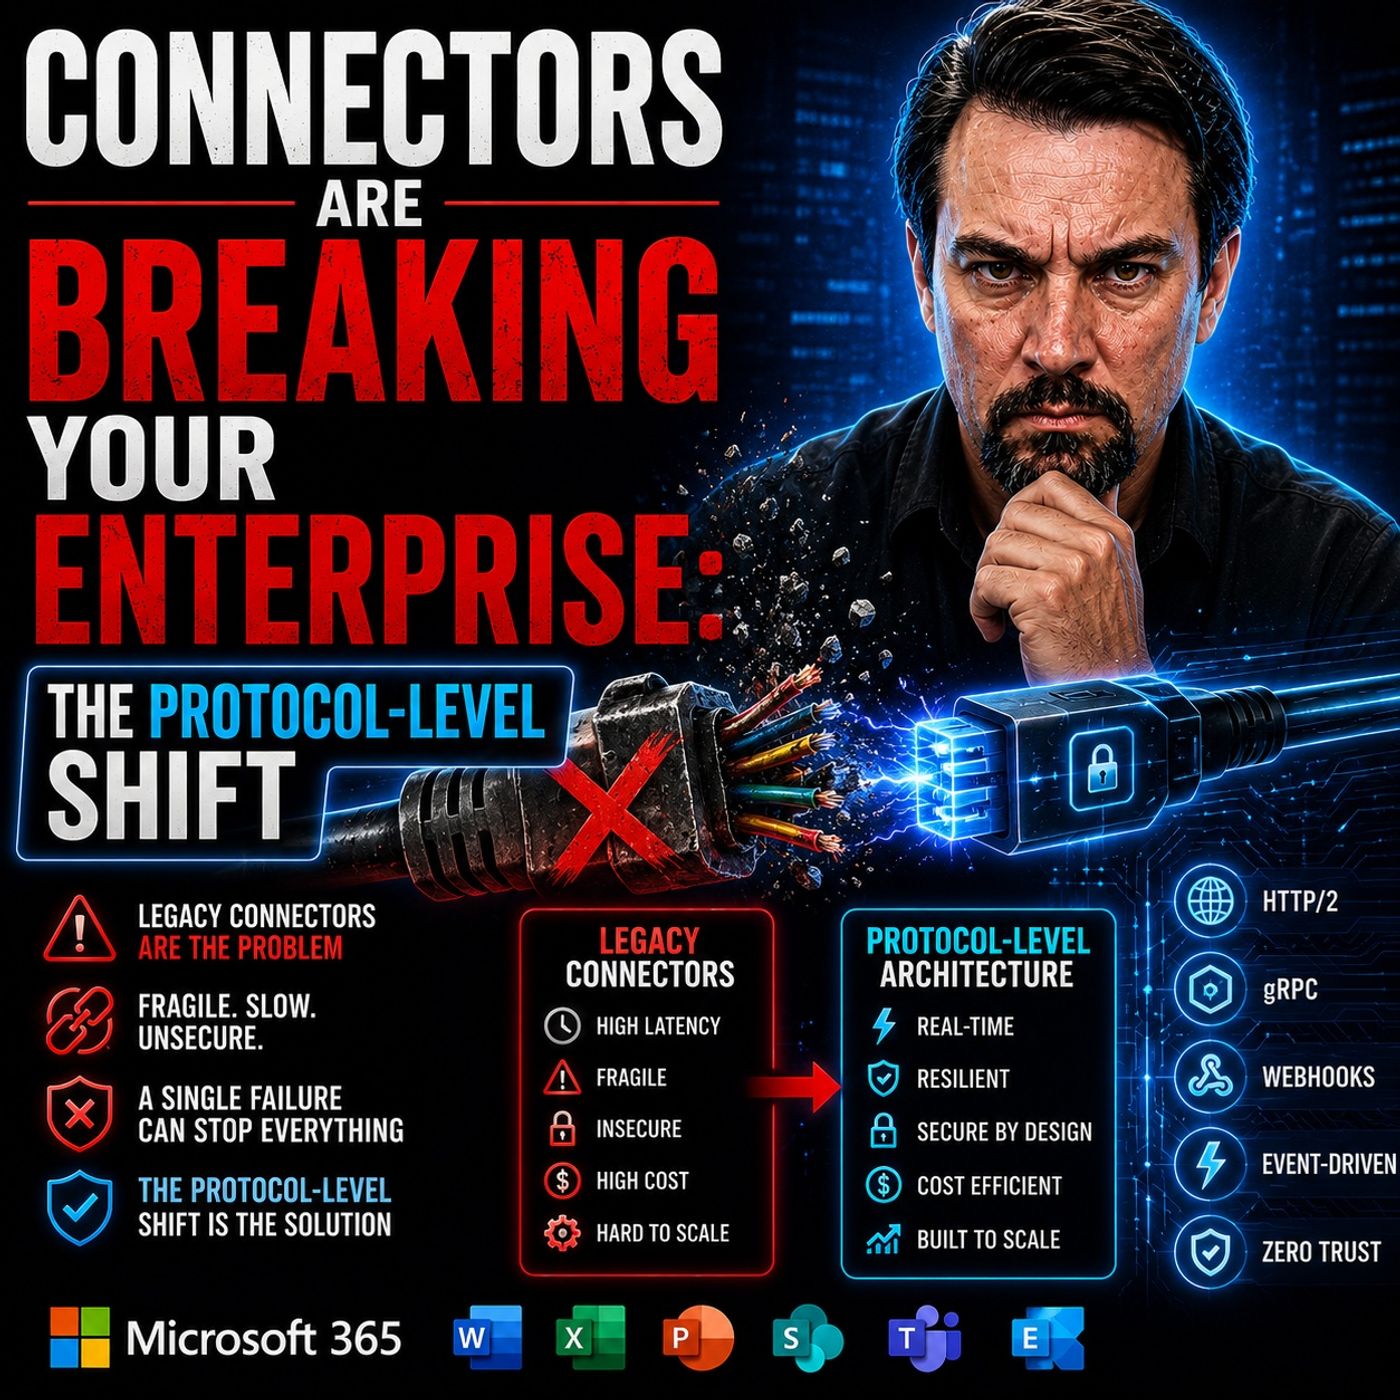
Há anos, as organizações vêm adotando ferramentas de integração low-code, mecanismos de automação e conectores gerenciados como o padrão-ouro absoluto para a transformação digital. Eles representam o "botão fácil" da arquitetura moderna. Precisa conectar o Salesforce ao Azure? Basta adicionar um conector gerenciado. Precisa ingerir telemetria no seu data lake ou direcionar notificações por canais de comunicação corporativos? Configure um wrapper low-code, defina alguns tokens de autenticação e observe os dados fluindo. Esses módulos prontos prometem implantação rápida, menos atrito e pouca necessidade de supervisão técnica aprofundada.
No entanto, por trás dessa camada de conveniência operacional extrema, existe um modelo de transporte frágil e altamente vulnerável. A arquitetura corporativa moderna, especialmente o crescimento explosivo da inteligência artificial, dos fluxos de trabalho agênticos em tempo real e do tráfego máquina a máquina de alta concorrência, está expondo as profundas limitações estruturais das plataformas tradicionais de integração gerenciada. Quando fluxos de trabalho falham sob forte concorrência, quando a latência sobe de forma imprevisível ou quando aplicações entram em cascata e causam indisponibilidades generalizadas, as equipes de desenvolvimento frequentemente apontam para a lógica da aplicação ou para a instabilidade do modelo. Mas, na maioria das vezes, a causa raiz está escondida mais fundo no sistema: na própria camada de transporte.
Para entender de fato por que a automação corporativa trava sob carga, precisamos remover as camadas de abstração oferecidas pelos conectores legados e examinar as penalidades arquiteturais que pagamos pela conveniência. À medida que entramos em uma era dominada por cargas de trabalho de IA de alta vazão, chegou a hora de reavaliar os custos ocultos do middleware gerenciado e explorar os paradigmas de engenharia necessários para construir sistemas resilientes e escaláveis.
A armadilha da conveniência dos conectores gerenciados
A filosofia central por trás dos conectores gerenciados é a velocidade de chegada ao mercado. Ao abstrair as chamadas de rede subjacentes, os esquemas de API e os protocolos de transporte, os fornecedores permitem que desenvolvedores montem processos de negócio complexos em questão de horas, e não de semanas. No entanto, essa abstração tem um preço arquitetural alto.
Todo conector gerenciado atua como um intermediário ativo posicionado entre seus microsserviços distribuídos. Quando uma requisição é iniciada, seus dados são interceptados, reempacotados, serializados, roteados pela infraestrutura compartilhada multilocatário, submetidos às regras de limitação de tráfego do gateway, avaliados pelas camadas de imposição de políticas e, por fim, traduzidos antes de chegar ao destino pretendido. Essa interceptação constante introduz dependências arquiteturais ocultas. Seu sistema não se comunica mais diretamente com o serviço de destino; ele se comunica por meio de um intermediário de caixa-preta cuja capacidade interna, alocação de recursos e saúde operacional permanecem totalmente fora do seu controle operacional.
Além disso, esse modelo de infraestrutura compartilhada introduz, por natureza, um atrito imprevisível no middleware. Como esses conectores frequentemente são executados em infraestrutura multilocatário gerenciada por terceiros, suas cargas de dados corporativas críticas disputam ciclos de CPU, alocações de memória e largura de banda de rede com milhares de outros locatários. Quando ocorrem picos de tráfego globais, seus fluxos de trabalho localizados ficam vulneráveis a interferências de vizinhos e à aplicação abrupta de limitações de tráfego. Um design orientado à conveniência sacrifica de forma consistente a resiliência estrutural, substituindo um comportamento de rede determinístico por uma orquestração probabilística de caixa-preta.
A taxa de latência e os custos arquiteturais ocultos
Arquitetos frequentemente caem na armadilha de enxergar os conectores como canos transparentes, condutos neutros que simplesmente repassam dados do ponto A ao ponto B. Na realidade, os conectores são camadas de integração intensivas em computação que impõem uma pesada e cumulativa taxa de desempenho sobre toda a sua pilha tecnológica.
Considere a mecânica de uma arquitetura tradicional de polling baseada em REST. Para verificar atualizações ou mudanças de dados, um conector gerenciado precisa disparar continuamente ciclos repetitivos de requisição e resposta. Se um sistema faz polling a cada poucos segundos em centenas de fluxos de trabalho simultâneos, o desperdício de infraestrutura é impressionante. Milhões de requisições HTTP retornam payloads vazios, consumindo grandes quantidades de ciclos de CPU para parsing, handshakes de conexão e overhead de cabeçalhos.
Isso nos leva ao alto custo da serialização repetitiva de JSON. Payloads baseados em texto, como o JSON, são surpreendentemente legíveis para humanos, mas são terrivelmente ineficientes na comunicação máquina a máquina. Toda vez que um conector processa um payload, ele precisa serializar estruturas de dados complexas em formatos de string volumosos na ponta de envio, transmitir esses payloads inchados pela rede e, em seguida, converter essas strings de volta em memória na ponta de recebimento. À medida que os fluxos de trabalho distribuídos ganham complexidade, essa latência se acumula de forma exponencial.
Pior ainda é o efeito em cascata dos erros 429 de limitação de taxa e de throttling. Quando uma API downstream detecta um volume excessivo de requisições vindas de um conector gerenciado, ela responde com códigos de throttling. As plataformas de integração padrão reagem a esses sinais iniciando novas tentativas automatizadas. Sob tráfego intenso, essas novas tentativas se multiplicam rapidamente e se transformam em tempestades de retentativas destrutivas, que efetivamente lançam um ataque de negação de serviço distribuído (DDoS) localizado contra os seus próprios sistemas internos. Fluxos de trabalho que funcionam perfeitamente em ambientes de staging, com testes de desenvolvedores de baixo volume, inevitavelmente entram em colapso sob o peso implacável da concorrência de ambientes corporativos reais.
De REST a binário: por que o gRPC está redefinindo a integração corporativa
Se os protocolos baseados em texto e os wrappers REST gerenciados estão batendo em um limite de desempenho, qual é a alternativa? A próxima geração de arquiteturas corporativas de alto throughput está migrando com determinação da comunicação textual verbosa para pilhas de transporte binárias otimizadas para máquinas.
É aqui que o gRPC e o Protocol Buffers (Protobuf) mudam fundamentalmente a equação dos sistemas distribuídos. Em vez de depender de payloads JSON superdimensionados e de requisições HTTP repetitivas e excessivamente tagarelas, o gRPC utiliza mensagens binárias compactas, otimizadas explicitamente para comunicação de alto desempenho entre máquinas. A serialização binária empacota as estruturas de dados de forma densa em bytes, reduzindo drasticamente o tamanho dos payloads, frequentemente em uma ordem de grandeza em comparação com seus equivalentes em JSON.
A redução no tamanho do payload se traduz diretamente em menor sobrecarga de CPU. Fazer o parsing de dados binários Protobuf exige esforço computacional mínimo, em comparação com o parsing de documentos de texto extensos. Além disso, o gRPC opera nativamente sobre HTTP/2, habilitando streams multiplexados em uma única conexão TCP, o que reduz drasticamente a latência de estabelecimento de conexão e elimina saltos de rede desnecessários.
Outra grande vantagem de migrar para uma arquitetura nativa de protocolo é a comunicação schema-first. Integrações REST tradicionais frequentemente sofrem com o interface drift, situação em que alterações de campos não documentadas ou parâmetros ausentes quebram fluxos de trabalho dependentes em tempo de execução. O gRPC impõe contratos fortemente tipados por meio de definições Protobuf compiladas. Tanto o cliente quanto o servidor concordam com a forma exata dos dados antes da implantação, eliminando classes inteiras de bugs de integração e garantindo fidelidade absoluta do contrato entre os limites dos sistemas distribuídos corporativos.
Adeus ao polling: streams persistentes e transporte em tempo real
Os conectores gerenciados tradicionais estão fundamentalmente ancorados em uma premissa arquitetural ultrapassada: a de que o trabalho corporativo sempre começa com uma requisição discreta e reativa. Mas, no cenário atual de IA corporativa em tempo real e automação instantânea orientada a eventos, esperar que os sistemas façam polling em busca de atualizações introduz atrasos inaceitáveis e desperdício de largura de banda.
A mudança arquitetural do polling para protocolos de streaming persistentes deixou de ser opcional para sistemas de alta escala. Tecnologias como WebSockets, HTTP/3, QUIC e WebTransport permitem que os sistemas mantenham canais de comunicação bidirecionais persistentes, nos quais os dados são enviados instantaneamente no momento em que um evento ocorre.
O polling gera volumes imensos de tráfego vazio que saturam as interfaces de rede e esgotam os recursos de computação. Já os modelos de streaming persistente mantêm uma conexão aberta, por onde o contexto flui continuamente com sobrecarga mínima de protocolo. Além disso, protocolos de transporte modernos como o QUIC eliminam grandes gargalos de rede, como o bloqueio de Head-of-Line, garantindo que a perda de pacotes em um stream não trave transmissões de dados não relacionadas.
Ao migrar para transportes de eventos persistentes, as organizações conseguem entregar eventos em menos de 100 milissegundos em escala global. Essa capacidade é especialmente importante para dar suporte a equipes distribuídas modernas e a agentes de IA em tempo real, que exigem propagação instantânea de contexto sem depender de intervalos de consulta periódica para sincronizar o estado.
Construindo resiliência: filas assíncronas e arquiteturas tolerantes a falhas
Sistemas de alta velocidade construídos sem tolerância a falhas robusta invariavelmente se tornam motores de falhas de alta velocidade. Um dos defeitos de projeto mais perigosos em cadeias de integração síncronas e baseadas em conectores é a suposição cega de que todo serviço downstream, banco de dados e API SaaS de terceiros permanecerá disponível continuamente.
Em ambientes corporativos reais, sistemas distribuídos enfrentam falhas parciais constantes, partições temporárias de rede, manutenções contínuas em bancos de dados e congestionamentos repentinos de tráfego. Quando os fluxos de integração estão fortemente acoplados em uma cadeia síncrona, uma lentidão temporária em um único serviço periférico gera backpressure que se propaga para trás e paralisa as aplicações de negócio essenciais.
Os padrões de resiliência assíncrona resolvem essa vulnerabilidade desacoplando a velocidade de ingestão da velocidade de processamento. Ao introduzir filas de mensagens duráveis e brokers de eventos, como Azure Service Bus, RabbitMQ ou Amazon SQS, entre os limites dos seus serviços, você cria um buffer robusto contra a volatilidade.
Quando um tráfego em rajada atinge sua camada de integração, os eventos recebidos são ingeridos com segurança e mantidos em armazenamento durável, em vez de forçar o processamento síncrono imediato em dependências downstream instáveis. Os consumidores downstream retiram mensagens da fila em um ritmo sustentável e controlado. Se um serviço de backend ficar offline para manutenção, a fila mantém os dados em segurança até a recuperação, evitando perda de dados, eliminando falhas em cascata catastróficas e garantindo que a arquitetura corporativa permaneça resiliente sob estresse extremo.
A virada de runtime: recuperando a soberania com conectores integrados
Além dos protocolos de rede e das estratégias de filas, os arquitetos corporativos precisam examinar com cuidado o runtime de execução física das suas camadas de integração. Um dos aspectos mais mal compreendidos da automação em nuvem é onde os conectores gerenciados realmente são executados.
Muitas organizações presumem que, como a lógica de integração está hospedada na assinatura de nuvem corporativa, por exemplo, no Azure Logic Apps, todo o processamento de dados permanece isolado com segurança dentro dos limites de rede confiáveis. No entanto, muitos conectores gerenciados tradicionais funcionam como integrações SaaS externas, executadas em infraestrutura multilocatário e compartilhada, totalmente fora da sua Virtual Network (VNet).
Essa realidade arquitetural cria vulnerabilidades graves de segurança e de conformidade com zero trust. Quando seus dados corporativos sensíveis saem do limite da sua rede privada para serem processados por middleware gerenciado de terceiros, você abre mão do controle direto na camada de transporte. Para contornar essa lacuna, as organizações costumam depender de On-Premises Data Gateways, que com frequência se transformam em enormes gargalos corporativos e em pontos únicos de falha.
A solução está em uma virada estratégica de runtime, em direção a conectores integrados e modelos de execução isolados, como o Azure Logic Apps Standard executado em ambientes dedicados do App Service ou em runtimes em contêineres. Os conectores integrados são executados diretamente no seu próprio runtime de computação e dentro dos limites da sua VNet. Isso elimina saltos externos para SaaS, reduz drasticamente a latência, atende a exigências rigorosas de conformidade com zero trust e restaura a soberania arquitetural completa sobre seus pipelines de dados corporativos.
Conclusão: projetando para escala resiliente na era da IA
A era de tratar a integração como um complemento de baixo código chegou oficialmente ao fim. À medida que as empresas correm para implantar modelos sofisticados de IA, agentes autônomos e pipelines de dados em tempo real, os modelos de transporte frágeis que sustentam os conectores gerenciados tradicionais estão cedendo sob a pressão. Atritos de middleware, custos ocultos de latência, gargalos de throttling e runtimes compartilhados inseguros já não são pequenos incômodos: são riscos críticos de negócio que comprometem a estabilidade dos sistemas e travam a inovação digital.
Construir para o futuro exige uma mudança fundamental de mentalidade. Precisamos deixar para trás o polling REST excessivo, os payloads JSON volumosos e o middleware gerenciado de caixa-preta, e migrar para uma engenharia nativa de protocolo, com serialização binária via gRPC, streaming persistente em tempo real, resiliência assíncrona com filas e soberania estrita sobre o runtime.
Para se aprofundar nessas mudanças de arquitetura, explorar padrões de design práticos e aprender como deixar sua estratégia de integração preparada para as exigências da inteligência artificial moderna, não deixe de ouvir o podcast complementar: Custom Connectors vs Model Context Protocol for Enterprise AI. Retomar o controle da camada de transporte da sua empresa é o passo mais importante que você pode dar para construir sistemas de automação verdadeiramente resilientes e escaláveis.