 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Ukryty koszt wygody: dlaczego zarządzane konektory zawodzą w korporacyjnej AI
By Mirko Peters ·
Od lat organizacje przyjmują narzędzia integracyjne low-code, silniki automatyzacji i zarządzane konektory jako absolutny wzorzec transformacji cyfrowej. Stanowią one „przycisk łatwości” nowoczesnej architektury. Potrzebujesz połączyć Salesforce z Azure? Dodaj zarządzany konektor. Chcesz wczytywać dane telemetryczne do jeziora danych albo kierować powiadomienia przez korporacyjne kanały komunikacj
Automatically translated with AI from the original post. Read the English original
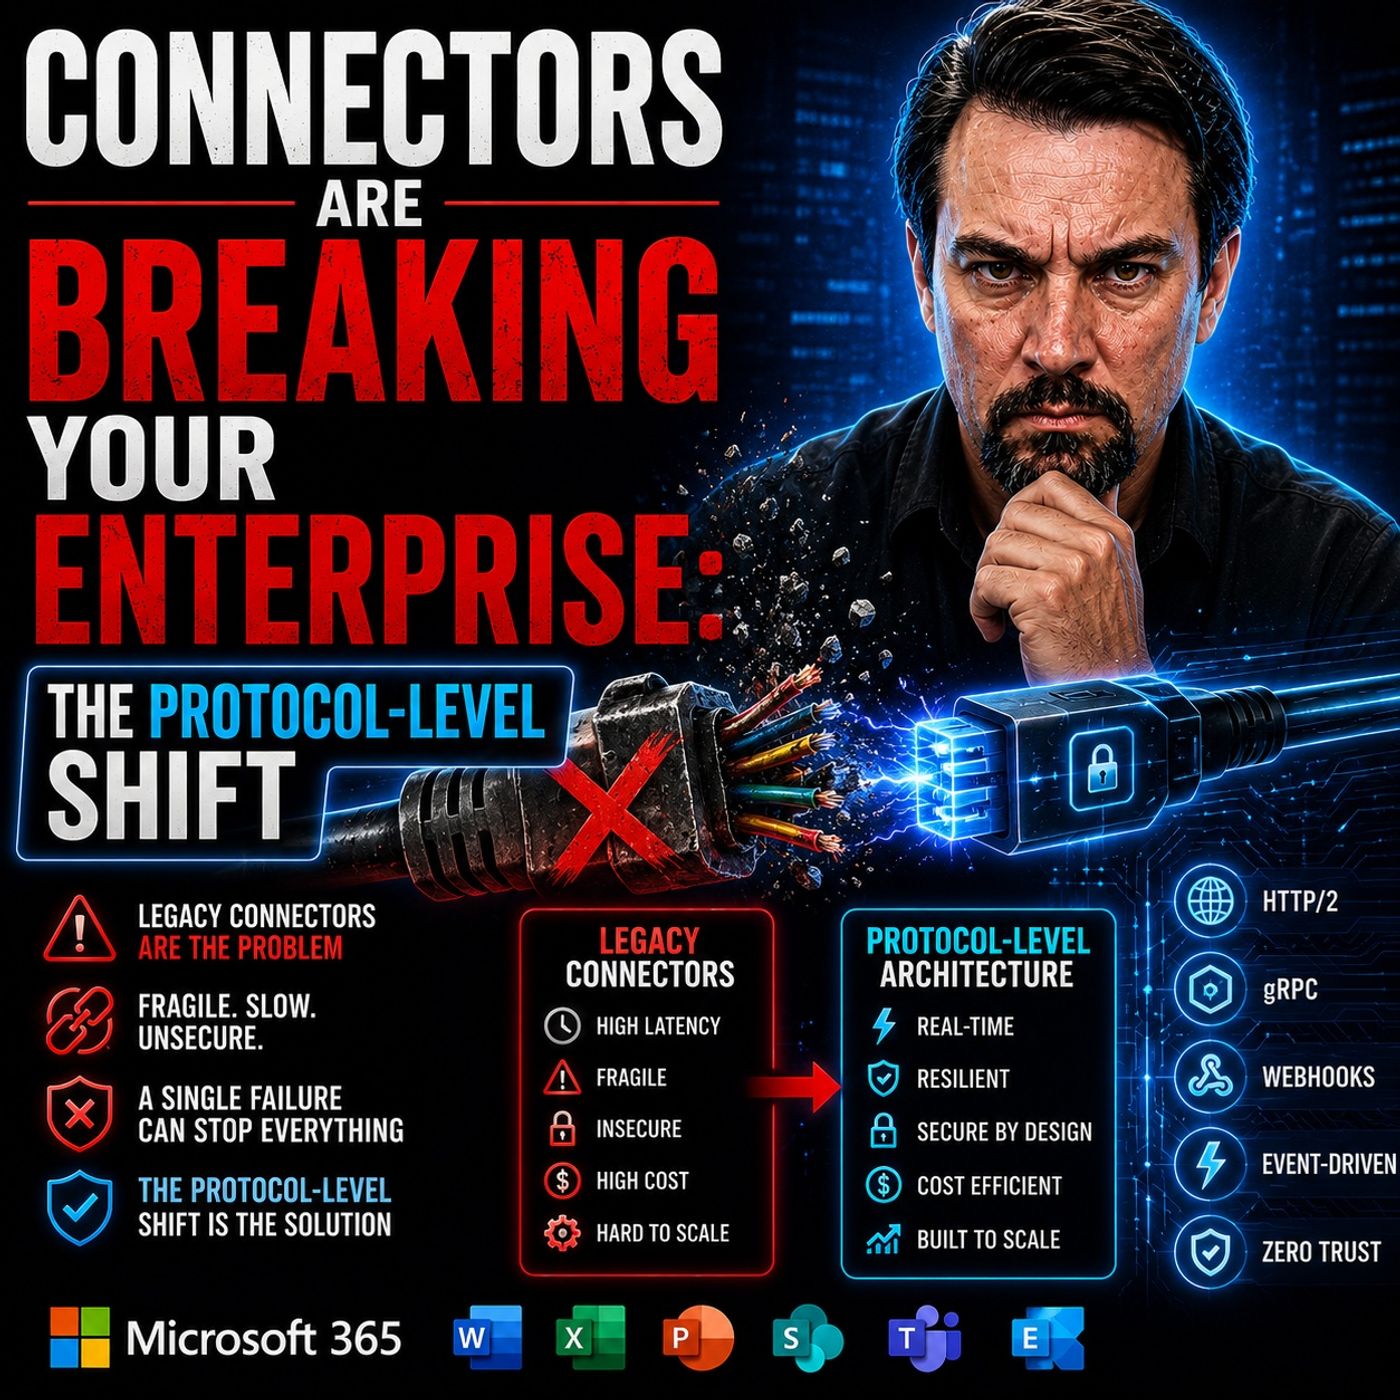
Od lat organizacje przyjmują narzędzia integracyjne low-code, silniki automatyzacji i zarządzane konektory jako absolutny wzorzec transformacji cyfrowej. Stanowią one „przycisk łatwości” nowoczesnej architektury. Potrzebujesz połączyć Salesforce z Azure? Dodaj zarządzany konektor. Chcesz wczytywać dane telemetryczne do jeziora danych albo kierować powiadomienia przez korporacyjne kanały komunikacji? Uruchom opakowanie low-code, skonfiguruj kilka tokenów uwierzytelniających i patrz, jak płyną dane. Te gotowe moduły obiecują szybkie wdrożenie, mniejsze tarcia i minimalną potrzebę głębokiego nadzoru inżynierskiego.
Pod tą fasadą ekstremalnej wygody kryje się jednak kruchy, wysoce podatny na awarie model transportu. Nowoczesna architektura korporacyjna, a zwłaszcza gwałtowny rozwój sztucznej inteligencji, agentowych przepływów pracy w czasie rzeczywistym oraz intensywnego ruchu maszyna–maszyna o wysokiej współbieżności, ujawnia głębokie strukturalne ograniczenia tradycyjnych zarządzanych platform integracyjnych. Gdy przepływy pracy zawodzą pod dużym obciążeniem, gdy opóźnienia nieprzewidywalnie rosną albo gdy aplikacje kaskadowo przechodzą w rozległe awarie, zespoły deweloperskie często wskazują na logikę aplikacji lub niestabilność modelu. Znacznie częściej jednak przyczyna tkwi głębiej w systemie: w samej warstwie transportowej.
Aby naprawdę zrozumieć, dlaczego automatyzacja w korporacji zacina się pod obciążeniem, musimy zdjąć warstwy abstrakcji dostarczane przez starsze konektory i przyjrzeć się kosztom architektonicznym, jakie ponosimy za wygodę. Wchodząc w erę zdominowaną przez obciążenia AI o wysokiej przepustowości, warto ponownie ocenić ukryte koszty zarządzanego oprogramowania pośredniczącego i poznać paradygmaty inżynierskie potrzebne do budowy odpornych, skalowalnych systemów.
Pułapka wygody zarządzanych konektorów
Podstawową filozofią zarządzanych konektorów jest szybkość wejścia na rynek. Dzięki abstrahowaniu od leżących u podstaw wywołań sieciowych, schematów API i protokołów transportowych dostawcy pozwalają deweloperom składać złożone procesy biznesowe w ciągu godzin zamiast tygodni. Ta abstrakcja ma jednak wysoką cenę architektoniczną.
Każdy zarządzany konektor działa jak aktywny pośrednik, znajdujący się dokładnie między rozproszonymi mikrousługami. Gdy zostaje zainicjowane żądanie, dane są przechwytywane, ponownie pakowane, serializowane, kierowane przez współdzieloną wielodzierżawczą infrastrukturę, poddawane regułom ograniczania przepustowości bramy, oceniane przez warstwy egzekwowania zasad, a na koniec tłumaczone, zanim w ogóle dotrą do docelowego celu. To ciągłe przechwytywanie wprowadza ukryte zależności architektoniczne. Twój system nie komunikuje się już bezpośrednio z usługą docelową; komunikuje się przez pośrednika typu czarna skrzynka, którego wewnętrzna pojemność, przydział zasobów i kondycja operacyjna pozostają całkowicie poza twoją kontrolą operacyjną.
Co więcej, ten model współdzielonej infrastruktury z natury wprowadza nieprzewidywalne tarcia w warstwie pośredniczącej. Ponieważ konektory często działają na wielodzierżawczej infrastrukturze zarządzanej przez podmioty trzecie, krytyczne korporacyjne ładunki danych rywalizują o cykle procesora, przydziały pamięci i przepustowość sieci z tysiącami innych dzierżaw. Gdy globalnie pojawiają się skoki ruchu, twoje lokalne przepływy pracy stają się podatne na szum sąsiadów i nagłe egzekwowanie ograniczeń. Projektowanie zorientowane na wygodę konsekwentnie poświęca strukturalną odporność, zastępując deterministyczne zachowanie sieci probabilistyczną orkiestracją typu czarna skrzynka.
Podatek od opóźnień i ukryte koszty architektoniczne
Architekci często wpadają w pułapkę postrzegania konektorów jako przezroczystych rur, neutralnych kanałów, które po prostu przekazują dane z punktu A do punktu B. W rzeczywistości konektory to wymagające obliczeniowo warstwy integracyjne, które nakładają wysoki, narastający narzut wydajnościowy na cały twój stos technologiczny.
Rozważmy mechanizm tradycyjnej architektury odpytywania REST. Aby sprawdzić aktualizacje lub zmiany danych, zarządzany konektor musi nieustannie wysyłać powtarzalne cykle żądanie–odpowiedź. Jeśli system odpytuje co kilka sekund w setkach współbieżnych przepływów pracy, marnotrawstwo infrastruktury jest ogromne. Miliony żądań HTTP zwracają puste ładunki, zużywając olbrzymie ilości cykli procesora na parsowanie, nawiązywanie połączeń i narzut nagłówków.
Dochodzimy w ten sposób do dużego kosztu powtarzalnej serializacji JSON. Ładunki tekstowe, takie jak JSON, są niezwykle czytelne dla człowieka, ale bardzo nieefektywne w komunikacji maszyna–maszyna. Za każdym razem, gdy łącznik przetwarza ładunek, musi on po stronie wysyłającej serializować złożone struktury danych do objętościowych ciągów znaków, przesłać te rozdęte ładunki przez sieć, a następnie po stronie odbierającej sparsować te ciągi z powrotem do pamięci. Wraz ze wzrostem złożoności rozproszonych przepływów pracy to opóźnienie narasta wykładniczo.
Jeszcze gorsze jest kaskadowe działanie ograniczania liczby żądań i błędów 429 (throttling). Gdy zewnętrzne API wykryje napływ żądań z zarządzanego łącznika, odpowiada kodami throttlingu. Standardowe platformy integracyjne reagują na te sygnały automatycznymi ponowieniami. Przy dużym ruchu te ponowienia szybko się mnożą i przeradzają się w niszczycielskie lawiny ponowień, które skutecznie uruchamiają lokalny atak typu DDoS (Distributed Denial of Service) na własne systemy wewnętrzne. Przepływy pracy, które działają bez zarzutu w środowiskach testowych przy niewielkiej liczbie żądań deweloperskich, nieuchronnie załamują się pod bezlitosnym obciążeniem równoczesności w rzeczywistych środowiskach przedsiębiorstw.
Od REST do formatu binarnego: dlaczego gRPC zmienia oblicze integracji w przedsiębiorstwach
Jeśli protokoły tekstowe i zarządzane opakowania REST napotykają ścianę wydajności, jaka jest alternatywa? Nowa generacja wysokoprzepustowych architektur przedsiębiorstw zdecydowanie odchodzi od rozwlekłej komunikacji tekstowej na rzecz zoptymalizowanych dla maszyn binarnych stosów transportowych.
Tutaj do głosu dochodzą gRPC i Protocol Buffers (Protobuf), które fundamentalnie zmieniają podejście do systemów rozproszonych. Zamiast polegać na przerośniętych ładunkach JSON i powtarzalnych, bardzo gadatliwych żądaniach HTTP, gRPC wykorzystuje zwarte komunikaty binarne, zoptymalizowane wprost pod wysokowydajną komunikację maszynową. Serializacja binarna upycha struktury danych w bajtach w sposób bardzo zwarty, drastycznie zmniejszając rozmiar ładunków — często o rząd wielkości w porównaniu z ich odpowiednikami w JSON.
Mniejszy rozmiar ładunku przekłada się bezpośrednio na niższe obciążenie procesora. Parsowanie binarnych danych Protobuf wymaga minimalnego wysiłku obliczeniowego w porównaniu z analizą rozbudowanych dokumentów tekstowych. Co więcej, gRPC działa natywnie nad protokołem HTTP/2, umożliwiając multipleksowane strumienie w ramach jednego połączenia TCP, co drastycznie skraca opóźnienie nawiązywania połączenia i eliminuje zbędne przeskoki w sieci.
Kolejną istotną zaletą przejścia na architekturę natywną dla protokołu jest komunikacja oparta na schemacie (schema-first). Tradycyjne integracje REST często cierpią na dryf interfejsu, gdy nieudokumentowane zmiany pól lub brakujące parametry psują zależne przepływy pracy w czasie wykonywania. gRPC wymusza silnie typowane kontrakty oparte na skompilowanych definicjach Protobuf. Klient i serwer uzgadniają dokładny kształt danych jeszcze przed wdrożeniem, co eliminuje całe klasy błędów integracyjnych i zapewnia pełną zgodność kontraktu w granicach rozproszonych przedsiębiorstw.
Pożegnanie z odpytywaniem: trwałe strumienie i transmisja w czasie rzeczywistym
Tradycyjne zarządzane łączniki są zasadniczo oparte na przestarzałym założeniu architektonicznym: że praca w przedsiębiorstwie zawsze zaczyna się od odrębnego, reaktywnego żądania. Jednak w nowoczesnym krajobrazie sztucznej inteligencji działającej w czasie rzeczywistym i automatyzacji sterowanej zdarzeniami oczekiwanie, aż systemy odpytają o aktualizacje, wprowadza nieakceptowalne opóźnienia i marnuje przepustowość.
Odejście architektury od odpytywania na rzecz trwałych protokołów strumieniowych nie jest już opcjonalne dla systemów o dużej skali. Technologie wykorzystujące WebSockets, HTTP/3, QUIC i WebTransport pozwalają systemom utrzymywać trwałe, dwukierunkowe kanały komunikacji, w których dane są wypychane natychmiast, w chwili wystąpienia zdarzenia.
Odpytywanie generuje ogromne ilości pustego ruchu, który zapycha interfejsy sieciowe i wyczerpuje zasoby obliczeniowe. Modele trwałego strumieniowania natomiast utrzymują otwarte połączenie, w którym kontekst przepływa w sposób ciągły, z minimalnym narzutem protokołu. Co więcej, nowoczesne protokoły transportowe, takie jak QUIC, eliminują główne wąskie gardła sieciowe, na przykład blokowanie czoła kolejki (Head-of-Line blocking), zapewniając, że utrata pakietu w jednym strumieniu nie wstrzymuje niezwiązanych z nim transmisji danych.
Dzięki przejściu na trwałe, sterowane zdarzeniami transporty organizacje mogą osiągnąć dostarczanie zdarzeń w czasie poniżej 100 milisekund na skalę globalną. Ta możliwość jest szczególnie istotna w obsłudze nowoczesnych, rozproszonych zespołów oraz agentów AI działających w czasie rzeczywistym, którzy wymagają natychmiastowego przekazywania kontekstu bez czekania na okresowe odpytywanie w celu synchronizacji stanu.
Budowanie odporności: kolejki asynchroniczne i architektury odporne na awarie
Szybkie systemy zbudowane bez solidnej tolerancji na awarie nieuchronnie stają się szybkimi generatorami awarii. Jedną z najbardziej niebezpiecznych wad projektowych w synchronicznych, opartych na łącznikach łańcuchach integracji jest ślepe założenie, że każda zależna usługa, baza danych i zewnętrzne API SaaS będą stale dostępne.
W rzeczywistych środowiskach przedsiębiorstw systemy rozproszone stale doświadczają częściowych awarii, przejściowych podziałów sieci, planowych prac konserwacyjnych baz danych oraz nagłych przeciążeń ruchu. Gdy przepływy integracyjne są ściśle powiązane w łańcuchu synchronicznym, chwilowe spowolnienie jednej pomocniczej usługi powoduje wsteczne ciśnienie, które kaskadowo rozchodzi się w górę i paraliżuje kluczowe aplikacje biznesowe.
Wzorce asynchronicznej odporności eliminują tę podatność, oddzielając szybkość przyjmowania danych od szybkości ich przetwarzania. Wprowadzając trwałe kolejki komunikatów i brokery zdarzeń, takie jak Azure Service Bus, RabbitMQ czy Amazon SQS, pomiędzy granicami usług, tworzysz solidny bufor chroniący przed zmiennością.
Gdy nagły wzrost ruchu trafia do warstwy integracji, przychodzące zdarzenia są bezpiecznie przyjmowane i przechowywane w trwałym magazynie, zamiast wymuszać natychmiastowe, synchroniczne przetwarzanie przez niestabilne zależności po stronie usług docelowych. Konsumenci po stronie odbiorczej pobierają komunikaty z kolejki w stałym, kontrolowanym tempie. Jeśli usługa zaplecza zostanie wyłączona na czas konserwacji, kolejka bezpiecznie przechowuje dane do momentu przywrócenia działania, zapobiegając utracie danych, eliminując katastrofalne kaskadowe awarie i zapewniając, że architektura przedsiębiorstwa pozostaje odporna w warunkach skrajnego obciążenia.
Zmiana środowiska wykonawczego: odzyskanie suwerenności dzięki wbudowanym łącznikom
Poza protokołami sieciowymi i strategiami kolejkowania architekci przedsiębiorstw muszą dokładnie przeanalizować fizyczne środowisko wykonawcze swoich warstw integracji. Jednym z najczęściej źle rozumianych aspektów automatyzacji w chmurze jest to, gdzie faktycznie wykonywane są zarządzane łączniki.
Wiele organizacji zakłada, że skoro ich logika integracji jest hostowana w ich subskrypcji chmurowej przedsiębiorstwa, na przykład w usłudze Azure Logic Apps, całe przetwarzanie danych pozostaje bezpiecznie odizolowane w zaufanych granicach sieci. Tymczasem wiele tradycyjnych zarządzanych łączników działa jako zewnętrzne integracje SaaS, uruchamiane na współdzielonej infrastrukturze wielodzierżawczej, całkowicie poza Twoją siecią wirtualną (VNet).
Ta architektoniczna rzeczywistość stwarza poważne luki w zakresie bezpieczeństwa i zgodności z modelem zero trust. Gdy wrażliwe dane korporacyjne opuszczają Twoją prywatną sieć, aby zostać przetworzone przez zewnętrzne zarządzane oprogramowanie pośredniczące, tracisz bezpośrednią kontrolę na warstwie transportowej. Aby wypełnić tę lukę, organizacje często polegają na lokalnych bramach danych (On-Premises Data Gateway), które nierzadko stają się ogromnymi wąskimi gardłami przedsiębiorstwa i pojedynczymi punktami awarii.
Rozwiązanie leży w strategicznej zmianie środowiska wykonawczego na rzecz wbudowanych łączników i izolowanych modeli wykonania, takich jak Azure Logic Apps Standard działający na dedykowanych środowiskach App Service lub środowiskach uruchomieniowych w kontenerach. Wbudowane łączniki działają bezpośrednio w Twoim własnym środowisku obliczeniowym i w granicach Twojej sieci VNet. Eliminuje to zewnętrzne przeskoki SaaS, znacząco ogranicza opóźnienia, spełnia rygorystyczne wymogi zgodności z modelem zero trust i przywraca pełną suwerenność architektoniczną nad potokami danych przedsiębiorstwa.
Podsumowanie: projektowanie skalowalnej odporności w erze AI
Era traktowania integracji jako dodatku low-code dobiegła oficjalnie końca. Gdy przedsiębiorstwa ścigają się we wdrażaniu zaawansowanych modeli AI, autonomicznych agentów i potoków danych czasu rzeczywistego, kruche modele transportowe leżące u podstaw tradycyjnych zarządzanych łączników pękają pod presją. Tarcia w oprogramowaniu pośredniczącym, ukryte koszty opóźnień, wąskie gardła ograniczania przepustowości oraz niebezpieczne współdzielone środowiska wykonawcze nie są już drobnymi niedogodnościami – są krytycznymi zagrożeniami biznesowymi, które podważają stabilność systemów i wstrzymują cyfrowe innowacje.
Budowanie przyszłości wymaga fundamentalnej zmiany sposobu myślenia. Musimy odejść od rozmownego odpytywania REST, obszernych ładunków JSON i nieprzejrzystego, zarządzanego oprogramowania pośredniczącego, a zamiast tego postawić na inżynierię opartą na protokołach: serializację binarną z gRPC, trwałe strumieniowanie w czasie rzeczywistym, asynchroniczną odporność opartą na kolejkach oraz ścisłą suwerenność w czasie wykonania.
Aby zgłębić te zmiany architektoniczne, poznać praktyczne wzorce projektowe i dowiedzieć się, jak uodpornić strategię integracji na wymagania nowoczesnej sztucznej inteligencji, koniecznie posłuchaj towarzyszącego odcinka podcastu: Custom Connectors vs Model Context Protocol for Enterprise AI. Odzyskanie kontroli nad warstwą transportową przedsiębiorstwa to absolutnie najważniejszy krok, jaki możesz podjąć, aby budować naprawdę odporne i skalowalne systemy automatyzacji.