 FR
 English
 Deutsch
 Español
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Le coût caché de la facilité : pourquoi les connecteurs managés échouent face à l’IA en entreprise
By Mirko Peters ·
Depuis des années, les organisations adoptent les outils d’intégration low-code, les moteurs d’automatisation et les connecteurs managés comme étalon absolu de la transformation numérique…
Automatically translated with AI from the original post. Read the English original
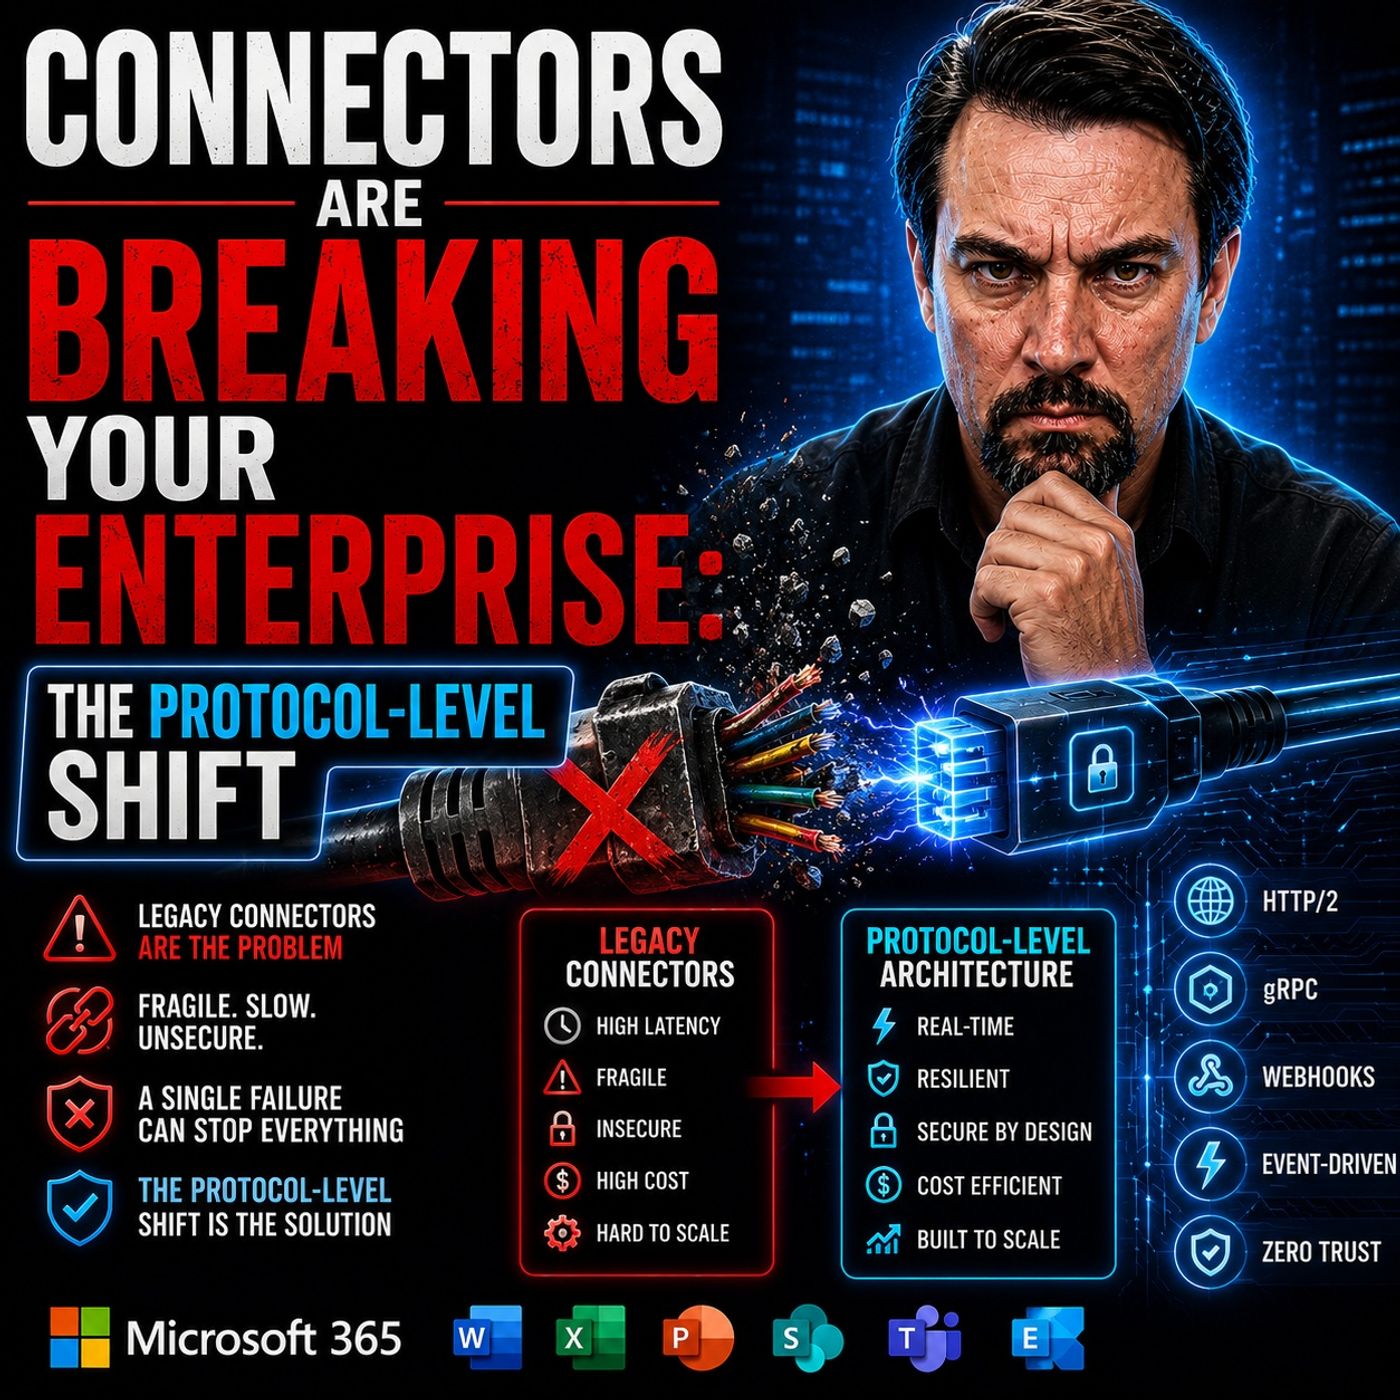
Depuis des années, les organisations adoptent les outils d’intégration low-code, les moteurs d’automatisation et les connecteurs managés comme l’étalon absolu de la transformation numérique. Ils incarnent le « bouton facile » de l’architecture moderne. Vous devez connecter Salesforce à Azure ? Ajoutez un connecteur managé. Vous voulez ingérer de la télémétrie dans votre data lake ou acheminer des notifications vers vos canaux de communication d’entreprise ? Déployez un wrapper low-code, configurez quelques jetons d’authentification et regardez les données circuler. Ces modules préconçus promettent un déploiement rapide, moins de frictions et un besoin minimal de supervision technique approfondie.
Pourtant, derrière ce vernis de facilité opérationnelle se cache un modèle de transport fragile et très vulnérable. L’architecture d’entreprise moderne, en particulier la croissance explosive de l’intelligence artificielle, des workflows agentiques en temps réel et du trafic machine à machine à forte concurrence, révèle les limites structurelles profondes des plateformes d’intégration managées traditionnelles. Lorsque des workflows échouent sous une forte concurrence, que la latence grimpe de façon imprévisible ou que des applications entraînent des pannes généralisées, les équipes de développement incriminent souvent la logique applicative ou l’instabilité des modèles. Or, dans la plupart des cas, la cause profonde se trouve plus en profondeur dans le système : la couche de transport elle-même.
Pour comprendre réellement pourquoi l’automatisation d’entreprise se bloque sous charge, il faut lever les couches d’abstraction fournies par les connecteurs historiques et examiner les pénalités architecturales que nous payons pour gagner en facilité. Alors que nous entrons dans une ère dominée par des charges de travail IA à haut débit, il est temps de réévaluer les coûts cachés des intergiciels managés et d’explorer les paradigmes d’ingénierie nécessaires pour bâtir des systèmes résilients et évolutifs.
Le piège de la facilité des connecteurs managés
La philosophie fondamentale des connecteurs managés est la rapidité de mise sur le marché. En masquant les appels réseau sous-jacents, les schémas d’API et les protocoles de transport, les éditeurs permettent aux développeurs d’assembler des processus métier complexes en quelques heures au lieu de quelques semaines. Pourtant, cette abstraction a un prix architectural élevé.
Chaque connecteur managé agit comme un intermédiaire actif, placé en plein milieu de vos microservices distribués. Lorsqu’une requête est lancée, vos données sont interceptées, réemballées, sérialisées, acheminées par une infrastructure multilocataire partagée, soumises aux règles de limitation de débit de la passerelle, évaluées par les couches d’application des stratégies, puis traduites avant même d’atteindre leur cible. Cette interception constante introduit des dépendances architecturales cachées. Votre système ne communique plus directement avec le service cible ; il communique par l’intermédiaire d’une boîte noire dont la capacité interne, l’allocation des ressources et l’état de santé opérationnel échappent entièrement à votre contrôle.
En outre, ce modèle d’infrastructure partagée introduit intrinsèquement des frictions imprévisibles au niveau de l’intergiciel. Ces connecteurs s’exécutant souvent sur une infrastructure multilocataire gérée par des tiers, vos charges utiles critiques se disputent les cycles CPU, les allocations de mémoire et la bande passante réseau avec des milliers d’autres locataires. Lorsque des pics de trafic surviennent à l’échelle mondiale, vos workflows localisés deviennent vulnérables aux interférences de voisinage et à l’application brutale de limitations de débit. La conception axée sur la facilité sacrifie systématiquement la résilience structurelle, en remplaçant un comportement réseau déterministe par une orchestration probabiliste en boîte noire.
Le coût de la latence et les coûts architecturaux cachés
Les architectes tombent fréquemment dans le piège qui consiste à considérer les connecteurs comme des tuyaux transparents, des conduits neutres qui se contentent de transporter les données du point A au point B. En réalité, les connecteurs sont des couches d’intégration gourmandes en calcul, qui imposent un lourd coût de performance, qui s’accumule, à l’ensemble de votre pile technologique.
Prenons l’exemple du fonctionnement d’une architecture traditionnelle d’interrogation REST. Pour détecter des mises à jour ou des modifications de données, un connecteur managé doit émettre en permanence des cycles requête-réponse répétitifs. Si un système interroge toutes les quelques secondes des centaines de workflows simultanés, le gaspillage d’infrastructure est considérable. Des millions de requêtes HTTP renvoient des charges utiles vides, consommant d’énormes quantités de cycles CPU pour l’analyse, les négociations de connexion et la surcharge des en-têtes.
Cela nous amène au coût élevé de la sérialisation JSON répétitive. Les charges utiles au format texte, comme JSON, sont remarquablement lisibles pour un humain, mais elles sont terriblement inefficaces pour la communication de machine à machine. À chaque traitement d'une charge utile, un connecteur doit sérialiser des structures de données complexes dans des formats de chaîne volumineux côté émetteur, transmettre ces charges alourdies sur le réseau, puis désérialiser ces chaînes en mémoire côté récepteur. À mesure que les workflows distribués gagnent en complexité, cette latence s'accumule de manière exponentielle.
Plus grave encore est l'effet en cascade des erreurs 429 de limitation de débit et de throttling. Lorsqu'une API en aval détecte un afflux de requêtes provenant d'un connecteur géré, elle répond par des codes de throttling. Les plateformes d'intégration standard réagissent à ces signaux en déclenchant des nouvelles tentatives automatiques. En cas de trafic intense, ces nouvelles tentatives se multiplient rapidement et se transforment en tempêtes de relances destructrices, qui lancent en pratique une attaque par déni de service distribué (DDoS) localisée contre vos propres systèmes internes. Les workflows qui fonctionnent sans faille dans les environnements de préproduction, sous une charge réduite de tests par les développeurs, finissent invariablement par s'effondrer sous le poids implacable de la simultanéité d'un environnement d'entreprise réel.
De REST au binaire : pourquoi gRPC redéfinit l'intégration en entreprise
Si les protocoles textuels et les enveloppes REST gérées atteignent un mur de performance, quelle est l'alternative ? La prochaine génération d'architectures d'entreprise à haut débit s'éloigne résolument des communications textuelles verbeuses pour se tourner vers des piles de transport binaires optimisées pour les machines.
C'est là que gRPC et Protocol Buffers (Protobuf) changent fondamentalement la donne des systèmes distribués. Au lieu de s'appuyer sur des charges utiles JSON surdimensionnées et sur des requêtes HTTP répétitives et très bavardes, gRPC utilise des messages binaires compacts, optimisés explicitement pour la communication machine à haute performance. La sérialisation binaire compacte les structures de données en octets, ce qui réduit considérablement la taille des charges utiles, souvent d'un ordre de grandeur par rapport à leurs équivalents JSON.
La réduction de la taille des charges utiles se traduit directement par une baisse de la charge CPU. L'analyse de données binaires Protobuf demande un effort de calcul minimal, comparé à celle de documents texte volumineux. De plus, gRPC fonctionne nativement sur HTTP/2, ce qui permet des flux multiplexés sur une seule connexion TCP, réduisant fortement la latence d'établissement de connexion et supprimant les sauts réseau inutiles.
Un autre avantage majeur de l'adoption d'une architecture native de protocole réside dans la communication orientée schéma. Les intégrations REST traditionnelles souffrent souvent d'une dérive d'interface, où des modifications de champs non documentées ou des paramètres manquants provoquent des pannes des workflows dépendants à l'exécution. gRPC impose des contrats fortement typés, définis par des fichiers Protobuf compilés. Le client et le serveur s'accordent sur la structure exacte des données avant le déploiement, ce qui élimine des familles entières de bogues d'intégration et garantit une fidélité absolue des contrats au-delà des frontières des systèmes distribués de l'entreprise.
Dire adieu au polling : flux persistants et transport en temps réel
Les connecteurs gérés traditionnels reposent fondamentalement sur une hypothèse architecturale dépassée : le travail en entreprise commencerait toujours par une requête discrète et réactive. Pourtant, dans le paysage actuel de l'IA d'entreprise en temps réel et de l'automatisation instantanée pilotée par les événements, attendre que les systèmes interrogent en boucle les mises à jour introduit des délais inacceptables et gaspille la bande passante.
Le virage architectural qui s'éloigne du polling au profit de protocoles de streaming persistants n'est plus facultatif pour les systèmes à grande échelle. Les technologies reposant sur WebSockets, HTTP/3, QUIC et WebTransport permettent aux systèmes de maintenir des canaux de communication bidirectionnels persistants, où les données sont poussées instantanément dès qu'un événement se produit.
Le polling génère d'immenses volumes de trafic vide, qui saturent les interfaces réseau et épuisent les ressources de calcul. Les modèles de streaming persistant, en revanche, maintiennent une connexion ouverte dans laquelle le contexte circule en continu, avec un surcoût de protocole minimal. De plus, les protocoles de transport modernes comme QUIC éliminent des goulets d'étranglement réseau majeurs, tels que le blocage en tête de ligne (Head-of-Line blocking), garantissant qu'une perte de paquets sur un flux donné ne bloque pas la transmission de données sans rapport.
En adoptant des transports événementiels persistants, les organisations peuvent atteindre une diffusion des événements inférieure à 100 millisecondes à l’échelle mondiale. Cette capacité est particulièrement précieuse pour accompagner les effectifs distribués modernes et les agents d’IA en temps réel, qui ont besoin d’une propagation instantanée du contexte sans attendre des intervalles d’interrogation périodiques pour synchroniser l’état.
Bâtir la résilience : files d’attente asynchrones et architectures tolérantes aux pannes
Les systèmes rapides conçus sans une tolérance aux pannes robuste deviennent inévitablement des moteurs de défaillance rapides. L’une des failles de conception les plus dangereuses des chaînes d’intégration synchrones basées sur des connecteurs est la supposition aveugle que chaque service en aval, chaque base de données et chaque API SaaS tierce restera disponible en permanence.
Dans les environnements d’entreprise réels, les systèmes distribués subissent en permanence des pannes partielles, des partitions réseau transitoires, des opérations de maintenance sur les bases de données et des congestions soudaines du trafic. Lorsque les flux d’intégration sont fortement couplés dans une chaîne synchrone, un ralentissement temporaire d’un seul service périphérique génère une contre-pression qui se propage en amont et paralyse les applications métier critiques.
Les modèles de résilience asynchrone répondent à cette vulnérabilité en découplant la vitesse d’ingestion de la vitesse de traitement. En introduisant des files de messages durables et des courtiers d’événements, comme Azure Service Bus, RabbitMQ ou Amazon SQS, entre les frontières de vos services, vous créez une mémoire tampon robuste face à la volatilité.
Lorsqu’un pic de trafic frappe votre couche d’intégration, les événements entrants sont ingérés en toute sécurité et conservés dans un stockage durable, plutôt que de forcer un traitement synchrone immédiat à travers des dépendances en aval instables. Les consommateurs en aval extraient les messages de la file à un rythme soutenable et contrôlé. Si un service back-end est hors ligne pour maintenance, la file conserve les données en lieu sûr jusqu’à la reprise, ce qui évite toute perte de données, supprime les défaillances en cascade catastrophiques et garantit que votre architecture d’entreprise reste résiliente face à des contraintes extrêmes.
Le pivot du runtime : reprendre la souveraineté grâce aux connecteurs intégrés
Au-delà des protocoles réseau et des stratégies de mise en file d’attente, les architectes d’entreprise doivent examiner de près le runtime d’exécution physique de leurs couches d’intégration. L’un des aspects les plus mal compris de l’automatisation cloud est l’endroit où les connecteurs managés s’exécutent réellement.
Beaucoup d’organisations supposent que, parce que leur logique d’intégration est hébergée dans leur abonnement cloud d’entreprise, par exemple dans Azure Logic Apps, tout le traitement des données reste isolé en toute sécurité au sein de leurs frontières réseau de confiance. Pourtant, de nombreux connecteurs managés traditionnels fonctionnent comme des intégrations SaaS externes, sur une infrastructure multilocataire partagée, entièrement en dehors de votre réseau virtuel (VNet).
Cette réalité architecturale crée de graves vulnérabilités en matière de sécurité et de conformité zero trust. Lorsque vos données d’entreprise sensibles quittent votre périmètre réseau privé pour être traitées par un intergiciel managé tiers, vous renoncez au contrôle direct de la couche transport. Pour combler cette lacune, les organisations recourent souvent aux passerelles de données locales (On-Premises Data Gateway), qui deviennent fréquemment d’énormes goulots d’étranglement et des points de défaillance uniques.
La solution réside dans un pivot stratégique du runtime vers des connecteurs intégrés et des modèles d’exécution isolés, comme Azure Logic Apps Standard exécuté sur des environnements App Service dédiés ou sur des runtimes conteneurisés. Les connecteurs intégrés s’exécutent directement dans votre propre runtime de calcul et dans les frontières de votre VNet. Cela supprime les sauts SaaS externes, réduit drastiquement la latence, répond aux exigences strictes de conformité zero trust et restaure une souveraineté architecturale totale sur vos chaînes de traitement de données d’entreprise.
Conclusion : concevoir pour une montée en charge résiliente à l’ère de l’IA
L’époque où l’intégration était traitée comme une réflexion secondaire en low-code est officiellement révolue. Alors que les entreprises se précipitent pour déployer des modèles d’IA sophistiqués, des agents autonomes et des pipelines de données en temps réel, les modèles de transport fragiles qui sous-tendent les connecteurs managés traditionnels cèdent sous la pression. La friction des intergiciels, les coûts cachés de latence, les goulots d’étranglement liés à la limitation de débit et les runtimes partagés non sécurisés ne sont plus de simples désagréments mineurs : ce sont des risques métier critiques qui compromettent la stabilité des systèmes et freinent l’innovation numérique.
Construire pour l’avenir exige un véritable changement de mentalité. Il faut s’éloigner des interrogations REST bavardes, des charges utiles JSON volumineuses et des intergiciels managés en boîte noire, pour privilégier à la place une ingénierie native des protocoles : sérialisation binaire avec gRPC, diffusion en continu persistante en temps réel, résilience asynchrone adossée à des files d’attente et souveraineté stricte de l’environnement d’exécution.
Pour approfondir ces évolutions architecturales, explorer des modèles de conception concrets et apprendre à pérenniser votre stratégie d’intégration face aux exigences de l’intelligence artificielle moderne, écoutez sans faute l’épisode de podcast associé : Custom Connectors vs Model Context Protocol for Enterprise AI. Reprendre le contrôle de votre couche de transport d’entreprise est l’étape la plus importante pour concevoir des systèmes d’automatisation véritablement résilients et évolutifs.