 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Waarom Copilot faalt: hallucinaties en privacyfouten in de onderneming ontrafeld
By Mirko Peters ·
Wanneer je achter je werkplek gaat zitten en een AI-assistent zoals Microsoft Copilot opent, doe je dat met een duidelijke verwachting: je wilt je werkproces versnellen, …
Automatically translated with AI from the original post. Read the English original
Dit zijn geen kleine softwarefouten of tijdelijke kinderziekten; het zijn fundamentele kwetsbaarheden die ingebakken zitten in het ontwerp van enorme algemene taalmodellen. Terwijl organisaties zich haasten om generatieve AI in te voeren, lopen IT-leiders, ontwikkelaars en security officers tegen een muur aan. Ze ontdekken dat groter niet altijd beter is. De pure omvang van traditionele LLM's zorgt vaak voor een onbeheersbaar aanvalsoppervlak qua beveiligingsrisico's, compliance-overtredingen en operationele overhead. Om goed te begrijpen waarom deze systemen in omgevingen waar veel op het spel staat stukgaan, moeten we de kern van de beveiligings- en nauwkeurigheidsproblemen van massieve assistenten zoals Copilot ontleden, en, belangrijker nog, de architecturale tegenbeweging onderzoeken die die problemen van de grond af aan oplost.
Dit zijn geen kleine softwarefouten of tijdelijke kinderziektes. Het gaat om fundamentele kwetsbaarheden die zijn ingebakken in het kernontwerp van enorme general-purpose taalmodellen. Terwijl organisaties zich haasten om generatieve AI in te zetten, lopen IT-leiders, ontwikkelaars en beveiligingsverantwoordelijken tegen een muur aan. Ze ontdekken dat groter niet altijd beter is. De enorme schaal van traditionele LLM's zorgt er juist vaak voor dat het aanvalsoppervlak voor beveiligingsrisico's, compliance-overtredingen en operationele lasten onbeheersbaar wordt. Om goed te begrijpen waarom deze systemen in bedrijfskritische omgevingen vastlopen, moeten we de kernfouten op het gebied van beveiliging en nauwkeurigheid onder de loep nemen die inherent zijn aan grote assistenten zoals Copilot. Belangrijker nog: we moeten de architectonische tegenbeweging verkennen die deze problemen van de grond af aan oplost.
Als je dieper wilt duiken in hoe moderne architectuur deze hindernissen overwint, bekijk dan zeker de bijbehorende Small Language Models for Faster, Cheaper Enterprise AI-aflevering. Daarin krijg je een praktische kijk op hoe deze systemen werken in echte Microsoft-omgevingen.
De belangrijkste zwakte uitgelegd
Uitleg van de belangrijkste zwakte
Je verwacht dat Copilot je helpt sneller en slimmer te werken, maar het worstelt vaak met nauwkeurigheid en privacy. Copilot gebruikt grote taalmodellen om antwoorden te genereren, maar deze modellen geven soms informatie verkeerd weer of verzinnen details. Je ziet dan antwoorden die overtuigend klinken, maar in werkelijkheid onvolledig of zelfs onjuist zijn. Dat komt doordat de modellen niet altijd de context of de gegevens die ze gebruiken goed begrijpen. Je moet feiten dubbelchecken en bronvermeldingen controleren, wat je vertraagt.
Privacy is een ander groot aandachtspunt. Copilot maakt verbinding met je bedrijfsgegevens en gebruikt jouw machtigingen om toegang te krijgen tot informatie. Als jij of je team te veel machtigingen hebben, kan Copilot gevoelige gegevens zonder waarschuwing ophalen. Iemand met brede toegang kan Copilot bijvoorbeeld vragen naar vertrouwelijke details zoals salarissen of beoordelingsgesprekken. Aanvallers die toegang krijgen tot deze accounts, kunnen ernstige datalekken veroorzaken. De modellen erven niet altijd vertrouwelijkheidslabels, waardoor gevoelige informatie gedeeld kan worden zonder de juiste classificatie.
Hieronder staat een tabel met enkele van de meest voorkomende beveiligingsproblemen in Copilot:
| Beschrijving | EchoLeak-kwetsbaarheid |
|---|---|
| Een zero-click-aanval die Copilot misbruikt om gevoelige gegevens uit verbonden M365-bronnen op te halen. | Een zero-click-aanval waarbij Copilot wordt misbruikt om gevoelige gegevens op te halen uit verbonden M365-bronnen. |
| Kwaadaardige instructies verborgen in content kunnen Copilot manipuleren om gegevens op te halen en te delen. | Verkeerde configuratie van agents in Copilot |
| Verkeerd geconfigureerde agents kunnen gegevens blootstellen, draaien met te veel bevoegdheden of inloggegevens opslaan. | Te ruime toegang tot gegevens |
| Copilot kan alles openen wat een gebruiker kan openen, met het risico dat gevoelige bedrijfsgegevens te veel worden gedeeld. | Copilot kan alles openen wat een gebruiker kan openen, waardoor gevoelige bedrijfsgegevens gemakkelijk te ruim worden gedeeld (oversharing). |
| Problemen met overerving van beveiligingslabels | Outputs van Copilot erven mogelijk geen beveiligingslabels, waardoor gegevens zonder classificatie en onjuist gedeeld kunnen worden. |
Impact op ontwikkelaars en teams
Wanneer je Copilot gebruikt, wil je betrouwbare hulp. In de praktijk moet je de output vaak nakijken en corrigeren. Dat extra werk kan je projecten vertragen. Ontwikkelaars kunnen het vertrouwen in de modellen verliezen als ze te veel fouten of privacyrisico's zien. Teams moeten meer tijd besteden aan het controleren op fouten en aan het bewaken dat gevoelige gegevens niet lekken. Daarnaast moet je je team mogelijk trainen om deze problemen te herkennen en op te lossen, en dat kost tijd en middelen.
Modellen kunnen slechte gegevensbeveiligingspraktijken versterken. Als je organisatie machtigingen niet zorgvuldig beheert, kan Copilot het probleem erger maken door meer gegevens bloot te stellen dan je verwacht. Je moet strikte toegangsbeheersing instellen en monitoren hoe de modellen omgaan met je zakelijke gegevens.
Gevolgen in de praktijk
Je ziet de effecten van deze tekortkomingen ook in echte situaties. Het Amerikaanse Congres heeft zijn medewerkers verboden Copilot te gebruiken uit angst voor datalekken. Leidinggevenden maakten zich zorgen dat gevoelige overheidsgegevens zouden kunnen lekken naar niet-geautoriseerde cloudservices. In een ander geval ontdekten onderzoekers een manier om via prompt injection en tool-exploits persoonsgegevens te stelen via Copilot. Deze incidenten laten zien dat de risico's niet louter theoretisch zijn.
Als je vertrouwt op modellen die je gegevens niet beschermen of geen nauwkeurige antwoorden geven, loop je echte zakelijke risico's. Gevoelige informatie kan lekken en je team kan tijd verliezen aan het herstellen van fouten. Je hebt modellen nodig die zowel nauwkeurigheid als privacy bieden, zodat je werk veilig en efficiënt blijft.
De SLM-revolutie in AI
Wat zijn small language models?
Misschien heb je over de SLM-revolutie gehoord, maar wat betekent dat voor jou? Small language models zijn een nieuw type AI dat zich richt op efficiëntie en nauwkeurigheid. Deze modellen gebruiken minder resources dan traditionele systemen. Je kunt ze draaien op gewone computers of zelfs op je eigen servers. Dat maakt ze eenvoudig in te zetten op de werkplek. Small language models helpen je taken uit te voeren, zoals het samenvatten van e-mails, het halen van kernpunten uit vergaderingen en het classificeren van documenten. Je krijgt snelle antwoorden zonder te wachten op cloudservers. De SLM-revolutie geeft je meer controle over je gegevens en je werkproces.
SLM's versus large language models
Je vraagt je misschien af hoe small language models zich verhouden tot large language models. Het belangrijkste verschil zit in omvang en focus. Large language models hebben dure hardware nodig en draaien vaak in de cloud. Small language models werken op lokale machines en verbruiken minder energie. Je ziet de verschillen in onderstaande tabel:
| Kenmerk | Small Language Models (SLM's) | Large Language Models (LLM's) |
|---|---|---|
| Efficiëntie | Trainen en draaien op standaardhardware | Vereist dure cloud-GPU's |
| Implementatie | On-premises voor extra privacy | Vaak cloudgebaseerd |
| Kosteneffectiviteit | Lagere operationele kosten | Hogere operationele kosten |
| Prestaties | Snelle inferentie met een kleine voetafdruk | Trager vanwege de grotere omvang |
| Vermindering van hallucinaties | Fijn afgestemd op specifieke datasets voor betrouwbare outputs | Vatbaarder voor hallucinaties |
| Gebruiksscenario's | Toegespitst op specifieke taken in de SDLC | Algemene toepassingen |
| Beveiliging | Houdt gevoelige gegevens binnen de organisatie | Gegevens kunnen extern worden blootgesteld |
Je ziet dat SLM's snelheid, privacy en kostenbesparing bieden. Je hoeft niet te vertrouwen op externe servers. Je houdt je gevoelige informatie veilig.
Waarom de SLM-revolutie ertoe doet
De SLM-revolutie verandert hoe je AI op het werk gebruikt. Je kunt nu modellen inzetten die bij je behoeften passen en je gegevens beschermen. Veel organisaties kiezen voor SLM's omdat ze de naleving van regels zoals HIPAA en de AVG ondersteunen. Je kunt informatie lokaal verwerken en voorkomen dat gegevens naar de cloud worden gestuurd. Dit helpt je aan strenge beveiligingseisen te voldoen. De SLM-revolutie verhoogt ook de productiviteit. Je krijgt antwoorden in realtime en kunt de naleving monitoren terwijl je werkt. Je hoeft je geen zorgen te maken over trage reacties of hoge kosten. De SLM-revolutie geeft je controle over je AI-tools en je bedrijfsgegevens.
Opmerking: De SLM-revolutie gaat niet alleen over technologie. Het gaat erom dat je AI veilig, snel en efficiënt kunt gebruiken.
Hoe small language models de fout van Copilot’s oplossen
Hallucinaties verminderen
Je wilt dat je AI-tools betrouwbare antwoorden geven. Small language models helpen je dit doel te bereiken. Deze modellen richten zich op nauwkeurigheid en context. Ze gebruiken gerichte trainingsdata en optimalisatietechnieken om hallucinaties te verminderen. Je ziet minder verzonnen pakketten en betrouwbaardere codesuggesties. Wanneer je modellen zoals de Phi Family van Microsoft gebruikt, krijg je codegeneratie waarbij beveiliging voorop staat. Dat betekent dat je code schoon en veilig blijft.
Small language models excelleren in realtime toepassingen. Je kunt ze gebruiken voor intelligente refactoring en geautomatiseerde analyse van vereisten. Ze helpen je om je code te optimaliseren en fouten te voorkomen. Je merkt prestatieverbeteringen omdat de modellen effectieve en snelle resultaten leveren. Je besteedt minder tijd aan het corrigeren van fouten en meer tijd aan het bouwen van oplossingen.
Privacy en controle over gegevens versterken
Je hecht waarde aan beveiliging en privacy. Small language models geven je controle over je gegevens. Je kunt deze modellen uitrollen op je eigen apparaten of servers. Deze on-device-mogelijkheid houdt gevoelige informatie binnen je organisatie. Je hoeft geen gegevens naar externe cloudservices te sturen. Zo bescherm je je bedrijf en voldoe je aan compliance-normen.
Met small language models beheer je machtigingen en toegang. Je bepaalt wie de modellen mag gebruiken en welke gegevens ze mogen zien. Deze aanpak ondersteunt proactieve loganalyse en geautomatiseerde incidentrespons. Je houdt activiteiten in de gaten en reageert snel op dreigingen. Je houdt je applicaties veilig en je gegevens privé.
Small language models ondersteunen optimalisatie voor beveiliging. Je kunt ze gebruiken voor prestatiebewaking in realtime. Ze helpen je documenten te classificeren en actiepunten te extraheren zonder vertrouwelijke informatie bloot te geven. Je hebt gemoedsrust, want je weet dat je gegevens veilig blijven.
Lagere kosten en minder resourcebehoefte
Je wilt je budget en resources optimaliseren. Small language models bieden hoge efficiëntie en lage latentie. Je kunt ze draaien op standaardhardware. Je hebt geen dure cloud-GPU’s of grote infrastructuur nodig. Dit verlaagt je operationele kosten en maakt AI toegankelijk voor meer teams.
Bekijk de onderstaande kostenvergelijkingstabel. Je ziet hoe small language models zoals Phi-3 Mini geld besparen ten opzichte van grote modellen:
| Model | Invoerkosten ($/M tokens) | Uitvoerkosten ($/M tokens) |
|---|---|---|
| GPT-5.5 | $5.00 | $15.00 |
| Claude Sonnet 4.6 | $3.00 | $15.00 |
| Gemini 3.1 Pro | $3.50 | $10.50 |
| Mistral 7B (via API) | $0.20 | $0.20 |
| Llama 3.1 8B (via API) | $0.18 | $0.18 |
| Phi-3 Mini (zelf gehost) | Alleen hardwarekosten | Alleen hardwarekosten |
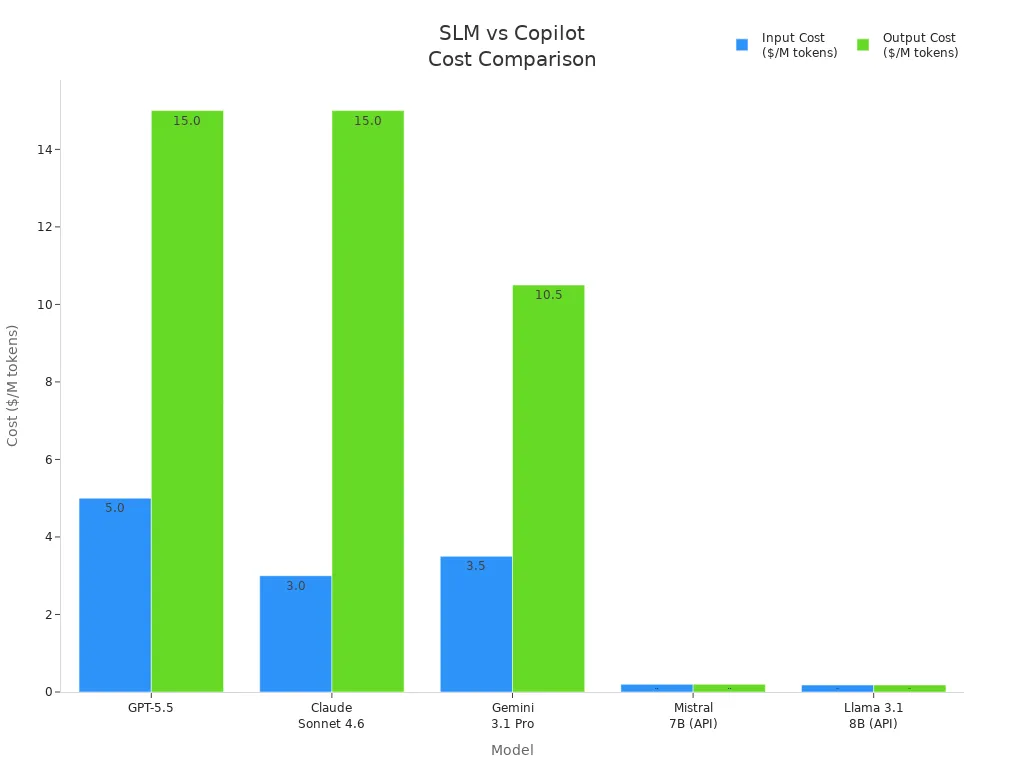
Je ziet dat Phi-3 Mini alleen hardwarekosten vereist. Je vermijdt doorlopende tokenkosten. Deze optimalisatie laat je applicaties schalen zonder zorgen over oplopende kosten. Je bereikt efficiënt datagebruik en een hoge responsiviteit. Je applicaties draaien met lage latentie en realtime prestaties.
Small language models ondersteunen optimalisatie voor veel taken. Je gebruikt ze voor refactoring, codegeneratie en documentclassificatie. Je krijgt prestaties die aansluiten bij je behoeften. Je kunt modellen lokaal uitrollen en de beveiliging waarborgen. Je bouwt applicaties die waarde leveren en binnen budget blijven.
Tip: Small language models helpen je je workflow te optimaliseren. Je boekt winst op het gebied van snelheid, privacy en kostenbesparing. Je kunt je richten op het bouwen van goede applicaties en het verbeteren van de productiviteit van je team.
Snelheid en responsiviteit
Je verwacht dat je AI-tools snel reageren. Trage antwoorden verstoren je workflow en kosten je tijd. Small Language Models, zoals de Phi Family van Microsoft, leveren snelle resultaten. Je krijgt antwoorden in milliseconden, niet in seconden. Deze snelheid helpt je gefocust en productief te blijven.
Je kunt SLM’s draaien op je eigen apparaten of servers. Je hoeft niet te wachten op verwerking in de cloud. Je verzoeken blijven lokaal, dus je krijgt direct feedback. Dit is belangrijk voor mobiele medewerkers en teams in het veld. Je hebt informatie precies op het moment dat je die nodig hebt.
De Phi-familiemodellen gebruiken efficiënte algoritmen. Ze verwerken taken met minimale vertraging. Je merkt het verschil wanneer je e-mails samenvat, actiepunten haalt of documenten classificeert. Je team kan in minder tijd meer taken afhandelen.
Tip: Snelle AI-antwoorden betekenen dat je minder tijd kwijt bent aan wachten en meer tijd besteedt aan waarde creëren.
Hier is een tabel die laat zien hoe SLM's qua responstijd vergelijken met grote modellen:
| Modeltype | Gemiddelde responstijd |
|---|---|
| Groot taalmodel | 2-5 seconden |
| Klein taalmodel (Phi) | < 0,5 seconden |
Je ziet dat SLM's bijna direct antwoord geven. Die snelheid verbetert je ervaring en houdt je projecten in beweging.
Je krijgt ook meer betrouwbaarheid. Snelle reacties betekenen minder onderbrekingen. Je applicaties werken soepel. Je kunt erop vertrouwen dat je AI-tools je tempo bijhouden.
Kleine taalmodellen helpen je responsieve apps te bouwen. Je kunt ze integreren in je workflow. Je team profiteert van realtime inzichten en snellere beslissingen.
Let op: snelheid en responsiviteit zijn niet alleen technische kenmerken. Ze zijn essentieel om AI nuttig te maken in je dagelijks werk.
Zakelijke voordelen van SLM's
Kostenbesparingen in de praktijk
Je wilt echte besparingen zien wanneer je investeert in AI-tools. Kleine taalmodellen leveren voor bedrijven een indrukwekkende kostenoptimalisatie op. Veel organisaties hebben grotere modellen vervangen door kleinere die 5 tot 150 keer goedkoper zijn. Je haalt betere resultaten voor specifieke taken zonder hoge kosten voor cloudverwerking. De volgende tabel laat zien hoe toonaangevende organisaties profiteren van SLM's:
| Organisatie | Modeltype | Kostenreductie | Prestatievergelijking |
|---|---|---|---|
| Checkr | 7B-14B-parameters | 5-150x minder | Betere resultaten |
| NVIDIA | 7B-14B-parameters | 5-150x minder | Betere resultaten |
| Bayer | 7B-14B-parameters | 5-150x minder | Betere resultaten |
| DoorDash | 7B-14B-parameters | 5-150x minder | Betere resultaten |
Je kunt je totale AI-kosten met 85-95% verlagen in vergelijking met traditionele oplossingen met grote modellen. Zo kun je je activiteiten opschalen en investeren in andere onderdelen van je bedrijf.
Lokale implementatie en datasoevereiniteit
Je moet je data beschermen en aan compliance-eisen voldoen. Met SLM's kun je AI lokaal uitrollen, waardoor gevoelige informatie binnen je organisatie blijft. Gereguleerde sectoren zoals zorg, financiën en recht geven de voorkeur aan lokale opstellingen, omdat die strikte beveiliging en privacy bieden. Je voorkomt dat data naar externe servers wordt gestuurd, wat het risico op datalekken verkleint en bijdraagt aan naleving van regelgeving.
- Lokale implementatie zorgt ervoor dat er geen data naar externe servers wordt verzonden.
- Je kunt modellen fine-tunen met eigen data, waardoor AI-beslissingen transparant en compliant zijn.
- Landen en organisaties investeren in soevereine AI-oplossingen om hun informatie onder controle te houden en de regionale weerbaarheid te versterken.
Hybride benaderingen helpen je ook om lokale verwerking van gevoelige data in balans te brengen met cloudverwerking voor schaalbaarheid en nauwkeurigheid. Zo krijg je flexibiliteit en behoud je toch de controle.
Productiviteitswinst in Microsoft 365
Je wilt dat je team sneller en slimmer werkt. SLM's die in Microsoft 365 zijn geïntegreerd, verhogen de productiviteit door snelle reacties en accurate resultaten. De latentie bij inferentie daalt tot 50-150 milliseconden, tegenover 200-1.000 milliseconden bij grotere modellen. Je medewerkers krijgen direct antwoord wanneer ze e-mails samenvatten, actiepunten halen of documenten classificeren.
- Gespecialiseerde SLM's halen een nauwkeurigheid van 85-97% in afgebakende domeinen en presteren daarmee beter dan algemene modellen.
- Verwerking op het apparaat houdt je workflow soepel en veilig.
- Je verkleint de behoefte aan technische ondersteuning en blijft tijdens het werk aan de compliance-eisen voldoen.
Je helpt ook het milieu. Het trainen van een SLM levert een veel kleinere CO2-voetafdruk op, vaak tussen 2 en 50 ton CO2-equivalent, terwijl grote modellen meer dan 500 ton kunnen bereiken. Zo maak je je bedrijf duurzamer en efficiënter.
Tip: SLM's geven je de mogelijkheid om kosten te optimaliseren, je data te beschermen en de productiviteit te verhogen, allemaal binnen je bestaande Microsoft 365-omgeving.
Use cases: de Phi Family in actie
Je wilt zien hoe small language models werken in echte zakelijke situaties. De Phi Family biedt praktische oplossingen waarmee je dagelijkse uitdagingen aanpakt. Je kunt deze modellen gebruiken om de communicatie te verbeteren, de productiviteit te verhogen en je team op veel manieren te ondersteunen.
Hier zijn enkele praktijkvoorbeelden van hoe je de Phi Family in je organisatie kunt gebruiken:
Meertalige chatbots voor klantenservice
Je kunt chatbots bouwen met Phi-3.5 die klantvragen in veel talen beantwoorden. Zo help je klanten uit verschillende landen zonder extra personeel aan te nemen. Je supportteam wordt efficiënter en je klanten krijgen sneller hulp.Meertalige contentgeneratie
Je kunt het maken van marketingcontent voor verschillende regio's automatiseren. Phi-3.5 helpt je advertenties, e-mails en social-mediaberichten in meerdere talen te schrijven. Hierdoor voelt je merk herkenbaarder voor mensen uit verschillende culturen. Je bereikt meer klanten en laat je bedrijf groeien.Documentvertaling en -samenvatting
Je kunt Phi-3.5 gebruiken om lange of complexe documenten te vertalen en samen te vatten. Dit is handig als je werkt in de rechtspraak, het onderwijs of onderzoek. Je bespaart tijd met heldere samenvattingen en nauwkeurige vertalingen. Je team kan zich richten op belangrijke taken in plaats van op handmatig werk.
Tip: Je kunt deze use cases combineren om nog meer waarde te creëren. Je kunt bijvoorbeeld klantfeedback vertalen en samenvatten, en de resultaten gebruiken om je producten te verbeteren.
Je hebt geen speciale hardware of cloudservices nodig om de Phi Family te gebruiken. Je kunt deze modellen draaien op je eigen servers of apparaten. Dit houdt je data veilig en helpt je aan privacyregels te voldoen. Je bepaalt waar je informatie naartoe gaat en wie er toegang toe heeft.
Je wint ook aan snelheid. De Phi Family geeft antwoorden in milliseconden. Je team hoeft niet te wachten op trage cloudreacties. Zo verloopt je workflow soepeler en blijven je projecten op koers.
Je ziet dat de Phi Family in veel branches past. Of je nu werkt in de klantenservice, marketing, de rechtspraak of het onderwijs, je vindt elke dag manieren om deze modellen te gebruiken. Je helpt je team slimmer te werken en betere resultaten te leveren.
Let op: De Phi Family van small language models geeft je de tools om echte problemen op te lossen. Je kunt klein beginnen en opschalen naarmate je behoeften groeien.
Afwegingen en beperkingen
Scope en specialisatie
Small language models (SLM's) geven je snelheid en privacy, maar je moet hun beperkingen kennen. SLM's richten zich op specifieke taken en domeinen. Ze bestrijken niet zoveel als large language models (LLM's). Je kunt deze verschillen merken:
- SLM's hebben kleinere kennisbanken dan LLM's.
- Ze geven soms vage antwoorden over open of onbekende onderwerpen.
- SLM's kunnen moeite hebben met lange documenten of complexe redeneringen.
- Je kunt minder consistentie zien in lange tekst of bij het wisselen van onderwerp.
- SLM's generaliseren minder goed, dus ze presteren mogelijk minder sterk bij nieuwe taken of taken die meerdere domeinen raken.
Als je een model nodig hebt voor brede, open vragen, voldoen SLM's niet altijd aan je behoefte. Voor gerichte taken komen ze echter goed tot hun recht.
Bias en datasetgrootte
Je wilt eerlijke en nauwkeurige resultaten van je AI. De manier waarop SLM's en LLM's met bias en datagrootte omgaan, verschilt. SLM's gebruiken kleinere, zorgvuldig gekozen datasets. Dit helpt bias te verminderen en houdt je data privé. LLM's trainen op enorme, open datasets, wat ongewenste bias of fouten kan introduceren.
Hier is een tabel die laat zien hoe SLM's en LLM's zich verhouden:
| Aspect | SLM's | LLM's |
|---|---|---|
| Biasrisico | Lager door kleinere, zorgvuldig samengestelde datasets | Hoger door training op ruwe, diverse data |
| Trainingsdata | Domeinspecifiek, zorgvuldig samengesteld | Open toegankelijke, mogelijk bevooroordeelde data |
| Modelarchitectuur | Minder complex, waardoor het biasrisico lager is | Complexer, kan bias onbedoeld versterken |
| Prestaties bij taken | Effectief in gespecialiseerde domeinen | Sterk bij open taken, maar kan feitelijke fouten bevatten |
LLM's maken soms feitelijke fouten of herhalen vooroordelen uit hun trainingsdata. SLM's helpen je met hun gerichte training deze problemen te vermijden en beschermen je privacy.
Let op: SLM's zijn niet perfect, maar hun kleinere, gecureerde datasets maken ze een veiligere keuze voor gevoelig of gereguleerd werk.
Toegankelijkheid en API-beschikbaarheid
Je wilt eenvoudig toegang tot AI-tools. SLM's geven je meer mogelijkheden om ze te gebruiken en uit te rollen. Veel developers merken dat SLM's lokaal draaien AI toegankelijker en betaalbaarder maakt. In een onderzoek met 180 developers verlaagde lokale uitrol van SLM's de kosten met 33% in vergelijking met commerciële API's. Je kunt meer experimenteren en sneller leren wanneer je het model op je eigen hardware beheert.
- Commerciële LLM-API's kunnen duur en traag zijn, en ze kunnen privacyzorgen oproepen.
- Open-sourcemodellen bestaan, maar je hebt enige technische kennis nodig om ze in te richten.
- Lokaal hosten van SLM's laat je effectiever je data en kosten beheren.
Met SLM's krijg je meer flexibiliteit en controle. Je kunt kiezen hoe je ze uitrolt, wie er toegang toe heeft en hoe je je data veilig houdt.
Tip: Als je wilt experimenteren, geld wilt besparen en je data wilt beschermen, bieden SLM's een praktische weg vooruit.
SLM's in de praktijk uitrollen
Uitrolopties
Je hebt verschillende manieren om Small Language Models uit te rollen in je organisatie. Je kiest de beste optie op basis van je behoeften en middelen. Veel teams gebruiken edge-apparaten voor realtime verwerking. Met deze apparaten draai je modellen lokaal, zodat je snelle antwoorden krijgt en je data veilig blijft. Clouduitrol biedt schaalbaarheid en eenvoudig beheer. Je kunt grote workloads aan en modellen snel updaten, maar je kunt te maken krijgen met latentie en ben je afhankelijk van internettoegang.
Uitrol on-premises houdt gevoelige informatie binnen je bedrijf. Je beheert je infrastructuur zelf en voldoet aan strikte compliance-eisen. Hybride opstellingen combineren lokale en cloudresources. Je zoekt een balans tussen snelheid, privacy en schaalbaarheid.
Hier is een tabel met de belangrijkste uitrolopties:
| Uitroloptie | Voordelen | Nadelen |
|---|---|---|
| Edge-uitrol | Realtimeverwerking op apparaten | Beperkte rekenkracht |
| Clouduitrol | Schaalbaar en efficiënt beheer | Mogelijke latentie en afhankelijkheid van internet |
| On-premises | Volledige controle en compliance | Hogere kosten voor installatie en onderhoud |
| Hybride | Flexibiliteit en evenwichtige prestaties | Complexiteit in integratie en beheer |
Bij het plannen van je uitrol moet je de scope van je workloads bepalen, je datagovernance controleren, de rekenkracht meten, de verwachte gebruikersbelasting inschatten en je toekomstige roadmap meenemen.
Fine-tuning en aanpassing
Je kunt Small Language Models fine-tunen om ze af te stemmen op je bedrijfsbehoeften. Fine-tuning laat je het gedrag van het model bijstellen en de nauwkeurigheid voor je taken verbeteren. Je begint met het voorbereiden en opschonen van je data. Je kiest het beste basismodel voor je doelen. Je koppelt het model aan live databases, zodat je AI actuele antwoorden geeft.
Je past beveiligingsprotocollen toe, zoals het maskeren van persoonsgegevens, om aan wereldwijde normen te voldoen. Je labelt je zakelijke data en traint het model op je merkstem en technische processen. Je test het model in praktijksituaties om nauwkeurigheid en bias te controleren. Je rolt het model uit, monitort de prestaties en traint het opnieuw waar nodig.
Uit een onderzoek bleek dat een fijn afgestemd klein model grotere modellen kan overtreffen tegen een fractie van de kosten. Je kunt veel verzoeken goedkoop verwerken en toch een hoge kwaliteit halen. Fine-tuning helpt je dezelfde resultaten te behalen als grotere modellen, maar met minder kosten en een snellere respons.
Integratie met developerworkflows
Je wilt dat je AI-tools naadloos in je werkproces passen. Je kunt te maken krijgen met uitdagingen zoals datalekken, ingewikkelde prompt engineering en een hoog resourcegebruik. Je kunt deze problemen oplossen door private datasets en robuuste evaluatieprotocollen te gebruiken. Je fine-tunt je modellen om ongewenste kennis te verminderen en de besluitvorming te verbeteren.
Je integreert SLM's met je ontwikkeltools en automatiseert taken zoals codegeneratie en documentclassificatie. Je draait modellen op edge-apparaten voor directe feedback en veilige verwerking. Je monitort de prestaties en past je opzet aan zodat je werkproces efficiënt blijft.
Tip: Begin met kleine taken en schaal op zodra je meer vertrouwen krijgt. Zo bouw je betrouwbare, snelle en veilige AI-oplossingen waarmee je team slimmer kan werken.
Open-source versus propriëtaire modellen
Wanneer je besluit om Small Language Models in te zetten, sta je voor een belangrijke keuze: open-source of propriëtair. Elke weg heeft unieke voordelen en uitdagingen. Als je deze verschillen begrijpt, kun je de beste beslissing voor je organisatie nemen.
Open-source SLM's geven je vrijheid en flexibiliteit. Je kunt de broncode raadplegen, aanpassen en het model afstemmen op je behoeften. Deze aanpak werkt goed als je wilt experimenteren, aanpassen of je AI-tools zelf wilt beheersen. Je kunt deze modellen op je eigen hardware draaien, wat helpt om gevoelige gegevens te beschermen en aan compliance-eisen te voldoen. Veel ontwikkelaars kiezen voor open-source SLM's omdat ze transparantie en steun van de community willen.
Propriëtaire modellen daarentegen komen van bedrijven die ze bouwen en onderhouden. Je krijgt een afgewerkt product met professionele ondersteuning en regelmatige updates. Deze modellen bevatten vaak geavanceerde functies, beveiligingspatches en integratie met andere enterprise-tools. Als je een oplossing wilt die direct werkt en met een serviceovereenkomst komt, kunnen propriëtaire modellen bij je behoeften passen.
Bij je keuze kun je het best een aantal factoren overwegen:
- Aanpasbaarheid: Open-source modellen laten je de AI fine-tunen en aanpassen aan je specifieke taken. Propriëtaire modellen kunnen je mogelijkheden beperken om het kernsysteem te wijzigen.
- Kosten: Open-source modellen hebben meestal geen licentiekosten. Je betaalt alleen voor hardware en onderhoud. Propriëtaire modellen vragen vaak abonnements- of gebruikskosten.
- Ondersteuning: Propriëtaire modellen bieden dedicated ondersteuning en documentatie. Open-source modellen vertrouwen op communityforums en gedeelde bronnen.
- Beveiliging en compliance: Beide opties kunnen voldoen aan hoge beveiligingsnormen, maar open-source modellen geven je meer controle over de verwerking van gegevens.
Een tabel kan je helpen de twee opties te vergelijken:
| Kenmerk | Open-source SLM's | Propriëtaire SLM's |
|---|---|---|
| Aanpasbaarheid | Hoog | Matig tot laag |
| Kosten | Alleen hardware/onderhoud | Abonnements-/gebruikskosten |
| Ondersteuning | Door community gedreven | Professioneel, dedicated |
| Updates | Bijdragen van de community | Regelmatig, door leverancier gestuurd |
| Gegevensbeheer | Volledig (lokale implementatie mogelijk) | Verschilt per leverancier |
Recent onderzoek van Stanford HAI laat zien dat gespecialiseerde SLM's in afgebakende domeinen een nauwkeurigheid van 85-97% halen. Dat presteert beter dan veel algemene grote modellen. Je profiteert van deze prestaties wanneer je modellen op maat maakt voor je bedrijf. De economische voordelen van SLM's stimuleren ook de adoptie, omdat je hoogwaardige resultaten kunt behalen zonder hoge kosten. Veel bedrijven kiezen nu voor zowel open-source als propriëtaire modellen, en richten zich op modellen die voor specifieke taken zijn ontworpen in plaats van generieke oplossingen.
Tip: Begin met je bedrijfsdoelen. Als je flexibiliteit en controle nodig hebt, zijn open-source SLM's misschien de beste keuze. Wil je betrouwbaarheid en ondersteuning, overweeg dan propriëtaire opties. Je kunt ook beide typen combineren om het beste van beide werelden te krijgen.
De toekomst van Small Language Models
Trends in de ontwikkeling van SLM's
Small language models (SLM's) groeien snel in veel sectoren. Bedrijven willen AI die goed werkt, minder kost en gegevens veilig houdt. SLM's drijven nu slimme tools aan in de gezondheidszorg, financiële dienstverlening en productie. Je kunt de onderstaande tabel bekijken om te zien hoe verschillende regio's en sectoren SLM's gebruiken:
| Segment | Inzichten |
|---|---|
| Gezondheidszorg | SLM's helpen bij patiëntbetrokkenheid en communicatie via chatbots en assistenten. |
| Trends in de Amerikaanse markt | De VS lopen voorop in het gebruik van SLM's, met bedrijven zoals Microsoft die nieuwe modellen naar voren brengen. |
| Europese trends | Europa richt zich op ethische AI en gebruikt SLM's voor klantenservice en contentcreatie. |
| Trends in Azië-Pacific | Snelle groei, omdat bedrijven efficiënte taaltools willen in veel sectoren. |
Je ziet nieuwe trends die SLM's vormgeven. Ontwikkelaars gebruiken parameter-efficient fine-tuning (PEFT) en kennisdistillatie om modellen slimmer te maken zonder grote computers nodig te hebben. Gequantiseerde modellen draaien nu op edge-apparaten, zodat je snelle antwoorden krijgt, zelfs op kleine hardware. SLM's ondersteunen automatisering en voorspellende inzichten in veel vakgebieden. Je profiteert van modellen die passen bij je behoeften en werken waar jij ze nodig hebt.
| Trendtype | Beschrijving |
|---|---|
| Belangrijkste innovatietrends | PEFT en kennisdistillatie maken SLM's efficiënt en eenvoudig aan te passen. |
| Adoptie in de industrie | SLM's zorgen voor automatisering in de productie, financiële sector en cybersecurity. |
| Drijfveer | De vraag naar snelle AI met weinig rekenkracht stimuleert de adoptie van SLM's. |
| Kans | SLM's die zijn afgestemd op de zorg en de financiële sector verbeteren de precisie en compliance. |
| Uitdaging | Het in balans houden van nauwkeurigheid en efficiëntie blijft een belangrijk aandachtspunt voor ontwikkelaars. |
Groeiende mogelijkheden
Misschien denk je dat SLM's alleen eenvoudige taken aankunnen, maar dat verandert. Recent onderzoek laat zien dat SLM's nu complexe taken kunnen overnemen die vroeger voorbehouden waren aan grote taalmodellen. SLM's kunnen bijvoorbeeld afbeeldingen en tekst verwerken en robots zelfs helpen hun omgeving te begrijpen. Je ziet SLM's samenwerken met grotere modellen voor taken zoals documentanalyse, begrip van beeld en taal, en realtime besluitvorming.
| Onderzoek | Bijdrage |
|---|---|
| Samenwerkingsmechanismen | SLM's nemen taken op een lager niveau over in multimodale systemen, waardoor AI efficiënter wordt. |
| LLM-distillatie | SLM's leren van grotere modellen om meerdere taken uit te voeren in gespecialiseerde domeinen. |
| VITA-1.5 Model | SLM's verwerken specifieke datatypen voordat ze informatie naar grotere modellen sturen. |
| Visie met lange context | SLM's beheren visuele informatie voor lange documenten of afbeeldingen. |
| Belichaamde agentsystemen | SLM's worden in de robotica ingezet en helpen machines te handelen in de echte wereld. |
| Samenwerking cloud-edge | SLM's verwerken gespecialiseerde taken in enterprise-omgevingen, wat kosten en latentie verlaagt. |
| Enterprise-SLM-oplossing | SLM's evenaren nu de prestaties van grotere modellen voor veel zakelijke taken. |
Je haalt steeds meer uit SLM's naarmate ze nieuwe uitdagingen leren aanpakken. Deze modellen ondersteunen nu multitasking, werken met verschillende soorten data en leveren snel resultaat.
De rol van Microsoft Phi
Je ziet de Phi-familie van Microsoft voorop lopen in de innovatie van SLM's. Experts benadrukken dat Phi-modellen, zoals Phi-4-mini, goed werken op edge-apparaten. Je kunt ze gebruiken op plekken met zwak internet of strenge privacyeisen. Deze modellen helpen je de efficiëntie te verhogen in de productie, zorg en retail. De Phi-4-mini- en Phi-4-multimodal-modellen hebben minder rekenkracht nodig, waardoor je geld bespaart en sneller resultaat krijgt. Hun langere contextvenster maakt het eenvoudig om grote documenten of datasets te analyseren.
"Taalmodellen zijn krachtige redeneermachines, en het integreren van kleine taalmodellen zoals Phi in Windows stelt ons in staat efficiënte rekencapaciteit te behouden en opent de deur naar een toekomst met continue intelligentie die in al je apps en ervaringen is ingebouwd. Copilot+ PC's bouwen voort op de mogelijkheden van Phi-4-multimodal en leveren de kracht van Microsofts geavanceerde SLM's zonder de energie-industrie te belasten. Deze integratie versterkt productiviteit, creativiteit en onderwijsgerichte ervaringen, en wordt een standaard onderdeel van ons ontwikkelplatform." —Vivek Pradeep, Vice President Distinguished Engineer of Windows Applied Sciences.
Je kunt verwachten dat Microsoft Phi nieuwe toepassingen van SLM's blijft stimuleren. Naarmate deze modellen onderdeel worden van je dagelijkse tools, zie je overal waar je werkt slimmere, snellere en veiligere AI.
Je ziet hoe Small Language Models, zoals de Phi-familie van Microsoft, het grootste probleem van Copilot oplossen. Deze modellen bieden je:
- Hoge nauwkeurigheid bij gespecialiseerde taken met een laag risico op fouten
- Snelle verwerking en lage latentie voor antwoorden in realtime
- Sterke privacy dankzij implementatie on-premises
- Lagere kosten en minder behoefte aan dure hardware
Je kunt klantenondersteuning automatiseren, tickets classificeren en regelgevende documenten efficiënt verwerken. Experts voorspellen dat AI binnenkort deel gaat uitmaken van de beroepsbevolking en sectoren zal transformeren. Overweeg SLM's voor je organisatie en blijf voorbereid op de volgende golf van AI-innovatie.
Veelgestelde vragen
Wat is een Small Language Model (SLM)?
Een Small Language Model gebruikt minder parameters dan grote modellen. Je kunt SLM's draaien op lokale apparaten. SLM's leveren snelle, nauwkeurige resultaten voor specifieke taken, zoals het samenvatten van e-mails of het classificeren van documenten.
Hoe verbetert de Phi-familie van Microsoft de privacy?
Je implementeert Phi-modellen lokaal. Je gegevens blijven binnen je organisatie. Je bepaalt wie toegang heeft en voldoet aan compliance-eisen. Phi-modellen helpen je gevoelige informatie te beschermen en privacyrisico's te verminderen.
Kan ik SLM's gebruiken zonder dure hardware?
Ja! Je draait SLM's zoals Phi-3 Mini op gewone computers of servers. Je vermijdt kostbare cloud-GPU's. SLM's werken efficiënt met minimale resources, waardoor AI toegankelijk wordt voor je team.
Hoe verminderen SLM's hallucinaties in codesuggesties?
SLM's gebruiken gerichte training en optimalisatie. Je ziet minder verzonnen pakketten en betrouwbaardere antwoorden. Phi-modellen richten zich op nauwkeurigheid, zodat je de door AI gegenereerde code beter kunt vertrouwen.
Welke taken kunnen SLM's uitvoeren in Microsoft 365?
Je gebruikt SLM's om e-mails samen te vatten, actiepunten te halen, documenten te classificeren en routinematige taken te automatiseren. SLM's verhogen de productiviteit en leveren snel, nauwkeurige resultaten in je dagelijkse werkproces.
Zijn SLM's geschikt voor gereguleerde sectoren?
Ja. Je implementeert SLM's lokaal om gegevens veilig te houden. Teams in de zorg, financiële sector en juridische sector gebruiken SLM's om aan strenge privacy- en compliance-normen te voldoen. Je houdt de controle over gevoelige informatie.
Hoe helpen SLM's de AI-kosten te verlagen?
Bij zelf gehoste implementatie betaal je alleen hardwarekosten. Je vermijdt doorlopende tokenkosten. Je schaalt je AI-oplossingen betaalbaar op en bereikt aanzienlijke besparingen in vergelijking met grote modellen.
🎧 Luister naar deze aflevering
Wil je een praktische uitleg over Small Language Models voor Faster, Cheaper Enterprise AI? In deze aflevering wordt het onderwerp helder uitgelegd en wordt getoond waarom het ertoe doet voor Microsoft 365, Azure, Power Platform, beveiliging, AI en modern werken.
Luister naar deze aflevering als je:
- De kernconcepten achter Small Language Models voor Faster, Cheaper Enterprise AI wilt begrijpen
- wilt zien hoe het past binnen het bredere Microsoft-technologie-ecosysteem
- wilt leren waar het praktische waarde kan opleveren voor je organisatie
Misschien vind je deze gerelateerde M365 FM-afleveringen ook interessant:
- Van data naar intelligente agents: vertrouwde enterprise-AI bouwen met Microsoft AI Foundry met Shubhangi Goyal [MVP]
- Azure DevOps in 2026: de stille ruggengraat van enterprise-AI
- Enterprise-AI-ervaringen bouwen in Power Apps met Sara Lagerquist [MVP]
- Microsoft Graph: The Enterprise Nervous System
- Graph-aangedreven AI-agents: een gids voor enterprise-architectuur
Ontdek meer praktische Microsoft-gesprekken op M365 FM.
Laatst beoordeeld: juli 2026.
Voor wie is dit bedoeld
Deze aflevering is bedoeld voor Microsoft-beheerders, architecten, ontwikkelaars, securityspecialisten en zakelijke leiders die een praktische basis nodig hebben voordat ze beslissingen nemen over implementatie, beheer of governance.
🎧 Luister ook naar
- AI Agents — Een sterk verwante vervolgstap om dit onderwerp verder uit te breiden.
- Power Platform — Een sterk verwante vervolgstap om dit onderwerp verder uit te breiden.
- Microsoft Graph Data Connect — Een sterk verwante vervolgstap om dit onderwerp verder uit te breiden.