 JA
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 한국어
なぜCopilotは失敗するのか:ハルシネーションと企業向けプライバシーの欠陥を読み解く
By Mirko Peters ·
ワークステーションに向かってMicrosoft Copilotのような AI アシスタントを開くとき、あなたには明確な期待があるはずです。作業の流れを加速させ、面倒な作業を自動化し、より clean で速いコードを書きたいのです。日常的な多くの作業では、大規模言語モデル(LLM)がその期待に応えてくれます。しかし、企業向けソフトウェア開発や機密性の高いデータ分析でこうした大規模なクラウドベースのアーキテクチャに長く頼ってきた方であれば、その負の側面に遭遇したことがあるでしょう。もっともらしく自信に満ちた説明が、実は完全な作り話だったという経験です。AI アシスタントが存在しないオープンソースのソフトウェアパッケージを作り出し、サプライチェーン攻撃の危険な侵入口をつくってしまう場面も見てきたはずです。さらに厄介なのは、アクセス許可の多い広範なクラウドモデルが、機密の社内財務レポートや人事関連
Automatically translated with AI from the original post. Read the English original
ワークステーションに向かってMicrosoft Copilotのような AI アシスタントを開くとき、あなたには明確な期待があるはずです。作業の流れを加速させ、面倒な作業を自動化し、より洗練された高速なコードを書きたいのです。日常的な多くの作業では、大規模言語モデル(LLM)がその期待に応えてくれます。しかし、企業向けソフトウェア開発や機密性の高いデータ分析でこうした大規模なクラウドベースのアーキテクチャに長く頼ってきた方であれば、その負の側面に遭遇したことがあるでしょう。もっともらしく自信に満ちた説明が、実は完全な作り話だったという経験です。AI アシスタントが存在しないオープンソースのソフトウェアパッケージを作り出し、サプライチェーン攻撃の危険な侵入口をつくってしまう場面も見てきたはずです。さらに厄介なのは、アクセス許可の多い広範なクラウドモデルが、機密の社内財務レポートや人事関連文書を権限のない人の目に触れさせているのではないか、という不安です。
これらは単なる軽微なソフトウェアの不具合や一時的な成長痛ではありません。大規模な汎用言語モデルの中核設計に組み込まれた、根本的な脆弱性です。組織が生成 AI の導入を急ぐなかで、IT リーダー、開発者、セキュリティ担当者は壁にぶつかっています。大きければ常に良いとは限らない、ということが分かってきたのです。実際、従来型 LLM の規模そのものが、セキュリティリスク、コンプライアンス違反、運用負荷の管理しきれない攻撃対象領域を生み出すことが少なくありません。ミッションクリティカルな企業環境でこれらのシステムがなぜ破綻するのかを本当に理解するには、Copilot のような大規模アシスタントに内在するセキュリティと正確性の欠陥を掘り下げるとともに、それらを根本から修正しつつあるアーキテクチャ面での巻き返しを探る必要があります。
現代のアーキテクチャがこうした課題をどう乗り越えつつあるかをさらに詳しく知りたい方は、関連エピソードのSmall Language Models for Faster, Cheaper Enterprise AI episodeもぜひご覧ください。実際の Microsoft 環境でこれらのシステムがどのように動作するのかを、実践的な視点で確認できます。
Copilot の中核的な欠陥
主な弱点の解説
Copilot には、より速く賢く作業してほしいと期待しますが、正確性とプライバシーの面で課題を抱えることがあります。Copilot は回答の生成に大規模言語モデルを使用しますが、これらのモデルは情報を誤って伝えたり、詳細を作り出したりすることがあります。説得力があるように見えて、実際には不完全だったり誤っていたりする回答が表示される場合があります。これは、モデルが文脈や利用するデータを常に正しく理解しているとは限らないためです。事実を確認し、引用元を見直す必要があり、そのぶん作業が遅くなります。
プライバシーも大きな懸念事項です。Copilot は業務データに接続し、ユーザーのアクセス許可を使って情報にアクセスします。ご自身やチームのアクセス許可が多すぎる場合、Copilot は警告なしに機密データを取り出してしまう可能性があります。例えば、広範なアクセス権を持つ人が、給与や人事評価といった機密情報をCopilotに尋ねることもあり得ます。これらのアカウントにアクセスできた攻撃者は、深刻な情報漏えいを引き起こしかねません。また、モデルが常にセキュリティラベルを引き継ぐとは限らないため、適切な分類がないまま機密情報が共有されてしまう恐れもあります。
Copilot に見られる代表的なセキュリティ上の欠陥を示した表は以下のとおりです:
| セキュリティ上の欠陥 | 説明 |
|---|---|
| EchoLeak の脆弱性 | 接続された M365 のソースから機密データを取り出すために Copilot を悪用する、ゼロクリック攻撃です。 |
| 大規模なプロンプトインジェクション | コンテンツに隠された悪意のある指示によって、Copilot を操作してデータを取得・共有させることができます。 |
| Copilot のエージェントの設定ミス | 設定を誤ったエージェントは、データを公開したり、過剰な特権で実行されたり、認証情報を保存したりする可能性があります。 |
| 過剰に許可されたデータアクセス | Copilot はユーザーがアクセスできるものすべてにアクセスできるため、業務上の機密データが過剰に共有されるリスクがあります。 |
| セキュリティラベルの継承に関する問題 | Copilot の出力がセキュリティラベルを継承しない場合があり、分類されていないデータや不適切に共有されたデータが生じるおそれがあります。 |
開発者とチームへの影響
Copilot を使うときは、信頼できる支援を期待するものです。しかし実際には、出力を確認して修正する作業が必要になることが多いのではないでしょうか。この余分な作業によってプロジェクトが遅れることがあります。ミスや情報漏えいのリスクが多く見られると、開発者はモデルへの信頼を失うかもしれません。チームは誤りを確認し、機密データが漏えいしていないかを確かめるために、より多くの時間を費やす必要があります。こうした問題を見つけて対処できるよう、チームを教育する必要もあり、それには時間とリソースがかかります。
モデルは、既存のずさんなデータセキュリティの運用をさらに増幅させることがあります。組織がアクセス許可を慎重に管理していない場合、Copilot は想定以上にデータを公開してしまうことで、状況を悪化させるおそれがあります。厳格なアクセス制御を設定し、モデルがビジネスデータとどのようにやり取りするかを監視する必要があります。
現実世界での影響
こうした欠陥の影響は、実際の状況でも確認されています。情報漏えいへの懸念から、米国議会はスタッフによる Copilot の利用を禁止しました。指導者たちは、機密性の高い政府データが許可されていないクラウドサービスに漏えいするおそれを懸念していました。別の事例では、研究者がプロンプトインジェクションとツールの悪用を組み合わせ、Copilot を通じて個人情報を盗み出す方法を発見しました。これらの事例は、リスクが単なる理論ではないことを示しています。
データを保護せず、正確な回答も提供しないモデルに頼っている場合、実際のビジネスリスクに直面します。機密情報が漏えいするおそれがあり、チームはミスの修正に時間を取られるかもしれません。仕事を安全かつ効率的に保つためには、正確性とプライバシーの両方を備えたモデルが必要です。
AI における SLM 革命
小規模言語モデルとは
SLM 革命という言葉を耳にしたことがあるかもしれませんが、それはあなたにとってどのような意味があるのでしょうか。小規模言語モデルは、効率と精度に重点を置いた新しいタイプの AI です。これらのモデルは、従来のシステムよりも少ないリソースで動作します。一般的なコンピューターや、自社のサーバー上でも実行できます。そのため、職場への導入が容易です。小規模言語モデルは、メールの要約、会議からの重要ポイントの抽出、文書の分類といったタスクを支援します。クラウドサーバーの応答を待つことなく、素早く回答を得られます。SLM 革命によって、データやワークフローをより自分の手でコントロールできるようになります。
SLM と大規模言語モデルの比較
小規模言語モデルと大規模言語モデルはどう違うのかと思われるかもしれません。主な違いはサイズと目的です。大規模言語モデルには高価なハードウェアが必要で、多くの場合クラウド上で動作します。小規模言語モデルはローカルマシンで動作し、消費電力も少なくて済みます。違いは以下の表でご確認いただけます。
| 特性 | 小規模言語モデル (SLM) | 大規模言語モデル (LLM) |
|---|---|---|
| 効率性 | 一般的なハードウェアでトレーニングと実行が可能 | 高価なクラウド GPU が必要 |
| 展開 | プライバシー強化のためオンプレミスで運用可能 | 多くの場合クラウドベース |
| コスト効率 | 運用コストが低い | 運用コストが高い |
| パフォーマンス | 小さなフットプリントで高速な推論が可能 | サイズが大きいため処理が遅い |
| ハルシネーションの低減 | 特定のデータセットでファインチューニングされ、信頼性の高い出力を得られる | ハルシネーションが発生しやすい |
| ユースケース | SDLC 内の特定のタスク向けに最適化 | 汎用的なアプリケーション |
| セキュリティ | 機密データを社内に保持できる | データが外部に公開されるおそれがある |
SLM は、速度、プライバシー、コスト削減の面で優れていることがわかります。外部のサーバーに頼る必要はありません。機密情報を安全に保つことができます。
SLM 革命が重要な理由
SLM 革命は、職場での AI の使い方を変えつつあります。ニーズに合ったモデルを展開し、データを保護することが可能になりました。多くの組織は、HIPAA や GDPR などの規制への準拠を支援できることから SLM を選択しています。情報をローカルで処理し、データをクラウドに送信せずに済みます。これにより、厳格なセキュリティ基準を満たしやすくなります。SLM 革命は生産性の向上にもつながります。リアルタイムで回答を得られ、作業の中でコンプライアンスを監視できます。応答の遅さや高いコストを心配する必要もありません。SLM 革命によって、AI ツールとビジネスデータを自分の手でコントロールできるようになります。
注意: SLM革命は技術だけの話ではありません。AIを安全に、迅速に、効率よく使える力をあなたに与えることがその本質です。
小規模言語モデルはCopilotの欠点をどう解決するのか
ハルシネーションの低減
AIツールには信頼できる回答を返してほしいものです。小規模言語モデルは、その目標の達成に役立ちます。これらのモデルは正確性と文脈に焦点を当てています。目的を絞った学習データと最適化技術を用いて、ハルシネーションを減らします。存在しないパッケージを提案されることが減り、より信頼できるコードの提案が得られます。Microsoftの Phi ファミリーなどのモデルを使えば、セキュリティを最優先にしたコード生成が可能になります。つまり、コードはクリーンで安全な状態を保てます。
小規模言語モデルは、リアルタイムのアプリケーションで力を発揮します。インテリジェントなリファクタリングや、要件分析の自動化に利用できます。コードの最適化やミスの回避にも役立ちます。モデルが効果的かつ高速に結果を返すため、パフォーマンスの向上を実感できるでしょう。エラーの修正に費やす時間が減り、ソリューションの構築により多くの時間を使えます。
プライバシーとデータ管理の強化
セキュリティとプライバシーは重要な関心事でしょう。小規模言語モデルを使えば、データを自分の手元で管理できます。これらのモデルは、自社のデバイスやサーバーにデプロイできます。このオンデバイス機能により、機密情報を組織内に留めておけます。外部のクラウドサービスにデータを送信する必要はありません。ビジネスを守りながら、コンプライアンス基準にも対応できます。
小規模言語モデルでは、アクセス許可とアクセスを管理できます。モデルを利用できるユーザーと、参照できるデータを決定できます。このアプローチは、プロアクティブなログ分析と自動化されたインシデント対応を支えます。アクティビティを監視し、脅威にすばやく対応できます。アプリケーションを安全に保ち、データを非公開のまま守れます。
小規模言語モデルは、セキュリティのための最適化を支援します。リアルタイムのパフォーマンス監視に利用できます。機密情報を公開することなく、ドキュメントの分類やアクションアイテムの抽出を支援します。データが安全に保たれていると分かれば、安心して業務を進められます。
コストとリソース要件の削減
予算とリソースを最適化したいと考えるのは当然でしょう。小規模言語モデルは、高い効率と低いレイテンシを実現します。一般的なハードウェアで実行できます。高価なクラウドGPUや大規模なインフラは必要ありません。これにより運用コストを抑えられ、より多くのチームがAIを利用できるようになります。
下のコスト比較表をご覧ください。Phi-3 Miniのような小規模言語モデルが、大規模モデルと比べてどれだけコストを抑えられるかが分かります。
| モデル | 入力コスト($/100万トークン) | 出力コスト($/100万トークン) |
|---|---|---|
| GPT-5.5 | $5.00 | $15.00 |
| Claude Sonnet 4.6 | $3.00 | $15.00 |
| Gemini 3.1 Pro | $3.50 | $10.50 |
| Mistral 7B(API経由) | $0.20 | $0.20 |
| Llama 3.1 8B(API経由) | $0.18 | $0.18 |
| Phi-3 Mini(セルフホスト) | ハードウェアコストのみ | ハードウェアコストのみ |
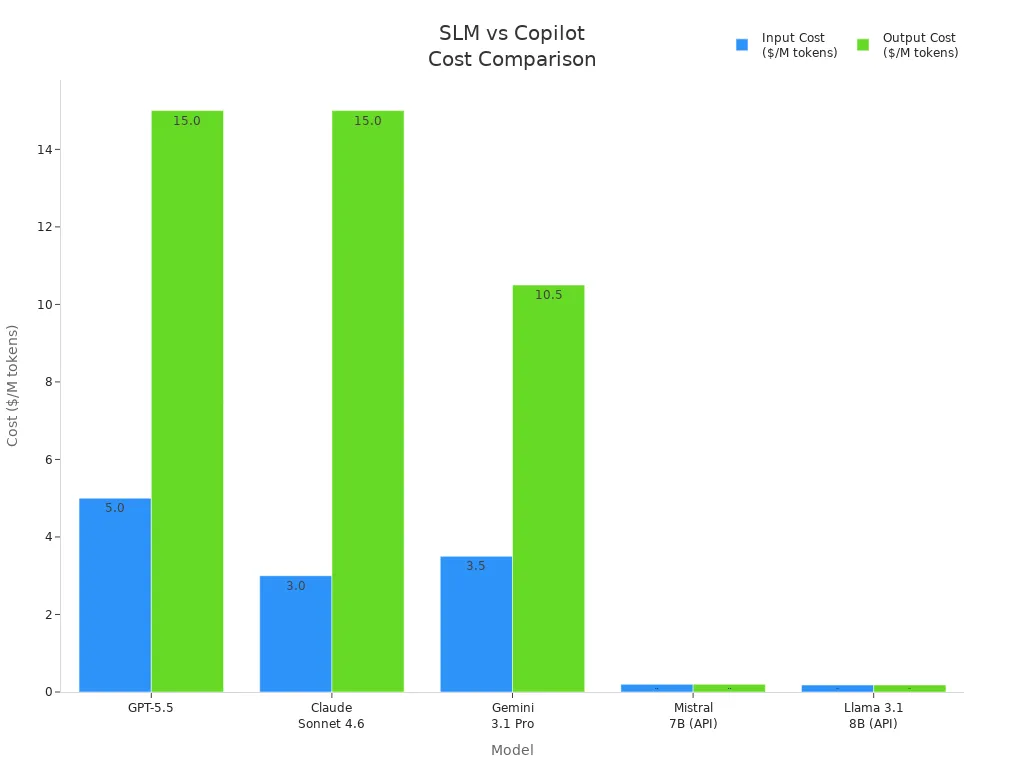
Phi-3 Miniはハードウェアコストのみで済むことが分かります。継続的なトークン料金が発生しないため、コストの上昇を気にせずアプリケーションを拡張できます。データ効率と高い応答性を両立でき、アプリケーションは低レイテンシかつリアルタイムで動作します。
小規模言語モデルは、多くのタスクの最適化に役立ちます。リファクタリング、コード生成、ドキュメント分類などに利用できます。ニーズに合った性能を得られ、ローカルにデプロイしてセキュリティを維持できます。価値を届けつつ予算内に収まるアプリケーションを構築できます。
ヒント: 小規模言語モデルは、ワークフローの最適化に役立ちます。スピード、プライバシー、コスト削減の効果が得られます。素晴らしいアプリケーションの開発と、チームの生産性向上に集中できます。
スピードと応答性
AIツールには素早い応答を期待するものです。応答が遅いと作業の流れが途切れ、時間を無駄にしてしまいます。Microsoftの Phi ファミリーのような小規模言語モデル(SLM)は、迅速な結果を返します。回答は数秒ではなく、ミリ秒単位で得られます。このスピードにより、集中力を保ち、生産性を高く維持できます。
SLMは自社のデバイスやサーバーで実行できます。クラウドでの処理を待つ必要はありません。リクエストはローカルで処理されるため、即座にフィードバックを得られます。これはモバイルワーカーや現場のチームにとって重要です。必要なときに、すぐに情報へアクセスできます。
Phiファミリーのモデルは効率的なアルゴリズムを使用しています。最小限の遅延でタスクを処理します。メールの要約、アクション項目の抽出、ドキュメントの分類などを行うと、その違いがわかります。チームはより短い時間で、より多くのタスクを処理できるようになります。
ヒント: AIの応答が速いと、待ち時間が減り、価値を生み出す作業により多くの時間を使えます。
以下は、SLMと大規模モデルの応答時間を比較した表です。
| モデルの種類 | 平均応答時間 |
|---|---|
| 大規模言語モデル | 2~5秒 |
| 小規模言語モデル(Phi) | 0.5秒未満 |
SLMはほぼ瞬時に回答を返すことがわかります。この速さにより操作性が向上し、プロジェクトも滞りなく進みます。
信頼性も向上します。応答が速いと、中断が減ります。アプリケーションは快適に動作します。AIツールがお客様のペースについてこられると信頼できます。
小規模言語モデルを使うと、反応の良いアプリを構築できます。ワークフローに組み込むこともできます。チームはリアルタイムのインサイトと迅速な意思決定の恩恵を受けられます。
注: 速度と応答性は単なる技術的な機能ではありません。日々の業務でAIを役立てるための重要な要素です。
企業におけるSLMのメリット
実際のコスト削減
AIツールに投資する際は、実際のコスト削減効果を確認したいところでしょう。小規模言語モデルは、企業にとって大きなコスト最適化効果をもたらします。多くの企業が、より大規模なモデルを、5~150倍安い小規模なモデルに置き換えています。クラウド処理に高額な料金を払わなくても、特定のタスクでより良い結果を得られます。次の表は、主要な組織がSLMからどのようなメリットを得ているかを示しています。
| 企業 | モデルの種類 | コスト削減 | パフォーマンスの比較 |
|---|---|---|---|
| Checkr | 70億~140億パラメーター | 5~150分の1 | より良い結果 |
| NVIDIA | 70億~140億パラメーター | 5~150分の1 | より良い結果 |
| Bayer | 70億~140億パラメーター | 5~150分の1 | より良い結果 |
| DoorDash | 70億~140億パラメーター | 5~150分の1 | より良い結果 |
従来の大規模モデルのソリューションと比べて、AIの総コストを85~95%削減できます。その分、事業の運営を拡大したり、ビジネスの他の分野に投資したりできます。
ローカル展開とデータの主権
データを保護し、コンプライアンス要件を満たす必要があります。SLMを使えば、AIをローカルに展開でき、機密情報を組織内に留めておけます。医療、金融、法務などの規制の厳しい業界では、厳格なセキュリティとプライバシーを提供できるため、ローカル環境が好まれています。外部サーバーへのデータ送信を避けられるため、情報漏えいのリスクが減り、規制基準への対応も支えられます。
- ローカル展開では、外部サーバーへのデータ送信がまったく発生しません。
- 独自のデータでモデルをファインチューニングすれば、AIの判断を透明にし、コンプライアンスに適合させられます。
- 各国や組織は、情報を管理し、地域的なレジリエンスを強化するために、主権AIソリューションへの投資を進めています。
ハイブリッドなアプローチを使えば、機密データはローカルで処理し、拡張性や精度が必要な処理はクラウドにオフロードするというバランスも取れます。管理性を保ちながら柔軟性も得られます。
Microsoft 365での生産性向上
チームにはより速く、より賢く働いてほしいものです。Microsoft 365に統合されたSLMは、迅速な応答と正確な結果によって生産性を高めます。推論の待ち時間は、大規模モデルの200~1,000ミリ秒に対し、50~150ミリ秒にまで短縮されます。従業員は、メールの要約、アクション項目の抽出、ドキュメントの分類を行う際に、すぐに回答を得られます。
- 特化型SLMは、限定的な領域で85~97%の精度を達成し、汎用モデルを上回ります。
- デバイス上での処理により、業務の流れを滑らかに保ち、安全性も確保できます。
- 技術サポートの負荷を減らし、業務を進めながらコンプライアンスも維持できます。
環境への貢献にもつながります。SLMのトレーニングによるカーボンフットプリントははるかに小さく、多くの場合2~50トンのCO2換算量です。一方、大規模モデルは500トンを超えることもあります。ビジネスをより持続可能で効率的なものにできます。
ヒント: SLMは、既存のMicrosoft 365環境の中で、コストの最適化、データの保護、生産性の向上を実現できる力を与えてくれます。
ユースケース: 実際に使えるPhiファミリー
小規模言語モデルが実際のビジネスの場面でどのように機能するのか、確認したいところでしょう。Phiファミリーは、日々の課題を解決するための実践的な手段を提供します。これらのモデルを使えば、コミュニケーションを改善し、生産性を高め、さまざまな形でチームを支援できます。
組織内でPhiファミリーをどのように活用できるか、実際の例をいくつかご紹介します。
多言語対応のカスタマーサポート チャットボット
Phi-3.5を使えば、多くの言語で顧客の質問に答えるチャットボットを構築できます。追加の人員を採用しなくても、さまざまな国のお客様に対応できます。サポートチームの効率が上がり、お客様はより早く支援を受けられるようになります。多言語コンテンツの生成
地域ごとのマーケティングコンテンツの作成を自動化できます。Phi-3.5は、複数の言語で広告、メール、ソーシャルメディアの投稿を作成する際に役立ちます。さまざまな文化圏の人々にとって、ブランドがより身近に感じられるようになります。より多くのお客様にリーチし、事業の成長につなげられます。ドキュメントの翻訳と要約
Phi-3.5を使えば、長文や複雑なドキュメントを翻訳・要約できます。法務、教育、研究の分野で仕事をしている場合に特に有効です。わかりやすい要約と正確な翻訳を得られるため、時間を節約できます。チームは手作業ではなく、重要な業務に集中できます。
ヒント: これらのユースケースを組み合わせると、さらに大きな価値を生み出せます。たとえば、顧客からのフィードバックを翻訳して要約し、その結果を製品の改善に活用できます。
Phiファミリーを使うために、特別なハードウェアやクラウドサービスは必要ありません。自社のサーバーやデバイスでこれらのモデルを実行できます。これによりデータを安全に保ち、プライバシーに関する規則への対応もしやすくなります。情報の保存先や、アクセスできるユーザーを自分で管理できます。
スピード面でもメリットがあります。Phiファミリーは数ミリ秒で回答を返します。チームが遅いクラウドの応答を待つ必要はありません。ワークフローがスムーズになり、プロジェクトを計画どおりに進めやすくなります。
Phiファミリーは多くの業界に適していることが分かります。カスタマーサービス、マーケティング、法務、教育のいずれの分野でも、日々の業務でこれらのモデルを活用する方法が見つかるはずです。チームのより賢い働き方を支え、より良い成果を届けられるようになります。
注: Phiファミリーの小規模言語モデルは、実際の課題を解決するためのツールを提供します。小さく始めて、ニーズの拡大に合わせて規模を広げていけます。
トレードオフと制限事項
対象範囲と専門性
小規模言語モデル(SLM)は、速度とプライバシーの面で優れていますが、その限界も理解しておく必要があります。SLMは特定のタスクや分野に特化しています。大規模言語モデル(LLM)ほど幅広くはカバーできません。次のような違いが見られる場合があります。
- SLMの知識ベースはLLMより小規模です。
- オープンエンドの質問や未知の話題では、曖昧な回答になることがあります。
- SLMは、長文のドキュメントや複雑な推論を苦手とする場合があります。
- 長文の場合や話題を切り替えた場合に、一貫性が低くなることがあります。
- SLMは汎化性能が高くないため、新しいタスクや複数分野にまたがるタスクでは、十分な性能を発揮できないことがあります。
幅広いオープンドメインの質問に対応するモデルが必要な場合、SLMでは要件を満たせないことがあります。一方で、特定のタスクに絞れば、その real な力を発揮します。
バイアスとデータセットの規模
AIから公平で正確な結果を得たいと考えるのは当然です。SLMとLLMでは、バイアスとデータ規模の扱い方が異なります。SLMはより小規模で慎重に選定されたデータセットを使用します。これによりバイアスを抑え、データのプライバシーを保ちやすくなります。LLMは巨大でオープンなデータセットで学習するため、望ましくないバイアスや誤りを取り込む可能性があります。
SLMとLLMの比較を次の表に示します。
| 項目 | SLM | LLM |
|---|---|---|
| バイアスのリスク | 小規模で厳選されたデータセットのため低い | 未加工で多様なデータで学習するため高い |
| 学習データ | 分野に特化し、厳選されたデータ | 公開されており、偏りの可能性があるデータ |
| モデルアーキテクチャ | 複雑さが低く、バイアスのリスクを抑えられる | 複雑で、意図せずバイアスを強化する可能性がある |
| タスクにおける性能 | 特定の分野で効果的 | オープンドメインのタスクに強い一方で、事実誤認が生じることがある |
LLMは、事実と異なる内容を生成したり、学習データに含まれる偏りを繰り返したりすることがあります。SLMは学習対象を絞り込んでいるため、こうした問題を抑えられ、プライバシーの保護にも役立ちます。
注: SLMは完璧ではありませんが、データセットが小規模で厳選されているため、機密性の高い業務や規制対象の業務では、より安全な選択肢になります。
アクセシビリティとAPIの利用しやすさ
AIツールには手軽にアクセスしたいものです。SLMは、利用方法やデプロイの方法の選択肢が広がります。多くの開発者が、SLMをローカルで実行することで、AIをより身近で手頃な価格で使えるようになると感じています。180人の開発者を対象とした調査では、SLMをローカルにデプロイすると、商用APIと比べてコストが33%削減されました。モデルを自分のハードウェア上で管理できれば、より多くの試行錯誤ができ、学習も早く進みます。
- 商用のLLM APIは高額になりがちで、応答も遅くなることがあります。また、プライバシー面の懸念も生じる可能性があります。
- オープンソースのモデルも存在しますが、セットアップにはある程度の技術的なスキルが必要です。
- SLMをローカルでホスティングすると、データとコストをより効果的に管理できます。
SLMを使えば、柔軟性と制御性が高まります。デプロイの方法、アクセスできるユーザー、データを安全に保つ方法を選べます。
ヒント: 実験をしながらコストを抑え、データも保護したいのであれば、SLMは現実的な選択肢になります。
実環境へのSLMのデプロイ
デプロイのオプション
組織でSmall Language Modelsをデプロイする方法はいくつかあります。ニーズとリソースに応じて最適な方法を選べます。多くのチームは、リアルタイム処理にエッジデバイスを利用しています。これらのデバイスではモデルをローカルで実行できるため、応答が速く、データも安全に保てます。クラウドへのデプロイは、拡張性と管理の容易さが特長です。大規模なワークロードを処理でき、モデルの更新も迅速に行えますが、遅延が発生する可能性があり、インターネット接続に依存します。
オンプレミスへのデプロイでは、機密情報を社内に留めておけます。インフラストラクチャを自社で管理でき、厳格なコンプライアンス要件にも対応できます。ハイブリッド構成では、ローカルリソースとクラウドリソースを組み合わせます。速度、プライバシー、拡張性のバランスを取ることができます。
主なデプロイのオプションを次の表にまとめます。
| デプロイのオプション | メリット | デメリット |
|---|---|---|
| エッジデプロイ | デバイス上でのリアルタイム処理 | 計算リソースが限られる |
| クラウドデプロイ | 拡張性が高く、効率的な管理が可能 | 遅延の可能性があり、インターネットに依存する |
| オンプレミス | 完全な制御とコンプライアンス対応 | セットアップと保守のコストが高くなる |
| ハイブリッド | 柔軟性とバランスの取れたパフォーマンス | 統合と管理が複雑 |
デプロイを計画する際は、ワークロードの範囲を特定し、データガバナンスを監査し、計算能力を測定し、想定されるユーザー負荷を見積もり、今後のロードマップも考慮してください。
ファインチューニングとカスタマイズ
ビジネスニーズに合わせてSmall Language Modelsをファインチューニングできます。ファインチューニングにより、モデルの振る舞いを調整し、タスクにおける精度を高められます。まずはデータの準備と整形から始めます。目的に合った最適なベースモデルを選択します。さらに、AIが最新の回答を返せるように、ライブのデータベースにモデルを接続します。
世界的な基準に適合させるため、個人情報のマスキングなどのセキュリティプロトコルを適用します。企業データにラベルを付け、ブランドの口調や技術的なプロセスに合うようモデルを学習させます。実際のシナリオでモデルをテストし、精度とバイアスを確認します。モデルをデプロイした後はパフォーマンスを監視し、必要に応じて再学習させます。
ある調査では、ファインチューニングされた小規模モデルが、はるかに低いコストで大規模モデルを上回る性能を示したことが分かりました。多くのリクエストを低コストで処理しながら、高い品質を実現できます。ファインチューニングにより、大規模モデルと同等の結果を、より低い費用と短い応答時間で得られます。
開発者ワークフローとの統合
AIツールを業務のワークフローにスムーズに組み込みたいところです。データ漏えいや、複雑なプロンプトエンジニアリング、高いリソース使用量といった課題に直面するかもしれません。これらは、プライベートデータセットと堅牢な評価プロトコルを使うことで解決できます。モデルをファインチューニングして不要な知識を減らし、意思決定の精度を高めましょう。
SLMを開発ツールと統合し、コード生成や文書分類などのタスクを自動化します。エッジデバイス上でモデルを動かせば、即座のフィードバックと安全な処理が得られます。パフォーマンスを監視し、ワークフローを効率的に保てるよう構成を調整しましょう。
ヒント: 小さなタスクから始め、自信がついたら徐々に適用範囲を広げましょう。信頼性が高く、高速で安全なAIソリューションを構築すれば、チームがより賢く働けるようになります。
オープンソースモデルとプロプライエタリモデルの比較
SLMを導入する際には、オープンソースかプロプライエタリかという重要な選択に直面します。それぞれに固有の利点と課題があります。これらの違いを理解することで、組織にとって最適な判断ができるようになります。
オープンソースのSLMは自由度と柔軟性を提供します。ソースコードにアクセスして変更し、ニーズに合わせてモデルを適応させることができます。このアプローチは、実験やカスタマイズ、AIツールの管理を行いたい場合に適しています。自社のハードウェア上でこれらのモデルを実行できるため、機密データを保護し、コンプライアンス要件を満たしやすくなります。透明性やコミュニティのサポートを重視して、オープンソースのSLMを選ぶ開発者も多くいます。
一方、プロプライエタリモデルは、モデルを構築・保守する企業から提供されます。洗練された製品と専門的なサポート、定期的なアップデートを受けられます。これらのモデルには、高度な機能、セキュリティパッチ、他のエンタープライズツールとの統合が含まれることが多くあります。すぐに使える状態で提供され、サービス契約も付くソリューションをお求めであれば、プロプライエタリモデルが適している可能性があります。
選択にあたっては、次の要素を検討する必要があります。
- カスタマイズ性: オープンソースモデルでは、特定のタスクに合わせてファインチューニングし、AIを適応させることができます。プロプライエタリモデルでは、中核システムの変更が制限される場合があります。
- コスト: オープンソースモデルは通常ライセンス料がかかりません。必要になるのはハードウェアと保守のコストのみです。プロプライエタリモデルは、サブスクリプションや従量課金が必要になることが多くあります。
- サポート: プロプライエタリモデルでは、専任のサポートとドキュメントが提供されます。オープンソースモデルは、コミュニティフォーラムや共有リソースに依存します。
- セキュリティとコンプライアンス: どちらの選択肢も高いセキュリティ基準を満たすことができますが、オープンソースモデルはデータの取り扱いをより細かく管理できます。
次の表で2つの選択肢を比較できます。
| 項目 | オープンソースSLM | プロプライエタリSLM |
|---|---|---|
| カスタマイズ性 | 高い | 中程度から低い |
| コスト | ハードウェアと保守のみ | サブスクリプションまたは従量課金 |
| サポート | コミュニティ主導 | 専任のプロフェッショナルサポート |
| アップデート | コミュニティによる貢献 | 定期的、ベンダー主導 |
| データ管理 | 完全(ローカル配置が可能) | ベンダーによって異なる |
Stanford HAIの最近の研究によると、特化型SLMは限定された領域において85~97%の精度に達することが示されています。これは、多くの汎用大規模モデルを上回る水準です。ビジネスに合わせてモデルを調整すれば、この性能を活用できます。SLMは経済的な利点も導入を後押ししており、高コストをかけずに高品質な結果を得られます。現在では多くの企業が、汎用的なソリューションではなく特定のタスク向けに設計されたモデルに注目し、オープンソースとプロプライエタリの両方を採用しています。
ヒント: まずはビジネスゴールから考えましょう。柔軟性と管理性が必要であれば、オープンソースのSLMが最適かもしれません。信頼性とサポートを重視するなら、プロプライエタリの選択肢を検討しましょう。両方を組み合わせて、それぞれの長所を活かすこともできます。
小規模言語モデルの将来
SLM開発の動向
小規模言語モデル(SLM)は、多くの業界で急速に広がっています。企業は、性能が高く、コストを抑えられ、データを安全に保てるAIを求めています。現在、SLMは医療、金融、製造業のスマートツールを支えています。以下の表で、地域や業界ごとのSLMの活用状況をご確認いただけます。
| セグメント | 洞察 |
|---|---|
| 医療 | SLMは、チャットボットやアシスタントを通じて患者との関わりやコミュニケーションを支援します。 |
| 米国市場の動向 | 米国はSLMの活用で先行しており、Microsoftをはじめとする企業が新しいモデルの開発を推進しています。 |
| 欧州の動向 | 欧州では倫理的なAIに重点が置かれており、カスタマーサポートやコンテンツ作成にSLMが活用されています。 |
| アジア太平洋地域の動向 | 企業が効率的な言語ツールを求めるなかで、多くの業界で急速に成長しています。 |
SLMを形作る新しい動向が見られます。開発者は、パラメーター効率の良いファインチューニング(PEFT)や知識蒸留を使い、大規模なコンピューターを必要とせずにモデルの性能を高めています。量子化されたモデルはエッジデバイスでも動作するようになり、小型のハードウェアでも素早い回答が得られます。SLMは多くの分野で自動化や予測インサイトを支えています。用途に合ったモデルを、必要な場所で使えるメリットがあります。
| 動向の種類 | 説明 |
|---|---|
| 主要なイノベーションの動向 | PEFTと知識蒸留によって、SLMは効率的で適応しやすくなっています。 |
| 業界での採用 | SLMは製造、金融、サイバーセキュリティにおける自動化を推進しています。 |
| 推進要因 | 高速で低計算量のAIへの需要が、SLMの採用を後押ししています。 |
| 機会 | ヘルスケアや金融向けに調整されたSLMは、精度とコンプライアンスを向上させます。 |
| 課題 | 精度と効率のバランスは、開発者にとって引き続き重要な課題です。 |
機能の拡張
SLMは単純なタスクしか扱えないと思われるかもしれませんが、その状況は変わりつつあります。最近の研究では、かつて大規模言語モデルが担っていた複雑な作業もSLMで扱えることが示されています。たとえば、SLMは画像やテキストを処理し、ロボットが周囲の環境を理解する手助けもできます。文書分析、視覚と言語の統合的な理解、リアルタイムの意思決定といったタスクでは、SLMが大規模モデルと連携して動作している例も見られます。
| 研究 | 貢献 |
|---|---|
| 協調のメカニズム | マルチモーダルシステムでは、SLMが下位レベルのタスクを担当し、AIをより効率的にしています。 |
| LLM蒸留 | SLMは大規模モデルから学習し、特定分野でのマルチタスク学習を実行します。 |
| VITA-1.5モデル | SLMは特定のデータ型を処理してから、より大規模なモデルに情報を送ります。 |
| 長文コンテキストのビジョン | SLMは、長い文書や画像に含まれる視覚情報を管理します。 |
| 身体性エージェントシステム | SLMはロボティクスで活用され、実世界の環境で機械が動作することを支援します。 |
| クラウドとエッジの連携 | SLMは企業環境で特化したタスクを処理し、コストと遅延を抑えます。 |
| エンタープライズ向けSLMソリューション | 多くの業務タスクにおいて、SLMは大規模モデルと同等の性能を発揮するようになっています。 |
SLMが新たな課題に対応できるようになるにつれ、得られる価値も大きくなります。これらのモデルは、マルチタスクへの対応、さまざまな種類のデータの扱い、迅速な結果の提供を実現しています。
Microsoft Phiの役割
SLMの革新を牽引しているのが、Microsoftの Phi ファミリーです。専門家は、Phi-4-miniのようなPhiモデルがエッジデバイスでうまく動作すると指摘しています。インターネット接続が不安定な場所や、厳格なプライバシー要件がある環境でも利用できます。これらのモデルは、製造、ヘルスケア、小売りの効率向上に役立ちます。Phi-4-miniとPhi-4-multimodalは必要な計算リソースが少なく、コストを抑えつつ、より速く結果を得られます。また、長いコンテキストウィンドウにより、大規模な文書やデータセットも容易に分析できます。
"言語モデルは強力な推論エンジンであり、Phiのような小規模言語モデルをWindowsに統合することで、効率的な計算能力を維持しつつ、すべてのアプリやエクスペリエンスに継続的なインテリジェンスを組み込む未来が開かれます。Copilot+ PCは、Phi-4-multimodalの機能を基盤とし、エネルギー消費を抑えながらMicrosoftの高度なSLMの能力を提供します。この統合により、生産性、創造性、教育向けの体験が強化され、当社の開発者プラットフォームの標準的な一部になります。" —Vivek Pradeep、Windows Applied Sciences担当 Vice President Distinguished Engineer
Microsoft Phiは、SLMの新たな活用方法を今後も生み出し続けるでしょう。これらのモデルが日々のツールの一部になるにつれ、働く場所のあらゆるところで、より賢く、より速く、より安全なAIが広がっていくはずです。
Small Language Models(SLM)、たとえばMicrosoftのPhiファミリーは、Copilotの最大の弱点を解決します。これらのモデルには次の利点があります。
- 専門的なタスクにおける高い精度と、エラーのリスクの低さ
- リアルタイムの回答に向けた高速な処理と低いレイテンシー
- オンプレミス展開による強力なプライバシー保護
- コストの低減と、高価なハードウェアの必要性の軽減
SLMを使えば、カスタマーサポートの自動化、チケットの分類、規制関連文書の効率的な処理が可能になります。また、AIがまもなく労働力に加わり、産業を変革すると専門家は予測しています。自社のビジネスでSLMの導入を検討し、次に来るAIイノベーションの波に備えておくとよいでしょう。
よくある質問
Small Language Model(SLM)とは何ですか?
Small Language Modelは、大規模モデルより少ないパラメーターを使用します。SLMはローカルデバイス上で実行できます。メールの要約や文書の分類など、特定のタスクに対して、高速で正確な結果を提供します。
Microsoft の Phi ファミリーはどのようにプライバシーを向上させますか?
Phiモデルをローカルに展開します。データは組織内にとどまります。アクセスを管理し、コンプライアンス要件を満たすことができます。Phiモデルは機密情報の保護に役立ち、プライバシーリスクを低減します。
高価なハードウェアがなくてもSLMを使えますか?
はい。Phi-3 MiniのようなSLMは、一般的なパソコンやサーバーで実行できます。高価なクラウドGPUを使う必要がありません。SLMは最小限のリソースで効率的に動作するため、チーム全体でAIを利用しやすくなります。
SLMはコードの提案における幻覚(ハルシネーション)をどのように減らしますか?
SLMは、目的を絞った学習と最適化を行います。存在しないパッケージが提案されることが減り、より信頼性の高い回答が得られます。Phiモデルは精度を重視しており、AIが生成したコードを信頼しやすくします。
SLMはMicrosoft 365で何のタスクを処理できますか?
SLMを使って、メールの要約、アクション項目の抽出、文書の分類、定型業務の自動化を行えます。SLMは生産性を高め、日常の業務フローの中で迅速かつ正確な結果を提供します。
SLMは規制の厳しい業界に適していますか?
はい。データを安全に保つため、SLMをローカルに展開します。医療、金融、法務のチームは、厳格なプライバシーおよびコンプライアンス基準を満たすためにSLMを使用しています。機密情報の管理を維持できます。
SLMはAIのコスト削減にどのように役立ちますか?
自社運用の展開では、必要になるのはハードウェアのコストだけです。継続的なトークン料金を支払う必要がありません。大規模モデルと比べて、AIソリューションを手頃な価格で拡張でき、大幅なコスト削減を実現できます。
🎧 このエピソードを聴く
「Faster, Cheaper Enterprise AI」のためのSmall Language Modelsについて、実践的な解説を聴きたいですか?このエピソードでは、このトピックを分かりやすく解説し、Microsoft 365、Azure、Power Platform、セキュリティ、AI、そしてモダンワークにとってなぜ重要なのかを紹介します。
次のような方は、このエピソードを聴いてください:
- 「Faster, Cheaper Enterprise AI」に関するSmall Language Modelsの基本的な概念を理解する
- Microsoftの技術エコシステム全体の中で、どのような位置づけになるかを知る
- 組織において実践的な価値を生み出せる場面を把握する
あわせて楽しめる関連のM365 FMエピソード:
- データからインテリジェント エージェントへ: Microsoft AI Foundry で信頼できるエンタープライズ AI を構築 (Shubhangi Goyal [MVP])
- 2026 年の Azure DevOps: エンタープライズ AI を支える縁の下の力持ち
- Power Apps におけるエンタープライズ向け AI エクスペリエンス (Sara Lagerquist [MVP])
- Microsoft Graph: エンタープライズの神経系
- Graph 搭載 AI エージェント: エンタープライズ アーキテクチャ ガイド
M365 FMでは、Microsoftに関する実践的な話題をさらに見つけられます。
最終レビュー日:2026年7月。
対象読者
このエピソードは、導入、運用、ガバナンスに関する判断を下す前に実践的な基礎知識を必要としている、Microsoft 管理者、アーキテクト、開発者、セキュリティ担当者、ビジネス リーダーの方々を対象としています。
🎧 あわせて聴きたいエピソード
- AI エージェント — このトピックを発展させるうえで、関連性の高い次のステップです。
- Power Platform — このトピックを発展させるうえで、関連性の高い次のステップです。
- Microsoft Graph Data Connect — このトピックを発展させるうえで、関連性の高い次のステップです。