 RU
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Українська
 العربية
 עברית
 日本語
 한국어
Исправляем недостатки Copilot с помощью малых языковых моделей
By Mirko Peters ·
Добро пожаловать обратно в блог-сопровождение подкаста! В этом посте мы подробно разберём технологический сдвиг, который меняет подход корпоративных организаций к искусственному интеллекту.
Automatically translated with AI from the original post. Read the English original
Добро пожаловать обратно в блог-сопровождение подкаста! В этом посте мы подробно разберём технологический сдвиг, который меняет подход корпоративных организаций к искусственному интеллекту. Если вы когда-либо пользовались ИИ-ассистентом для программирования или инструментом для повышения продуктивности, таким как Microsoft Copilot, то наверняка сталкивались с его время от времени ошибками: выдуманными названиями пакетов, неожиданным раскрытием данных или медленными ответами, которые тормозят работу. Большие языковые модели (LLM) мощны, но они не всегда подходят для каждой задачи, особенно внутри защищённых корпоративных сред.
К счастью, происходит масштабный сдвиг. Появление малых языковых моделей (SLM) меняет правила игры: они предлагают узкоспециализированные, экономичные и безопасные альтернативы, которые устраняют ключевые недостатки massive LLM. Чтобы получить полный разбор того, как эти модели работают в реальных средах Microsoft, обязательно послушайте соответствующий эпизод подкаста Small Language Models for Faster, Cheaper Enterprise AI.
Главный недостаток Copilot
Основная слабость: объяснение
Вы ждёте, что Copilot поможет работать быстрее и умнее, но ему часто не хватает точности и соблюдения конфиденциальности. Copilot использует большие языковые модели для генерации ответов, однако эти модели иногда искажают информацию или придумывают детали. Вы можете получить убедительно звучащие ответы, которые на деле неполны или даже неверны. Это происходит потому, что модели не всегда понимают контекст или данные, которые используют. Приходится перепроверять факты и проверять ссылки на источники, что замедляет работу.
Конфиденциальность — ещё одна серьёзная проблема. Copilot подключается к вашим бизнес-данным и использует ваши разрешения для доступа к информации. Если у вас или вашей команды слишком много разрешений, Copilot может извлечь конфиденциальные данные без предупреждения. Например, сотрудник с широким доступом может попросить Copilot показать конфиденциальные сведения, такие как зарплаты или результаты аттестаций. Злоумышленники, получившие доступ к таким учётным записям, могут спровоцировать серьёзные утечки данных. Модели не всегда наследуют метки конфиденциальности, поэтому чувствительная информация может передаваться без должной классификации.
Ниже приведена таблица с наиболее распространёнными уязвимостями безопасности Copilot:
| Уязвимость безопасности | Описание |
|---|---|
| Уязвимость EchoLeak | Атака без взаимодействия с пользователем (zero-click), которая использует Copilot для извлечения конфиденциальных данных из подключённых источников M365. |
| Инъекция промптов в масштабе | Вредоносные инструкции, скрытые в содержимом, могут заставить Copilot извлекать и передавать данные. |
| Ошибки конфигурации агентов Copilot | Неправильно настроенные агенты могут раскрывать данные, работать с избыточными привилегиями или хранить учётные данные. |
| Чрезмерно широкий доступ к данным | Copilot может получить доступ ко всему, к чему имеет доступ пользователь, что создаёт риск избыточного открытия доступа к конфиденциальным бизнес-данным. |
| Проблемы наследования меток конфиденциальности | Результаты Copilot могут не наследовать метки конфиденциальности, что приводит к неклассифицированным и ненадлежащим образом передаваемым данным. |
Влияние на разработчиков и команды
Когда вы используете Copilot, вы хотите получать надёжную помощь. Вместо этого вам часто приходится проверять и исправлять его результаты. Эта дополнительная работа может замедлить ваши проекты. Разработчики могут утратить доверие к моделям, если видят слишком много ошибок или рисков для конфиденциальности. Командам приходится тратить больше времени на поиск ошибок и на то, чтобы конфиденциальные данные не утекли. Может также понадобиться обучить команду выявлять и устранять такие проблемы, что требует времени и ресурсов.
Модели могут усиливать слабые практики защиты данных. Если организация не управляет разрешениями внимательно, Copilot может ухудшить ситуацию, открывая больше данных, чем вы ожидаете. Нужно устанавливать строгие средства контроля доступа и отслеживать, как модели взаимодействуют с вашими бизнес-данными.
Последствия в реальном мире
Последствия этих недостатков видны в реальных ситуациях. Конгресс США запретил своим сотрудникам использовать Copilot из-за опасений утечки данных. Руководители опасались, что конфиденциальные государственные данные могут утечь в несанкционированные облачные сервисы. В другом случае исследователи нашли способ с помощью prompt injection и эксплуатации инструментов украсть персональные данные через Copilot. Эти инциденты показывают, что риски не теоретические.
Если вы полагаетесь на модели, которые не защищают ваши данные и не дают точных ответов, вы сталкиваетесь с реальными бизнес-рисками. Конфиденциальная информация может утечь, а ваша команда может тратить время на исправление ошибок. Вам нужны модели, которые обеспечивают и точность, и конфиденциальность, чтобы ваша работа оставалась безопасной и эффективной.
Революция SLM в ИИ
Что такое малые языковые модели?
Возможно, вы слышали о революции SLM, но что она значит для вас? Малые языковые модели – это новый тип ИИ, ориентированный на эффективность и точность. Такие модели используют меньше ресурсов, чем традиционные системы. Их можно запускать на обычных компьютерах или даже на собственных серверах. Это упрощает их внедрение на рабочем месте. Малые языковые модели помогают выполнять такие задачи, как суммаризация писем, извлечение ключевых моментов из собраний и классификация документов. Вы получаете быстрые ответы, не ожидая облачных серверов. Революция SLM даёт вам больше контроля над данными и рабочими процессами.
SLM и большие языковые модели
Вы можете задаться вопросом, чем малые языковые модели отличаются от больших. Главное различие – в размере и направленности. Большие языковые модели требуют дорогостоящего оборудования и часто работают в облаке. Малые языковые модели работают на локальных машинах и потребляют меньше энергии. Различия можно увидеть в таблице ниже:
| Характеристика | Малые языковые модели (SLM) | Большие языковые модели (LLM) |
|---|---|---|
| Эффективность | Обучаются и работают на стандартном оборудовании | Требуют дорогостоящих облачных GPU |
| Развёртывание | Локально, для повышенной конфиденциальности | Чаще всего в облаке |
| Экономическая эффективность | Ниже эксплуатационные расходы | Выше эксплуатационные расходы |
| Производительность | Быстрый вывод при небольшом объёме ресурсов | Медленнее из-за большего размера |
| Снижение галлюцинаций | Дообучены на специфических наборах данных для надёжных результатов | Более склонны к галлюцинациям |
| Сценарии использования | Адаптированы под конкретные задачи в SDLC | Универсальные приложения |
| Безопасность | Конфиденциальные данные остаются внутри организации | Данные могут быть раскрыты во внешней среде |
Видно, что SLM дают скорость, конфиденциальность и экономию. Вам не нужно полагаться на внешние серверы. Ваша конфиденциальная информация остаётся в безопасности.
Почему революция SLM важна
Революция SLM меняет то, как вы используете ИИ на работе. Теперь вы можете развёртывать модели, которые соответствуют вашим потребностям и защищают данные. Многие организации выбирают SLM, потому что они поддерживают соответствие таким правилам, как HIPAA и GDPR. Вы можете обрабатывать информацию локально и не отправлять данные в облако. Это помогает соблюдать строгие стандарты безопасности. Революция SLM также повышает продуктивность. Вы получаете ответы в реальном времени и можете отслеживать соответствие требованиям во время работы. Вам не нужно беспокоиться о медленных ответах или высоких расходах. Революция SLM даёт вам контроль над инструментами ИИ и данными бизнеса.
Примечание: революция SLM – это не только технологии. Это возможность использовать ИИ безопасно, быстро и эффективно.
Как малые языковые модели устраняют недостаток Copilot
Снижение галлюцинаций
Вы хотите, чтобы инструменты ИИ давали надёжные ответы. Малые языковые модели помогают достичь этой цели. Эти модели ориентированы на точность и контекст. Они используют целевые обучающие данные и методы оптимизации, чтобы снизить количество галлюцинаций. Вы видите меньше выдуманных пакетов и более надёжные предложения кода. Когда вы используете модели семейства Microsoft Phi, вы получаете генерацию кода с приоритетом безопасности. Это значит, что ваш код остаётся чистым и безопасным.
Малые языковые модели отлично справляются с приложениями реального времени. Их можно использовать для интеллектуального рефакторинга и автоматизированного анализа требований. Они помогают оптимизировать код и избегать ошибок. Вы замечаете прирост производительности, потому что модели выдают эффективные и быстрые результаты. Вы тратите меньше времени на исправление ошибок и больше на создание решений.
Повышение конфиденциальности и контроля над данными
Вам важны безопасность и конфиденциальность. Малые языковые модели дают вам контроль над данными. Вы можете развернуть эти модели на собственных устройствах или серверах. Такая возможность работать на устройстве сохраняет конфиденциальную информацию внутри организации. Не нужно отправлять данные во внешние облачные сервисы. Вы защищаете бизнес и соответствуете требованиям комплаенса.
С малыми языковыми моделями вы управляете разрешениями и доступом. Вы решаете, кто может использовать модели и какие данные они могут видеть. Такой подход поддерживает проактивный анализ журналов и автоматизированное реагирование на инциденты. Вы отслеживаете активность и быстро реагируете на угрозы. Вы сохраняете безопасность приложений и конфиденциальность данных.
Малые языковые модели поддерживают оптимизацию с точки зрения безопасности. Их можно использовать для мониторинга производительности в реальном времени. Они помогают классифицировать документы и извлекать задачи без раскрытия конфиденциальной информации. Вы спокойны, зная, что ваши данные в безопасности.
Снижение затрат и потребности в ресурсах
Вы хотите оптимизировать бюджет и ресурсы. Малые языковые модели отличаются высокой эффективностью и низкой задержкой. Их можно запускать на стандартном оборудовании. Не нужны дорогие облачные GPU или большая инфраструктура. Это снижает ваши операционные расходы и делает ИИ доступнее для большего числа команд.
Ознакомьтесь с таблицей сравнения стоимости ниже. Вы видите, как малые языковые модели, например Phi-3 Mini, экономят деньги по сравнению с большими моделями:
| Модель | Стоимость входных данных ($/млн токенов) | Стоимость выходных данных ($/млн токенов) |
|---|---|---|
| GPT-5.5 | $5.00 | $15.00 |
| Claude Sonnet 4.6 | $3.00 | $15.00 |
| Gemini 3.1 Pro | $3.50 | $10.50 |
| Mistral 7B (через API) | $0.20 | $0.20 |
| Llama 3.1 8B (через API) | $0.18 | $0.18 |
| Phi-3 Mini (собственный хостинг) | Только стоимость оборудования | Только стоимость оборудования |
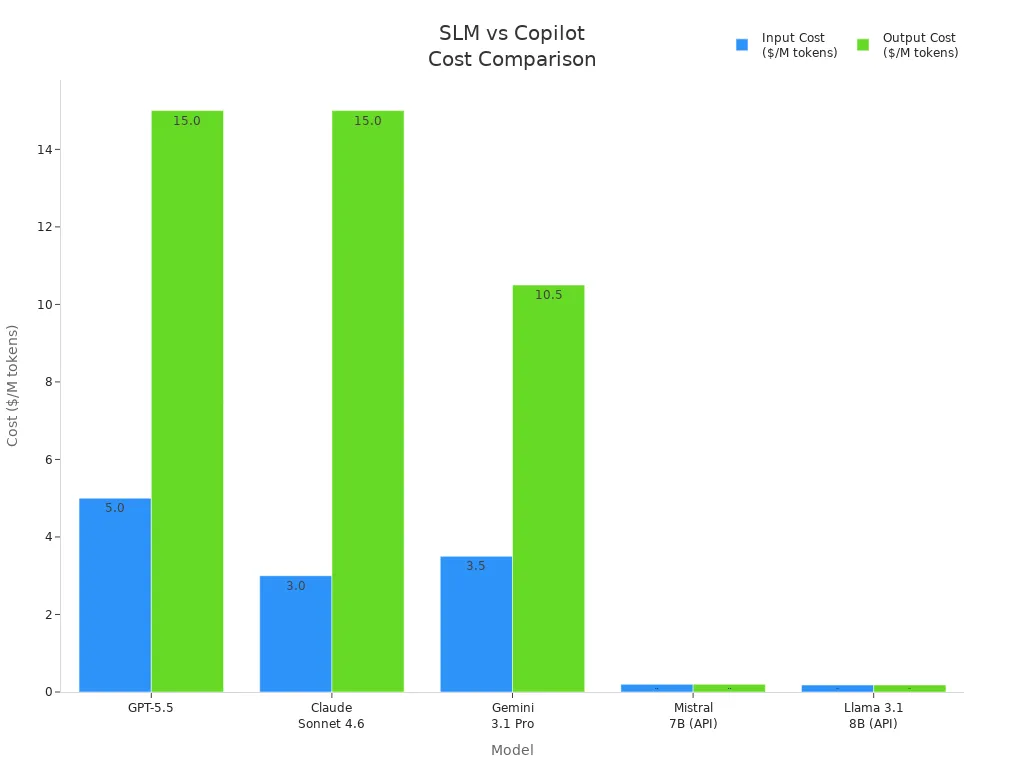
Вы видите, что Phi-3 Mini требует только затрат на оборудование. Вы избегаете постоянной платы за токены. Такая оптимизация позволяет масштабировать приложения, не беспокоясь о росте расходов. Вы добиваетесь эффективности работы с данными и высокой отзывчивости. Ваши приложения работают с низкой задержкой и в режиме реального времени.
Малые языковые модели поддерживают оптимизацию для множества задач. Вы используете их для рефакторинга, генерации кода и классификации документов. Производительность соответствует вашим потребностям. Вы можете развертывать модели локально и сохранять безопасность. Вы создаёте приложения, которые приносят пользу и укладываются в бюджет.
Совет: малые языковые модели помогают оптимизировать рабочий процесс. Вы получаете скорость, конфиденциальность и экономию средств. Вы можете сосредоточиться на создании отличных приложений и повышении производительности команды.
Скорость и отзывчивость
Вы ждёте, что ваши ИИ-инструменты будут отвечать быстро. Медленные ответы нарушают рабочий процесс и отнимают время. Малые языковые модели, такие как семейство Phi от Microsoft, дают быстрые результаты. Ответы приходят за миллисекунды, а не за секунды. Такая скорость помогает оставаться сосредоточенным и продуктивным.
Вы можете запускать SLM на собственных устройствах или серверах. Не нужно ждать облачной обработки. Ваши запросы остаются локальными, поэтому вы сразу получаете отклик. Это важно для мобильных сотрудников и команд, работающих на выезде. Вы получаете доступ к информации именно тогда, когда она нужна.
Модели семейства Phi используют эффективные алгоритмы. Они обрабатывают задачи с минимальной задержкой. Разницу вы заметите, когда будете суммировать письма, извлекать задачи или классифицировать документы. Ваша команда сможет выполнить больше задач за меньшее время.
Совет: быстрые ответы ИИ означают, что вы меньше ждёте и больше времени тратите на создание ценности.
Ниже таблица, показывающая, как SLM сравниваются с большими моделями по времени отклика:
| Тип модели | Среднее время отклика |
|---|---|
| Большая языковая модель | 2–5 секунд |
| Малая языковая модель (Phi) | < 0,5 секунды |
Вы видите, что SLM дают ответы почти мгновенно. Такая скорость улучшает ваш опыт и помогает проектам двигаться дальше.
Вы также получаете надёжность. Быстрые ответы означают меньше перерывов. Ваши приложения работают плавно. Вы можете доверять ИИ-инструментам, которые успевают за вашим темпом.
Малые языковые модели помогают создавать отзывчивые приложения. Их можно встроить в рабочий процесс. Ваша команда получает аналитику в реальном времени и быстрее принимает решения.
Примечание: скорость и отзывчивость — это не просто технические характеристики. Именно они делают ИИ полезным в вашей повседневной работе.
Корпоративные преимущества SLM
Экономия на практике
Вы хотите увидеть реальную экономию, когда инвестируете в инструменты ИИ. Малые языковые модели обеспечивают впечатляющую оптимизацию затрат для предприятий. Многие компании заменили более крупные модели меньшими, которые обходятся в от 5 до 150 раз дешевле. Вы можете добиться лучших результатов в конкретных задачах, не платя высокие тарифы за облачную обработку. В таблице ниже показано, как крупные организации получают выгоду от SLM:
| Компания | Тип модели | Снижение затрат | Сравнение производительности |
|---|---|---|---|
| Checkr | 7B–14B параметров | в 5–150 раз меньше | Лучшие результаты |
| NVIDIA | 7B–14B параметров | в 5–150 раз меньше | Лучшие результаты |
| Bayer | 7B–14B параметров | в 5–150 раз меньше | Лучшие результаты |
| DoorDash | 7B–14B параметров | в 5–150 раз меньше | Лучшие результаты |
Вы можете сократить общие расходы на ИИ на 85–95% по сравнению с традиционными решениями на основе больших моделей. Это позволяет масштабировать операции и инвестировать в другие направления бизнеса.
Локальное развертывание и суверенитет данных
Вам необходимо защищать данные и соблюдать требования соответствия. SLM позволяют развертывать ИИ локально, сохраняя конфиденциальную информацию внутри организации. Регулируемые отрасли, такие как здравоохранение, финансы и юриспруденция, предпочитают локальные решения, поскольку они обеспечивают строгую безопасность и конфиденциальность. Вы избегаете передачи данных на внешние серверы, что снижает риск утечек и поддерживает соблюдение нормативных стандартов.
- Локальное развертывание гарантирует отсутствие передачи данных на внешние серверы.
- Вы можете дообучать модели на собственных данных, делая решения ИИ прозрачными и соответствующими требованиям.
- Государства и организации инвестируют в суверенные решения ИИ, чтобы контролировать свою информацию и укреплять региональную устойчивость.
Гибридные подходы также помогают сбалансировать локальную обработку конфиденциальных данных с облачной обработкой для масштабируемости и точности. Вы получаете гибкость, сохраняя контроль.
Повышение продуктивности в Microsoft 365
Вы хотите, чтобы ваша команда работала быстрее и эффективнее. SLM, интегрированные в Microsoft 365, повышают продуктивность, обеспечивая быстрые ответы и точные результаты. Задержка вывода снижается до 50–150 миллисекунд против 200–1 000 миллисекунд у более крупных моделей. Сотрудники получают мгновенные ответы при обобщении писем, извлечении задач и классификации документов.
- Специализированные SLM достигают точности 85–97% в узких предметных областях, превосходя универсальные модели.
- Обработка на устройстве обеспечивает плавность работы и безопасность.
- Вы сокращаете потребность в технической поддержке и поддерживаете соответствие требованиям в процессе работы.
Вы также помогаете окружающей среде. Обучение SLM создает значительно меньший углеродный след, часто от 2 до 50 тонн CO2-эквивалента, тогда как для крупных моделей это может превышать 500 тонн. Вы делаете бизнес более устойчивым и эффективным.
Совет: SLM дают возможность оптимизировать затраты, защищать данные и повышать продуктивность — и всё это в рамках вашей существующей среды Microsoft 365.
Сценарии использования: семейство Phi на практике
Вы хотите увидеть, как малые языковые модели работают в реальных бизнес-ситуациях. Семейство Phi предлагает практические решения, которые помогают справляться с повседневными задачами. Вы можете использовать эти модели для улучшения коммуникации, повышения продуктивности и поддержки команды во многих направлениях.
Ниже приведены примеры того, как вы можете использовать семейство Phi в своей организации:
Многоязычные чат-боты для поддержки клиентов
С Phi-3.5 вы можете создавать чат-боты, которые отвечают на вопросы клиентов на многих языках. Это позволяет обслуживать клиентов из разных стран без найма дополнительного персонала. Ваша служба поддержки работает эффективнее, а клиенты получают помощь быстрее.Генерация многоязычного контента
Вы можете автоматизировать создание маркетингового контента для разных регионов. Phi-3.5 помогает писать рекламные тексты, электронные письма и публикации для социальных сетей на нескольких языках. Так ваш бренд становится ближе людям из разных культур. Вы охватываете больше клиентов и развиваете бизнес.Перевод и суммаризация документов
Вы можете использовать Phi-3.5 для перевода и суммаризации длинных или сложных документов. Это полезно, если вы работаете в сфере права, образования или исследований. Вы экономите время, получая понятные резюме и точные переводы. Ваша команда может сосредоточиться на важных задачах, а не на рутинной работе вручную.
Совет: Вы можете комбинировать эти сценарии, чтобы получить еще большую пользу. Например, вы можете перевести отзывы клиентов, сделать их краткое изложение и использовать результаты для улучшения продуктов.
Для использования семейства Phi не нужно специальное оборудование или облачные сервисы. Вы можете запускать эти модели на собственных серверах или устройствах. Это защищает ваши данные и помогает соответствовать требованиям к конфиденциальности. Вы контролируете, куда попадает ваша информация и кто имеет к ней доступ.
Вы также получаете выигрыш в скорости. Семейство Phi выдает ответы за миллисекунды. Вашей команде не нужно ждать медленных ответов из облака. Это делает рабочий процесс более плавным и помогает держать проекты на плаву.
Семейство Phi подходит для многих отраслей. Работаете ли вы в сфере клиентской поддержки, маркетинга, права или образования, вы найдете способы использовать эти модели каждый день. Вы помогаете команде работать умнее и добиваться лучших результатов.
Примечание: Семейство малых языковых моделей Phi даёт вам инструменты для решения реальных задач. Можно начать с малого и масштабироваться по мере роста потребностей.
Компромиссы и ограничения
Область применения и специализация
Малые языковые модели (SLM) дают скорость и конфиденциальность, но важно знать их ограничения. SLM сосредоточены на конкретных задачах и предметных областях. Они охватывают меньше, чем большие языковые модели (LLM). Вы можете заметить следующие различия:
- В SLM базы знаний меньше, чем у LLM.
- Иногда они дают расплывчатые ответы на открытые или незнакомые темы.
- SLM могут испытывать трудности с длинными документами или сложными рассуждениями.
- Качество может быть менее стабильным в длинных текстах или при переходе между темами.
- SLM хуже обобщают знания, поэтому могут показывать более слабые результаты в новых задачах или задачах на стыке областей.
Если вам нужна модель для широких открытых вопросов, SLM не всегда подойдут. Но для узконаправленных задач они показывают отличные результаты.
Предвзятость и размер датасета
Вам нужны справедливые и точные результаты от ИИ. SLM и LLM по-разному работают с предвзятостью и объемом данных. SLM используют меньшие, тщательно отобранные датасеты. Это помогает снизить предвзятость и сохранить конфиденциальность ваших данных. LLM обучаются на огромных открытых датасетах, которые могут привнести нежелательную предвзятость или ошибки.
Ниже таблица, показывающая сравнение SLM и LLM:
| Аспект | SLM | LLM |
|---|---|---|
| Риск предвзятости | Ниже благодаря меньшим, отобранным датасетам | Выше из-за обучения на сырых и разнородных данных |
| Обучающие данные | Специализированные, отобранные | Открыто доступные, потенциально предвзятые данные |
| Архитектура модели | Менее сложная, что снижает риск предвзятости | Более сложная, может непреднамеренно закреплять предвзятость |
| Производительность в задачах | Эффективны в специализированных областях | Сильны в задачах открытой тематики, но могут допускать фактические ошибки |
LLM иногда допускают фактические ошибки или воспроизводят предвзятость из обучающих данных. SLM, благодаря целевому обучению, помогают избежать этих проблем и защищают вашу конфиденциальность.
Примечание: SLM не идеальны, но их меньшие, тщательно отобранные датасеты делают их более безопасным выбором для чувствительных или регулируемых задач.
Доступность и доступность API
Вам нужен простой доступ к инструментам ИИ. SLM дают больше вариантов того, как вы их используете и развертываете. Многие разработчики считают, что локальный запуск SLM делает ИИ доступнее и дешевле. В исследовании с участием 180 разработчиков локальное развертывание SLM сократило расходы на 33% по сравнению с коммерческими API. Когда вы контролируете модель на собственном оборудовании, вы можете больше экспериментировать и быстрее учиться.
- Коммерческие API LLM могут быть дорогими и медленными, а также вызывать вопросы о конфиденциальности.
- Открытые модели существуют, но для их настройки нужны определенные технические навыки.
- Локальное размещение SLM позволяет эффективнее управлять данными и расходами.
SLM дают больше гибкости и контроля. Вы сами выбираете, как их развернуть, кто может получить к ним доступ и как защитить свои данные.
Совет: если вы хотите экспериментировать, экономить и защищать данные, SLM — практичный путь вперед.
Развертывание SLM на практике
Варианты развертывания
В вашей организации есть несколько способов развернуть небольшие языковые модели. Вы можете выбрать наиболее подходящий вариант, исходя из своих потребностей и ресурсов. Многие команды используют периферийные устройства для обработки в реальном времени. Такие устройства позволяют запускать модели локально, поэтому вы получаете быстрые ответы и сохраняете данные в безопасности. Облачное развертывание даёт масштабируемость и простое управление. Вы можете обрабатывать большие нагрузки и быстро обновлять модели, но при этом можете столкнуться с задержками и зависимостью от доступа в интернет.
Локальное развертывание (on-premises) сохраняет конфиденциальную информацию внутри компании. Вы контролируете инфраструктуру и соблюдаете строгие требования соответствия. Гибридные конфигурации сочетают локальные и облачные ресурсы. Вы балансируете между скоростью, конфиденциальностью и масштабируемостью.
Ниже приведена таблица с основными вариантами развертывания:
| Вариант развертывания | Преимущества | Недостатки |
|---|---|---|
| Периферийное развертывание | Обработка в реальном времени на устройствах | Ограниченные вычислительные ресурсы |
| Облачное развертывание | Масштабируемость и эффективное управление | Возможные задержки и зависимость от интернета |
| On-premises | Полный контроль и соответствие требованиям | Более высокие затраты на настройку и обслуживание |
| Гибридное развертывание | Гибкость и сбалансированная производительность | Сложность интеграции и управления |
Планируя развертывание, определите границы рабочих нагрузок, проверьте управление данными, оцените вычислительную мощность, спрогнозируйте нагрузку на пользователей и учтите свой план развития на перспективу.
Тонкая настройка и адаптация
Вы можете дообучить небольшие языковые модели под потребности своего бизнеса. Тонкая настройка позволяет корректировать поведение модели и повышать точность для ваших задач. Начинаете вы с подготовки и очистки данных. Затем выбираете наиболее подходящую базовую модель для своих целей. Подключаете модель к актуальным базам данных, чтобы ваш ИИ давал ответы на основе свежих данных.
Вы применяете протоколы безопасности, например маскирование персональных данных, чтобы соответствовать глобальным стандартам. Вы маркируете корпоративные данные и обучаете модель соответствовать голосу вашего бренда и техническим процессам. Вы тестируете модель в реальных сценариях, чтобы проверить точность и отсутствие предвзятости. Затем вы развертываете модель, отслеживаете её работу и при необходимости переобучаете.
Исследование показало, что дообученная небольшая модель может превосходить более крупные модели при значительно меньших затратах. Вы можете недорого обрабатывать множество запросов и добиваться высокого качества. Тонкая настройка помогает получить те же результаты, что и у более крупных моделей, но с меньшими расходами и более быстрым откликом.
Интеграция с рабочими процессами разработчиков
Вы хотите, чтобы инструменты ИИ плавно вписывались в ваш рабочий процесс. Вас могут ожидать такие проблемы, как утечка данных, сложный prompt engineering и высокое потребление ресурсов. Решить их помогает использование закрытых наборов данных и надежных протоколов оценки. Вы дообучаете модели, чтобы уменьшить ненужные знания и улучшить принятие решений.
Вы интегрируете SLM с инструментами разработки и автоматизируете такие задачи, как генерация кода и классификация документов. Вы запускаете модели на периферийных устройствах, чтобы получать мгновенную обратную связь и обрабатывать данные безопасно. Вы отслеживаете производительность и корректируете настройки, чтобы ваш рабочий процесс оставался эффективным.
Совет: начинайте с небольших задач и постепенно расширяйте охват по мере роста уверенности. Так вы сможете создавать надёжные, быстрые и безопасные решения на основе ИИ, которые помогут вашей команде работать умнее.
Открытые и проприетарные модели
Перед вами стоит важный выбор при внедрении небольших языковых моделей: открытая модель или проприетарная. У каждого варианта есть свои преимущества и сложности. Понимание этих различий поможет вам принять наилучшее решение для вашей организации.
Открытые SLM дают свободу и гибкость. Вы можете получить исходный код, изменить его и адаптировать модель под свои задачи. Такой подход хорошо подходит, если вы хотите экспериментировать, настраивать или контролировать свои инструменты ИИ. Эти модели можно запускать на собственном оборудовании, что помогает защищать конфиденциальные данные и соответствовать требованиям регуляторов. Многие разработчики выбирают открытые SLM, потому что ценят прозрачность и поддержку сообщества.
Проприетарные модели, напротив, создаются и поддерживаются компаниями-разработчиками. Вы получаете отполированный продукт с профессиональной поддержкой и регулярными обновлениями. Такие модели часто включают расширенные функции, исправления безопасности и интеграцию с другими корпоративными инструментами. Если вам нужно решение, которое работает сразу после установки и поставляется с соглашением об обслуживании, проприетарные модели могут подойти.
При выборе стоит учитывать несколько факторов:
- Настройка: открытые модели позволяют донастраивать и адаптировать ИИ под ваши конкретные задачи. Проприетарные модели могут ограничивать возможности изменения базовой системы.
- Стоимость: открытые модели обычно не требуют лицензионных платежей. Вы платите только за оборудование и обслуживание. За проприетарные модели часто нужно платить по подписке или за использование.
- Поддержка: проприетарные модели предлагают выделенную поддержку и документацию. Открытые модели опираются на форумы сообщества и общие ресурсы.
- Безопасность и соответствие требованиям: оба варианта могут соответствовать высоким стандартам безопасности, но открытые модели дают вам больше контроля над обработкой данных.
Таблица поможет сравнить два варианта:
| Характеристика | Открытые SLM | Проприетарные SLM |
|---|---|---|
| Настраиваемость | Высокая | От средней до низкой |
| Стоимость | Только оборудование и обслуживание | Подписка и плата за использование |
| Поддержка | Силами сообщества | Профессиональная, выделенная |
| Обновления | Вклад сообщества | Регулярные, от вендора |
| Контроль данных | Полный (возможно локальное развертывание) | Зависит от вендора |
Недавние исследования Stanford HAI показывают, что специализированные SLM достигают точности 85–97% в узких предметных областях. Это превосходит многие универсальные крупные модели. Вы получаете эту производительность, когда адаптируете модели под свой бизнес. Экономические преимущества SLM также стимулируют внедрение, ведь вы можете получать качественные результаты без высоких затрат. Многие компании сейчас выбирают и открытые, и проприетарные модели, делая упор на решения для конкретных задач, а не на универсальные.
Совет: начните с бизнес-целей. Если вам нужны гибкость и контроль, открытые SLM могут оказаться лучшим выбором. Если важны надёжность и поддержка, рассмотрите проприетарные варианты. Также можно комбинировать оба типа, чтобы получить лучшее от каждого.
Будущее небольших языковых моделей
Тенденции развития SLM
Небольшие языковые модели (SLM) быстро набирают популярность в самых разных отраслях. Компаниям нужен ИИ, который хорошо работает, стоит дешевле и надёжно защищает данные. SLM уже лежат в основе умных инструментов в здравоохранении, финансах и производстве. В таблице ниже показано, как разные регионы и отрасли используют SLM:
| Сегмент | Ключевые наблюдения |
|---|---|
| Здравоохранение | SLM помогают взаимодействовать с пациентами и общаться с ними через чат-боты и ассистентов. |
| Тенденции на рынке США | США лидируют по использованию SLM, а такие компании, как Microsoft, продвигают новые модели. |
| Тенденции в Европе | Европа делает акцент на этичном ИИ и использует SLM для поддержки клиентов и создания контента. |
| Тенденции в Азиатско-Тихоокеанском регионе | Быстрый рост, поскольку предприятия хотят эффективных языковых инструментов во многих отраслях. |
Вы замечаете новые тренды, которые формируют малые языковые модели (SLM). Разработчики используют параметрически эффективную тонкую настройку (PEFT) и дистилляцию знаний, чтобы делать модели умнее без необходимости в мощном железе. Квантованные модели теперь работают на периферийных устройствах, поэтому вы получаете быстрые ответы даже на маломощном оборудовании. SLM поддерживают автоматизацию и прогнозную аналитику во многих областях. Вы выигрываете от моделей, которые подходят под ваши задачи и работают там, где они нужны.
| Тип тренда | Описание |
|---|---|
| Ключевые инновационные тренды | PEFT и дистилляция знаний делают SLM эффективными и простыми в адаптации. |
| Внедрение в отраслях | SLM обеспечивают автоматизацию в производстве, финансах и кибербезопасности. |
| Драйвер | Спрос на быстрый ИИ с низкими вычислительными затратами стимулирует внедрение SLM. |
| Возможность | SLM, адаптированные для здравоохранения и финансов, повышают точность и соответствие требованиям. |
| Вызов | Баланс между точностью и эффективностью остаётся ключевым направлением для разработчиков. |
Расширение возможностей
Можно подумать, что SLM справляются только с простыми задачами, но это меняется. Недавние исследования показывают, что SLM теперь могут выполнять сложные задачи, которые раньше были по силам только большим языковым моделям. Например, SLM способны обрабатывать изображения и текст, а также помогать роботам понимать окружающую среду. Вы видите, как SLM работают вместе с более крупными моделями, решая задачи анализа документов, понимания связки «зрение — язык» и принятия решений в реальном времени.
| Исследование | Вклад |
|---|---|
| Механизмы совместной работы | SLM берут на себя задачи нижнего уровня в мультимодальных системах, делая ИИ более эффективным. |
| Дистилляция из LLM | SLM обучаются у более крупных моделей, чтобы выполнять многозадачное обучение в узкоспециализированных областях. |
| Модель VITA-1.5 | SLM обрабатывают отдельные типы данных, прежде чем передать информацию более крупным моделям. |
| Визуальный анализ длинного контекста | SLM работают с визуальной информацией в длинных документах и изображениях. |
| Системы воплощённых агентов | SLM применяются в робототехнике, помогая машинам действовать в реальных условиях. |
| Совместная работа облака и периферии | SLM решают специализированные задачи в корпоративной среде, снижая затраты и задержки. |
| Корпоративное решение на базе SLM | SLM теперь сопоставимы по производительности с более крупными моделями во многих бизнес-задачах. |
Вы получаете больше от SLM по мере того, как они учатся справляться с новыми задачами. Такие модели теперь поддерживают многозадачность, работают с разными типами данных и быстро выдают результаты.
Роль Microsoft Phi
Вы видите, как семейство Phi от Microsoft задаёт направление развития SLM. Эксперты отмечают, что модели Phi, такие как Phi-4-mini, хорошо работают на периферийных устройствах. Вы можете использовать их там, где слабый интернет или строгие требования к конфиденциальности. Эти модели помогают повысить эффективность в производстве, здравоохранении и розничной торговле. Phi-4-mini и Phi-4-multimodal требуют меньше вычислительных ресурсов, поэтому вы экономите деньги и получаете результаты быстрее. Их увеличенное окно контекста позволяет легко анализировать большие документы и наборы данных.
«Языковые модели — это мощные механизмы рассуждений, и интеграция малых языковых моделей вроде Phi в Windows позволяет сохранять эффективность вычислений и открывает путь к будущему, в котором интеллект непрерывно встроен во все ваши приложения и сценарии работы. Copilot+ PC будут опираться на возможности Phi-4-multimodal, предоставляя мощь передовых SLM Microsoft без энергозатрат. Эта интеграция повысит продуктивность, творческий потенциал и образовательные сценарии и станет стандартной частью нашей платформы для разработчиков». — Вивек Прадип, вице-президент, выдающийся инженер направления Windows Applied Sciences.
Можно ожидать, что Microsoft Phi и дальше будет открывать новые сценарии использования SLM. По мере того как эти модели становятся частью ваших повседневных инструментов, вы увидите более умный, быстрый и безопасный ИИ везде, где работаете.
Вы видите, как малые языковые модели, такие как семейство Phi от Microsoft, устраняют главный недостаток Copilot. Эти модели дают вам:
- высокую точность в специализированных задачах при низком риске ошибок
- быструю обработку и низкую задержку для ответов в реальном времени
- высокий уровень конфиденциальности благодаря развёртыванию на собственной инфраструктуре
- более низкие затраты и меньшую потребность в дорогостоящем оборудовании
Вы можете автоматизировать поддержку клиентов, классифицировать обращения и эффективно обрабатывать нормативные документы. Эксперты прогнозируют, что ИИ скоро присоединится к рабочей силе и изменит целые отрасли. Вам стоит рассмотреть SLM для своего бизнеса и быть готовыми к следующей волне инноваций в области ИИ.
Часто задаваемые вопросы
Что такое малая языковая модель (SLM)?
Малая языковая модель использует меньше параметров, чем большие модели. Вы можете запускать SLM на локальных устройствах. SLM дают быстрые и точные результаты для конкретных задач, например для суммаризации писем или классификации документов.
Как семейство Phi от Microsoft повышает конфиденциальность?
Вы развёртываете модели Phi локально. Ваши данные остаются внутри организации. Вы контролируете доступ и выполняете требования соответствия. Модели Phi помогают защищать конфиденциальную информацию и снижать риски для конфиденциальности.
Можно ли использовать SLM без дорогого оборудования?
Да! Вы запускаете SLM, например Phi-3 Mini, на обычных компьютерах или серверах. Вы избегаете дорогих облачных GPU. SLM эффективно работают с минимальными ресурсами, делая ИИ доступным для вашей команды.
Как SLM снижают количество галлюцинаций в подсказках по коду?
SLM используют целенаправленное обучение и оптимизацию. Вы видите меньше выдуманных пакетов и более надёжные ответы. Модели Phi сосредоточены на точности, помогая вам доверять коду, созданному ИИ.
Какие задачи могут решать SLM в Microsoft 365?
Вы используете SLM для суммаризации писем, выделения пунктов действий, классификации документов и автоматизации рутинных задач. SLM повышают продуктивность и быстро дают точные результаты в повседневной работе.
Подходят ли SLM для отраслей с регуляторными требованиями?
Да. Вы развёртываете SLM локально, чтобы сохранить данные в безопасности. Команды в здравоохранении, финансах и юридических службах используют SLM, чтобы соответствовать строгим стандартам конфиденциальности и соответствия требованиям. Вы сохраняете контроль над конфиденциальной информацией.
Как SLM помогают снизить затраты на ИИ?
Для развёртывания на собственной инфраструктуре SLM требуют только затрат на оборудование. Вы избегаете постоянной оплаты за токены. Вы масштабируете решения на базе ИИ с разумными затратами и получаете существенную экономию по сравнению с большими моделями.
🎧 Послушайте этот выпуск
Хотите практичное объяснение малых языковых моделей для более быстрого и дешёвого корпоративного ИИ? Этот выпуск разбирает тему понятным языком и показывает, почему она важна для Microsoft 365, Azure, Power Platform, безопасности, ИИ и современной работы.
Послушайте этот выпуск, если вы хотите:
- Понять ключевые концепции малых языковых моделей для более быстрого и дешёвого корпоративного ИИ
- Увидеть, как это вписывается в более широкую экосистему технологий Microsoft
- Узнать, где это может принести практическую пользу вашей организации
Вам также могут понравиться связанные выпуски M365 FM:
- От данных к интеллектуальным агентам: создание надёжного корпоративного ИИ с Microsoft AI Foundry вместе с Shubhangi Goyal [MVP]
- Azure DevOps в 2026 году: незаметная основа корпоративного ИИ
- Корпоративные ИИ-сценарии в Power Apps вместе с Sara Lagerquist [MVP]
- Microsoft Graph: нервная система предприятия
- ИИ-агенты на основе Graph: руководство по корпоративной архитектуре
Открывайте больше практичных разговоров о технологиях Microsoft на M365 FM.
Последняя проверка: июль 2026.
Для кого этот выпуск
Этот выпуск предназначен для администраторов Microsoft, архитекторов, разработчиков, специалистов по безопасности и руководителей бизнеса, которым нужна практическая основа перед принятием решений о внедрении, эксплуатации или управлении.
🎧 Также рекомендуем послушать
- AI Agents — очень логичный следующий шаг для развития этой темы.
- Power Platform — очень логичный следующий шаг для развития этой темы.
- Microsoft Graph Data Connect — тесно связанный следующий шаг для дальнейшего изучения этой темы.