 UK
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 العربية
 עברית
 日本語
 한국어
Подолання «стіни затримки»: навіщо вашій хмарній стратегії потрібен периферійний рівень
By Mirko Peters ·
У міру того як організації дедалі глибше занурюються у штучний інтелект, промислову автоматизацію та телеметрію операційних процесів у реальному часі, тиха перешкода часто загрожує зірвати їхні цифрові ініціативи: «стіна затримки». Централізовані хмарні середовища пропонують неймовірну масштабованість, потужне довготривале зберігання та надійну аналітику даних, але вони фундаментально не справляют
Automatically translated with AI from the original post. Read the English original
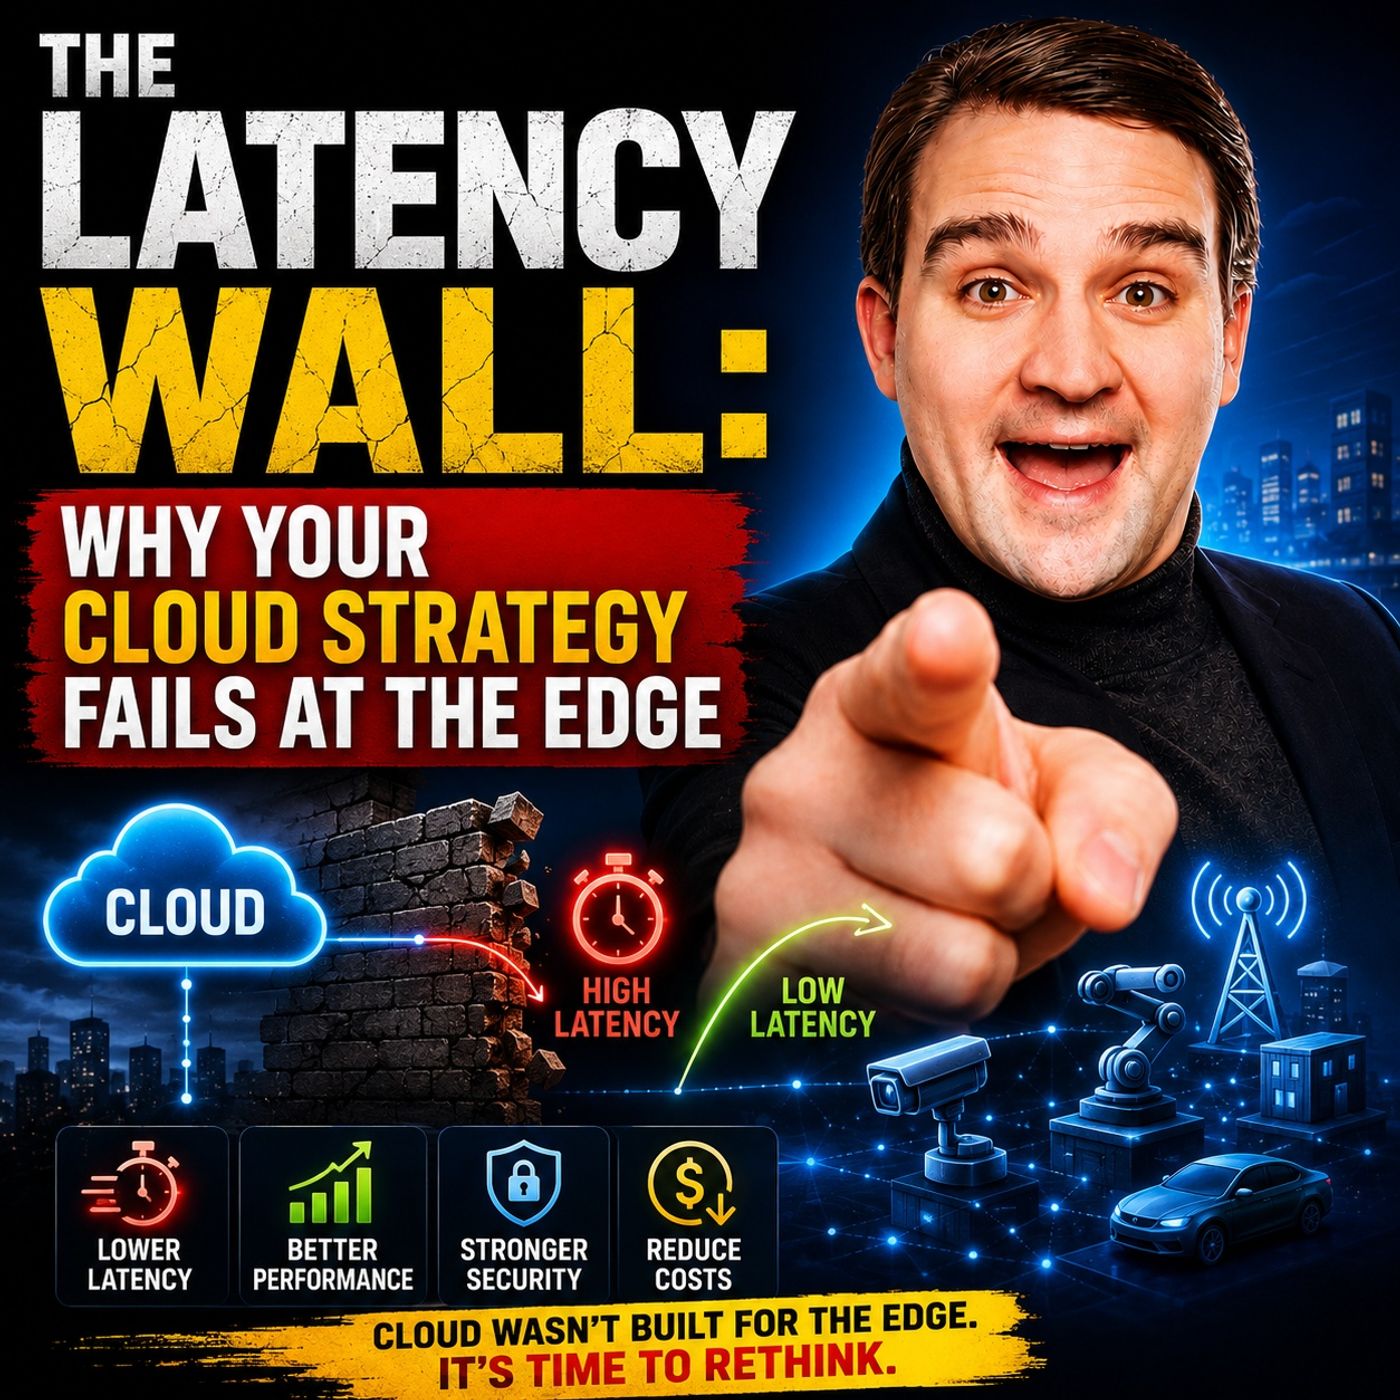
У міру того як організації дедалі глибше занурюються у штучний інтелект, промислову автоматизацію та телеметрію операційних процесів у реальному часі, тиха перешкода часто загрожує зірвати їхні цифрові ініціативи: «стіна затримки». Централізовані хмарні середовища пропонують неймовірну масштабованість, потужне довготривале зберігання та надійну аналітику даних, але вони фундаментально не справляються, коли застосункам потрібен миттєвий зворотний зв’язок. Якщо ваша архітектура повністю покладається на віддалений центр обробки даних, кожен пакет, що проходить туди й назад, додає мілісекунди затримки — затримки, які можуть призвести до збою автоматизованих процесів, невдалих перевірок якості або критичних вразливостей безпеки.
У цьому дописі ми розберемо, чому традиційна централізована хмарна модель упирається в стіну на периферії, як сучасні галузі долають ці обмеження за допомогою локальної обробки даних і як на практиці виглядає комплексна гібридна стратегія. Щоб детально дізнатися, як ці архітектурні, безпекові та управлінські рішення працюють саме в середовищах Microsoft, обов’язково послухайте наш супровідний подкаст-епізод Cloud Latency and Edge Computing Strategy.
Розуміння «стіни затримки» та її впливу на операції в реальному часі
«Стіна затримки» — це фізична й архітектурна межа того, наскільки швидко дані можуть переміщуватися від точки походження до централізованого хмарного сховища. Відстань мережею, фізичні маршрутні переходи, перевантаження пропускної здатності та втрати пакетів разом створюють передбачувані нижні межі продуктивності. У звичайному корпоративному програмному забезпеченні затримка в 100 мілісекунд є для людини абсолютно непомітною. Проте для автономного керованого візка, роботизованої руки на виробничій ділянці чи високошвидкісної системи візуального контролю якості 100 мілісекунд — це ціла вічність.
Коли ви окреслюєте вимоги до середовищ, де переважають периферійні компоненти, обмеження надсилання необроблених даних із датчиків або відеопотоків до дата-центру публічної хмари стають напрочуд очевидними. Мережева затримка спричиняє джитер, проблеми асинхронної синхронізації даних і додаткове навантаження на моніторинг. Щоб зберегти цілісність системи, архітектори мають відійти від мислення «лише хмара» до парадигми локальної обробки, де рішення ухвалюються за мілісекунди від самого обладнання.
Технічні та бізнесові наслідки обмежень централізованої хмари
Ігнорування «стіни затримки» має серйозні технічні та фінансові наслідки. Продуктивність застосунків одразу страждає, коли цикли реального часу збоюють. Наприклад, ресурсомісткі робочі навантаження ШІ, що запускають моделі комп’ютерного зору, потребують негайних результатів інференсу. Якщо відеокадри мають пройти публічними інтернет-маршрутами до хмарного кластера, затримка може зробити результат повністю неактуальним до моменту його повернення.
Крім того, синхронізація даних у розподілених середовищах створює величезну архітектурну складність. Периферійні вузли часто працюють у віддалених, відключених або з низькою пропускною здатністю локаціях, де неперервне високошвидкісне з’єднання не гарантоване. Спроба керувати телеметрією, оновленнями, політиками безпеки та асинхронними апдейтами без узгодженої периферійної стратегії призводить до масової фрагментації, прогалин у безпеці та вразливості до несанкціонованого фізичного доступу.
З фінансового боку відправлення петабайтів сирих, нефільтрованих операційних даних назад у хмару призводить до astronomічних витрат на пропускну здатність. Замість безперервної передачі необробленої телеметрії 24/7 організації досягають значної економії, фільтруючи, агрегуючи та обробляючи дані локально — і надсилаючи в хмару лише стиснуті висновки або критичні сповіщення.
Реальні кейси: промислова автоматизація, автономні транспортні засоби, охорона здоров’я та роздрібна торгівля
Найкраще видно, як фізичні галузі справляються зі «стіною затримки», коли розглядаєш конкретні приклади:
- Промислова автоматизація: На високошвидкісних виробничих ділянках, де незапланований простій коштує тисячі доларів щохвилини, хмарний ШІ для виявлення дефектів продукції створює неприйнятну затримку на шляху туди й назад. Розгортаючи квантовані моделі комп’ютерного зору на локальних периферійних пристроях, загальна затримка контролю падає до лічених мілісекунд, що дозволяє миттєво виявляти та відбраковувати дефектні деталі.
- Автономні транспортні засоби: Безпілотні автомобілі та автоматизовані мобільні роботи мусять орієнтуватися в динамічному фізичному просторі за лічені мілісекунди. Збір даних із сенсорів, телеметрія керування та логіка уникнення зіткнень не допускають жодних перебоїв у мережі, тож для безпеки обов'язково потрібні локальні вузли обчислень на периферії.
- Телеметрія в охороні здоров'я: Системи дистанційного моніторингу пацієнтів і мережі діагностичної телеметрії вимагають надзвичайно низької затримки та суворої відповідності таким регламентам, як HIPAA і GDPR. Локальні периферійні сервери обробляють чутливі показники пацієнтів безпосередньо на місці, знижуючи затримку до 80 % і водночас захищаючи конфіденційність даних.
- Роздрібна торгівля та розумні простори: У магазинах із великим потоком відвідувачів аналітика на периферії забезпечує автоматичні каси, відстеження запасів у реальному часі та динамічний моніторинг полиць. Завдяки цьому обслуговування клієнтів залишається безперебійним, навіть якщо зв'язок із зовнішньою хмарою нестабільний.
Подолання «стіни затримки» за допомогою периферійних обчислень і гібридних стратегій
Подолати «стіну затримки» не означає відмовитися від хмари; натомість це потребує ретельно збалансованої гібридної стратегії «від хмари до периферії». Запускаючи безпосередньо на периферії робочі навантаження, чутливі до затримки, інференс штучного інтелекту в реальному часі та контури керування процесами, організації зберігають оперативність, необхідну для фізичних операцій. Водночас централізована хмара залишається головним місцем для глибокої історичної аналітики, глобальної звітності та довготривалого навчання моделей.
Такі платформи, як Azure Stack Edge, закривають саме цей розрив, переносячи можливості корпоративної хмари безпосередньо в локальні центри обробки даних або у віддалені польові середовища. У поєднанні з приватними мережами 5G та Multi-access Edge Computing (MEC) бізнес отримує виділені архітектури з наднизькою затримкою, здатні забезпечити роботу найвимогливіших сучасних застосунків.
Побудова перспективної стратегії «від хмари до периферії»
Створення стійкої та перспективної стратегії периферійних обчислень потребує методичного, покрокового підходу:
- Оцініть вимоги до затримки: Проаналізуйте робочі навантаження, щоб визначити, які системи потребують відповіді менш ніж за 20 мілісекунд, а які можуть працювати з чергами, що йдуть до хмари.
- Розгорніть інфраструктуру, готову до периферії: Інвестуйте у захищені від несприятливих умов вузли обчислень, надійне локальне сховище з високим рівнем резервування та високошвидкісне мережеве підключення (наприклад, приватна 5G або Wi-Fi 6).
- Оптимізуйте моделі ШІ: Стисніть і квантуйте моделі машинного навчання, щоб вони могли ефективно працювати на периферійному обладнанні з обмеженими ресурсами.
- Забезпечте єдине управління: Підтримуйте узгоджені політики безпеки, управління ідентифікацією та фреймворки моніторингу в усьому розподіленому континуумі «від хмари до периферії».
Поширені запитання щодо затримки хмарних обчислень і стратегії периферійних обчислень
Що таке «стіна затримки» в хмарних обчисленнях?
«Стіна затримки» виникає, коли фізична відстань і мережеві переходи між джерелом операційних даних і централізованим центром обробки даних у хмарі спричиняють неприйнятні затримки, через які застосунки реального часу стають неефективними.
Чому периферійні обчислення зменшують затримку?
Периферійні обчислення обробляють дані безпосередньо в місці їх створення або поблизу нього (наприклад, на локальному сервері заводу чи в роздрібному терміналі), значно скорочуючи фізичну відстань, яку мають пройти дані.
Як Azure Stack Edge допомагає з обробкою в реальному часі?
Azure Stack Edge переносить можливості Azure з обчислень, зберігання та ШІ безпосередньо в ваше локальне середовище, дозволяючи запускати робочі навантаження й аналізувати дані на місці, перш ніж надсилати узагальнені результати в хмару.
Які галузі найбільше виграють від периферійних обчислень?
Найбільше виграють виробництво, охорона здоров'я, транспорт, автономне водіння, логістика та роздрібна торгівля завдяки суворим вимогам до миттєвих рішень у реальному часі.
Чи можна використовувати периферійні обчислення з моєю поточною хмарною стратегією?
Так. Гібридний підхід дозволяє запускати чутливі до часу робочі навантаження на периферії, водночас використовуючи публічну хмару для широкого масштабування, архівування та розширеної аналітики.
Яка роль приватної 5G у периферійних обчисленнях?
Приватна 5G забезпечує виділену, високозахищену бездротову мережеву інфраструктуру, яка гарантує наднизьку затримку та надійне з'єднання для критично важливих периферійних пристроїв.
Як дізнатися, чи потребує мій застосунок периферійних обчислень?
Якщо ваш застосунок вимагає відповіді менш ніж за 50 мілісекунд, працює у віддалених середовищах із нестабільним зв'язком або обробляє чутливі локальні дані, які не можуть витримати затримок при передачі, він є головним кандидатом для периферійних обчислень.
Чи покращують периферійні обчислення безпеку?
Периферійні обчислення можуть суттєво посилити безпеку, зберігаючи чутливу телеметрію та персональні дані на локальній інфраструктурі й мінімізуючи ризики під час передавання даними мережею на великі відстані.
🎧 Слухайте цей епізод
Хочете практичне пояснення Cloud Latency and Edge Computing Strategy? У цьому епізоді тему розібрано простою мовою. Ви дізнаєтесь, чому вона важлива для Microsoft 365, Azure, Power Platform, безпеки, ШІ та сучасної роботи.
Послухайте цей епізод, якщо хочете:
- Зрозуміти ключові поняття, що стоять за Cloud Latency and Edge Computing Strategy
- Побачити, як це вписується в ширшу екосистему технологій Microsoft
- Дізнатися, де це може принести практичну користь вашій організації
Вам також можуть сподобатися ці пов'язані епізоди M365 FM:
- Отруєння залежностей мікросервісів і каскадна затримка в хмарі
- Microsoft Cloud Solution Provider (CSP) — просто про складне
- Microsoft Defender for Cloud Apps — просто про складне
- Як побудувати переможну партнерську стратегію Microsoft
- Управління ШІ: від Microsoft Copilot до квантових обчислень
Відкривайте більше практичних розмов про Microsoft на M365 FM.
Останнє оновлення: липень 2026.
Для кого цей епізод
Цей епізод призначено для адміністраторів Microsoft, архітекторів, розробників, фахівців з безпеки та керівників бізнесу, яким потрібна практична основа перед рішеннями щодо впровадження, експлуатації чи управління.
🎧 Також варто послухати
- AI Agents — наступний логічний крок для розширення цієї теми.
- Power Platform — наступний логічний крок для розширення цієї теми.
- Microsoft Graph Data Connect — наступний логічний крок для розширення цієї теми.