 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Always-On-begeleiding versus situatiegebonden expertise: je AI-architectuur herstructureren
By Mirko Peters ·
Welkom terug bij de blogbegeleiding van onze podcast. In dit bericht duiken we diep in een technische hindernis waar bijna elk enterprise-team tegenaan loopt nadat het de eerste golf AI-oplossingen heeft uitgerold. Je bouwt een eigen AI-agent en in het begin voelt het als magie. Hij is snel, bijzonder nauwkeurig en erg responsief. Maar na drie tot zes maanden gebeurt er iets vreemds. De reactietij
Automatically translated with AI from the original post. Read the English original
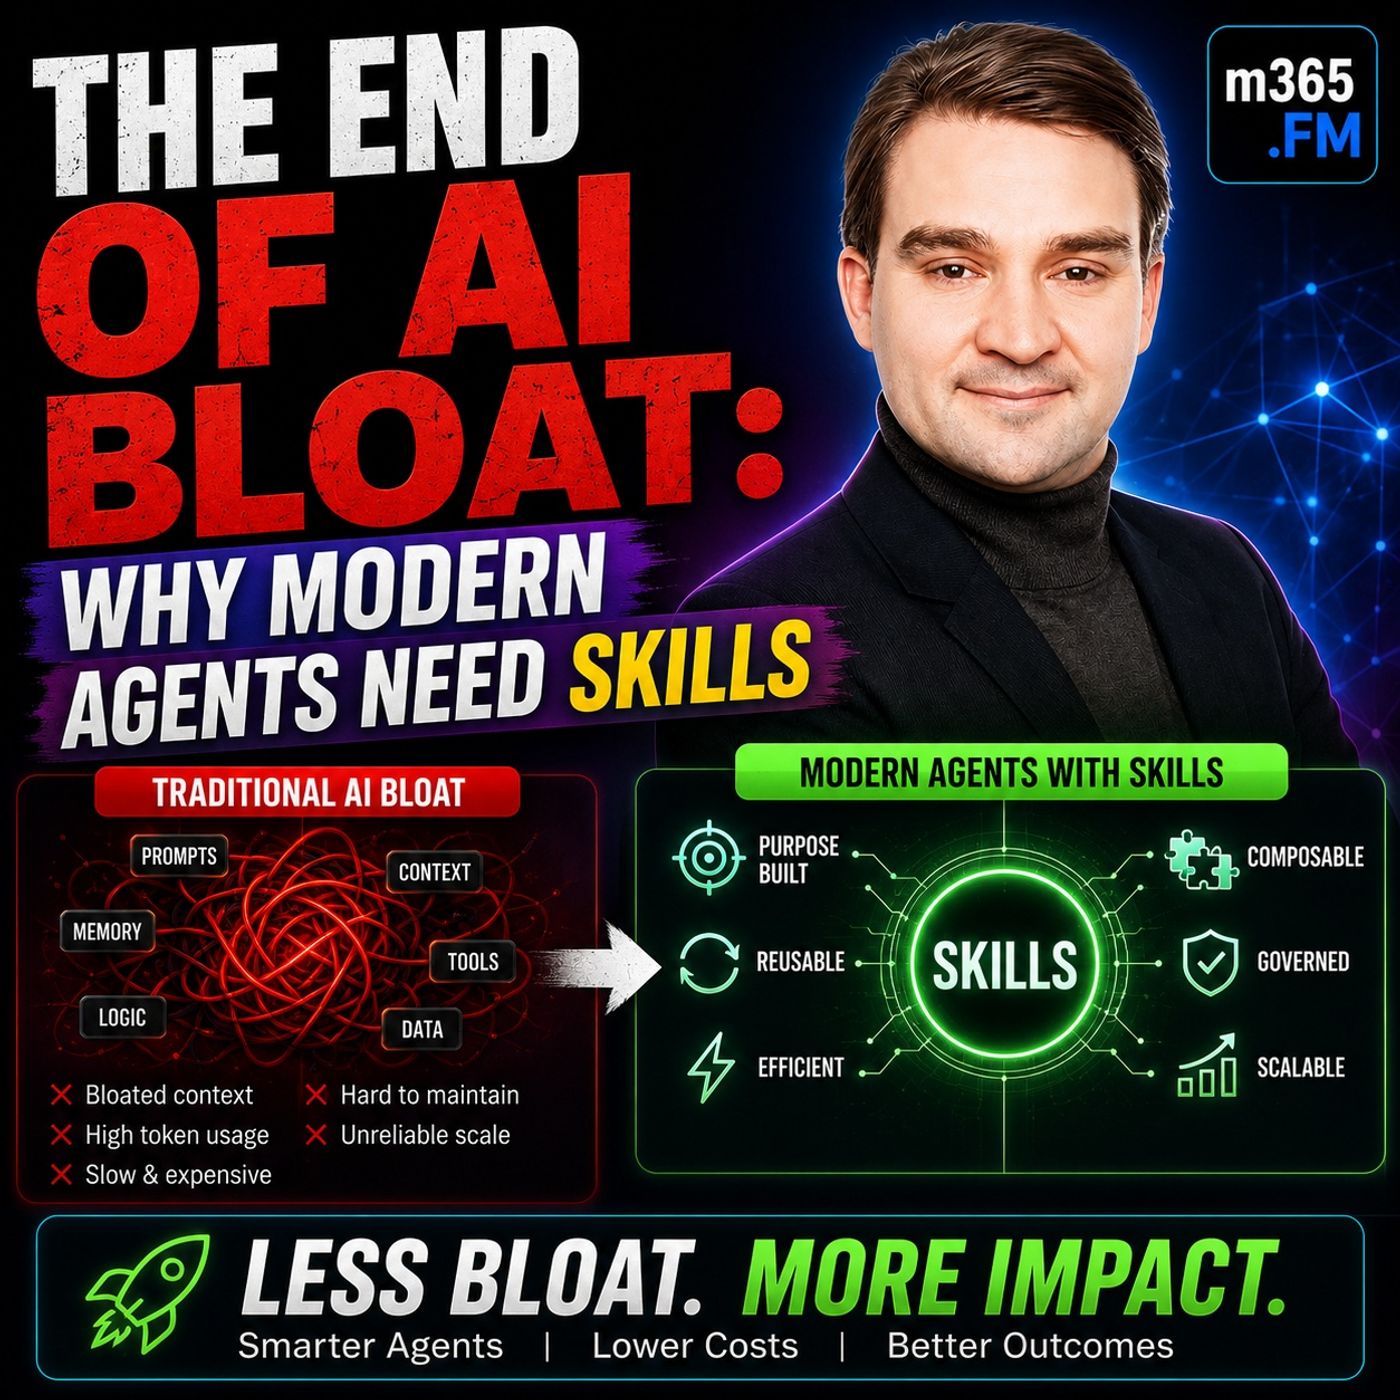
Welkom terug bij de blogbegeleiding van onze podcast. In dit bericht duiken we diep in een technische hindernis waar bijna elk enterprise-team tegenaan loopt nadat het de eerste golf AI-oplossingen heeft uitgerold. Je bouwt een eigen AI-agent en in het begin voelt het als magie. Hij is snel, bijzonder nauwkeurig en erg responsief. Maar na drie tot zes maanden gebeurt er iets vreemds. De reactietijden kruipen omhoog, de operationele kosten sluipen omhoog, en de agent begint te hallucineren of wijkt af van het gewenste gedrag. In veel organisaties is de standaardreactie om meer rekenkracht op het probleem te gooien of over te stappen op een groter taalmodel. Maar zoals we uitgebreid laten zien, ligt het kernprobleem niet bij het model zelf, maar bij de onderliggende architectuur van je prompts.
In dit bericht bespreken we waarom monolithische prompts leiden tot catastrofale contextdegradatie, hoe je universele kerngedragingen scheidt van taakspecifieke workflows, en waarom modulaire ontwerppatronen het enterprise-AI-landschap veranderen.
Inleiding: de verborgen kosten van monolithische prompts
Wanneer engineeringteams conversationele AI-agenten voor het eerst prototypen, leunen ze meestal op één uitgebreide systeemprompt. Die prompt bepaalt wie de agent is, hoe hij spreekt, welke regels hij moet volgen en hoe hij complexe uitzonderingssituaties afhandelt. Het is een intuïtieve manier om te beginnen. Maar naarmate het bedrijf evolueert, evolueert ook de prompt. HR voegt nieuwe verlofregels toe, compliance introduceert regionale regelgeving en klantenservice voegt terugbetalingsworkflows toe.
Voordat je het weet, is je systeemprompt uitgegroeid tot duizenden tokens aan dichte instructies. Elke keer dat een gebruiker een eenvoudige vraag stelt, zoals naar de kantooruren, moet het AI-model alle regels, beleidsregels en uitzonderingen in de volledige systeemprompt verwerken en erover redeneren. Hoewel vijfennegentig procent van die instructies volledig irrelevant is voor het opzoeken van kantooruren, moet het model ze toch doorlopen. Deze verborgen belasting op rekenkracht en redenering noemen we de Context Tax, en die verandert op termijn fundamenteel de prestatiekenmerken van je AI-agent.
Begrijpen van de Context Tax en waarom agents na verloop van tijd degraderen
Agentdegradatie in productieomgevingen is opvallend voorspelbaar. Het ontstaat niet doordat het onderliggende model is verleerd te redeneren. Het ontstaat doordat we het actieve contextvenster van het model overbelasten met cognitieve ruis. Wanneer je een AI dwingt om bij elke gebruikersinteractie bergen ongerelateerde procedurele documentatie door te spitten, gebeuren er meerdere dingen tegelijk:
- Het tokenverbruik schiet omhoog, wat rechtstreeks de inferentiekosten per aanvraag verhoogt.
- De responslatentie neemt toe, omdat grotere contexten meer verwerkingstijd vragen.
- De kans op hallucinaties stijgt, omdat het model moeite heeft met het afwegen van tegenstrijdige of irrelevante instructies.
- De consistentie van de redenering neemt af, omdat de aandacht van het model versplinterd raakt over te veel concurrerende richtlijnen.
Het systeem is niet minder intelligent geworden; het redeneerpad is simpelweg vastgelopen door onnodige data. Om dit op te lossen moeten we goed kijken naar hoe we informatie binnen onze architecturen verdelen.
Altijd-actieve richtlijnen versus situationele expertise
Een van de krachtigste mentaliteitsveranderingen in modern AI-engineering is het scheiden van je systeeminstructies in twee duidelijke categorieën: altijd-actieve richtlijnen en situationele expertise.
Altijd-actieve richtlijnen bestaan uit de universele vangrails en identiteitskenmerken die bij elke interactie moeten gelden, ongeacht de intentie van de gebruiker. Dit omvat:
- Identiteit, persona en toon van de agent
- Universele eisen voor enterprise-beveiliging
- Kernregels voor compliance en absolute grenzen
- Standaard opmaak- en uitvoervoorkeuren
Situationele expertise is daarentegen volledig contextafhankelijk. Het is informatie die alleen waardevol is wanneer een specifiek scenario of workflow wordt getriggerd. Voorbeelden zijn onboardingprotocollen voor leveranciers, belastingberekeningsregels, regionale retourbeleidsregels of complexe procedures voor het afhandelen van IT-incidenten.
In verouderde architecturen worden beide categorieën in één enorme prompt samengevoegd. In een moderne, herstructureerde architectuur blijft alleen de altijd-actieve richtlijnberichten permanent geladen. Al het overige wordt verpakt in modulaire componenten die dynamisch worden geladen.
Anatomie van een Skill: kennis verpakken voor AI
Om de Context Tax weg te nemen, hebben we een mechanisme nodig dat situationele expertise buiten de primaire prompt opslaat en die alleen ophaalt wanneer dat nodig is. Dat mechanisme is de AI Skill. Een Skill is meer dan een promptfragment; het is een volledig, herbruikbaar pakket met taakspecifieke instructies en middelen. Een goed ontworpen Skill bevat doorgaans:
- Duidelijke triggerbeschrijvingen die de orchestrator vertellen wanneer de Skill relevant is
- Gestructureerde procedurele instructies voor het afhandelen van de taak
- Referentiedocumenten, formulieren of beleidssjablonen
- Optionele scripts of API-definities om acties uit te voeren
Het hart van dit pakket is het configuratiebestand, vaak opgezet als een SKILL.md-bestand. Dit bestand beschrijft de exacte scope, het doel en de uitvoeringsstappen voor dat specifieke kennisdomein. Door kennis op deze manier te modulariseren, creëer je overzichtelijke, onderhoudbare eenheden van bedrijfscapaciteit die onafhankelijk van elkaar kunnen worden bijgewerkt zonder de stabiliteit van de kernagent in gevaar te brengen.
Heldere redeneergrenzen vastleggen
Het modulariseren van je AI-agent in afzonderlijke Skills bespaart niet alleen tokens; het legt ook strikte redeneergrenzen vast. Wanneer een model een monolithische prompt krijgt, probeert het elk probleem tegelijkertijd door de bril van elke regel te bekijken. Met Skills isoleer je het redeneerdomein.
Wanneer een gebruiker bijvoorbeeld een inkoopworkflow start, wordt de inkoop-Skill geladen en richt de redeneermotor van de agent zich volledig op inkoopbeleid, goedkeuringshiërarchieën en leveranciersrichtlijnen. Zolang die Skill actief is, blijven niet-gerelateerde regels over belastingaftrek of personeelsbeleid buiten het actieve contextvenster. Deze strikte afbakening verbetert zowel de precisie als de consistentie van de output van de AI aanzienlijk en zorgt ervoor dat deze gespecialiseerde procedures volgt zonder storing vanuit andere delen van de organisatie.
Progressive disclosure toepassen voor efficiëntie
Hoe beheren we deze Skills zonder het systeem te overbelasten? Het antwoord ligt in een ontwerppatroon dat bekendstaat als progressive disclosure. In plaats van bij het opstarten elke instructie en elke workflow te laden, houdt je agent een lichtgewicht catalogus bij met alleen de namen en beschrijvingen van de beschikbare Skills.
Wanneer een gebruiker een prompt indient, verloopt de workflow in een vaste volgorde:
- De orchestrator analyseert het verzoek van de gebruiker aan de hand van de lichtgewicht Skill-catalogus.
- Het identificeert de specifieke Skill die nodig is om het scenario af te handelen.
- Het systeem laadt die ene Skill dynamisch in het contextvenster.
- De agent voert de taak met grote precisie uit.
- Zodra de taak is afgerond, wordt de Skill ontladen, waarna de agent terugkeert naar zijn schone, basisstatus.
Dit ontwerppatroon verlaagt de rekenkracht die nodig is aanzienlijk, verkort de latentie en houdt de operationele kosten onder controle, terwijl je agents toegang blijven houden tot diepgaande, gespecialiseerde bedrijfskennis.
Conclusie: je AI-architectuur herstructureren voor de toekomst
Monolithische prompts hebben ons in de vroege dagen van generatieve AI-experimenten goed gediend, maar enterprise-implementaties vragen om meer schaalbaarheid, lagere latentie en hogere betrouwbaarheid. Door altijd-actieve richtlijnen te scheiden van situationele expertise en modulaire Skills te omarmen via progressive disclosure, elimineer je de Context Tax, voorkom je agentdegradatie en bouw je robuuste AI-systemen die soepel meegroeien met je organisatie.
Wil je een volledig overzicht van deze architectuurpatronen, praktijkvoorbeelden van implementatie en hoe deze concepten werken op platforms als Microsoft Copilot Studio, GitHub Copilot en Claude Code? Bekijk dan zeker onze gerelateerde aflevering: The End of AI Bloat: Why Modern Agents Need Skills. Luister mee, abonneer je en laat ons weten hoe jij je enterprise AI-agents structureert!