 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Wskazówki stałe a wiedza sytuacyjna: przebudowa architektury AI
By Mirko Peters ·
Witamy ponownie w towarzyszącym podcastowi wpisie na blogu. W dzisiejszym artykule zagłębiamy się w problem techniczny, z którym niemal każdy zespół w przedsiębiorstwie styka się po wdrożeniu pierwszej fali rozwiązań AI…
Automatically translated with AI from the original post. Read the English original
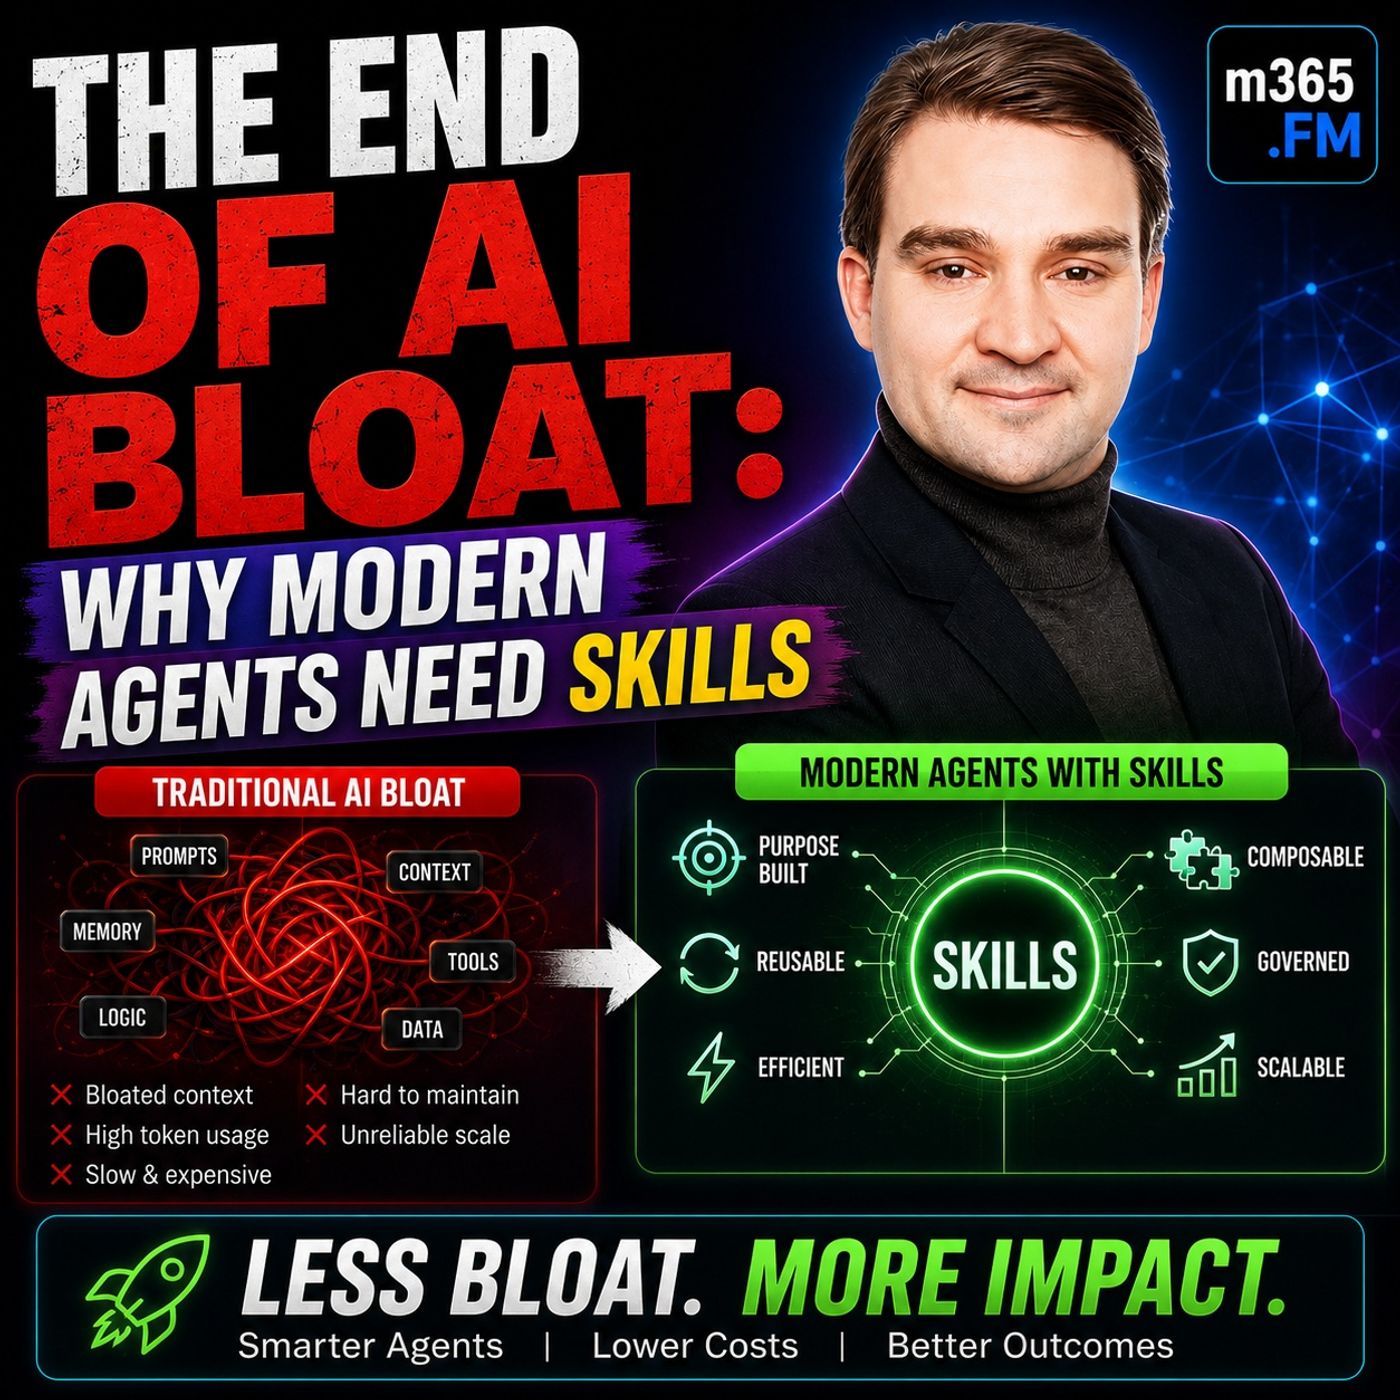
Witamy ponownie w towarzyszącym podcastowi wpisie na blogu. W dzisiejszym artykule zagłębiamy się w problem techniczny, z którym niemal każdy zespół wdrażający w firmie pierwsze rozwiązania AI prędzej czy później się mierzy. Budujesz własnego agenta AI i na początku wygląda to jak magia. Działa szybko, jest bardzo trafny i dobrze reaguje. Ale po trzech, sześciu miesiącach dzieje się coś dziwnego. Czasy odpowiedzi zaczynają się wlec, koszty operacyjne rosną, a agent zaczyna halucynować lub odchodzić od zamierzonego zachowania. Standardowym rozwiązaniem w wielu organizacjach jest dołożenie mocy obliczeniowej albo przejście na większy model językowy. Jak jednak pokazujemy w szczegółach, sedno problemu nie leży w samym modelu, lecz w architekturze promptów, na których się opiera.
W tym wpisie wyjaśniamy, dlaczego monolityczne prompty prowadzą do katastrofalnej degradacji kontekstu, jak oddzielić uniwersalne zachowania bazowe od przepływów pracy specyficznych dla zadań i dlaczego modułowe wzorce projektowe zmieniają krajobraz AI w przedsiębiorstwach.
Wprowadzenie: ukryty koszt monolitycznych promptów
Kiedy zespoły inżynierskie po raz pierwszy prototypują konwersacyjnych agentów AI, zazwyczaj opierają się na jednym, obszernym prompcie systemowym. Ten prompt określa, kim jest agent, jak ma mówić, jakie zasady musi przestrzegać i jak obsługiwać złożone przypadki brzegowe. To intuicyjny sposób na start. Jednak wraz z rozwojem biznesu rośnie też prompt. HR dodaje nowe zasady dotyczące urlopów, dział zgodności wprowadza regionalne przepisy, a obsługa klienta dopisuje procedury zwrotów.
Zanim się obejrzysz, prompt systemowy rozrasta się do tysięcy tokenów gęstych instrukcji. Za każdym razem, gdy użytkownik zadaje proste pytanie, na przykład o godziny otwarcia biura, model AI jest zmuszony wczytać, przetworzyć i przeanalizować każdą regułę, zasadę i przypadek brzegowy zawarte w całym prompcie systemowym. Mimo że dziewięćdziesiąt pięć procent tych instrukcji nie ma nic wspólnego ze sprawdzaniem godzin otwarcia, model i tak musi je przeanalizować. Ten ukryty narzut na moc obliczeniową i rozumowanie nazywamy podatkiem od kontekstu (Context Tax). Z czasem fundamentalnie zmienia on charakterystykę wydajności Twojego agenta AI.
Zrozumienie podatku od kontekstu i tego, dlaczego agenci z czasem tracą jakość
Degradacja agentów w środowiskach produkcyjnych jest zaskakująco przewidywalna. Nie dzieje się tak dlatego, że model zapomniał, jak rozumować. Dzieje się tak, ponieważ przeciążamy aktywne okno kontekstowe modelu szumem poznawczym. Kiedy zmuszasz AI do przekopywania się przez góry niezwiązanej dokumentacji proceduralnej przy każdej interakcji z użytkownikiem, jednocześnie dzieje się kilka rzeczy:
- Zużycie tokenów gwałtownie rośnie, co bezpośrednio zwiększa koszt wnioskowania przypadający na każde żądanie.
- Opóźnienie odpowiedzi wzrasta, ponieważ większe konteksty wymagają więcej czasu na przetworzenie.
- Prawdopodobieństwo halucynacji rośnie, gdyż model ma trudność z ważeniem sprzecznych lub nieistotnych instrukcji.
- Spójność rozumowania spada, ponieważ uwaga modelu rozprasza się na zbyt wiele konkurujących ze sobą dyrektyw.
System nie zmniejszył swojej inteligencji; po prostu jego ścieżka rozumowania została przytłoczona niepotrzebnymi danymi. Aby to rozwiązać, musimy dokładnie przyjrzeć się temu, jak rozmieszczamy informacje w naszych architekturach.
Wskazówki stałe a wiedza sytuacyjna
Jedną z najbardziej wartościowych zmian sposobu myślenia w nowoczesnej inżynierii AI jest podział instrukcji systemowych na dwie odrębne kategorie: wskazówki stałe (always-on guidance) i wiedzę sytuacyjną (situational expertise).
Wskazówki stałe to uniwersalne zabezpieczenia i znaczniki tożsamości, które muszą obowiązywać w każdej interakcji, niezależnie od intencji użytkownika. Obejmują one:
- Tożsamość agenta, personę i ton głosu
- Uniwersalne wymagania bezpieczeństwa przedsiębiorstwa
- Podstawowe zasady zgodności i bezwzględne granice
- Standardowe preferencje formatowania i wyjścia
Wiedza sytuacyjna z kolei ma w pełni kontekstowy charakter. To informacje, które są wartościowe tylko wtedy, gdy uruchomiony zostanie konkretny scenariusz lub przepływ pracy. Przykładami są procedury onboardingu dostawców, regulacje dotyczące obliczania podatków, regionalne zasady zwrotów czy złożone procedury reagowania na incydenty IT.
W starszych architekturach obie kategorie są upychane w jednym, ogromnym prompcie. W nowoczesnej, przebudowanej architekturze na stałe pozostają załadowane wyłącznie wskazówki obowiązujące zawsze. Cała reszta jest zapakowana w modułowe komponenty, które ładują się dynamicznie.
Anatomia Skilla: pakowanie wiedzy dla AI
Aby wyeliminować Context Tax, potrzebujemy mechanizmu, który przechowuje wiedzę sytuacyjną poza głównym promptem i pobiera ją dopiero wtedy, gdy jest potrzebna. Tym mechanizmem jest AI Skill. Skill to nie tylko fragment promptu, lecz kompleksowy, wielokrotnego użytku pakiet instrukcji i zasobów dotyczących konkretnego zadania. Dobrze zaprojektowany Skill zazwyczaj zawiera:
- Jasne opisy wyzwalaczy, które informują orkiestrator, kiedy Skill jest istotny
- Uporządkowane instrukcje proceduralne dotyczące obsługi zadania
- Dokumenty referencyjne, formularze lub szablony zasad
- Opcjonalne skrypty lub definicje API do wykonywania działań
W centrum tego pakietu znajduje się plik konfiguracyjny, często zapisany jako plik SKILL.md. Określa on dokładny zakres, cel i kroki wykonania dla danej dziedziny wiedzy. Dzięki modularyzacji wiedzy w ten sposób tworzysz przejrzyste, łatwe w utrzymaniu jednostki zdolności przedsiębiorstwa, które można aktualizować niezależnie, bez ryzyka dla stabilności głównego agenta.
Wyznaczanie jasnych granic rozumowania
Modularyzacja agenta AI na odrębne Skille robi więcej niż tylko oszczędza tokeny – ustala rygorystyczne granice rozumowania. Gdy model dostaje monolityczny prompt, próbuje rozwiązać każdy problem przez pryzmat wszystkich reguł jednocześnie. Korzystając ze Skilli, izolujesz domenę rozumowania.
Na przykład, gdy użytkownik uruchamia proces zakupowy, ładowany jest Skill dotyczący zakupów, a silnik rozumowania agenta skupia się wyłącznie na zasadach zakupu, hierarchiach zatwierdzania i wytycznych dla dostawców. Gdy ten Skill jest aktywny, niezwiązane z nim reguły dotyczące odliczeń podatkowych lub polityk kadrowych pozostają poza aktywnym oknem kontekstu. Ta ścisła granica znacząco poprawia zarówno precyzję, jak i spójność wyników AI, zapewniając, że agent postępuje zgodnie z wyspecjalizowanymi procedurami bez zakłóceń ze strony innych obszarów firmy.
Wdrażanie progresywnego ujawniania dla wydajności
Jak zarządzać tymi Skillami, nie przeciążając systemu? Odpowiedź kryje się we wzorcu projektowym znanym jako progresywne ujawnianie. Zamiast ładować wszystkie instrukcje i przepływy pracy przy starcie, agent utrzymuje lekki katalog zawierający wyłącznie nazwy i opisy dostępnych Skilli.
Gdy użytkownik wysyła prompt, przepływ pracy przebiega w ściśle określonej sekwencji:
- Orkiestrator analizuje żądanie użytkownika względem lekkiego katalogu Skilli.
- Identyfikuje konkretny Skill wymagany do obsługi scenariusza.
- System dynamicznie ładuje ten pojedynczy Skill do okna kontekstu.
- Agent wykonuje zadanie z dużą precyzją.
- Po zakończeniu zadania Skill zostaje wyładowany, a agent wraca do swojego lekkiego, bazowego stanu.
Ten wzorzec projektowy radykalnie zmniejsza wymagania obliczeniowe, skraca opóźnienia i utrzymuje koszty operacyjne pod kontrolą, zapewniając jednocześnie, że agenty mają dostęp do głębokiej, wyspecjalizowanej wiedzy przedsiębiorstwa.
Podsumowanie: przebudowa architektury AI na przyszłość
Monolityczne prompty dobrze służyły we wczesnych czasach eksperymentów z generatywną AI, ale wdrożenia w przedsiębiorstwach wymagają większej skalowalności, niższych opóźnień i wyższej niezawodności. Oddzielając wskazówki obowiązujące zawsze od wiedzy sytuacyjnej i przyjmując modularne Skille dzięki progresywnemu ujawnianiu, możesz wyeliminować Context Tax, zapobiec degradacji agentów i budować solidne systemy AI, które rozwijają się wraz z organizacją.
Aby usłyszeć pełne omówienie tych wzorców architektonicznych, praktycznych przykładów wdrożeń oraz tego, jak te koncepcje odnoszą się do platform takich jak Microsoft Copilot Studio, GitHub Copilot i Claude Code, koniecznie posłuchaj powiązanego odcinka: The End of AI Bloat: Why Modern Agents Need Skills. Słuchaj, subskrybuj i daj nam znać, jak strukturyzujesz swoje agenty AI w przedsiębiorstwie!