 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Die Distributed-Monolith-Falle in .NET-Microservices vermeiden
Von Mirko Peters ·
Wenn Engineering-Teams von einer monolithischen Anwendung auf eine Microservice-Architektur umstellen, verfolgen sie meist eine ganz bestimmte Reihe von Versprechen: schnellere Funktionsbereitstellung, unabhängige Skalierbarkeit, lokal begrenzte Fehlerisolation und die Freiheit, moderne Technologie-Stacks zu erproben …
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
Wenn Engineering-Teams von einer monolithischen Anwendung auf eine Microservice-Architektur umstellen, verfolgen sie meist eine ganz bestimmte Reihe von Versprechen: schnellere Funktionsbereitstellung, unabhängige Skalierbarkeit, lokal begrenzte Fehlerisolation und die Freiheit, moderne Technologie-Stacks zu erproben. Viele .NET-Organisationen stoßen jedoch an eine Wand, an der die Entwicklungsgeschwindigkeit praktisch zum Stillstand kommt. Statt eines flexiblen, lose gekoppelten Ökosystems betreiben sie einen Distributed Monolith – eine Architektur, die die betriebliche Komplexität verteilter Systeme mit der engen Kopplung eines klassischen Monolithen vereint.
Diese Herausforderung entsteht selten absichtlich. Sie schleicht sich meist über subtile Architekturentscheidungen ein, etwa wenn eine Datenbank von mehreren Services gemeinsam genutzt wird, synchrone HTTP-Aufrufe stark überwiegen oder die API-Governance zu einem administrativen Engpass wird. In diesem Beitrag betrachten wir die Symptome der Distributed-Monolith-Falle, decken die verborgenen Performance-Probleme in Ihren Netzwerkschichten auf, identifizieren architektonische Engpässe mit modernen Observability-Werkzeugen und zeigen praxisnahe Strategien, mit denen Sie unabhängige Skalierung in Ihren .NET-Microservices zurückgewinnen. Wenn Ihr Team die Reibungsverluste durch sinkende Liefergeschwindigkeiten bereits gespürt hat, sind Sie nicht allein. Diese Muster zu verstehen ist der erste Schritt, um Ihre Agilität zurückzugewinnen.
Microservice-Architektur: Verborgene Komplexität
Distributed Monoliths
Symptome
Vielleicht glauben Sie, dass die Aufteilung Ihrer Anwendung in Microservices Ihre Performance-Probleme automatisch löst. Tatsächlich kann dabei aber leicht ein Distributed Monolith entstehen. Das passiert, wenn Services in einem solchen Maß voneinander abhängen, dass Ihnen der eigentliche Nutzen der Trennung verloren geht. Folgende typische Symptome können Sie beobachten:
- Services sind für jeden gängigen Geschäftsvorgang auf synchrone Aufrufe angewiesen.
- Teams tun sich schwer, einzelne Änderungen auszurollen, ohne Ausfallzeiten zu riskieren oder nachgelagerte Services zu beschädigen.
- Gemeinsam genutzte Datenbanken zwingen Sie, Schemaänderungen über mehrere eigenständige Entwicklungsteams hinweg eng abzustimmen.
- Komponenten bleiben eng gekoppelt, obwohl sie physisch in getrennten Prozessen oder Containern laufen.
Auswirkungen auf die Geschwindigkeit
Ein Distributed Monolith kann Ihr System auf Weisen verlangsamen, die Sie zunächst nicht erwarten. Die Netzwerklatenz steigt, weil jeder einzelne Aufruf zwischen Services zusätzliche Verzögerung verursacht. Anders als bei einer monolithischen Anwendung, bei der Aufrufe unmittelbar im Arbeitsspeicher erfolgen, verlagert eine Microservice-Architektur die Performance-Engpässe von der Datenbank oder der CPU in die Netzwerkschicht. Synchrone Aufrufe zwischen Microservices summieren ihre Latenz, während ein Monolith diese Aufrufe innerhalb des Prozesses abwickelt. Dadurch verlieren Sie die Fähigkeit, Services unabhängig zu skalieren und Fehler wirksam zu isolieren. Die Performance-Probleme verstärken sich mit jeder Ebene, die Ihr Abhängigkeitsbaum wächst.
Wenn Sie eine monolithische Anwendung ohne saubere Grenzziehung verteilen, stoßen Sie häufig auf gravierende Performance-Probleme. Komponenten bleiben stark voneinander abhängig, und Sie profitieren nicht von der unabhängigen Skalierung und Fehlerisolation, die gut strukturierte Microservices bieten.
Koordinationsaufwand
API-Governance
Microservice-Architekturen erfordern eine starke API-Governance. Sie müssen jede Änderung prüfen und freigeben, damit sich keine technischen Schulden und doppelte Arbeit ansammeln. Ist die Governance zu streng, bremsen Sie die Entwicklung auf Schneckentempo. Ist sie zu lax, riskieren Sie, in kürzester Zeit strukturelle technische Schulden aufzubauen.
Wenn die Governance zu lax oder zu streng ist, kann das zu technischen Schulden, doppeltem Aufwand und einer erheblichen Verlangsamung der Entwicklung führen.
Im Grunde bauen Sie sehr schnell einen enormen Berg technischer Schulden auf. Und am Ende müssen Sie noch mehr Geld und Zeit investieren, um alles wieder herauszureißen und von vorne zu beginnen.
Gestalten Sie Ihre Governance-Modelle so, dass sie Entwicklerinnen und Entwickler aktiv unterstützen. Automatisierung hilft dabei, die Qualität, Sicherheit und Konsistenz von APIs zu verbessern, ohne zusätzlichen administrativen Ballast zu erzeugen.
Wenn Governance so gestaltet ist, dass sie Entwickler unterstützt, und durch Automatisierung gestützt wird, wirkt sie als Katalysator für eine bessere API-Qualität, mehr Sicherheit und mehr Konsistenz.
APIs spielen in Ihrer übergreifenden Geschäftsstrategie eine entscheidende Rolle. Sie müssen APIs als erstklassige Bürger behandeln.
Im aktuellen State of API Integration Report gaben 84 Prozent der Unternehmen an, dass APIs für ihre Kerngeschäftsstrategie kritisch oder sehr kritisch sind.
Teamzusammenarbeit
Microservices erfordern ständige Abstimmung zwischen Teams. Sie verbringen Stunden mit der Vorbereitung von Besprechungen, wechseln ständig den Kontext zwischen Domänen und klären teamübergreifende Rollen. Diese Aktivitäten können leicht einen großen Teil Ihrer Arbeitswoche beanspruchen.
| Faktoren der Koordinationskosten | Beschreibung |
|---|---|
| Entscheidungsverzögerung | Verzögerungen durch mehrere Beteiligte und umständliche Genehmigungsketten |
| Kontextwechsel | Zersplitterte Aufmerksamkeit durch zahlreiche bereichsübergreifende Abstimmungspunkte |
| Informationsverlust | Verlust oder Verfälschung wichtigen Wissens über organisatorische Ebenen hinweg |
| Unklare Rollen | Unklare Verantwortlichkeiten führen zu Lücken und doppelter Entwicklungsarbeit |
| Koordinationsaufwand | Zeitaufwand |
|---|---|
| Besprechungsvorbereitung | Mehr als 8 Stunden pro Woche |
| Koordinationsaktivitäten | 35–80 % der Arbeitszeit von Wissensarbeitern |
Sie müssen erkennen, dass der Koordinationsaufwand die Liefergeschwindigkeit unbemerkt untergraben kann. Klar definierte Verantwortungsbereiche und schlanke Kommunikationskanäle sind unverzichtbar, um Lücken und doppelte Arbeit zu vermeiden.
Herausforderungen im .NET-Ökosystem
Platform Engineering
Microservice-Architekturen im .NET-Ökosystem bringen besondere technische Herausforderungen mit sich. Sie stoßen häufig auf Code-Duplizierung und Redundanzen, die den Wartungsaufwand erhöhen und das Risiko inkonsistenter Daten steigern. Entwickler müssen oft übermäßig viel Boilerplate-Code schreiben, nur um die Infrastruktur zum Laufen zu bringen. Die Organisation des Quellcodes wird außerordentlich schwierig, wenn Domänenmodelle unsachgemäß über Services hinweg geteilt werden. Copy-and-paste-Anti-Patterns verzögern Fehlerbehebungen und erschweren die langfristige Wartung erheblich.
- Code-Duplizierung führt zu höheren laufenden Wartungskosten.
- Gemeinsam genutzte Modelle über Services hinweg machen Schema-Updates riskant.
- Entwickler kopieren möglicherweise Service-Logik, was wichtige Fehlerbehebungen verlangsamt.
Domänengrenzen
Sie müssen beim Aufbau von Microservices in .NET außerordentlich präzise Domänengrenzen definieren. Unterlassen Sie dies, steigt die kognitive Belastung der Entwickler drastisch. Zu viele gleichzeitige architektonische Anforderungen überfordern Ihr Team. Die Einhaltung von Standards und Compliance wird schwierig, was Zuverlässigkeitsprobleme verursachen und Ihre gesamte Sicherheitslage schwächen kann.
- Die kognitive Belastung steigt stark, wenn Entwickler mehrere miteinander verbundene Services parallel im Blick behalten müssen.
- Unternehmensstandards und Compliance lassen sich nur noch schwer konsistent durchsetzen.
- Zuverlässigkeit und Sicherheit leiden, wenn Domänengrenzen schlecht definiert sind.
Microservice-Architekturen bieten überzeugende Vorteile, doch Sie müssen ihre verborgene Komplexität aktiv angehen. Achten Sie auf Symptome eines verteilten Monolithen, steuern Sie Ihren Koordinationsaufwand und begegnen Sie den .NET-spezifischen Plattformherausforderungen direkt.
Tickende Zeitbombe: Performance-Probleme
Sie mögen annehmen, Microservices steigerten die Systemgeschwindigkeit automatisch, doch ohne sorgfältiges Design können sie zu einer tickenden Zeitbombe für Ihre Infrastruktur werden. Viele Engineering-Teams entdecken typische Performance-Probleme erst nach dem Deployment in die Produktion. Diese Probleme liegen verborgen unter der Oberfläche und warten darauf, Ihre Anwendung unter Spitzenlast auszubremsen. Sie sollten verstehen, wie Netzwerklatenz, kaskadierende Fehlerstellen und Datenbankkonflikte Ihre Architektur zu einer Quelle chronischer Frustration im Produktivbetrieb machen.
Netzwerklatenz
In-Process- vs. Netzwerkaufrufe
Wenn Sie einen Monolithen in Microservices aufteilen, wechseln Sie von Funktionsaufrufen innerhalb des Prozesses zu Netzwerkaufrufen. Diese architektonische Umstellung bringt unvermeidbare Latenz mit sich. In einer monolithischen Anwendung wird ein Funktionsaufruf nahezu augenblicklich aufgelöst. Bei Microservices muss jeder Aufruf zwischen Services durch das Netzwerk laufen und fügt Millisekunden an Verzögerung hinzu.
| Architekturtyp | Durchschnittliche Latenz |
|---|---|
| Funktionsaufruf innerhalb des Prozesses (Monolith) | 0,001 ms (1 Mikrosekunde) |
| HTTP-Aufruf im selben Rechenzentrum (Microservices) | 1–5 ms (1.000–5.000 Mikrosekunden) |
Netzwerkaufrufe sind um Größenordnungen langsamer als Funktionsaufrufe innerhalb eines Prozesses. Dieser Unterschied summiert sich rasch, je größer Ihr System wird. Jeder zusätzliche Dienst in einer Anforderungskette erhöht die Latenz und macht einfache Vorgänge für Endbenutzer zu langsamen, frustrierenden Erlebnissen.
Ressourcennutzung
Netzwerkaufrufe kosten nicht nur Latenz, sie verbrauchen auch wertvolle Systemressourcen. Jeder Aufruf beansprucht CPU-Zyklen, Speicherpuffer und Netzwerkbandbreite. Mit jedem weiteren Microservice wächst der Netzwerkverkehr exponentiell. Diese zusätzliche Last führt zu höheren Kosten für die Cloud-Infrastruktur und zu trägeren Antwortzeiten.
Sie können die Performance verbessern, indem Sie unnötige Aufrufe zwischen Diensten konsequent reduzieren. Einige fortgeschrittene Teams setzen intelligentes Traffic-Management ein, um Latenz zu senken und die Resilienz zu erhöhen:
- Der MCG-Ansatz verbesserte die Antwortzeiten um 15 % bei erhöhter Netzwerklatenz, da die Verzögerungen bei der Kommunikation zwischen Diensten sanken.
- Unter Spitzenlast zeigte das MCG-gestützte Setup im Vergleich zu standardmäßigen Service-Mesh-Konfigurationen eine höhere Resilienz mit weniger Fehlern.
- Performance-Auswertungen zeigten, dass intelligente Traffic-Platzierungsstrategien den Overhead der Sidecar-Proxys abmildern, die Antwortzeiten senken und den Durchsatz stabilisieren.
Sie sollten fortlaufend überwachen, wie sich der Netzwerkverkehr auf die Performance Ihres Systems auswirkt. Kleine, sich summierende Verzögerungen werden schnell zu großen Engpässen.
Fehlerquellen
Ausbreitungsrisiken
Microservices verändern das Fehlerprofil Ihres Systems grundlegend. Da jeder Dienst von anderen abhängt, kann sich ein einzelner Ausfall über Ihre gesamte Infrastruktur ausbreiten.
| Architekturtyp | Risiko der Fehlerausbreitung | Fehlerisolierung | Systemresilienz |
|---|---|---|---|
| Monolithisch | Hoch | Nein | Niedrig |
| Microservices | Niedrig | Ja | Hoch |
In einem monolithischen System kann ein einziger schwerwiegender Fehler den gesamten Anwendungsprozess zum Absturz bringen. Microservices bieten eine deutlich bessere Fehlerisolierung: Fällt ein nicht kritischer Dienst aus, können die übrigen weiterlaufen. Resilienzmuster wie Circuit Breaker verhindern, dass sich Fehler systemweit ausbreiten.
- In einem Monolithen kann ein einziger Fehler einen vollständigen Ausfall verursachen und so einen Single Point of Failure schaffen.
- Microservices ermöglichen echte Fehlertoleranz: Der Ausfall nicht kritischer Komponenten bringt die Plattform nicht zu Fall.
- Muster wie Circuit Breaker stärken die Resilienz, indem sie fehlerhafte nachgelagerte Abhängigkeiten isolieren.
Herausforderungen bei der Observability
Sie benötigen umfassende Observability, um Performance-Probleme in einem weitverzweigten Microservices-Netz zu erkennen und zu beheben. Die Ursache von Latenz oder sporadischen Fehlern aufzuspüren wird mit jedem zusätzlichen Dienst exponentiell schwieriger. Sie müssen Logs, Infrastrukturmetriken und verteilte Traces von jeder laufenden Instanz zusammenführen. Ohne leistungsfähige Observability-Werkzeuge verlieren Sie unzählige Stunden bei der Suche nach der Ursache von Produktionsverlangsamungen.
Typische Performance-Engpässe verbergen sich oft in komplexen, asynchronen Aufrufketten. Nutzen Sie verteiltes Tracing, um Anforderungen über Systemgrenzen hinweg zu verfolgen. So erkennen Sie Engpässe, bevor sie Ihre Benutzer beeinträchtigen.
Achten Sie auf diese klassischen Anti-Pattern:
- God Service (zu viel Verantwortung): Ein Dienst, der mehrere voneinander unabhängige Geschäftsbereiche abdeckt und damit zentrale Architekturprinzipien verletzt.
- Enge Kopplung zwischen Diensten: Direkte, fest codierte Abhängigkeiten, die nachgelagerte Systeme brechen, sobald sich ein Schema ändert.
Datenbankkonflikte
Gemeinsam genutzte Datenspeicher
Viele Teams machen den kritischen Fehler, eine Datenbank über mehrere Microservices hinweg zu teilen. Dadurch entsteht eine starke Kopplung über das Schema. Eine Änderung der Datenbankstruktur wird riskant, weil sie externe Dienste brechen kann, und das kostet Geschwindigkeit und die unabhängige Skalierbarkeit.
Das größte Problem gemeinsam genutzter Datenbanken ist, dass sie eine Kopplung über das Schema erzeugen. Die Kosten für Änderungen steigen stark, weil kaum noch abzusehen ist, wann sich Änderungen gefahrlos vornehmen lassen, ohne einen anderen Dienst zu beschädigen. Das wirkt sich wiederum auf die Skalierbarkeit des Systems aus. Dienste lassen sich nicht einzeln skalieren, wenn sie auf einen gemeinsamen Datenspeicher angewiesen sind. Da die Skalierbarkeit eines Dienstes durch seine langsamste Komponente begrenzt wird, wird eine gemeinsame Datenbank schnell zum massiven Engpass.
Sie sollten gemeinsam genutzte Datenspeicher vollständig abschaffen. Weisen Sie jedem Microservice eine eigene, dedizierte Datenbank zu, um Ihre Datenebenen zu entkoppeln und die Leistung wiederherzustellen.
Probleme bei der Skalierbarkeit
Datenbankkonflikte sind für Unternehmensanwendungen eine tickende Zeitbombe. Konkurrieren mehrere Microservices um dieselbe Datenbank-Engine, entsteht ein gravierender Leistungsengpass. Die langsamste Abfrage oder der langsamste Dienst begrenzt die Kapazität des gesamten Systems. Das führt zu erschöpften Verbindungspools, steigender Latenz und katastrophalen Ausfällen bei Lastspitzen.
Engpässe in der Microservices-Architektur erkennen
Überwachungstools
Metriken
Sie müssen die richtigen betrieblichen Metriken erfassen, um Leistungseinbußen frühzeitig zu erkennen. Metriken liefern eine Momentaufnahme Ihres Systemzustands und helfen Ihnen, Trends zu erkennen, bevor sie sich auf den Produktivbetrieb auswirken. Konzentrieren Sie sich stark auf geschäftsrelevante Kennzahlen neben technischen Metriken: Verfolgen Sie p99-Antwortzeiten, Fehlerraten und Anfragedurchsatz.
Transparenz
Transparenz ist für verteilte Systeme unverzichtbar. Was Sie nicht sehen, können Sie nicht beheben. Implementieren Sie Überwachungstools, die Telemetriedaten von jeder Dienstinstanz erfassen:
- Prometheus, Datadog und Grafana für die Echtzeitüberwachung von Infrastruktur und Anwendungen.
- Elasticsearch, Logstash, Kibana (ELK) oder Graylog für die zentralisierte Protokollaggregation.
- Tools für die Anwendungsleistungsüberwachung (Application Performance Monitoring, APM) wie New Relic oder Dynatrace für die Profilerstellung von Aufrufen auf Code-Ebene.
- Kubernetes oder andere Container-Orchestratoren für die Beobachtbarkeit des zugrunde liegenden Clusters.
- API-Gateways wie Kong oder Zuul für die Analyse des Edge-Datenverkehrs.
Verteiltes Tracing
Anfrageflüsse
Verteiltes Tracing ermöglicht es Ihnen, eine HTTP-Anfrage nachzuverfolgen, während sie Ihre Microservice-Architektur durchläuft. Tracing-Tools wie OpenTelemetry, Jaeger und Zipkin verknüpfen diese Aufrufe miteinander, zeigen den durchgängigen Ausführungspfad an und heben genaue Latenz-Hotspots hervor.
- Verteiltes Tracing bietet tiefgehende Einblicke über Dienstgrenzen hinweg.
- Es legt verborgene Engpässe offen und beschleunigt Debugging-Abläufe erheblich.
- Entwicklungsteams nutzen Traces, um Latenzquellen aufzuspüren und die Zuverlässigkeit zu verbessern.
Latenzquellen
Die Latenz summiert sich, wenn Anfragen mehrere Dienste durchlaufen. Standardprotokolle und Infrastrukturmetriken allein können diese Granularität auf Transaktionsebene nicht abbilden. Tracing bewahrt den Anfragekontext über Netzwerkübergänge hinweg, sodass Sie genau die Methode oder Datenbankabfrage identifizieren können, die die Verlangsamung verursacht.
Versteckte Verlangsamungen erkennen
Symptome
Versteckte Verlangsamungen können die Benutzererfahrung beeinträchtigen, auch wenn es zu keinen vollständigen Ausfällen kommt. Achten Sie auf steigende Antwortzeiten, erhöhte Fehlerraten und einen wachsenden Speicherbedarf. Verwenden Sie Korrelations-IDs, um Anfragen durch Ihre Systeme zu verfolgen, und richten Sie auf Basis strenger Service-Level-Objectives (SLOs) proaktive Benachrichtigungen ein.
Praxisbeispiele
Praxisnahe Fallstudien aus der Softwareentwicklung zeigen, wie wichtig die frühzeitige Erkennung von Engpässen ist. Ein Beispiel: Ein stark ausgelasteter Spring-Boot-Microservice litt unter gravierenden Leistungseinbußen. Mithilfe von APM- und Profiling-Tools entdeckte das Entwicklungsteam eine nicht optimierte Abfrageschleife. Durch eine spezielle Klausel, mit der sich Datenbankoperationen bündeln ließen, sank die Zahl der Abfragen pro Sekunde von 300 auf 30. Dadurch stabilisierten sich die CPU-Auslastung und der Garbage-Collection-Aufwand sofort.
Tipp: Kombinieren Sie Metriken, Protokolle und Traces immer in einer einheitlichen Observability-Pipeline. Diese Kombination verschafft Ihnen einen unmittelbaren, ganzheitlichen Blick auf den Zustand Ihres Systems.
Lösungen für Leistungsprobleme bei Microservices
Asynchrone Kommunikation
Vorteile von Nachrichtenaustausch
Viele Skalierungshürden in einer Microservice-Architektur lassen sich mit asynchroner Kommunikation lösen. Indem Sie Anfragen über Nachrichtenwarteschlangen entkoppeln, verarbeiten Dienste Aufgaben in ihrem eigenen Tempo. Verkehrsspitzen fangen sie so ab, ohne Anfragen zu verwerfen.
| Leistungssteigerung | Beschreibung |
|---|---|
| Skalierbarkeit | Asynchrone Nachrichtenübermittlung ermöglicht eine massive Skalierung, indem Warteschlangen Verkehrsspitzen abfedern. |
| Zuverlässigkeit | Asynchrone Broker unterstützen Nachrichtenwiederholungen und Dead-Letter-Warteschlangen. So lässt sich der Verlust von Nachrichten bei Ausfallzeiten praktisch ausschließen. |
| Testbarkeit | Tests werden einfacher, weil konsumierende Dienste für die Überprüfung der Nutzdaten lediglich eine Mock-Warteschlange benötigen. |
Umsetzung
Implementieren Sie asynchrone Kommunikation mit leistungsfähigen Nachrichtenbrokern wie RabbitMQ, Azure Service Bus oder Apache Kafka. Mit Publish-Subscribe-Mustern verteilen Sie Domänenereignisse sauber an unabhängige Dienste.
Schott-Muster & Circuit Breaker
Isolationsstrategien
Schützen Sie Ihre Microservices mit Schotten und Circuit Breakern vor kaskadierenden Ausfällen. Schotten unterteilen Ressourcenpools, sodass ein Fehler in einem Dienst nicht die Threads oder Verbindungen des gesamten Systems erschöpfen kann.
Schotten isolieren Fehlerdomänen, indem sie für verschiedene Dienste getrennte Ressourcenpools oder Kontingente einrichten. So verhindern sie, dass lokal begrenzte Fehler die gesamte Anwendung lahmlegen.
Fehlerbehebung
Circuit Breaker überwachen Fehlerraten und weisen Anfragen an fehlerhafte Abhängigkeiten sofort ab. So verhindern sie kaskadierende Ausfälle im gesamten Netzwerk.
Das Schott-Muster in der Microservice-Architektur dient dazu, Fehler in einem Teil des Systems daran zu hindern, die gesamte Plattform zum Absturz zu bringen. Dadurch werden Fehler direkt an ihrem Ursprung isoliert.
Caching & Skalierung
Auswahl des Datenspeichers
Caching ist ein unverzichtbares Werkzeug für leistungsstarke Microservices. Lagern Sie wiederholte Datenbankabfragen und aufwendige API-Berechnungen in schnelle In-Memory-Caches wie Redis oder Memcached aus.
| Vorteil | Beschreibung |
|---|---|
| Feinkörnige Steuerung | Cachen Sie Domänenfragmente abhängig von ihrer Volatilität und Aktualisierungshäufigkeit. |
| Weniger Cache-Invalidierung | Reduziert den Aufwand für das Leeren des Caches, da nur betroffene Datensegmente aktualisiert werden. |
| Bessere Cache-Trefferquoten | Ermöglicht kleinere, stark optimierte Cache-Einträge für höhere Trefferquoten im Arbeitsspeicher. |
| Behandlung dynamischer und statischer Inhalte | Unterstützt das Caching statischer Datensätze bei gleichzeitigem dynamischen Abruf von Echtzeitstatistiken. |
Unabhängige Skalierung
Caching und getrennte Datenspeicher ermöglichen es Ihnen, einzelne Dienste unabhängig voneinander zu skalieren. So beseitigen Sie Engpässe durch konkurrierende Ressourcenzugriffe.
- Verbesserte Skalierbarkeit des Systems
- Höhere Entwicklungsagilität und kürzere Time-to-Market
- Robuste Fehlerisolierung und Systemresilienz
- Kosteneffiziente Nutzung von Cloud-Ressourcen
- Bessere DevOps-Integration und kontinuierliche Bereitstellungspipelines
Abhängigkeiten reduzieren
Entkopplung
Echte Microservices erfordern eine konsequente Entkopplung. Arbeiten Dienste unabhängig voneinander und ohne blockierende synchrone Aufrufe, beseitigen Sie künstliche Engpässe.
Entkopplung bedeutet, dass jeder Microservice seine interne Arbeitslast bearbeitet, ohne synchron auf externe Prozesse zu warten. Diese Unabhängigkeit vermeidet Engpässe und sorgt dafür, dass Ihre Plattform reibungslos läuft.
Zu den wichtigsten architektonischen Vorteilen einer reduzierten Abhängigkeit gehören:
- Unabhängige Skalierung der Dienste auf Basis der Echtzeitlast.
- Geringeres Risiko kaskadierender Ausfälle über Teamgrenzen hinweg.
- Autonomie für Entwicklungsteams, die Code nach eigenem Zeitplan ausliefern.
- Schnellere Ursachenanalyse bei der Incident-Response.
Vereinfachung
Ein vereinfachter Abhängigkeitsgraph reduziert die kognitive Last. Dadurch lässt sich Ihre Architektur deutlich einfacher testen, überwachen und absichern.
| Ansatz | Was es bedeutet | Warum es wichtig ist |
|---|---|---|
| Individuelle SLOs | Zuverlässigkeit jedes Microservices separat erfassen | Können systemweite Verschlechterungen der Nutzererfahrung übersehen |
| Zusammengesetzte SLOs | Zuverlässigkeitsziele über voneinander abhängige Dienste hinweg kombinieren | Bilden die tatsächliche Ende-zu-Ende-Systemgesundheit ab |
Eignung der Microservice-Architektur bewerten
Die Wahl des richtigen Architekturmodells bestimmt Ihr Entwicklungstempo und Ihre Betriebskosten. Der Microsoft Development Podcast greift diese Spannung immer wieder auf und zeigt einen wachsenden Trend: Organisationen führen überfragmentierte Microservices zurück in überschaubare modulare Monolithen.
Entscheidungsmatrix
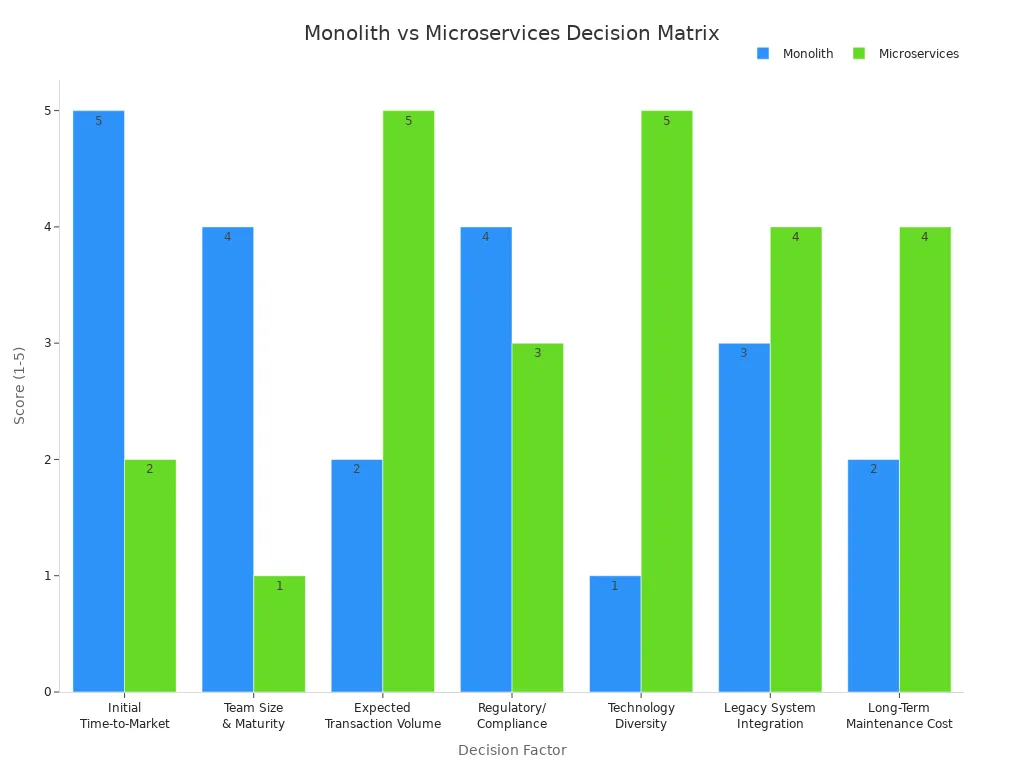
Nutzen Sie eine strukturierte Entscheidungsmatrix, um zu prüfen, ob Microservices wirklich zur Reife Ihrer Organisation passen:
| Entscheidungsfaktor | Monolith-Bewertung (1–5) | Microservices-Bewertung (1–5) | Strategische Begründung |
|---|---|---|---|
| Anfängliche Time-to-Market (Geschwindigkeit) | 5 | 2 | Monolithen erfordern nur minimale Infrastrukturkonfiguration zu Beginn. |
| Teamgröße und Reife (DevOps) | 4 | 1 | Microservices setzen fortgeschrittene CI/CD, Automatisierung und Observability voraus. |
| Erwartetes Transaktionsvolumen (Skalierung) | 2 | 5 | Microservices ermöglichen präzises, unabhängiges Skalieren ressourcenintensiver Engpässe. |
| Regulatorische Anforderungen und Compliance-Komplexität | 4 | 3 | Einzelne Artefakte vereinfachen das initiale Sicherheitsaudit und die Compliance-Prüfungen. |
| Technologievielfalt und Experimentierfreude | 1 | 5 | Microservices ermöglichen es Teams, pro Service-Domäne spezialisierte Technologie-Stacks einzusetzen. |
| Integration von Altsystemen | 3 | 4 | Microservices eignen sich hervorragend, um Legacy-Komponenten zu kapseln und zu modernisieren. |
| Langfristige Wartungskosten (TCO) | 2 | 4 | Microservices senken die Kosten pro Funktion über die Zeit, dafür steigt der operative Aufwand. |
Zentrale Bewertungsfragen
- Verfügt Ihr Entwicklungsteam über fundierte DevOps-, Platform-Engineering- und SRE-Kenntnisse?
- Haben Sie extreme Skalierungsanforderungen, die den Mehraufwand verteilter Systeme rechtfertigen?
- Benötigen Sie Polyglot Persistence und Technologievielfalt?
- Ist Ihre Organisationskultur bereit, den hohen Abstimmungsaufwand zwischen Teams zu bewältigen?
Warnsignale für eine Neubewertung
Achten Sie auf diese Warnsignale, die auf eine notwendige Umstrukturierung Ihrer Microservice-Architektur hindeuten:
- Die Liefergeschwindigkeit kommt durch ständige teamübergreifende Abhängigkeiten zum Erliegen.
- Die Betriebskosten für die Cloud wachsen schneller als der Geschäftsumsatz.
- Ausfälle breiten sich leicht über mehrere Domänen hinweg aus.
Monolith vs. Microservices
| Architekturtyp | Empfohlene Teamgröße | Wesentliche Merkmale |
|---|---|---|
| Monolithisch | < 8–10 Entwickler | Einfache Bereitstellungen, geringer Betriebsaufwand |
| Microservices | > 10–15 Entwickler | Unabhängige Teamautonomie, komplexe verteilte Abstimmung |
Bei der Einführung einer Microservice-Architektur sehen Sie sich versteckter Komplexität und Performance-Risiken gegenüber. Engpässe treten immer wieder an unerwarteten Stellen in der Netzwerk- und Datenschicht auf. Der Microsoft Development Podcast zeigt, dass schnelle Auslieferung eine konsequente Architekturdisziplin erfordert. Damit Ihre .NET-Systeme gesund bleiben, sollten Sie Folgendes beachten:
- Anfragen zwischen Services und Timeout-Richtlinien sorgfältig steuern.
- Elastisches Load Balancing und automatisierte Skalierung implementieren.
- Datenspeicher entkoppeln, sodass jeder Service seine eigene Datenbank besitzt.
- Wiederkehrende API- und Datenbankabfragen konsequent cachen.
Darüber hinaus sollten Sie architektonische Governance durchsetzen, robuste API-Gateways einsetzen und regelmäßige Architekturreviews durchführen. Eine kontinuierliche Bewertung stellt sicher, dass Ihr Technologie-Stack mit Ihrem Geschäft effektiv mitwächst.
Häufige Fragen
Was ist ein verteilter Monolith?
Ein verteilter Monolith ist ein Anti-Pattern, bei dem eine Anwendung physisch in mehrere Microservices aufgeteilt wird, logisch aber durch synchrone HTTP-Aufrufe, gemeinsam genutzte Datenbanken und enge Bereitstellungsabhängigkeiten gekoppelt bleibt. Damit gehen die zentralen Vorteile von Microservices verloren.
Wie erkennen Sie Performance-Engpässe in Microservices?
Überwachen Sie die p99-Antwortzeiten, Fehlerraten und den Anfragedurchsatz. Nutzen Sie Tools für verteiltes Tracing, um Anfragen über Service-Grenzen hinweg nachzuverfolgen und langsame Netzwerkabschnitte oder Datenbankabfragen zu identifizieren.
Warum ist Netzwerklatenz in einer Microservice-Architektur relevant?
Netzwerklatenz verursacht bei jedem Aufruf zwischen Services eine Verzögerung im Millisekundenbereich. Anders als die unmittelbaren Speicheraufrufe innerhalb eines Prozesses bei einem Monolithen summieren sich verteilte Netzwerkabschnitte schnell und verschlechtern die Reaktionsfähigkeit der gesamten Anwendung.
Wie lässt sich der Koordinationsaufwand zwischen Teams reduzieren?
Definieren Sie klare Grenzen für die Domänenverantwortung, automatisieren Sie API-Governance-Prüfungen, reduzieren Sie unnötige Statusbesprechungen und setzen Sie auf asynchrone Kommunikation, damit Teams eigenständig arbeiten können.
Welche Tools unterstützen die Observability in .NET-Microservices?
Zu den gängigen Observability-Tools gehören Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin und zentralisierte Logging-Plattformen wie der ELK-Stack. Gemeinsam erfassen sie Metriken, Logs und verteilte Traces.
Wann sollten Sie eine Konsolidierung von Microservices in Betracht ziehen?
Ziehen Sie eine Konsolidierung in Betracht, wenn die Geschwindigkeit bei der Auslieferung neuer Funktionen nachlässt, die Kosten für die Cloud-Infrastruktur außer Kontrolle geraten oder kaskadierende Ausfälle regelmäßig Ihre Verfügbarkeit beeinträchtigen.
Wie gehen Sie am besten mit gemeinsam genutzten Daten in Microservices um?
Geben Sie jedem Microservice eine eigene, private Datenbank. Vermeiden Sie es, Datenbanken zwischen Diensten zu teilen. So beseitigen Sie die Kopplung über Schemas und stellen die unabhängige Skalierbarkeit der Datenbanken wieder her.
Wie verbessert asynchrone Kommunikation die Performance von Microservices?
Asynchrone Kommunikation über Message Broker ermöglicht es Diensten, Ereignisse in ihrem eigenen Tempo zu verarbeiten. So werden Lastspitzen abgefedert und blockierende synchrone Engpässe beseitigt.
🎧 Diese Folge anhören
Möchten Sie eine praxisnahe, detaillierte Erklärung zu Why Microservice Architecture Slows Software Delivery? Diese Folge erläutert die zentralen Architekturthemen in verständlicher Sprache und zeigt, warum sie für Microsoft 365, Azure, Power Platform, die Sicherheit im Unternehmen, KI und moderne Softwareentwicklung wichtig sind.
Hören Sie sich diese Folge an, wenn Sie Folgendes möchten:
- Die grundlegenden Konzepte verstehen, warum Microservices die Auslieferung von Software verlangsamen können
- Sehen, wie sich die Architektur in das breitere Microsoft-Technologie-Ökosystem einfügt
- Erfahren, wo sie für Ihre Organisation praktischen, messbaren Mehrwert schaffen kann
Diese verwandten M365 FM-Folgen könnten Sie ebenfalls interessieren:
- Der Monorepo-Mythos: Warum Ihre Architektur fragmentiert ist
- Microsoft Graph Automation Architecture: Beyond Scripts
- Graph-basierte KI-Agenten: Ein Architekturleitfaden für Unternehmen
- .NET-Erweiterbarkeit und Clean Architecture mit Miguel Castro [MVP]
- Enterprise AI Agent Fabric: Architecture Beyond Chatbots
Entdecken Sie weitere praxisnahe Gespräche zu Microsoft-Engineering auf M365 FM.