 PT
 English
 Deutsch
 Español
 Français
 Italiano
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Como evitar a armadilha do monólito distribuído em microsserviços .NET
By Mirko Peters ·
Quando equipes de engenharia migram de uma aplicação monolítica para uma arquitetura de microsserviços, normalmente estão buscando um conjunto muito específico de promessas: entrega de funcionalidades mais rápida, escalabilidade independente, isolamento localizado de falhas e liberdade para experimentar stacks tecnológicas modernas. No entanto, muitas organizações .NET batem em uma parede em que a
Automatically translated with AI from the original post. Read the English original
Quando equipes de engenharia migram de uma aplicação monolítica para uma arquitetura de microsserviços, normalmente estão buscando um conjunto muito específico de promessas: entrega de funcionalidades mais rápida, escalabilidade independente, isolamento localizado de falhas e liberdade para experimentar stacks tecnológicas modernas. No entanto, muitas organizações .NET batem em uma parede em que a velocidade de desenvolvimento simplesmente para. Em vez de um ecossistema ágil e fracamente acoplado, acabam mantendo um monólito distribuído: uma arquitetura que combina a complexidade operacional de sistemas distribuídos com o acoplamento forte de um monólito tradicional.
Esse problema raramente é malicioso ou intencional. Normalmente ele se instala por meio de escolhas arquiteturais sutis, como compartilhar um banco de dados entre vários serviços, depender fortemente de chamadas HTTP síncronas ou deixar que a governança de APIs se torne um gargalo administrativo. Neste post, vamos explorar os sintomas da armadilha do monólito distribuído, descobrir os problemas de desempenho escondidos nas suas camadas de rede, identificar gargalos arquiteturais com ferramentas modernas de observabilidade e percorrer estratégias práticas para recuperar a escalabilidade independente nos seus microsserviços .NET. Se sua equipe já sentiu o atrito de entregas cada vez mais lentas, você não está sozinho, e entender esses padrões é o primeiro passo para recuperar sua agilidade.
Arquitetura de microsserviços: complexidade oculta
Monólitos distribuídos
Sintomas
Você pode achar que dividir sua aplicação em microsserviços vai resolver automaticamente seus problemas de desempenho. No entanto, é fácil acabar com um monólito distribuído. Isso acontece quando os serviços dependem uns dos outros a ponto de você perder os verdadeiros benefícios da separação. Você pode notar estes sintomas comuns:
- Os serviços dependem de chamadas síncronas para toda operação de negócio padrão.
- As equipes têm dificuldade para implantar mudanças individuais sem arriscar indisponibilidade ou quebrar serviços dependentes.
- Bancos de dados compartilhados obrigam você a coordenar de forma apertada as mudanças de esquema entre várias equipes de desenvolvimento distintas.
- Os componentes continuam fortemente acoplados, mesmo rodando fisicamente em processos ou contêineres separados.
Impacto na velocidade
Um monólito distribuído pode deixar seu sistema mais lento de maneiras que você não espera inicialmente. A latência de rede vai aumentar, porque cada chamada entre serviços acrescenta atraso. Diferente de uma aplicação monolítica, em que as chamadas acontecem instantaneamente na memória, uma arquitetura de microsserviços desloca os gargalos de desempenho do banco de dados ou da CPU para a camada de rede. Chamadas síncronas entre microsserviços acumulam latência, enquanto um monólito trata essas chamadas dentro do próprio processo. Como consequência, você perde a capacidade de escalar serviços de forma independente e de isolar falhas com eficácia, fazendo com que os desafios de desempenho se agravem à medida que a árvore de dependências cresce.
Quando você tenta distribuir uma aplicação monolítica sem um desenho adequado de limites, normalmente enfrenta sérios desafios de desempenho. Os componentes continuam altamente dependentes uns dos outros, e você não obtém os benefícios de escalabilidade independente ou de isolamento de falhas que microsserviços bem estruturados oferecem.
Sobrecarga de coordenação
Governança de APIs
A arquitetura de microsserviços exige uma governança de APIs sólida. Você precisa revisar e aprovar cada mudança para evitar o acúmulo de dívida técnica e de esforços duplicados. Se a governança for rígida demais, o desenvolvimento desacelera ao extremo. Se for frouxa demais, você corre o risco de acumular dívida técnica estrutural quase da noite para o dia.
Quando a governança é frouxa ou rígida demais, ela pode levar a dívida técnica, esforços duplicados e grandes lentidões no processo de desenvolvimento.
Na essência, você está acumulando dívida técnica muito rapidamente. E, no fim, você precisa gastar mais dinheiro e mais tempo para arrancar tudo isso e começar de novo.
Você precisa desenhar seus modelos de governança para beneficiar ativamente os desenvolvedores. A automação ajuda a melhorar a qualidade, a segurança e a consistência das APIs sem acrescentar peso administrativo.
Quando a governança é projetada para beneficiar os desenvolvedores e reforçada com automação, ela funciona como um catalisador para melhorar a qualidade, a segurança e a consistência das APIs.
As APIs desempenham um papel fundamental na estratégia de negócios como um todo. Você precisa tratá-las como cidadãs de primeira classe.
No mais recente relatório sobre o estado da integração de APIs, 84% das empresas afirmaram que as APIs são críticas ou muito críticas para a sua estratégia de negócios principal.
Colaboração entre equipes
Microsserviços exigem coordenação constante entre as equipes. Você passa horas preparando reuniões, alternando contextos entre domínios e esclarecendo papéis entre equipes. Essas atividades podem facilmente consumir uma grande parte da sua semana de trabalho.
| Fatores de custo de coordenação | Descrição |
|---|---|
| Latência nas decisões | Atrasos causados por múltiplas partes interessadas e cadeias de aprovação complicadas |
| Troca de contexto | Atenção fragmentada entre diversos pontos de coordenação interfuncional |
| Degradação da informação | Perda ou distorção de conhecimento crítico ao longo das camadas organizacionais |
| Ambiguidade de papéis | Responsabilidade pouco clara, gerando lacunas e esforços de desenvolvimento duplicados |
| Atividade de coordenação | Tempo gasto |
|---|---|
| Preparação de reuniões | Mais de 8 horas por semana |
| Atividades de coordenação | 35-80% do tempo dos trabalhadores do conhecimento |
Você precisa reconhecer que a sobrecarga de coordenação pode sabotar silenciosamente a velocidade de entrega. Limites de responsabilidade claros e canais de comunicação simplificados são indispensáveis para evitar lacunas e esforços duplicados.
Desafios do ecossistema .NET
Engenharia de plataforma
A arquitetura de microsserviços no ecossistema .NET traz desafios de engenharia específicos. Você frequentemente enfrenta duplicação de código e redundâncias, que aumentam o esforço de manutenção e o risco de inconsistências de dados. Os desenvolvedores muitas vezes lidam com uma quantidade excessiva de código boilerplate apenas para colocar a infraestrutura em funcionamento. Organizar o código-fonte torna-se extremamente difícil quando você compartilha modelos de domínio entre serviços de forma inadequada. Os antipadrões de copiar e colar atrasam correções de bugs e complicam significativamente a manutenção de longo prazo.
- A duplicação de código leva a custos de manutenção contínua mais altos.
- Modelos compartilhados entre serviços tornam as atualizações de esquema arriscadas.
- Desenvolvedores podem copiar e colar a lógica de serviços, o que retarda correções críticas de bugs.
Limites de domínio
Você precisa definir limites de domínio extremamente bem delimitados ao construir microsserviços em .NET. Se não fizer isso, aumenta drasticamente a carga cognitiva dos desenvolvedores. Demandas arquiteturais simultâneas em excesso sobrecarregam a sua equipe. Manter padrões e conformidade torna-se difícil, o que pode causar problemas de confiabilidade e enfraquecer a sua postura geral de segurança.
- A carga cognitiva aumenta bruscamente quando os desenvolvedores precisam lidar com múltiplos serviços interconectados.
- Padrões e conformidade corporativa ficam mais difíceis de aplicar de forma consistente.
- A confiabilidade e a segurança são prejudicadas quando os limites de domínio são mal definidos.
Embora a arquitetura de microsserviços ofereça benefícios atraentes, você precisa tratar proativamente a sua complexidade oculta. Fique atento aos sintomas de monólito distribuído, gerencie a sobrecarga de coordenação e enfrente de frente os desafios de plataforma específicos do .NET.
Bomba-relógio: problemas de desempenho
Você pode presumir que microsserviços vão, por natureza, acelerar o sistema, mas sem um design rigoroso eles podem se tornar uma bomba-relógio para a sua infraestrutura. Muitas equipes de engenharia descobrem problemas comuns de desempenho apenas depois de implantar em produção. Esses problemas ficam ocultos, esperando para derrubar a sua aplicação sob carga de pico. Você precisa entender como a latência de rede, os pontos de falha em cascata e a contenção de banco de dados transformam a sua arquitetura em uma fonte de frustração crônica em produção.
Latência de rede
Chamadas em processo vs. chamadas de rede
Quando você divide um monólito em microsserviços, passa de chamadas de função em processo para chamadas de rede. Essa mudança arquitetural introduz uma latência inevitável. Em uma aplicação monolítica, uma chamada de função é resolvida quase instantaneamente. Em microsserviços, cada chamada entre serviços precisa atravessar a rede, adicionando milissegundos de atraso.
| Tipo de arquitetura | Latência média |
|---|---|
| Chamada de função em processo (monólito) | 0,001 ms (1 microssegundo) |
| Chamada HTTP dentro do mesmo datacenter (microsserviços) | 1-5 ms (1.000-5.000 microssegundos) |
Chamadas de rede são ordens de grandeza mais lentas do que chamadas de função em processo. Essa diferença se acumula rapidamente conforme o sistema cresce. Cada novo serviço inserido em uma cadeia de requisições adiciona mais latência, transformando operações simples em experiências lentas e frustrantes para os usuários finais.
Uso de recursos
As chamadas de rede fazem mais do que apenas adicionar latência; elas consomem recursos valiosos do sistema. Cada chamada consome ciclos de CPU, buffers de memória e largura de banda de rede. Conforme você adiciona mais microsserviços, o tráfego de rede cresce de forma exponencial. Essa carga extra leva a custos mais altos de infraestrutura na nuvem e a tempos de resposta mais lentos.
Você pode melhorar o desempenho reduzindo de forma agressiva as chamadas desnecessárias entre serviços. Algumas equipes mais avançadas usam gerenciamento inteligente de tráfego para reduzir a latência e aumentar a resiliência:
- A abordagem MCG melhorou os tempos de resposta em 15% sob maior latência de rede, devido à redução dos atrasos na comunicação entre serviços.
- Em condições de pico de carga, a configuração com MCG apresentou resiliência superior, com menos taxas de erro em comparação com configurações padrão de service mesh.
- Avaliações de desempenho demonstraram que estratégias inteligentes de posicionamento de tráfego atenuaram a sobrecarga dos sidecar proxies, reduzindo os tempos de resposta e estabilizando a vazão.
Você precisa monitorar continuamente como o tráfego de rede afeta o desempenho do sistema. Pequenos atrasos acumulados facilmente se transformam em grandes gargalos.
Pontos de falha
Riscos de propagação
Microsserviços mudam fundamentalmente o perfil de falhas do seu sistema. Como cada serviço depende de outros, uma única falha pode se propagar por toda a sua infraestrutura.
| Tipo de arquitetura | Risco de propagação de falhas | Isolamento de falhas | Resiliência do sistema |
|---|---|---|---|
| Monolítica | Alto | Não | Baixa |
| Microsserviços | Baixo | Sim | Alta |
Em um sistema monolítico, um único bug fatal pode derrubar todo o processo da aplicação. Microsserviços oferecem um isolamento de falhas muito melhor: se um serviço não crítico falhar, os demais podem continuar em execução. Padrões de resiliência, como circuit breakers, ajudam a impedir que falhas se espalhem globalmente.
- Em um monolito, um único bug pode causar uma indisponibilidade completa, criando um ponto único de falha.
- Microsserviços permitem uma tolerância a falhas real, garantindo que falhas em componentes não críticos não derrubem a plataforma.
- Padrões como circuit breakers aumentam a resiliência ao isolar dependências downstream que estão falhando.
Desafios de observabilidade
Você precisa de observabilidade abrangente para detectar e corrigir problemas de desempenho em uma malha extensa de microsserviços. Descobrir a causa raiz de latência ou de erros intermitentes fica exponencialmente mais difícil conforme os serviços se multiplicam. Você precisa agregar logs, métricas de infraestrutura e rastreamentos distribuídos de cada instância em execução. Sem ferramentas robustas de observabilidade, você vai perder incontáveis horas procurando a origem das lentidões em produção.
Gargalos de desempenho comuns frequentemente se escondem em cadeias de chamadas complexas e assíncronas. Você deve usar rastreamento distribuído para acompanhar as requisições através das fronteiras entre serviços, o que permite identificar gargalos antes que eles afetem os usuários.
Fique atento a estes antipadrões clássicos:
- God Service (responsabilidade excessiva): um serviço que cuida de múltiplos domínios de negócio distintos, violando princípios arquiteturais fundamentais.
- Acoplamento forte entre serviços: dependências diretas e fixas no código que quebram sistemas downstream sempre que um schema muda.
Contenção no banco de dados
Repositórios de dados compartilhados
Muitas equipes cometem o erro crítico de compartilhar um banco de dados entre vários microsserviços. Essa prática cria um acoplamento severo pelo schema. Alterar a estrutura do banco se torna arriscado, porque pode quebrar serviços externos, comprometendo a sua velocidade de entrega e a escalabilidade independente.
O principal problema dos bancos de dados compartilhados é que eles criam acoplamento por esquema. O custo de mudança aumenta drasticamente, pois fica difícil saber quando é seguro fazer alterações sem quebrar outro serviço. Isso tem efeitos em cascata sobre a escalabilidade do sistema. Você não consegue escalar serviços individualmente quando eles dependem de um armazenamento de dados compartilhado. Como a escalabilidade de um serviço é limitada pelo seu componente mais lento, um banco de dados compartilhado rapidamente se torna um gargalo enorme.
Você deve eliminar por completo os armazenamentos de dados compartilhados. Atribua a cada microsserviço o seu próprio banco de dados dedicado para desacoplar as camadas de dados e restaurar o desempenho.
Problemas de Escalabilidade
A contenção de banco de dados é uma bomba-relógio para aplicações corporativas. Quando vários microsserviços disputam o mesmo mecanismo de banco de dados, você cria um forte gargalo de desempenho. A consulta ou o serviço mais lento limita a capacidade de todo o sistema, levando ao esgotamento do pool de conexões, ao aumento da latência e a interrupções catastróficas durante picos de tráfego.
Identificando Gargalos em Arquiteturas de Microsserviços
Ferramentas de Monitoramento
Métricas
Você precisa acompanhar as métricas operacionais certas para identificar a degradação de desempenho logo no início. As métricas oferecem um retrato instantâneo da saúde do seu sistema, ajudando você a detectar tendências antes que afetem a produção. Concentre-se fortemente em indicadores relevantes para o negócio, junto com as métricas técnicas: acompanhe os tempos de resposta p99, as taxas de erro e a vazão de requisições.
Visibilidade
A visibilidade é indispensável em sistemas distribuídos. Você não consegue corrigir o que não consegue ver. Implemente ferramentas de monitoramento que ingiram telemetria de todas as instâncias de serviço:
- Prometheus, Datadog e Grafana para monitoramento em tempo real de infraestrutura e aplicações.
- Elasticsearch, Logstash, Kibana (ELK) ou Graylog para agregação centralizada de logs.
- Ferramentas de Application Performance Monitoring (APM), como New Relic ou Dynatrace, para o perfilamento de chamadas no nível do código.
- Kubernetes ou orquestradores de contêineres para a observabilidade do cluster subjacente.
- Gateways de API, como Kong ou Zuul, para análise do tráfego de borda.
Rastreamento Distribuído
Fluxos de Requisições
O rastreamento distribuído permite acompanhar uma requisição HTTP à medida que ela percorre a sua arquitetura de microsserviços. Ferramentas de rastreamento, como OpenTelemetry, Jaeger e Zipkin, conectam essas chamadas, exibindo o caminho de execução de ponta a ponta e destacando os pontos exatos de latência.
- O rastreamento distribuído oferece visibilidade profunda através dos limites entre serviços.
- Ele expõe gargalos ocultos e acelera drasticamente os fluxos de depuração.
- Equipes de engenharia usam os rastreamentos para descobrir as origens da latência e melhorar a confiabilidade.
Origens da Latência
A latência se acumula à medida que as requisições passam de um serviço para outro. Logs padrão e métricas de infraestrutura, isoladamente, não conseguem mostrar esse nível de granularidade transacional. O rastreamento preserva o contexto da requisição ao longo dos saltos de rede, para que você identifique com precisão o método ou a consulta ao banco de dados que causa a lentidão.
Identificando Lentidões Ocultas
Sintomas
Lentidões ocultas podem prejudicar a experiência do usuário, mesmo na ausência de interrupções totais. Fique atento ao aumento dos tempos de resposta, das taxas de erro e do consumo de memória. Use IDs de correlação para rastrear requisições pelos seus sistemas e configure alertas proativos com base em objetivos de nível de serviço (SLOs) rigorosos.
Casos Reais
Estudos de caso reais de engenharia destacam a importância da detecção proativa de gargalos. Por exemplo, um microsserviço Spring Boot de alta carga sofreu uma degradação severa de desempenho. Por meio de ferramentas profundas de APM e perfilamento, a equipe de engenharia descobriu um loop de consultas não otimizado. Ao introduzir uma cláusula específica para agrupar as operações de banco de dados, eles reduziram as consultas por segundo de 300 para 30, estabilizando imediatamente o uso de CPU e eliminando a sobrecarga do coletor de lixo.
Dica: combine sempre métricas, logs e rastreamentos em um pipeline de observabilidade unificado. Essa combinação oferece uma visão imediata e holística da saúde do seu sistema.
Soluções para Problemas de Desempenho em Microsserviços
Comunicação assíncrona
Benefícios da mensageria
Você pode resolver muitos desafios de escalabilidade em uma arquitetura de microsserviços adotando a comunicação assíncrona. Ao desacoplar as requisições por meio de filas de mensagens, os serviços processam o trabalho no próprio ritmo, absorvendo picos de tráfego com segurança e sem descartar requisições.
| Melhoria de desempenho | Descrição |
|---|---|
| Escalabilidade | A mensageria assíncrona permite uma escalabilidade enorme, usando filas para armazenar em buffer os picos de tráfego. |
| Confiabilidade | Os brokers assíncronos oferecem suporte a novas tentativas de envio de mensagens e a filas de mensagens mortas (dead-letter queues), garantindo zero perda de mensagens durante indisponibilidades. |
| Testabilidade | Os testes ficam mais simples, pois os serviços consumidores precisam apenas de uma fila simulada (mock) para verificar o payload. |
Implementação
Implemente a comunicação assíncrona com brokers de mensagens robustos, como RabbitMQ, Azure Service Bus ou Apache Kafka. Use padrões de publicação e assinatura (publish-subscribe) para difundir eventos de domínio de forma limpa entre serviços independentes.
Bulkheads e Circuit Breakers
Estratégias de isolamento
Proteja seus microsserviços contra falhas em cascata usando bulkheads e circuit breakers. Os bulkheads particionam os pools de recursos, de modo que uma falha em um serviço não consiga esgotar threads ou conexões em todo o sistema.
Os bulkheads são projetados para isolar domínios de falha, criando pools de recursos ou cotas separados para diferentes serviços, impedindo que falhas localizadas derrubem toda a aplicação.
Mitigação de falhas
Os circuit breakers monitoram as taxas de erro e rejeitam rapidamente as requisições para dependências com problemas, evitando interrupções em cascata em toda a sua rede.
O padrão bulkhead em arquiteturas de microsserviços é usado para impedir que falhas em uma parte do sistema derrubem toda a plataforma, isolando efetivamente as falhas em sua origem.
Cache e escalabilidade
Seleção de armazenamento de dados
O cache é uma ferramenta essencial para microsserviços de alto desempenho. Transfira leituras repetidas de banco de dados e cálculos custosos de APIs para caches rápidos em memória, como Redis ou Memcached.
| Benefício | Descrição |
|---|---|
| Controle granular | Armazene em cache fragmentos de domínio com base na volatilidade e na frequência de atualização. |
| Menor invalidação de cache | Reduz a sobrecarga de limpeza ao atualizar apenas os segmentos de dados afetados. |
| Taxas de acerto de cache melhoradas | Permite entradas de cache menores e altamente otimizadas, para taxas de acerto maiores na memória. |
| Tratamento híbrido dinâmico/estático | Permite armazenar em cache registros estáticos enquanto busca estatísticas em tempo real de forma dinâmica. |
Escalabilidade independente
O cache e os armazenamentos de dados segregados permitem escalar serviços individualmente, eliminando gargalos de contenção de recursos.
- Maior escalabilidade do sistema
- Mais agilidade no desenvolvimento e entrega mais rápida ao mercado
- Isolamento robusto de falhas e resiliência do sistema
- Uso economicamente eficiente dos recursos da nuvem
- Melhor integração com DevOps e pipelines de entrega contínua
Redução de dependências
Desacoplamento
Microsserviços verdadeiros exigem um desacoplamento radical. Quando os serviços operam de forma independente, sem chamadas síncronas bloqueantes, você elimina gargalos artificiais.
Desacoplar significa que cada microsserviço processa a própria carga interna sem esperar de forma síncrona por processos externos. Essa independência evita gargalos e mantém sua plataforma funcionando sem problemas.
Os principais benefícios arquiteturais de reduzir dependências incluem:
- Escalabilidade independente dos serviços com base nas cargas de trabalho em tempo real.
- Risco reduzido de falhas em cascata entre as fronteiras das equipes.
- Autonomia para as equipes de desenvolvimento publicarem código em seus próprios cronogramas.
- Identificação mais rápida da causa raiz durante a resposta a incidentes.
Simplificação
Simplificar o grafo de dependências reduz a carga cognitiva, tornando a arquitetura muito mais fácil de testar, monitorar e proteger.
| Abordagem | O que significa | Por que importa |
|---|---|---|
| SLOs individuais | Acompanhar a confiabilidade de cada microsserviço separadamente | Pode deixar passar a degradação da experiência do usuário em todo o sistema |
| SLOs compostos | Combinar objetivos de confiabilidade entre serviços interdependentes | Refletem a saúde real do sistema de ponta a ponta |
Avaliando a adequação da arquitetura de microsserviços
Escolher o modelo arquitetural certo define a velocidade da sua engenharia e os seus custos operacionais. O Microsoft Development Podcast frequentemente explora essa tensão, destacando uma tendência crescente de organizações que consolidam microsserviços excessivamente fragmentados de volta em monólitos modulares gerenciáveis.
Matriz de decisão
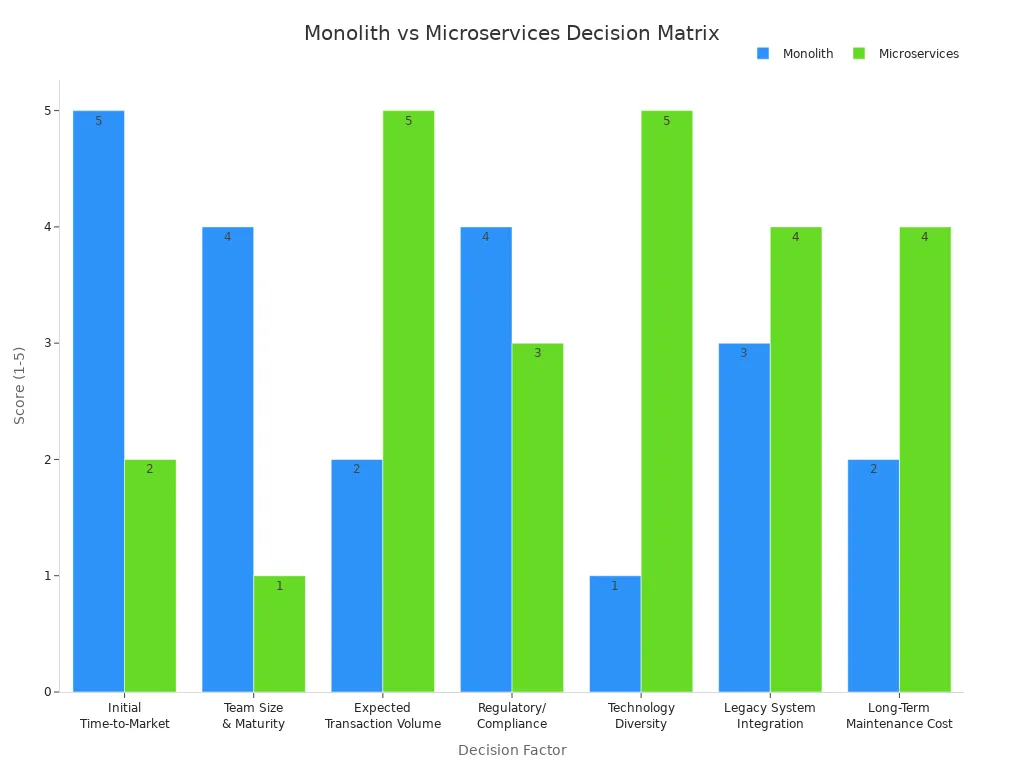
Use uma matriz de decisão estruturada para avaliar se microsserviços realmente se adequam à maturidade da sua organização:
| Fator de decisão | Pontuação do monólito (1-5) | Pontuação dos microsserviços (1-5) | Justificativa estratégica |
|---|---|---|---|
| Tempo inicial até o mercado (velocidade) | 5 | 2 | Monólitos exigem configuração mínima de infraestrutura no início. |
| Tamanho e maturidade da equipe (DevOps) | 4 | 1 | Microsserviços exigem CI/CD avançado, automação e observabilidade. |
| Volume esperado de transações (escala) | 2 | 5 | Microsserviços permitem o escalonamento preciso e independente de gargalos que consomem muitos recursos. |
| Complexidade regulatória/de conformidade | 4 | 3 | Artefatos únicos simplificam a auditoria de segurança e as verificações de conformidade iniciais. |
| Diversidade tecnológica/experimentação | 1 | 5 | Microsserviços permitem que as equipes adotem pilhas tecnológicas especializadas por domínio de serviço. |
| Integração com sistemas legados | 3 | 4 | Microsserviços se destacam ao encapsular e modernizar componentes legados. |
| Custo de manutenção de longo prazo (TCO) | 2 | 4 | Microsserviços reduzem o custo de funcionalidades ao longo do tempo, à custa de maior sobrecarga operacional. |
Perguntas-chave de avaliação
- Sua equipe de engenharia possui habilidades sólidas em DevOps, engenharia de plataforma e SRE?
- Você enfrenta requisitos de escala extremos que justifiquem a sobrecarga de um ambiente distribuído?
- Você precisa de persistência poliglota e diversidade tecnológica?
- Sua cultura organizacional está preparada para lidar com os intensos custos de coordenação entre equipes?
Sinais para reconsiderar
Fique atento a estes sinais de alerta que indicam que sua arquitetura de microsserviços precisa de reestruturação:
- A velocidade de entrega para por completo devido a dependências constantes entre equipes.
- Os gastos operacionais com nuvem crescem mais rápido do que a receita do negócio.
- Falhas se propagam facilmente por vários domínios.
Monólito versus microsserviços
| Tipo de arquitetura | Recomendação de tamanho da equipe | Principais características |
|---|---|---|
| Monolítica | < 8-10 desenvolvedores | Implantações simples, baixa sobrecarga operacional |
| Microsserviços | > 10-15 desenvolvedores | Autonomia independente das equipes, coordenação distribuída complexa |
Você enfrenta complexidade oculta e riscos de desempenho ao implementar uma arquitetura de microsserviços. Gargalos sempre surgem em camadas de rede e de dados inesperadas. O Microsoft Development Podcast ressalta como a entrega rápida exige disciplina arquitetural rigorosa. Para manter seus sistemas .NET saudáveis, lembre-se de:
- Gerenciar cuidadosamente as requisições entre serviços e as políticas de timeout.
- Implemente balanceamento de carga elástico e escalonamento automatizado.
- Desacople os armazenamentos de dados para que cada serviço seja dono do seu próprio banco de dados.
- Armazene em cache de forma agressiva as consultas repetitivas de API e de banco de dados.
Você também deve aplicar governança arquitetural, utilizar gateways de API robustos e conduzir revisões arquiteturais regulares. A avaliação contínua garante que sua pilha tecnológica escale de forma eficaz junto com o seu negócio.
Perguntas frequentes
O que é um monólito distribuído?
Um monólito distribuído é um antipadrão em que uma aplicação é fisicamente dividida em vários microsserviços, mas permanece logicamente acoplada por meio de chamadas HTTP síncronas, bancos de dados compartilhados e dependências rígidas de implantação, abrindo mão dos principais benefícios dos microsserviços.
Como identificar gargalos de desempenho em microsserviços?
Monitore os tempos de resposta p99, as taxas de erro e a vazão de requisições. Utilize ferramentas de rastreamento distribuído para acompanhar as requisições entre os limites dos serviços e identificar saltos de rede lentos ou consultas a bancos de dados.
Por que a latência de rede importa na arquitetura de microsserviços?
A latência de rede adiciona milissegundos de atraso a cada chamada entre serviços. Diferentemente das chamadas instantâneas de memória em processo de um monólito, os saltos de rede distribuídos se acumulam rapidamente, degradando a capacidade de resposta geral da aplicação.
Como reduzir a sobrecarga de coordenação entre equipes?
Defina limites claros de propriedade de domínio, automatize as verificações de governança de APIs, reduza reuniões de status desnecessárias e adote padrões de comunicação assíncrona para capacitar as equipes a trabalhar com autonomia.
Quais ferramentas ajudam na observabilidade de microsserviços .NET?
Ferramentas populares de observabilidade incluem Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin e plataformas de logs centralizados, como a stack ELK, que juntas capturam métricas, logs e rastreamentos distribuídos.
Quando você deve considerar a consolidação de microsserviços?
Considere a consolidação se a velocidade de entrega de funcionalidades cair, os custos da infraestrutura em nuvem saírem do controle ou falhas em cascata afetarem com frequência a sua capacidade de manter a disponibilidade.
Qual é a melhor forma de lidar com dados compartilhados em microsserviços?
Dê a cada microsserviço o seu próprio banco de dados privado. Evite compartilhar bancos de dados entre serviços para eliminar o acoplamento de esquemas e restaurar a escalabilidade independente do banco de dados.
Como a comunicação assíncrona melhora o desempenho de microsserviços?
A comunicação assíncrona com brokers de mensagens permite que os serviços processem eventos no próprio ritmo, absorvendo picos de tráfego e eliminando gargalos síncronos de bloqueio.
🎧 Ouça este episódio
Quer uma explicação prática e aprofundada sobre Why Microservice Architecture Slows Software Delivery? Este episódio detalha esses tópicos arquiteturais essenciais em linguagem clara e mostra por que eles importam para Microsoft 365, Azure, Power Platform, segurança corporativa, IA e engenharia de software moderna.
Ouça este episódio se você quiser:
- Entender os conceitos centrais por trás de por que os microsserviços podem desacelerar a entrega de software
- Ver como a arquitetura se encaixa no ecossistema tecnológico mais amplo da Microsoft
- Descobrir onde ela pode gerar valor prático e mensurável para a sua organização
Você também pode gostar destes episódios relacionados do M365 FM:
- O mito do monorepo: por que sua arquitetura está fragmentada
- Microsoft Graph Automation Architecture: Beyond Scripts
- Agentes de IA baseados no Graph: um guia de arquitetura empresarial
- Extensibilidade no .NET e Arquitetura Limpa com Miguel Castro [MVP]
- Enterprise AI Agent Fabric: Architecture Beyond Chatbots
Descubra mais conversas práticas sobre engenharia Microsoft no M365 FM.