 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Het distributed monolith-valkuil vermijden in .NET-microservices
By Mirko Peters ·
Wanneer engineeringteams overstappen van een monolithische applicatie naar een microservicearchitectuur, streven ze meestal naar een zeer specifieke set beloften: snellere levering van functies, onafhankelijke schaalbaarheid, gelokaliseerde foutisolatie en de vrijheid om met moderne technologiestacks te experimenteren. …
Automatically translated with AI from the original post. Read the English original
Wanneer engineeringteams overstappen van een monolithische applicatie naar een microservicearchitectuur, streven ze meestal naar een zeer specifieke set beloften: snellere levering van functies, onafhankelijke schaalbaarheid, gelokaliseerde foutisolatie en de vrijheid om met moderne technologiestacks te experimenteren. Toch loopt het bij veel .NET-organisaties vast: de ontwikkelsnelheid komt tot stilstand. In plaats van een flexibel, losjes gekoppeld ecosysteem beheren ze een distributed monolith: een architectuur die de operationele complexiteit van gedistribueerde systemen combineert met de strakke koppeling van een traditionele monoliet.
Deze uitdaging ontstaat zelden met opzet of kwade wil. Ze sluipt meestal binnen via subtiele architectuurkeuzes, zoals het delen van een database over meerdere services, een zware afhankelijkheid van synchrone HTTP-aanroepen, of API-governance die een administratieve bottleneck wordt. In dit artikel bekijken we de symptomen van de distributed monolith-valkuil, brengen we de verborgen prestatieproblemen in je netwerklagen aan het licht, identificeren we architectuurknelpunten met moderne observability-tools en lopen we praktische strategieën door om onafhankelijke schaling in je .NET-microservices terug te krijgen. Als je team de wrijving van trage leveringssnelheden heeft gevoeld, dan sta je er niet alleen voor, en het begrijpen van deze patronen is de eerste stap naar het herwinnen van je wendbaarheid.
Microservicearchitectuur: verborgen complexiteit
Distributed monoliths
Symptomen
Je denkt misschien dat het opsplitsen van je applicatie in microservices je prestatieproblemen automatisch oplost. Toch kun je heel makkelijk eindigen met een distributed monolith. Dat gebeurt wanneer services zo sterk van elkaar afhankelijk zijn dat je de echte voordelen van scheiding verliest. Je kunt de volgende veelvoorkomende symptomen herkennen:
- Services leunen voor elke standaard bedrijfsbewerking op synchrone aanroepen.
- Teams hebben moeite om afzonderlijke wijzigingen uit te rollen zonder het risico op downtime of het breken van downstreamservices.
- Gedeelde databases dwingen je om schemawijzigingen strak te coördineren over meerdere afzonderlijke ontwikkelteams heen.
- Componenten blijven strak gekoppeld, ook al draaien ze fysiek in afzonderlijke processen of containers.
Impact op snelheid
Een distributed monolith kan je systeem op manieren vertragen die je in eerste instantie niet verwacht. Je zult zien dat de netwerklatentie toeneemt, omdat elke aanroep tussen services extra vertraging toevoegt. In tegenstelling tot een monolithische applicatie, waarin aanroepen direct in het geheugen plaatsvinden, verschuift een microservicearchitectuur je prestatieknelpunten van de database of CPU naar de netwerklaag. Synchrone aanroepen tussen microservices stapelen hun latentie op, terwijl een monoliet deze aanroepen in-process afhandelt. Daardoor verlies je het vermogen om services onafhankelijk te schalen en fouten effectief te isoleren, waardoor prestatieproblemen toenemen naarmate je afhankelijkheidsboom groeit.
Wanneer je een monolithische applicatie probeert te distribueren zonder goed ontworpen grenzen, krijg je vaak te maken met ernstige prestatieproblemen. Componenten blijven sterk van elkaar afhankelijk en je krijgt niet de voordelen van onafhankelijke schaling of foutisolatie die goed gestructureerde microservices wel bieden.
Coördinatieoverhead
API-governance
Microservicearchitectuur vereist sterke API-governance. Je moet elke wijziging beoordelen en goedkeuren om te voorkomen dat er technische schuld en dubbel werk ontstaat. Is de governance te streng, dan vertraagt de ontwikkeling enorm. Is ze te soepel, dan loop je het risico bijna van de ene op de andere dag structurele technische schuld op te bouwen.
Wanneer governance te soepel of te streng is, kan dat leiden tot technische schuld, dubbel werk en grote vertragingen in het ontwikkelproces.
Kortom, je bouwt heel snel een hele hoop technische schuld op. En uiteindelijk moet je misschien meer geld en tijd uittrekken om dat allemaal weer af te breken en opnieuw te beginnen.
Je moet je governancemodellen zo ontwerpen dat ze ontwikkelaars actief helpen. Automatisering helpt om de kwaliteit, beveiliging en consistentie van API's te verbeteren zonder extra administratieve last.
Wanneer governance is ontworpen ten gunste van ontwikkelaars en wordt ondersteund door automatisering, werkt het als een katalysator voor betere API-kwaliteit, beveiliging en consistentie.
API's spelen een cruciale rol in je bredere bedrijfsstrategie. Je moet ze behandelen als volwaardige onderdelen van je organisatie.
In het meest recente rapport over API-integratie zei 84 procent van de bedrijven dat API's cruciaal of zeer cruciaal zijn voor hun kernstrategie.
Samenwerking in teams
Microservices vragen om voortdurende afstemming tussen teams. Je besteedt uren aan het voorbereiden van vergaderingen, aan het wisselen van context tussen domeinen en aan het verduidelijken van rollen over teamgrenzen heen. Deze activiteiten kunnen gemakkelijk een groot deel van je werkweek opslokken.
| Factoren die afstemmingskosten bepalen | Beschrijving |
|---|---|
| Besluitvertraging | Vertraging door meerdere belanghebbenden en omslachtige goedkeuringsketens |
| Contextwisseling | Versnipperde aandacht door allerlei afstemmingsmomenten over functionele grenzen heen |
| Informatieverlies | Verlies of vervorming van cruciale kennis doorheen de organisatorische lagen |
| Onduidelijke rollen | Onduidelijke verantwoordelijkheid leidt tot hiaten en dubbel ontwikkelwerk |
| Afstemmingsactiviteit | Bestede tijd |
|---|---|
| Voorbereiding van vergaderingen | Meer dan 8 uur per week |
| Afstemmingsactiviteiten | 35–80% van de tijd van kenniswerkers |
Je moet beseffen dat de afstemmingsbelasting stilletjes de snelheid van oplevering kan ondermijnen. Duidelijke afbakening van verantwoordelijkheden en gestroomlijnde communicatiekanalen zijn noodzakelijk om hiaten en dubbel werk te voorkomen.
Uitdagingen in het .NET-ecosysteem
Platform engineering
Een microservicearchitectuur in het .NET-ecosysteem brengt specifieke engineeringuitdagingen met zich mee. Je krijgt vaak te maken met codeduplicatie en overbodigheden, wat het onderhoud zwaarder maakt en het risico op inconsistente gegevens vergroot. Ontwikkelaars worstelen vaak met een overmaat aan boilerplatecode om de infrastructuur draaiend te krijgen. Het organiseren van broncode wordt bijzonder lastig wanneer je domeinmodellen onzorgvuldig over services deelt. Copy-and-paste-antipatronen vertragen het oplossen van bugs en maken langetermijnonderhoud aanzienlijk moeilijker.
- Codeduplicatie leidt tot hogere doorlopende onderhoudskosten.
- Gedeelde modellen over services heen maken schemawijzigingen riskant.
- Ontwikkelaars kopiëren mogelijk servicelogica, wat kritieke bugfixes vertraagt.
Domeingrenzen
Je moet domeingrenzen bij het bouwen van microservices in .NET strak en scherp definiëren. Doe je dat niet, dan vergroot je de cognitieve belasting van ontwikkelaars aanzienlijk. Te veel gelijktijdige architectuurvereisten overweldigen je team. Het handhaven van standaarden en compliance wordt moeilijk, wat betrouwbaarheidsproblemen kan veroorzaken en je algehele beveiligingspositie kan verzwakken.
- De cognitieve belasting stijgt sterk wanneer ontwikkelaars jongleren met meerdere onderling verbonden services.
- Standaarden en compliance binnen de onderneming worden moeilijker consistent af te dwingen.
- Betrouwbaarheid en beveiliging lijden wanneer domeingrenzen slecht zijn gedefinieerd.
Microservicearchitectuur biedt aantrekkelijke voordelen, maar je moet de verborgen complexiteit actief aanpakken. Let op de symptomen van een gedistribueerde monoliet, beheer je afstemmingsbelasting en pak de .NET-specifieke platformuitdagingen resoluut aan.
Tikkende tijdbom: prestatieproblemen
Je zou kunnen denken dat microservices vanzelf de systeemsnelheid verhogen, maar zonder zorgvuldig ontwerp kunnen ze een tikkende tijdbom worden voor je infrastructuur. Veel engineeringteams ontdekken veelvoorkomende prestatieproblemen pas nadat ze in productie zijn gezet. Deze problemen liggen verborgen en wachten tot ze je applicatie onder piekbelasting neerhalen. Je moet begrijpen hoe netwerklatentie, cascaderende faalpunten en databasecontentie je architectuur veranderen in een bron van chronische frustratie in productie.
Netwerklatentie
In-process versus netwerkaanroepen
Wanneer je een monoliet opsplitst in microservices, verschuif je van aanroepen binnen het proces naar netwerkaanroepen. Deze architectuurwijziging brengt onvermijdelijke latentie met zich mee. In een monolithische applicatie wordt een functieaanroep vrijwel direct afgehandeld. In microservices moet elke aanroep van service naar service via het netwerk, wat er milliseconden vertraging aan toevoegt.
| Architectuurtype | Gemiddelde latentie |
|---|---|
| Functieaanroep binnen het proces (monoliet) | 0,001 ms (1 microseconde) |
| HTTP-aanroep binnen hetzelfde datacenter (microservices) | 1-5 ms (1.000-5.000 microseconden) |
Netwerkaanroepen zijn een orde van grootte trager dan functieaanroepen binnen hetzelfde proces. Dit verschil stapelt zich snel op naarmate je systeem groeit. Elke nieuwe service in een aanvraagketen voegt extra latentie toe en maakt van eenvoudige handelingen trage, frustrerende ervaringen voor eindgebruikers.
Resourcegebruik
Netwerkaanroepen veroorzaken niet alleen latentie; ze verbruiken ook waardevolle systeemresources. Elke aanroep kost CPU-cycli, geheugenbuffers en netwerkbandbreedte. Naarmate je meer microservices toevoegt, groeit het netwerkverkeer exponentieel. Die extra belasting leidt tot hogere cloudinfrastructuurkosten en trage responstijden.
Je kunt de prestaties verbeteren door onnodige onderlinge serviceaanroepen agressief terug te dringen. Sommige geavanceerde teams gebruiken intelligent verkeersbeheer om de latentie te verlagen en de veerkracht te vergroten:
- De MCG-aanpak verbeterde de responstijden met 15% bij toenemende netwerklatentie, dankzij minder vertragingen in de communicatie tussen services.
- Onder piekbelasting vertoonde de MCG-geoptimaliseerde opzet een betere veerkracht met minder foutpercentages dan standaard service mesh-configuraties.
- Prestatiemetingen toonden aan dat slimme verkeersplaatsing de overhead van sidecar-proxy's beperkte, waardoor de responstijden daalden en de doorvoer stabiel bleef.
Je moet voortdurend monitoren hoe het netwerkverkeer de prestaties van je systeem beïnvloedt. Kleine, zich opstapelende vertragingen groeien snel uit tot grote knelpunten.
Storingspunten
Verspreidingsrisico's
Microservices veranderen fundamenteel het storingsprofiel van je systeem. Omdat elke service afhankelijk is van andere, kan één storing zich door je hele infrastructuur verspreiden.
| Architectuurtype | Risico op verspreiding van storingen | Isolatie van storingen | Systeemveerkracht |
|---|---|---|---|
| Monolithisch | Hoog | Nee | Laag |
| Microservices | Laag | Ja | Hoog |
In een monolithisch systeem kan één fatale bug het hele applicatieproces doen stoppen. Microservices bieden veel betere isolatie van storingen; als een niet-kritieke service uitvalt, kunnen de andere gewoon blijven draaien. Veerkrachtpatronen zoals circuit breakers helpen voorkomen dat storingen zich wereldwijd verspreiden.
- In een monoliet kan één bug een volledige uitval veroorzaken, waardoor er een single point of failure ontstaat.
- Microservices maken echte fouttolerantie mogelijk, zodat storingen in niet-kritieke componenten het platform niet onderuit halen.
- Patronen zoals circuit breakers vergroten de veerkracht door falende afhankelijkheden stroomafwaarts te isoleren.
Uitdagingen op het gebied van observability
Je hebt uitgebreide observability nodig om prestatieproblemen in een uitgebreid microservicesnetwerk op te sporen en op te lossen. Het vinden van de oorzaak van latentie of sporadische fouten wordt exponentieel moeilijker naarmate er meer services bijkomen. Je moet logs, infrastructuurmetrics en gedistribueerde traces van elke draaiende instantie samenvoegen. Zonder degelijke observability-tooling verspil je ontelbare uren aan het zoeken naar de bron van productievertragingen.
Veelvoorkomende prestatieknelpunten schuilen vaak in complexe, asynchrone aanroepketens. Gebruik gedistribueerde tracing om aanvragen over grenzen heen te volgen, zodat je knelpunten kunt opsporen voordat ze je gebruikers raken.
Let op deze klassieke anti-patronen:
- God Service (te veel verantwoordelijkheid): een service die meerdere uiteenlopende bedrijfsdomeinen afhandelt, in strijd met de kernprincipes van architectuur.
- Strakke koppeling tussen services: directe, hardgecodeerde afhankelijkheden die stroomafwaartse systemen breken zodra een schema wijzigt.
Databasecontentie
Gedeelde datastores
Veel teams maken de kritieke fout om één database over meerdere microservices te delen. Deze aanpak creëert ernstige koppeling op schemaniveau. Het wijzigen van je databasestructuur wordt riskant, omdat externe services kunnen breken, wat je snelheid en onafhankelijke schaalbaarheid ondermijnt.
Het belangrijkste probleem met gedeelde databases is dat ze koppeling creëren via het schema. De kosten van wijzigingen lopen sterk op, omdat het moeilijk wordt om te weten wanneer je veilig iets kunt wijzigen zonder een andere service te breken. Dit heeft gevolgen voor de schaalbaarheid van het systeem. Je kunt services niet afzonderlijk opschalen als ze afhankelijk zijn van een gedeelde datastore. Omdat de schaalbaarheid van een service wordt beperkt door het langzaamste onderdeel, wordt een gedeelde database snel een enorme bottleneck.
Je moet gedeelde datastores volledig elimineren. Geef elke microservice een eigen, dedicated database om je datalagen los te koppelen en de prestaties te herstellen.
Schaalbaarheidsproblemen
Databasecontentie is een tikkende tijdbom voor enterprise-applicaties. Wanneer meerdere microservices concurreren om dezelfde databaseengine, ontstaat een zware prestatiebottleneck. De langzaamste query of service beperkt de capaciteit van het hele systeem, wat leidt tot uitputting van de connection pool, stijgende latentie en catastrofale storingen tijdens piekbelasting.
Bottlenecks in een microservicesarchitectuur herkennen
Monitoringtools
Metrics
Je moet de juiste operationele metrics bijhouden om prestatieverslechtering vroegtijdig te signaleren. Metrics geven een direct beeld van de gezondheid van je systeem en helpen je trends op te merken voordat ze de productieomgeving raken. Richt je sterk op zakelijk relevante indicatoren naast technische metrics: houd p99-responstijden, foutpercentages en requestdoorvoer bij.
Zichtbaarheid
Zichtbaarheid is onmisbaar in gedistribueerde systemen. Wat je niet kunt zien, kun je niet oplossen. Implementeer monitoringtools die telemetrie verzamelen van elke serviceinstantie:
- Prometheus, Datadog en Grafana voor realtime monitoring van infrastructuur en applicaties.
- Elasticsearch, Logstash, Kibana (ELK) of Graylog voor gecentraliseerde logaggregatie.
- Application Performance Monitoring (APM)-tools zoals New Relic of Dynatrace voor profilering van aanroepen op codeniveau.
- Kubernetes of andere container-orkestrators voor observability van de onderliggende cluster.
- API-gateways zoals Kong of Zuul voor analyse van verkeer aan de rand van het systeem.
Gedistribueerde tracing
Requestflows
Gedistribueerde tracing laat je een HTTP-request volgen terwijl het door je microservicearchitectuur loopt. Tracingtools zoals OpenTelemetry, Jaeger en Zipkin koppelen deze aanroepen aan elkaar en tonen het volledige uitvoeringspad, met exacte latentiehotspots.
- Gedistribueerde tracing biedt diepgaand inzicht over servicegrenzen heen.
- Het legt verborgen bottlenecks bloot en versnelt het debuggen aanzienlijk.
- Engineeringteams gebruiken traces om de bronnen van latentie op te sporen en de betrouwbaarheid te verbeteren.
Bronnen van latentie
Latentie stapelt zich op naarmate requests van service naar service gaan. Standaard logs en infrastructuurmetrics alleen kunnen dit niveau van transactionele granulariteit niet tonen. Tracing behoudt de requestcontext over netwerkhops heen, zodat je precies de methode of databasequery kunt aanwijzen die de vertraging veroorzaakt.
Verborgen vertragingen herkennen
Symptomen
Verborgen vertragingen kunnen de gebruikerservaring schaden, zelfs zonder volledige storingen. Let op stijgende responstijden, hogere foutpercentages en een groter geheugengebruik. Gebruik correlatie-ID's om requests door je systemen te volgen en stel proactieve waarschuwingen in op basis van strikte service-level objectives (SLO's).
Praktijkvoorbeelden
Praktijkcases uit de engineering laten zien hoe belangrijk proactieve bottleneckdetectie is. Zo kreeg een Spring Boot-microservice met veel belasting te maken met ernstige prestatieproblemen. Via diepgaande APM- en profilingtools ontdekte het engineeringteam een niet-geoptimaliseerde queryloop. Door een specifieke clausule toe te voegen om databasebewerkingen te bundelen, daalde het aantal queries per seconde van 300 naar 30, waardoor het CPU-gebruik direct stabiliseerde en de overhead van garbage collection verdween.
Tip: Combineer metrics, logs en traces altijd in één geïntegreerde observability-pipeline. Deze combinatie geeft je direct een volledig beeld van de gezondheid van je systeem.
Oplossingen voor prestatieproblemen in microservices
Asynchrone communicatie
Voordelen van berichtenverkeer
Je kunt veel schaalproblemen in een microservicearchitectuur oplossen door asynchrone communicatie toe te passen. Door verzoeken via berichtenwachtrijen te ontkoppelen, verwerken services het werk in hun eigen tempo en vang je verkeerspieken veilig op zonder verzoeken te verliezen.
| Prestatieverbetering | Beschrijving |
|---|---|
| Schaalbaarheid | Asynchroon berichtenverkeer maakt enorme schaalvergroting mogelijk door wachtrijen te gebruiken om verkeerspieken op te vangen. |
| Betrouwbaarheid | Asynchrone brokers ondersteunen nieuwe pogingen en dead-letter-wachtrijen, waardoor er tijdens uitval geen berichten verloren gaan. |
| Testbaarheid | Testen wordt eenvoudiger, omdat consumerende services alleen een mock-wachtrij nodig hebben om de payload te controleren. |
Implementatie
Implementeer asynchrone communicatie met robuuste message brokers zoals RabbitMQ, Azure Service Bus of Apache Kafka. Gebruik publish-subscribe-patronen om domeingebeurtenissen netjes te verspreiden naar onafhankelijke services.
Bulkheads & circuit breakers
Isolatiestrategieën
Bescherm je microservices tegen cascaderende storingen met bulkheads en circuit breakers. Bulkheads verdelen resourcepools, zodat een storing in één service niet alle threads of verbindingen in het hele systeem uitput.
Bulkheads zijn bedoeld om storingsdomeinen te isoleren door aparte resourcepools of quota voor verschillende services te maken. Zo voorkom je dat een lokale storing de hele applicatie platlegt.
Beperken van storingen
Circuit breakers monitoren foutpercentages en laten verzoeken naar ongezonde afhankelijkheden direct mislukken. Zo voorkom je cascaderende uitval in je hele netwerk.
Het bulkhead-patroon in een microservicearchitectuur wordt gebruikt om te voorkomen dat fouten in één deel van een systeem het hele platform laten crashen, waarbij storingen al bij de oorsprong worden geïsoleerd.
Caching en schaalvergroting
Keuze van datastores
Caching is een essentieel hulpmiddel voor high-performance microservices. Verplaats herhaalde databaseleesacties en dure API-berekeningen naar snelle in-memory caches zoals Redis of Memcached.
| Voordeel | Beschrijving |
|---|---|
| Fijnmazige controle | Cache domeinfragmenten op basis van volatiliteit en updatefrequentie. |
| Minder cache-invalidatie | Beperkt de overhead van het leegmaken door alleen de getroffen datasegmenten te vernieuwen. |
| Betere cachetreffersratio | Maakt kleinere, sterk geoptimaliseerde cache-items mogelijk voor hogere in-memory treffersratio's. |
| Hybride afhandeling van dynamische en statische gegevens | Ondersteunt het cachen van statische gegevens, terwijl realtimestatistieken dynamisch worden opgehaald. |
Onafhankelijk schalen
Caching en gescheiden datastores stellen je in staat om individuele services onafhankelijk te schalen, waardoor knelpunten door resourceconflicten verdwijnen.
- Verbeterde systeemschaalbaarheid
- Meer ontwikkelwendbaarheid en snellere time-to-market
- Robuuste foutisolatie en systeemveerkracht
- Kosteneffectief gebruik van cloudresources
- Betere DevOps-integratie en continue deployment-pijplijnen
Afhankelijkheden verminderen
Ontkoppelen
Echte microservices vereisen radicaal ontkoppelen. Wanneer services onafhankelijk werken zonder blokkerende synchrone aanroepen, verwijder je kunstmatige knelpunten.
Ontkoppelen betekent dat elke microservice zijn interne werk afhandelt zonder synchroon te wachten op externe processen. Deze onafhankelijkheid voorkomt knelpunten en houdt je platform soepel draaiend.
De belangrijkste architectuurvoordelen van het verminderen van afhankelijkheden zijn:
- Onafhankelijk schalen van services op basis van realtime werkbelasting.
- Minder risico op cascaderende storingen over teamgrenzen heen.
- Autonomie voor ontwikkelteams om code op hun eigen schema uit te rollen.
- Snellere isolatie van de hoofdoorzaak tijdens incidentrespons.
Vereenvoudiging
Een eenvoudigere afhankelijkheidsgraaf verlaagt de cognitieve belasting en maakt je architectuur veel makkelijker te testen, monitoren en beveiligen.
| Aanpak | Wat het betekent | Waarom het ertoe doet |
|---|---|---|
| Individuele SLO's | Betrouwbaarheid per microservice afzonderlijk bijhouden | Kan een verslechtering van de gebruikerservaring over het hele systeem missen |
| Samengestelde SLO's | Betrouwbaarheidsdoelen van onderling afhankelijke services combineren | Geeft de werkelijke gezondheid van het end-to-end systeem weer |
Evaluatie van de geschiktheid van een microservicearchitectuur
Het kiezen van het juiste architectuurmodel bepaalt je ontwikkelsnelheid en je operationele kosten. De Microsoft Development Podcast gaat hier vaak op in en wijst op een groeiende trend waarbij organisaties te sterk gefragmenteerde microservices weer samenvoegen tot beheersbare modulaire monolieten.
Beslismatrix
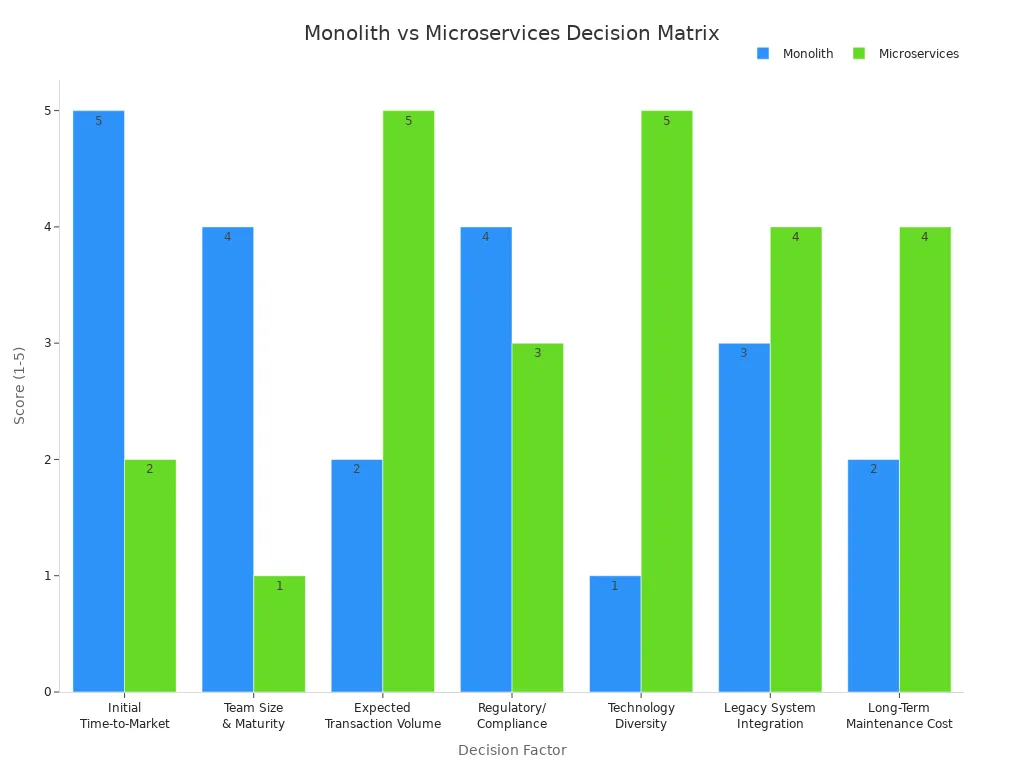
Gebruik een gestructureerde beslismatrix om te beoordelen of microservices echt passen bij de volwassenheid van je organisatie:
| Beslisfactor | Monolietscore (1-5) | Microservicesscore (1-5) | Strategische onderbouwing |
|---|---|---|---|
| Initiële time-to-market (snelheid) | 5 | 2 | Monolieten vereisen minimale initiële infrastructuurconfiguratie. |
| Teamgrootte & volwassenheid (DevOps) | 4 | 1 | Microservices vragen om geavanceerde CI/CD, automatisering en observability. |
| Verwacht transactievolume (schaal) | 2 | 5 | Microservices maken precies en onafhankelijk schalen van resource-intensieve knelpunten mogelijk. |
| Regelgeving/complexiteit van compliance | 4 | 3 | Eén artefact vereenvoudigt de initiële beveiligingsaudit en compliancecontroles. |
| Technologiediversiteit/experimenteren | 1 | 5 | Microservices maken het mogelijk dat teams per servicedomein gespecialiseerde techstacks inzetten. |
| Integratie met legacysystemen | 3 | 4 | Microservices blinken uit in het omhullen en moderniseren van legacycomponenten. |
| Onderhoudskosten op lange termijn (TCO) | 2 | 4 | Microservices verlagen op termijn de kosten per functie, ten koste van meer operationele overhead. |
Belangrijkste beoordelingsvragen
- Beschikt je engineeringteam over solide DevOps-, platform engineering- en SRE-vaardigheden?
- Heb je extreme schaalvereisten die de overhead van gedistribueerde systemen rechtvaardigen?
- Heb je polyglot persistence en technologiediversiteit nodig?
- Is je organisatiecultuur klaar om de intensieve coördinatiekosten tussen teams aan te kunnen?
Signalen om opnieuw te overwegen
Let op deze waarschuwingssignalen die aangeven dat je microservicearchitectuur herstructurering nodig heeft:
- De levertijd komt tot stilstand door voortdurende afhankelijkheden tussen teams.
- De operationele cloudkosten stijgen sneller dan de groei van de bedrijfsomzet.
- Storingen slaan gemakkelijk over naar meerdere domeinen.
Monoliet vs microservices
| Architectuurtype | Aanbeveling teamgrootte | Belangrijkste kenmerken |
|---|---|---|
| Monoliet | < 8-10 developers | Eenvoudige deployments, lage operationele overhead |
| Microservices | > 10-15 developers | Onafhankelijke autonomie van teams, complexe gedistribueerde coördinatie |
Bij het implementeren van een microservicearchitectuur loer je op verborgen complexiteit en prestatierisico's. Knelpunten duiken altijd op in onverwachte netwerk- en datalagen. De Microsoft Development Podcast benadrukt hoe snelle levering een strikte architectuurdiscipline vereist. Om je .NET-systemen gezond te houden, kun je het volgende doen:
- Beheer verzoeken tussen services en timeoutbeleid zorgvuldig.
- Implementeer elastische load balancing en geautomatiseerd schalen.
- Ontkoppel datastores zodat elke service zijn eigen database beheert.
- Cache herhaalde API- en databasequery's agressief.
Daarnaast kun je architectuurgovernance afdwingen, robuuste API-gateways inzetten en regelmatig architectuurreviews uitvoeren. Voortdurende evaluatie zorgt ervoor dat je technologiestack effectief meegroeit met je bedrijf.
Veelgestelde vragen
Wat is een gedistribueerde monoliet?
Een gedistribueerde monoliet is een anti-patroon waarbij een applicatie fysiek is opgesplitst in meerdere microservices, maar logisch gekoppeld blijft via synchrone HTTP-aanroepen, gedeelde databases en strakke afhankelijkheden bij het deployen, waardoor de kernvoordelen van microservices verloren gaan.
Hoe herken je prestatieknelpunten in microservices?
Monitor p99-responstijden, foutpercentages en requestdoorvoer. Gebruik tools voor distributed tracing om requests over servicegrenzen heen te volgen en trage netwerkhops of databasequery's te identificeren.
Waarom is netwerklatentie belangrijk in een microservicearchitectuur?
Netwerklatentie voegt milliseconden vertraging toe aan elke aanroep tussen services. In tegenstelling tot de direct beschikbare geheugenaanroepen in een monoliet, stapelen gedistribueerde netwerkhops zich snel op en verslechteren ze de algehele responsiviteit van de applicatie.
Hoe kun je de coördinatie-overhead tussen teams verminderen?
Definieer duidelijke grenzen voor domeineigenaarschap, automatiseer API-governancecontroles, verminder onnodige statusvergaderingen en omarm asynchrone communicatiepatronen zodat teams zelfstandig kunnen werken.
Welke tools helpen bij observability in .NET-microservices?
Populaire observability-tools zijn onder andere Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin en centrale logplatforms zoals de ELK-stack. Samen leggen ze metrics, logs en gedistribueerde traces vast.
Wanneer overweeg je het consolideren van microservices?
Overweeg consolidatie als de snelheid van functielevering afneemt, de kosten van je cloudinfrastructuur uit de hand lopen, of als cascaderende storingen regelmatig je uptime in gevaar brengen.
Wat is de beste manier om gedeelde data in microservices te beheren?
Geef elke microservice zijn eigen privédatabase. Vermijd het delen van databases tussen services, zodat schemakoppelingen verdwijnen en de database weer onafhankelijk kan schalen.
Hoe verbetert asynchrone communicatie de prestaties van microservices?
Asynchrone communicatie via message brokers laat services gebeurtenissen in hun eigen tempo verwerken. Zo worden pieken in verkeer opgevangen en verdwijnen synchrone knelpunten die blokkeren.
🎧 Luister naar deze aflevering
Wil je een praktische, diepgaande uitleg over Why Microservice Architecture Slows Software Delivery? In deze aflevering lichten we de belangrijkste architectuuronderwerpen helder toe en laten we zien waarom ze ertoe doen voor Microsoft 365, Azure, Power Platform, enterprise-beveiliging, AI en moderne softwareontwikkeling.
Luister naar deze aflevering als je:
- De kernconcepten begrijpt achter waarom microservices de levering van software kunnen vertragen
- Ziet hoe architectuur past binnen het bredere Microsoft-technologie-ecosysteem
- Leert waar het praktische, meetbare waarde kan opleveren voor je enterprise-organisatie
Misschien vind je deze gerelateerde M365 FM-afleveringen ook interessant:
- De monorepo-mythe: waarom je architectuur gefragmenteerd is
- Microsoft Graph Automation Architecture: Beyond Scripts
- Graph-Powered AI Agents: een architectuurgids voor enterprise
- .NET-extensibility en Clean Architecture met Miguel Castro [MVP]
- Enterprise AI Agent Fabric: Architecture Beyond Chatbots
Ontdek meer praktische Microsoft-engineeringgesprekken op M365 FM.