 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Evitare la trappola del monolite distribuito nei microservizi .NET
By Mirko Peters ·
Quando i team di sviluppo passano da un'applicazione monolitica a un'architettura a microservizi, di solito inseguono un insieme molto preciso di promesse: consegna più rapida delle funzionalità, scalabilità indipendente, isolamento localizzato dei guasti e libertà di sperimentare con stack tecnologici moderni. Tuttavia, molte organizzazione .NET si trovano di fronte a un muro: la velocità di svil
Automatically translated with AI from the original post. Read the English original
Quando i team di sviluppo passano da un'applicazione monolitica a un'architettura a microservizi, di solito inseguono un insieme molto preciso di promesse: consegna più rapida delle funzionalità, scalabilità indipendente, isolamento localizzato dei guasti e libertà di sperimentare con stack tecnologici moderni. Tuttavia, molte organizzazioni .NET si trovano di fronte a un muro: la velocità di sviluppo si blocca. Invece di un ecosistema agile e debolmente accoppiato, si ritrovano a gestire un monolite distribuito, un'architettura che combina la complessità operativa dei sistemi distribuiti con l'accoppiamento stretto di un monolite tradizionale.
Questa situazione è raramente dovuta a intenzioni malevole o a una scelta deliberata. Di solito si insinua attraverso decisioni architetturali sottili, come la condivisione di un database tra più servizi, il ricorso massiccio a chiamate HTTP sincrone o il fatto che la governance delle API diventi un collo di bottiglia amministrativo. In questo post esploreremo i sintomi della trappola del monolite distribuito, scopriremo i problemi di prestazioni nascosti nei livelli di rete, individueremo i colli di bottiglia architetturali con strumenti di osservabilità moderni e vedremo alcune strategie pratiche per recuperare la scalabilità indipendente nei tuoi microservizi .NET. Se il tuo team ha sentito il peso del rallentamento delle consegne, non sei solo: capire questi schemi è il primo passo per recuperare l'agilità.
Architettura a microservizi: complessità nascosta
Monoliti distribuiti
Sintomi
Potresti pensare che suddividere l'applicazione in microservizi risolva automaticamente i problemi di prestazioni. In realtà, è facile ritrovarsi con un monolite distribuito. Questo accade quando i servizi dipendono l'uno dall'altro in misura tale da far perdere i veri vantaggi della separazione. Potresti notare questi sintomi comuni:
- I servizi si basano su chiamate sincrone per ogni operazione aziendale standard.
- Il team fatica a distribuire le singole modifiche senza rischiare interruzioni o di compromettere i servizi a valle.
- I database condivisi ti costringono a coordinare strettamente le modifiche allo schema tra più team di sviluppo distinti.
- I componenti restano fortemente accoppiati, anche se girano fisicamente in processi o container separati.
Impatto sulla velocità
Un monolite distribuito può rallentare il sistema in modi che non ti aspetti all'inizio. Vedrai aumentare la latenza di rete, perché ogni singola chiamata tra servizi aggiunge un ritardo. A differenza di un'applicazione monolitica, dove le chiamate avvengono istantaneamente in memoria, un'architettura a microservizi sposta i colli di bottiglia delle prestazioni dal database o dalla CPU al livello di rete. Le chiamate sincrone tra microservizi accumulano latenza, mentre un monolite gestisce queste chiamate all'interno del processo. Di conseguenza, perdi la capacità di scalare i servizi in modo indipendente e di isolare efficacemente i guasti, e i problemi di prestazioni si amplificano man mano che l'albero delle dipendenze cresce.
Quando provi a distribuire un'applicazione monolitica senza una progettazione adeguata dei confini, ti trovi spesso di fronte a seri problemi di prestazioni. I componenti restano fortemente dipendenti l'uno dall'altro e non ottieni i vantaggi della scalabilità indipendente o dell'isolamento dei guasti che offrono i microservizi ben strutturati.
Sovraccarico di coordinamento
Governance delle API
L'architettura a microservizi richiede una solida governance delle API. Devi esaminare e approvare ogni modifica per evitare di accumulare debito tecnico e lavoro duplicato. Se la governance è troppo rigida, rallenti lo sviluppo fino a fermarlo quasi del tutto. Se è troppo permissiva, rischi di costruire debito tecnico strutturale quasi da un giorno all'altro.
Quando la governance è troppo permissiva o troppo rigida, può portare a debito tecnico, lavoro duplicato e rallentamenti drastici nel processo di sviluppo.
In sostanza, stai accumulando molto rapidamente debito tecnico. E alla fine, dovrai spendere più denaro e più tempo per smantellare tutto e ricominciare da capo.
Devi progettare i modelli di governance in modo che siano realmente a vantaggio degli sviluppatori. L'automazione aiuta a migliorare qualità, sicurezza e coerenza delle API senza aggiungere attrito amministrativo.
Quando la governance è pensata per portare vantaggi agli sviluppatori e viene rafforzata con l'automazione, diventa un catalizzatore per una migliore qualità, sicurezza e coerenza delle API.
Le API giocano un ruolo fondamentale nella strategia di business complessiva. Devi trattarle come cittadini di prima classe.
Nell'ultimo report sullo stato dell'integrazione delle API, l'84 percento delle aziende ha dichiarato che le API sono critiche o molto critiche per la loro strategia di business core.
Collaborazione tra team
I microservizi richiedono un coordinamento costante tra i team. Passi ore a prepararti alle riunioni, a passare da un contesto all'altro tra domini diversi e a chiarire i ruoli tra team. Queste attività possono facilmente assorbire una grossa parte della tua settimana lavorativa.
| Fattori di costo del coordinamento | Descrizione |
|---|---|
| Latenza decisionale | Ritardi dovuti a più stakeholder e a catene di approvazione macchinose |
| Cambio di contesto | Attenzione frammentata tra i vari punti di coordinamento trasversali |
| Degrado delle informazioni | Perdita o distorsione di conoscenze critiche attraverso i livelli organizzativi |
| Ambiguità dei ruoli | Responsabilità poco chiare che generano lacune e duplicazione degli sforzi di sviluppo |
| Attività di coordinamento | Tempo impiegato |
|---|---|
| Preparazione delle riunioni | Oltre 8 ore a settimana |
| Attività di coordinamento | Dal 35 all'80% del tempo dei knowledge worker |
Devi riconoscere che l'overhead di coordinamento può compromettere silenziosamente la velocità di consegna. Confini di responsabilità chiari e canali di comunicazione snelli sono indispensabili per evitare lacune e duplicazione degli sforzi.
Sfide dell'ecosistema .NET
Platform engineering
L'architettura a microservizi nell'ecosistema .NET porta con sé sfide ingegneristiche specifiche. Ti capita spesso di affrontare duplicazione del codice e ridondanze, che aumentano gli sforzi di manutenzione e rischiano di generare incoerenze nei dati. Gli sviluppatori spesso si trovano a gestire una quantità eccessiva di codice boilerplate solo per far partire l'infrastruttura. Organizzare il codice sorgente diventa estremamente difficile quando condividi in modo improprio i modelli di dominio tra i servizi. Gli anti-pattern di copia e incolla ritardano la correzione dei bug e complicano in modo significativo la manutenzione a lungo termine.
- La duplicazione del codice comporta costi di manutenzione continua più elevati.
- I modelli condivisi tra servizi rendono rischiose le modifiche allo schema.
- Gli sviluppatori possono copiare e incollare la logica dei servizi, il che rallenta la correzione di bug critici.
Confini di dominio
Devi definire confini di dominio estremamente precisi quando costruisci microservizi in .NET. Se non lo fai, aumenti drasticamente il carico cognitivo degli sviluppatori. Troppe richieste architetturali simultanee sopraffanno il team. Far rispettare standard e conformità diventa difficile, il che può causare problemi di affidabilità e indebolire la tua postura di sicurezza complessiva.
- Il carico cognitivo aumenta bruscamente quando gli sviluppatori devono gestire più servizi interconnessi.
- Standard e conformità aziendale diventano più difficili da applicare in modo coerente.
- Affidabilità e sicurezza ne risentono quando i confini di dominio sono definiti in modo carente.
Anche se l'architettura a microservizi offre vantaggi importanti, devi affrontare in modo proattivo la sua complessità nascosta. Attenzione ai sintomi del monolite distribuito, gestisci l'overhead di coordinamento e affronta di petto le sfide specifiche della piattaforma .NET.
Bomba a orologeria: problemi di prestazioni
Potresti pensare che i microservizi migliorino automaticamente la velocità del sistema, ma senza una progettazione rigorosa possono trasformarsi in una bomba a orologeria per la tua infrastruttura. Molti team di ingegneria scoprono i problemi di prestazioni più comuni solo dopo il deployment in produzione. Questi problemi restano nascosti, in attesa di rallentare l'applicazione sotto carico di picco. Devi capire come latenza di rete, punti di guasto a cascata e contesa sul database trasformino la tua architettura in una fonte di frustrazione cronica in produzione.
Latenza di rete
Chiamate in-process vs chiamate di rete
Quando suddividi un monolite in microservizi, passi dalle chiamate di funzione in-process alle chiamate di rete. Questo cambiamento architetturale introduce una latenza inevitabile. In un'applicazione monolitica, una chiamata di funzione si risolve quasi istantaneamente. Nei microservizi, ogni chiamata tra servizi deve attraversare la rete, aggiungendo ritardi nell'ordine dei millisecondi.
| Tipo di architettura | Latenza media |
|---|---|
| Chiamata di funzione in-process (monolite) | 0,001 ms (1 microsecondo) |
| Chiamata HTTP all'interno dello stesso datacenter (microservizi) | 1-5 ms (da 1.000 a 5.000 microsecondi) |
Le chiamate di rete sono ordini di grandezza più lente delle chiamate di funzione in-process. Questa differenza si amplifica rapidamente man mano che il sistema cresce. Ogni nuovo servizio introdotto in una catena di richieste aggiunge altra latenza, trasformando operazioni semplici in esperienze lente e frustranti per gli utenti finali.
Utilizzo delle risorse
Le chiamate di rete non si limitano ad aggiungere latenza: consumano risorse di sistema preziose. Ogni chiamata utilizza cicli di CPU, buffer di memoria e banda di rete. Aggiungendo microservizi, il traffico di rete cresce in modo esponenziale. Questo carico aggiuntivo comporta costi più elevati per l'infrastruttura cloud e tempi di risposta più lenti.
Puoi migliorare le prestazioni riducendo in modo deciso le chiamate inutili tra servizi. Alcuni team avanzati usano una gestione intelligente del traffico per ridurre la latenza e aumentare la resilienza:
- L'approccio MCG ha migliorato i tempi di risposta del 15% in presenza di una latenza di rete maggiore, grazie a ritardi di comunicazione tra servizi ridotti.
- In condizioni di picco di carico, la configurazione potenziata con MCG ha mostrato una resilienza superiore, con meno errori rispetto alle configurazioni standard con service mesh.
- Le valutazioni delle prestazioni hanno dimostrato che le strategie di posizionamento intelligente del traffico attenuano il sovraccarico dei proxy sidecar, riducendo i tempi di risposta e stabilizzando il throughput.
Devi monitorare continuamente l'impatto del traffico di rete sulle prestazioni del sistema. Piccoli ritardi che si accumulano possono facilmente trasformarsi in colli di bottiglia importanti.
Punti di guasto
Rischi di propagazione
I microservizi cambiano in modo sostanziale il profilo dei guasti del sistema. Poiché ogni servizio dipende dagli altri, un singolo guasto può propagarsi a tutta l'infrastruttura.
| Tipo di architettura | Rischio di propagazione dei guasti | Isolamento dei guasti | Resilienza del sistema |
|---|---|---|---|
| Monolitico | Alto | No | Bassa |
| Microservizi | Basso | Sì | Alta |
In un sistema monolitico, un solo bug fatale può bloccare l'intero processo dell'applicazione. I microservizi offrono un isolamento dei guasti molto migliore: se un servizio non critico si interrompe, gli altri possono continuare a funzionare. I pattern di resilienza, come i circuit breaker, aiutano a impedire che i guasti si diffondano a livello globale.
- In un monolite, un singolo bug può causare un'interruzione completa, creando un singolo punto di guasto.
- I microservizi consentono una vera tolleranza ai guasti, evitando che il malfunzionamento di componenti non critici comprometta l'intera piattaforma.
- Pattern come i circuit breaker migliorano la resilienza isolando le dipendenze a valle che presentano problemi.
Sfide di osservabilità
Per individuare e risolvere i problemi di prestazioni in una rete di microservizi così estesa serve un'osservabilità completa. Individuare la causa di latenze o errori intermittenti diventa esponenzialmente più difficile man mano che i servizi si moltiplicano. Devi aggregare log, metriche infrastrutturali e tracce distribuite di ogni istanza in esecuzione. Senza strumenti di osservabilità robusti, perderai innumerevoli ore a cercare l'origine dei rallentamenti in produzione.
I colli di bottiglia nelle prestazioni si nascondono spesso in catene di chiamate complesse e asincrone. Dovresti usare il tracciamento distribuito per seguire le richieste attraverso i confini dei servizi, così da individuare i colli di bottiglia prima che impattino sugli utenti.
Attenzione a questi anti-pattern classici:
- God Service (troppe responsabilità): un servizio che gestisce più domini di business eterogenei, violando i principi fondamentali dell'architettura.
- Accoppiamento stretto tra servizi: dipendenze dirette e hardcoded che interrompono i sistemi a valle ogni volta che cambia uno schema.
Contesa sul database
Archivi dati condivisi
Molti team commettono l'errore critico di condividere un database tra più microservizi. Questa pratica crea un forte accoppiamento a livello di schema. Modificare la struttura del database diventa rischioso, perché può interrompere i servizi esterni, compromettendo la velocità di sviluppo e la scalabilità indipendente.
Il problema principale dei database condivisi è che creano un accoppiamento a livello di schema. Il costo del cambiamento aumenta drasticamente, perché diventa difficile capire quando puoi apportare modifiche in sicurezza senza rompere un altro servizio. Questo ha effetti a catena sulla scalabilità del sistema: non puoi scalare i servizi singolarmente se dipendono tutti da un archivio dati condiviso. Poiché la scalabilità di un servizio è limitata dal suo componente più lento, un database condiviso diventa rapidamente un enorme collo di bottiglia.
Dovresti eliminare completamente gli archivi dati condivisi. Assegna a ogni microservizio un proprio database dedicato per disaccoppiare i livelli dei dati e ripristinare le prestazioni.
Problemi di scalabilità
La contesa sul database è una bomba a orologeria per le applicazioni aziendali. Quando più microservizi si contendono lo stesso motore di database, si crea un forte collo di bottiglia prestazionale. La query o il servizio più lento limita la capacità dell'intero sistema, con conseguente esaurimento del pool di connessioni, aumento della latenza e interruzioni catastrofiche durante i picchi di traffico.
Individuare i colli di bottiglia nell'architettura a microservizi
Strumenti di monitoraggio
Metriche
Devi monitorare le metriche operative giuste per individuare tempestivamente il degrado delle prestazioni. Le metriche offrono una fotografia istantanea dello stato del sistema e ti aiutano a intercettare le tendenze prima che abbiano impatto sulla produzione. Concentrati molto sugli indicatori rilevanti per il business, insieme alle metriche tecniche: monitora i tempi di risposta p99, i tassi di errore e la velocità di elaborazione delle richieste (throughput).
Visibilità
La visibilità non è negoziabile nei sistemi distribuiti. Non puoi risolvere ciò che non riesci a vedere. Implementa strumenti di monitoraggio che acquisiscano la telemetria da ogni istanza di servizio:
- Prometheus, Datadog e Grafana per il monitoraggio in tempo reale dell'infrastruttura e delle applicazioni.
- Elasticsearch, Logstash, Kibana (ELK) o Graylog per l'aggregazione centralizzata dei log.
- Strumenti di Application Performance Monitoring (APM), come New Relic o Dynatrace, per l'analisi delle chiamate a livello di codice.
- Kubernetes o altri orchestratori di container per l'osservabilità del cluster sottostante.
- Gateway API come Kong o Zuul per l'analisi del traffico in ingresso.
Tracciamento distribuito
Flussi delle richieste
Il tracciamento distribuito consente di seguire una richiesta HTTP mentre attraversa l'architettura a microservizi. Strumenti di tracciamento come OpenTelemetry, Jaeger e Zipkin collegano queste chiamate tra loro, mostrando il percorso di esecuzione end-to-end ed evidenziando i punti esatti di latenza.
- Il tracciamento distribuito offre una visibilità approfondita oltre i confini dei servizi.
- Mette in luce colli di bottiglia nascosti e accelera notevolmente i flussi di debugging.
- I team di ingegneria usano le tracce per individuare le fonti di latenza e migliorare l'affidabilità.
Fonti di latenza
La latenza si accumula man mano che le richieste passano da un servizio all'altro. I log standard e le metriche infrastrutturali, da soli, non possono mostrare questo livello di granularità transazionale. Il tracciamento conserva il contesto della richiesta attraverso i passaggi di rete, così puoi individuare il metodo o la query di database esatti che causano i rallentamenti.
Riconoscere i rallentamenti nascosti
Sintomi
I rallentamenti nascosti possono compromettere l'esperienza utente anche in assenza di interruzioni totali. Tieni d'occhio l'aumento dei tempi di risposta, dei tassi di errore e dell'utilizzo di memoria. Usa gli ID di correlazione per seguire le richieste attraverso i sistemi e configura avvisi proattivi basati su obiettivi di livello di servizio (SLO) rigorosi.
Casi reali
I casi di studio reali dimostrano quanto sia importante individuare in anticipo i colli di bottiglia. Ad esempio, un microservizio Spring Boot ad alto carico ha subito un grave degrado delle prestazioni. Grazie ad APM e strumenti di profilazione approfonditi, il team di ingegneria ha scoperto un ciclo di query non ottimizzato. Introducendo una specifica clausola per raggruppare le operazioni sul database, hanno ridotto le query al secondo da 300 a 30, stabilizzando immediatamente l'utilizzo della CPU e eliminando il sovraccarico della garbage collection.
Suggerimento: combina sempre metriche, log e tracce in un'unica pipeline di osservabilità. Questa combinazione ti offre una visione immediata e completa dello stato del sistema.
Soluzioni ai problemi di prestazioni dei microservizi
Comunicazione asincrona
Vantaggi della messaggistica
Puoi risolvere molti problemi di scalabilità in un'architettura a microservizi adottando la comunicazione asincrona. Disaccoppiando le richieste tramite code di messaggi, i servizi elaborano il lavoro al proprio ritmo, assorbendo i picchi di traffico in modo sicuro senza perdere richieste.
| Miglioramento delle prestazioni | Descrizione |
|---|---|
| Scalabilità | La messaggistica asincrona consente una scalabilità notevole utilizzando code per assorbire i picchi di traffico. |
| Affidabilità | I broker asincroni supportano i tentativi di nuova consegna dei messaggi e le dead-letter queue, garantendo la perdita zero di messaggi durante i periodi di indisponibilità. |
| Testabilità | I test diventano più semplici, perché i servizi consumatori hanno bisogno solo di una coda simulata per verificare il payload. |
Implementazione
Implementa la comunicazione asincrona con broker di messaggi affidabili come RabbitMQ, Azure Service Bus o Apache Kafka. Usa i pattern publish-subscribe per trasmettere in modo pulito gli eventi di dominio tra servizi indipendenti.
Bulkhead & Circuit Breaker
Strategie di isolamento
Proteggi i tuoi microservizi dai guasti a cascata usando bulkhead e circuit breaker. I bulkhead suddividono i pool di risorse, così che un guasto in un servizio non possa esaurire thread o connessioni nell'intero sistema.
I bulkhead sono progettati per isolare i domini di guasto creando pool di risorse o quote separate per servizi diversi, impedendo che guasti localizzati mandino fuori servizio l'intera applicazione.
Mitigazione dei guasti
I circuit breaker monitorano i tassi di errore e bloccano immediatamente le richieste verso dipendenze non operative, evitando interruzioni a cascata in tutta la rete.
Il pattern bulkhead nell'architettura a microservizi serve a impedire che i guasti in una parte del sistema mandino in crash l'intera piattaforma, isolando efficacemente i guasti alla loro origine.
Cache e scalabilità
Selezione dell'archivio dati
La cache è uno strumento essenziale per microservizi ad alte prestazioni. Sposta le letture ripetute dal database e i calcoli costosi delle API su cache in memoria veloci come Redis o Memcached.
| Vantaggio | Descrizione |
|---|---|
| Controllo granulare | Metti in cache i frammenti di dominio in base alla volatilità e alla frequenza di aggiornamento. |
| Invalidazione della cache ridotta | Riduce il sovraccarico delle purghe aggiornando solo i segmenti di dati interessati. |
| Migliori percentuali di hit della cache | Consente voci di cache più piccole e altamente ottimizzate, per tassi di hit più elevati in memoria. |
| Gestione ibrida dinamica/statica | Supporta la cache dei record statici recuperando dinamicamente le statistiche in tempo reale. |
Scalabilità indipendente
La cache e gli archivi dati separati ti consentono di scalare i singoli servizi in modo indipendente, eliminando i colli di bottiglia dovuti alla contesa di risorse.
- Maggiore scalabilità del sistema
- Maggiore agilità di sviluppo e time to market più rapido
- Solido isolamento dei guasti e resilienza del sistema
- Utilizzo economicamente efficiente delle risorse cloud
- Migliore integrazione DevOps e pipeline di distribuzione continua
Riduzione delle dipendenze
Disaccoppiamento
I veri microservizi richiedono un disaccoppiamento radicale. Quando i servizi operano in modo indipendente, senza chiamate sincrone bloccanti, eliminano colli di bottiglia artificiali.
Il disaccoppiamento significa che ogni microservizio gestisce il proprio carico di lavoro interno senza attendere in modo sincrono processi esterni. Questa indipendenza evita i colli di bottiglia e mantiene la piattaforma in funzione senza intoppi.
I principali vantaggi architetturali della riduzione delle dipendenze includono:
- Scalabilità indipendente dei servizi in base ai carichi di lavoro in tempo reale.
- Rischio ridotto di guasti a cascata oltre i confini dei team.
- Autonomia dei team di sviluppo nel rilasciare il codice secondo la propria pianificazione.
- Individuazione più rapida della causa principale durante la gestione degli incidenti.
Semplificazione
Semplificare il grafo delle dipendenze riduce il carico cognitivo, rendendo l'architettura molto più facile da testare, monitorare e proteggere.
| Approccio | Cosa significa | Perché è importante |
|---|---|---|
| SLO individuali | Monitorare l'affidabilità di ciascun microservizio separatamente | Possono non rilevare il degrado dell'esperienza utente a livello di sistema |
| SLO compositi | Combinare gli obiettivi di affidabilità tra servizi interdipendenti | Riflettono la vera integrità del sistema end-to-end |
Valutare l'adeguatezza dell'architettura a microservizi
Scegliere il modello architetturale giusto determina la velocità di sviluppo e i costi operativi. Il Microsoft Development Podcast esplora spesso questa tensione, evidenziando una tendenza crescente: le organizzazioni stanno riunendo microservizi eccessivamente frammentati in monoliti modulari gestibili.
Matrice decisionale
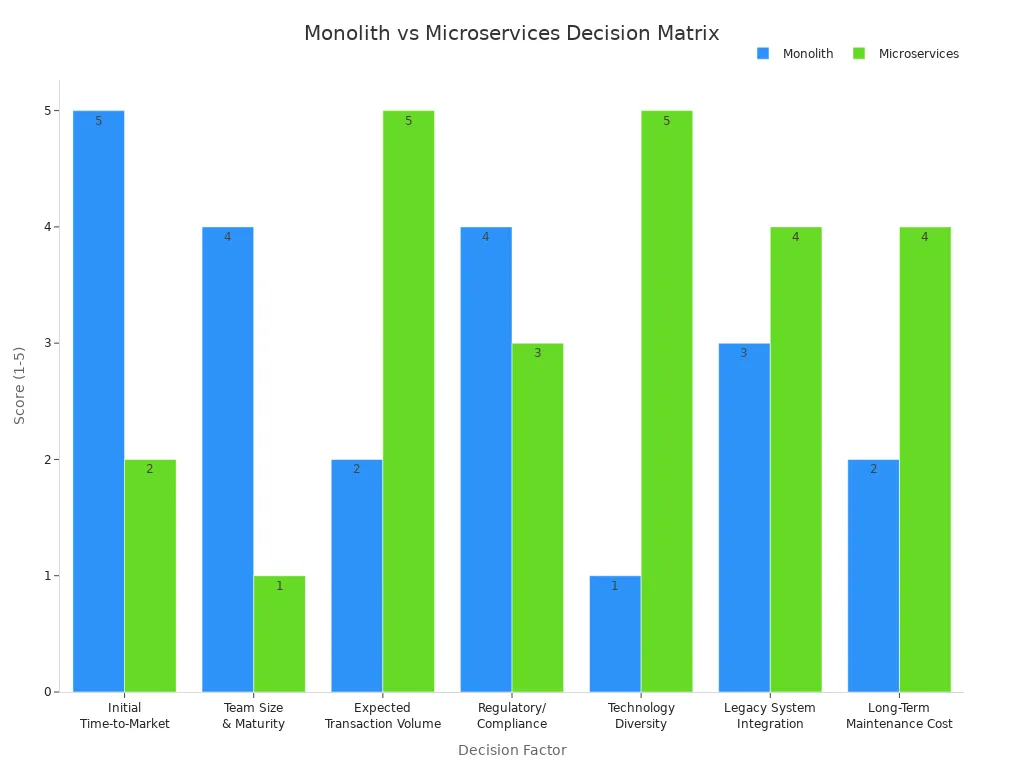
Usa una matrice decisionale strutturata per valutare se i microservizi sono davvero adatti alla maturità della tua organizzazione:
| Fattore decisionale | Punteggio monolite (1-5) | Punteggio microservizi (1-5) | Motivazione strategica |
|---|---|---|---|
| Tempo iniziale di messa sul mercato (velocità) | 5 | 2 | I monoliti richiedono una configurazione iniziale dell'infrastruttura minima. |
| Dimensione e maturità del team (DevOps) | 4 | 1 | I microservizi richiedono CI/CD, automazione e osservabilità avanzate. |
| Volume di transazioni previsto (scalabilità) | 2 | 5 | I microservizi consentono di scalare in modo preciso e indipendente i colli di bottiglia che consumano più risorse. |
| Complessità normativa/di conformità | 4 | 3 | Un unico artefatto semplifica le verifiche di sicurezza e conformità iniziali. |
| Diversità tecnologica/sperimentazione | 1 | 5 | I microservizi consentono ai team di adottare stack tecnologici specializzati per ogni dominio di servizio. |
| Integrazione con sistemi legacy | 3 | 4 | I microservizi sono particolarmente efficaci nel racchiudere e modernizzare i componenti legacy. |
| Costo di manutenzione a lungo termine (TCO) | 2 | 4 | I microservizi riducono nel tempo il costo delle nuove funzionalità, a fronte però di un maggiore carico operativo. |
Domande chiave per la valutazione
- Il tuo team di ingegneria dispone di solide competenze in DevOps, platform engineering e SRE?
- Hai requisiti di scalabilità estremi che giustificano il sovraccarico di un sistema distribuito?
- Hai bisogno di persistenza poliglotta e diversità tecnologica?
- La cultura della tua organizzazione è pronta a gestire gli elevati costi di coordinamento tra team?
Segnali da non ignorare
Fai attenzione a questi campanelli d'allarme che indicano che la tua architettura a microservizi necessita di una ristrutturazione:
- La velocità di consegna si blocca a causa di continue dipendenze tra team.
- I costi operativi del cloud crescono più velocemente dei ricavi dell'azienda.
- Le interruzioni si propagano facilmente su più domini.
Monolite vs microservizi
| Tipo di architettura | Dimensione del team consigliata | Caratteristiche principali |
|---|---|---|
| Monolitica | < 8-10 sviluppatori | Distribuzioni semplici, basso carico operativo |
| Microservizi | > 10-15 sviluppatori | Piena autonomia dei team, coordinamento distribuito complesso |
Implementando un'architettura a microservizi incontri complessità nascoste e rischi per le prestazioni. I colli di bottiglia compaiono inevitabilmente in livelli di rete e dati inattesi. Il Microsoft Development Podcast sottolinea come una consegna rapida richieda una disciplina architetturale rigorosa. Per mantenere sani i tuoi sistemi .NET, ricorda di:
- Gestire con attenzione le richieste tra servizi e i criteri di timeout.
- Implementare il bilanciamento del carico elastico e la scalabilità automatica.
- Disaccoppiare gli archivi dati in modo che ogni servizio possieda il proprio database.
- Mettere in cache in modo aggressivo le query API e database ripetitive.
Dovresti inoltre applicare una governance architetturale, utilizzare API gateway solidi e svolgere revisioni architetturali periodiche. La valutazione continua garantisce che lo stack tecnologico scali in modo efficace insieme al business.
Domande frequenti
Che cos'è un monolite distribuito?
Un monolite distribuito è un anti-pattern in cui un'applicazione viene suddivisa fisicamente in più microservizi, ma resta accoppiata a livello logico tramite chiamate HTTP sincrone, database condivisi e dipendenze strette in fase di distribuzione, perdendo così i vantaggi fondamentali dei microservizi.
Come si individuano i colli di bottiglia delle prestazioni nei microservizi?
Monitora i tempi di risposta p99, i tassi di errore e il throughput delle richieste. Usa strumenti di tracciamento distribuito per seguire le richieste attraverso i confini dei servizi e individuare hop di rete lenti o query di database.
Perché la latenza di rete è importante nell'architettura a microservizi?
La latenza di rete aggiunge millisecondi di ritardo a ogni chiamata tra servizi. A differenza delle chiamate in memoria immediate di un monolite, gli hop di rete distribuiti si accumulano rapidamente, riducendo la reattività complessiva dell'applicazione.
Come si può ridurre il sovraccarico di coordinamento tra i team?
Definisci confini chiari di responsabilità per ogni dominio, automatizza i controlli di governance delle API, riduci le riunioni di stato superflue e adotta modelli di comunicazione asincroni, così da dare ai team la possibilità di lavorare in autonomia.
Quali strumenti aiutano con l'osservabilità nei microservizi .NET?
Tra gli strumenti di osservabilità più diffusi ci sono Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin e le piattaforme di logging centralizzato come lo stack ELK, che insieme raccolgono metriche, log e tracce distribuite.
Quando conviene valutare il consolidamento dei microservizi?
Valuta il consolidamento se la velocità di rilascio delle funzionalità cala, i costi dell'infrastruttura cloud crescono fuori controllo o le interruzioni a cascata compromettono regolarmente la disponibilità del servizio.
Qual è il modo migliore per gestire i dati condivisi nei microservizi?
Assegna a ogni microservizio un database privato. Evita di condividere i database tra servizi per eliminare l'accoppiamento tramite lo schema e ripristinare la scalabilità indipendente del database.
In che modo la comunicazione asincrona migliora le prestazioni dei microservizi?
La comunicazione asincrona tramite message broker consente ai servizi di elaborare gli eventi con il proprio ritmo, assorbendo i picchi di traffico ed eliminando i colli di bottiglia sincroni che bloccano il flusso.
🎧 Ascolta questo episodio
Vuoi una spiegazione pratica e approfondita di Perché l'architettura a microservizi rallenta il rilascio del software? Questo episodio illustra con un linguaggio chiaro questi temi architetturali fondamentali e spiega perché sono importanti per Microsoft 365, Azure, Power Platform, la sicurezza enterprise, l'AI e l'ingegneria del software moderna.
Ascolta questo episodio se vuoi:
- Capire i concetti chiave alla base del motivo per cui i microservizi possono rallentare il rilascio del software
- Scoprire come l'architettura si inserisce nel più ampio ecosistema tecnologico Microsoft
- Capire dove può generare valore pratico e misurabile per la tua organizzazione enterprise
Potrebbero interessarti anche questi episodi correlati di M365 FM:
- Il mito del monorepo: perché la tua architettura è frammentata
- Microsoft Graph Automation Architecture: Beyond Scripts
- Agenti IA basati su Graph: una guida all'architettura enterprise
- Estensibilità .NET e Clean Architecture con Miguel Castro [MVP]
- Enterprise AI Agent Fabric: Architecture Beyond Chatbots
Scopri altre conversazioni pratiche sull'ingegneria Microsoft su M365 FM.