 FR
 English
 Deutsch
 Español
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Éviter le piège du monolithe distribué dans les microservices .NET
Par Mirko Peters ·
Lorsque les équipes d’ingénierie passent d’une application monolithique à une architecture de microservices, elles poursuivent généralement un ensemble très précis de promesses : une livraison des fonctionnalités plus rapide, une mise à l’échelle indépendante, une isolation locale des pannes et la liberté d’expérimenter avec des technologies modernes. Pourtant, de nombreuses organisations .NET se
Traduit automatiquement par IA à partir de l'article original. Lire l'original en anglais
Lorsque les équipes d’ingénierie passent d’une application monolithique à une architecture de microservices, elles poursuivent généralement un ensemble très précis de promesses : une livraison des fonctionnalités plus rapide, une mise à l’échelle indépendante, une isolation locale des pannes et la liberté d’expérimenter avec des technologies modernes. Pourtant, de nombreuses organisations .NET se heurtent à un mur : la vélocité de développement s’effondre. Plutôt qu’un écosystème agile et faiblement couplé, elles se retrouvent à maintenir un monolithe distribué, une architecture qui combine la complexité opérationnelle des systèmes distribués et le couplage fort d’un monolithe traditionnel.
Ce problème est rarement malveillant ni intentionnel. Il s’installe généralement à travers des choix d’architecture subtils, comme le partage d’une base de données entre plusieurs services, une dépendance marquée aux appels HTTP synchrones, ou une gouvernance des API qui devient un goulot d’étranglement administratif. Dans cet article, nous allons examiner les symptômes du piège du monolithe distribué, mettre au jour les problèmes de performance cachés dans vos couches réseau, identifier les goulots d’étranglement architecturaux à l’aide d’outils d’observabilité modernes, et parcourir des stratégies concrètes pour retrouver une mise à l’échelle indépendante dans vos microservices .NET. Si votre équipe ressent le frein d’un rythme de livraison en baisse, vous n’êtes pas seul, et comprendre ces schémas est la première étape pour retrouver votre agilité.
Architecture de microservices : une complexité cachée
Monolithes distribués
Symptômes
Vous pensez peut-être que découper votre application en microservices résoudra automatiquement vos problèmes de performance. Pourtant, vous pouvez facilement aboutir à un monolithe distribué. Cela se produit lorsque les services dépendent les uns des autres à un point tel que vous perdez les véritables bénéfices de la séparation. Vous pourriez remarquer ces symptômes courants :
- Les services reposent sur des appels synchrones pour chaque opération métier courante.
- Les équipes peinent à déployer des modifications individuelles sans risquer une interruption de service ou la rupture des services en aval.
- Les bases de données partagées vous obligent à coordonner étroitement les modifications de schéma entre plusieurs équipes de développement distinctes.
- Les composants restent fortement couplés, alors même qu’ils s’exécutent physiquement dans des processus ou des conteneurs séparés.
Impact sur la vitesse
Un monolithe distribué peut ralentir votre système de manières auxquelles vous ne vous attendiez pas forcément. Vous constaterez une hausse de la latence réseau, car chaque appel entre services ajoute un délai. Contrairement à une application monolithique, où les appels s’effectuent instantanément en mémoire, une architecture de microservices déplace vos goulots d’étranglement de performance de la base de données ou du processeur vers la couche réseau. Les appels synchrones entre microservices accumulent la latence, alors qu’un monolithe traite ces appels en interne au processus. Par conséquent, vous perdez la capacité de mettre à l’échelle les services indépendamment et d’isoler efficacement les pannes, ce qui amplifie les problèmes de performance à mesure que votre arbre de dépendances s’étend.
Lorsque vous tentez de distribuer une application monolithique sans conception appropriée des frontières, vous rencontrez souvent de sérieux problèmes de performance. Les composants restent fortement dépendants les uns des autres, et vous ne bénéficiez pas de la mise à l’échelle indépendante ni de l’isolation des pannes que procurent des microservices bien structurés.
Surcharge de coordination
Gouvernance des API
L’architecture de microservices exige une gouvernance des API rigoureuse. Vous devez examiner et approuver chaque modification pour éviter l’accumulation de dette technique et la duplication des efforts. Si la gouvernance est trop stricte, vous ralentissez le développement jusqu’à l’immobilisme. Si elle est trop laxiste, vous risquez de accumuler une dette technique structurelle en quelques jours seulement.
Lorsque la gouvernance est soit trop laxiste, soit trop stricte, elle peut entraîner de la dette technique, une duplication des efforts et des ralentissements importants du processus de développement.
En somme, vous accumulez très rapidement une grande quantité de dette technique. Et au bout du compte, vous devez consacrer davantage d’argent et de temps à tout démanteler pour repartir de zéro.
Vous devez concevoir vos modèles de gouvernance pour qu’ils profitent activement aux développeurs. L’automatisation contribue à améliorer la qualité, la sécurité et la cohérence des API sans ajouter de charge administrative.
Lorsque la gouvernance est conçue pour profiter aux développeurs et renforcée par l'automatisation, elle devient un catalyseur d'amélioration de la qualité, de la sécurité et de la cohérence des API.
Les API jouent un rôle essentiel dans votre stratégie d'entreprise globale. Vous devez les traiter comme des citoyens de première classe.
Dans le dernier rapport sur l'état de l'intégration des API, 84 % des entreprises ont déclaré que les API étaient critiques ou très critiques pour leur stratégie commerciale de base.
Collaboration d'équipe
Les microservices exigent une coordination constante entre les équipes. Vous passez des heures à préparer des réunions, à basculer d'un domaine à l'autre et à clarifier les rôles inter-équipes. Ces activités peuvent facilement absorber une part importante de votre semaine de travail.
| Facteurs de coût de coordination | Description |
|---|---|
| Latence décisionnelle | Retards dus à la multiplicité des parties prenantes et à des chaînes d'approbation lourdes |
| Changement de contexte | Attention fragmentée entre de nombreux points de coordination transversaux |
| Dégradation de l'information | Perte ou déformation de connaissances critiques à travers les niveaux de l'organisation |
| Ambiguïté des rôles | Responsabilités mal définies, entraînant des lacunes et des doublons de développement |
| Activité de coordination | Temps consacré |
|---|---|
| Préparation de réunions | Plus de 8 heures par semaine |
| Activités de coordination | 35 à 80 % du temps des travailleurs du savoir |
Vous devez reconnaître que la charge de coordination peut discrètement freiner la vitesse de livraison. Des périmètres de responsabilité clairs et des canaux de communication rationalisés sont indispensables pour éviter les lacunes et les efforts dupliqués.
Défis de l'écosystème .NET
Ingénierie de plateforme
L'architecture microservices dans l'écosystème .NET soulève des défis d'ingénierie spécifiques. Vous êtes fréquemment confronté à la duplication de code et aux redondances, qui augmentent les efforts de maintenance et risquent de provoquer des incohérences de données. Les développeurs doivent souvent gérer une quantité excessive de code standard simplement pour mettre en place et faire fonctionner l'infrastructure. L'organisation du code source devient extrêmement difficile lorsque vous partagez mal les modèles de domaine entre les services. Les anti-patterns du copier-coller retardent la correction des bogues et compliquent considérablement la maintenance à long terme.
- La duplication de code entraîne des coûts de maintenance continus plus élevés.
- Les modèles partagés entre services rendent les mises à jour de schéma hasardeuses.
- Les développeurs peuvent copier-coller la logique des services, ce qui ralentit la correction de bogues critiques.
Frontières de domaine
Vous devez définir des frontières de domaine d'une netteté absolue lorsque vous concevez des microservices en .NET. Si vous ne le faites pas, vous augmentez considérablement la charge cognitive des développeurs. Trop d'exigences architecturales simultanées submergent votre équipe. Faire respecter les standards et la conformité devient difficile, ce qui peut entraîner des problèmes de fiabilité et affaiblir votre posture de sécurité globale.
- La charge cognitive augmente fortement lorsque les développeurs jonglent avec de nombreux services interconnectés.
- Il devient plus difficile d'appliquer de manière cohérente les standards et la conformité de l'entreprise.
- La fiabilité et la sécurité se dégradent lorsque les frontières de domaine sont mal définies.
Bien que l'architecture microservices offre des avantages convaincants, vous devez anticiper proactivement sa complexité cachée. Soyez attentif aux symptômes d'un monolithe distribué, maîtrisez la charge de coordination et affrontez de front les défis de la plateforme .NET.
Bombe à retardement : problèmes de performance
Vous pourriez penser que les microservices accélèrent naturellement le système, mais sans une conception rigoureuse, ils peuvent devenir une bombe à retardement pour votre infrastructure. De nombreuses équipes d'ingénierie ne découvrent les problèmes de performance courants qu'après le déploiement en production. Ces problèmes restent cachés, prêts à faire chuter votre application sous forte charge. Vous devez comprendre comment la latence réseau, les points de défaillance en cascade et la contention sur les bases de données transforment votre architecture en source de frustrations chroniques en production.
Latence réseau
Appels in-process et appels réseau
Lorsque vous découpez un monolithe en microservices, vous passez d'appels de fonction in-process à des appels réseau. Ce changement architectural introduit une latence inévitable. Dans une application monolithique, un appel de fonction s'exécute presque instantanément. Dans une architecture microservices, chaque appel entre services doit traverser le réseau, ajoutant des millisecondes de délai.
| Type d'architecture | Latence moyenne |
|---|---|
| Appel de fonction in-process (monolithe) | 0,001 ms (1 microseconde) |
| Appel HTTP au sein du même datacenter (microservices) | 1 à 5 ms (1 000 à 5 000 microsecondes) |
Les appels réseau sont des ordres de grandeur plus lents que les appels de fonctions en processus. Cet écart s’accentue rapidement à mesure que votre système monte en charge. Chaque nouveau service ajouté à une chaîne de requêtes ajoute de la latence, transformant des opérations simples en expériences lentes et frustrantes pour les utilisateurs finaux.
Consommation de ressources
Les appels réseau ne se contentent pas d’ajouter de la latence : ils consomment des ressources système précieuses. Chaque appel mobilise des cycles CPU, des tampons mémoire et de la bande passante réseau. Plus vous ajoutez de microservices, plus le trafic réseau croît de façon exponentielle. Cette charge supplémentaire entraîne des coûts d’infrastructure cloud plus élevés et des temps de réponse plus lents.
Vous pouvez améliorer les performances en réduisant de manière agressive les appels inutiles entre services. Certaines équipes avancées s’appuient sur une gestion intelligente du trafic pour réduire la latence et renforcer la résilience :
- L’approche MCG a amélioré les temps de réponse de 15 % face à une latence réseau accrue, grâce à la réduction des délais de communication inter-services.
- En cas de charge maximale, la configuration optimisée par MCG a fait preuve d’une résilience supérieure, avec moins d’erreurs que les configurations standard de maillage de services (service mesh).
- Les évaluations de performance ont démontré que les stratégies intelligentes de placement du trafic atténuaient la surcharge des proxys sidecar, réduisant les temps de réponse et stabilisant le débit.
Vous devez surveiller en continu l’impact du trafic réseau sur les performances de votre système. De petits retards accumulés peuvent rapidement se transformer en goulets d’étranglement majeurs.
Points de défaillance
Risques de propagation
Les microservices modifient fondamentalement le profil de défaillance de votre système. Comme chaque service dépend des autres, une seule défaillance peut se propager à l’ensemble de votre infrastructure.
| Type d’architecture | Risque de propagation des défaillances | Isolation des pannes | Résilience du système |
|---|---|---|---|
| Monolithique | Élevé | Non | Faible |
| Microservices | Faible | Oui | Élevée |
Dans un système monolithique, un seul bug fatal peut faire tomber l’ensemble du processus applicatif. Les microservices offrent une bien meilleure isolation des pannes : si un service non critique tombe en panne, les autres peuvent continuer à fonctionner. Des modèles de résilience comme les disjoncteurs (circuit breakers) permettent d’empêcher la propagation globale des défaillances.
- Dans un monolithe, un seul bug peut provoquer une panne totale, créant un point de défaillance unique.
- Les microservices permettent une véritable tolérance aux pannes, garantissant que la défaillance de composants non critiques ne fasse pas sombrer la plateforme.
- Des modèles comme les disjoncteurs renforcent la résilience en isolant les dépendances aval défaillantes.
Défis de l’observabilité
Vous avez besoin d’une observabilité complète pour détecter et corriger les problèmes de performance au sein d’un maillage de microservices étendu. Identifier la cause profonde d’une latence ou d’erreurs intermittentes devient exponentiellement plus difficile à mesure que les services se multiplient. Vous devez agréger les journaux, les métriques d’infrastructure et les traces distribuées de chaque instance en cours d’exécution. Sans outils d’observabilité robustes, vous perdrez d’innombrables heures à chercher l’origine des ralentissements en production.
Les goulets d’étranglement de performance se cachent souvent dans des chaînes d’appels complexes et asynchrones. Vous devriez exploiter le traçage distribué pour suivre les requêtes à travers les frontières, afin de repérer les goulets d’étranglement avant qu’ils n’affectent vos utilisateurs.
Méfiez-vous de ces anti-patterns classiques :
- God Service (trop de responsabilités) : un service qui gère plusieurs domaines métier disparates, en violation des principes d’architecture fondamentaux.
- Couplage fort entre services : dépendances codées en dur qui cassent les systèmes en aval dès qu’un schéma évolue.
Contention sur les bases de données
Magasins de données partagés
De nombreuses équipes commettent l’erreur critique de partager une base de données entre plusieurs microservices. Cette pratique crée un couplage sévère au niveau du schéma. Modifier la structure de votre base de données devient périlleux, car cela risque de casser les services externes, compromettant votre vélocité et votre capacité à monter en charge de façon indépendante.
Le principal problème des bases de données partagées est qu’elles créent un couplage au niveau du schéma. Le coût des évolutions augmente fortement, car il devient difficile de savoir quand il est possible de modifier un service sans en casser un autre. Cela a des répercussions sur la scalabilité du système : vous ne pouvez pas faire évoluer les services individuellement lorsqu’ils reposent sur un magasin de données partagé. Comme la scalabilité d’un service est limitée par son composant le plus lent, une base de données partagée devient rapidement un goulot d’étranglement majeur.
Vous devez supprimer entièrement les magasins de données partagés. Attribuez à chaque microservice sa propre base de données dédiée afin de découpler vos couches de données et de restaurer les performances.
Problèmes de scalabilité
La contention sur les bases de données est une bombe à retardement pour les applications d’entreprise. Lorsque plusieurs microservices se disputent le même moteur de base de données, vous créez un goulot d’étranglement de performance important. La requête ou le service le plus lent limite la capacité de l’ensemble du système, ce qui entraîne l’épuisement du pool de connexions, une hausse de la latence et des interruptions catastrophiques lors des pics de trafic.
Identifier les goulots d’étranglement dans une architecture de microservices
Outils de supervision
Métriques
Vous devez suivre les bonnes métriques opérationnelles pour repérer tôt toute dégradation des performances. Les métriques offrent un instantané immédiat de la santé de votre système et vous aident à détecter les tendances avant qu’elles n’affectent la production. Concentrez-vous fortement sur les indicateurs pertinents pour le métier, en complément des métriques techniques : suivez les temps de réponse p99, les taux d’erreur et le débit des requêtes.
Visibilité
La visibilité est indispensable pour les systèmes distribués. On ne peut pas corriger ce que l’on ne voit pas. Mettez en place des outils de supervision qui collectent la télémétrie de chaque instance de service :
- Prometheus, Datadog et Grafana pour la supervision en temps réel de l’infrastructure et des applications.
- Elasticsearch, Logstash, Kibana (ELK) ou Graylog pour l’agrégation centralisée des journaux.
- Les outils de supervision des performances applicatives (APM) comme New Relic ou Dynatrace pour le profilage des appels au niveau du code.
- Kubernetes ou les orchestrateurs de conteneurs pour l’observabilité sous-jacente du cluster.
- Les passerelles d’API comme Kong ou Zuul pour l’analyse du trafic en périphérie.
Traçage distribué
Parcours des requêtes
Le traçage distribué permet de suivre une requête HTTP à travers votre architecture de microservices. Des outils de traçage comme OpenTelemetry, Jaeger et Zipkin relient ces appels entre eux, affichent le chemin d’exécution de bout en bout et mettent en évidence les points de latence précis.
- Le traçage distribué offre une visibilité approfondie au-delà des frontières des services.
- Il révèle les goulots d’étranglement cachés et accélère considérablement les flux de débogage.
- Les équipes d’ingénierie utilisent les traces pour identifier les sources de latence et améliorer la fiabilité.
Sources de latence
La latence s’accumule à mesure que les requêtes transitent d’un service à l’autre. Les journaux standards et les métriques d’infrastructure seuls ne permettent pas d’atteindre ce niveau de granularité transactionnelle. Le traçage conserve le contexte de la requête à travers les sauts réseau, ce qui permet d’identifier précisément la méthode ou la requête de base de données à l’origine des ralentissements.
Repérer les ralentissements cachés
Symptômes
Les ralentissements cachés peuvent nuire à l’expérience utilisateur, même en l’absence de panne totale. Surveillez la hausse des temps de réponse, l’augmentation des taux d’erreur et la consommation mémoire croissante. Utilisez des identifiants de corrélation pour suivre les requêtes à travers vos systèmes et mettez en place des alertes proactives basées sur des objectifs de niveau de service (SLO) stricts.
Cas concrets
Les études de cas d’ingénierie réelles soulignent l’importance d’une détection proactive des goulots d’étranglement. Par exemple, un microservice Spring Boot très sollicité souffrait d’une dégradation sévère des performances. Grâce à des outils APM et de profilage poussés, l’équipe d’ingénierie a découvert une boucle de requêtes non optimisée. En introduisant une clause spécifique permettant de regrouper les opérations de base de données, elle a réduit le nombre de requêtes par seconde de 300 à 30, ce qui a immédiatement stabilisé l’utilisation du processeur et supprimé la surcharge liée au ramasse-miettes.
Astuce : combinez toujours les métriques, les journaux et les traces dans un pipeline d’observabilité unifié. Cette combinaison vous offre une vue immédiate et globale de la santé de votre système.
Solutions aux problèmes de performance des microservices
Communication asynchrone
Avantages de la messagerie
Vous pouvez résoudre de nombreux problèmes de montée en charge dans une architecture microservices en adoptant la communication asynchrone. En découplant les requêtes via des files d’attente de messages, les services traitent le travail à leur propre rythme et absorbent sans risque les pics de trafic, sans perdre de requêtes.
| Amélioration des performances | Description |
|---|---|
| Évolutivité | La messagerie asynchrone permet une montée en charge massive, grâce à des files d’attente qui tamponnent les pics de trafic. |
| Fiabilité | Les courtiers asynchrones prennent en charge les nouvelles tentatives d’envoi de messages et les files de lettres mortes, garantissant une perte de messages nulle pendant les interruptions de service. |
| Testabilité | Les tests sont plus simples, car les services consommateurs n’ont besoin que d’une file factice pour vérifier les charges utiles. |
Mise en œuvre
Mettez en œuvre la communication asynchrone à l’aide de courtiers de messages robustes comme RabbitMQ, Azure Service Bus ou Apache Kafka. Utilisez les modèles publication-abonnement pour diffuser proprement les événements de domaine entre des services indépendants.
Cloisons étanches & disjoncteurs
Stratégies d’isolation
Protégez vos microservices contre les défaillances en cascade à l’aide de cloisons étanches et de disjoncteurs. Les cloisons étanches cloisonnent les pools de ressources afin qu’une défaillance dans un service ne puisse pas épuiser les threads ou les connexions de l’ensemble du système.
Les cloisons étanches sont conçues pour isoler les domaines de défaillance en créant des pools de ressources ou des quotas distincts pour différents services, empêchant qu’une défaillance localisée ne mette à bas l’ensemble de l’application.
Atténuation des défaillances
Les disjoncteurs surveillent les taux d’erreur et rejettent immédiatement les requêtes adressées à des dépendances défaillantes, ce qui empêche les pannes en cascade à travers votre réseau.
Le motif de cloisonnement dans une architecture microservices sert à empêcher que des défaillances survenant dans une partie d’un système ne fassent planter l’ensemble de la plateforme, en isolant efficacement les défaillances à leur origine.
Mise en cache & mise à l’échelle
Sélection du magasin de données
La mise en cache est un outil essentiel pour des microservices performants. Déchargez les lectures répétées de base de données et les calculs d’API coûteux vers des caches en mémoire rapides comme Redis ou Memcached.
| Avantage | Description |
|---|---|
| Contrôle fin | Mettez en cache des fragments de domaine selon leur volatilité et leur fréquence de mise à jour. |
| Invalidation de cache réduite | Limite la charge liée à la purge en n’actualisant que les segments de données concernés. |
| Taux de succès du cache améliorés | Permet des entrées de cache plus petites et hautement optimisées, pour des taux de succès en mémoire plus élevés. |
| Gestion hybride dynamique et statique | Permet de mettre en cache les enregistrements statiques tout en récupérant dynamiquement les statistiques en temps réel. |
Mise à l’échelle indépendante
La mise en cache et les magasins de données séparés vous permettent de faire évoluer chaque service indépendamment, en supprimant les goulots d’étranglement liés à la contention des ressources.
- Amélioration de l’évolutivité du système
- Agilité de développement accrue et mise sur le marché plus rapide
- Isolation robuste des défaillances et résilience du système
- Utilisation rentable des ressources cloud
- Meilleure intégration DevOps et pipelines de déploiement continu
Réduction des dépendances
Découplage
Les vrais microservices exigent un découplage radical. Lorsque les services fonctionnent indépendamment, sans appels synchrones bloquants, vous supprimez des goulots d’étranglement artificiels.
Le découplage signifie que chaque microservice gère sa charge de travail interne sans attendre de manière synchrone des processus externes. Cette indépendance évite les goulots d’étranglement et assure le bon fonctionnement de votre plateforme.
Les principaux avantages architecturaux de la réduction des dépendances sont les suivants :
- Mise à l’échelle indépendante des services selon les charges de travail en temps réel.
- Risque réduit de défaillances en cascade au-delà des frontières des équipes.
- Autonomie des équipes de développement pour livrer le code selon leurs propres calendriers.
- Identification plus rapide de la cause première lors de la réponse aux incidents.
Simplification
Simplifier votre graphe de dépendances réduit la charge cognitive et rend votre architecture nettement plus simple à tester, à superviser et à sécuriser.
| Approche | Ce que cela signifie | Pourquoi c’est important |
|---|---|---|
| SLO individuels | Suivre la fiabilité de chaque microservice séparément | Peut passer à côté d’une dégradation de l’expérience utilisateur à l’échelle du système |
| SLO composites | Combiner les objectifs de fiabilité de services interdépendants | Refléter la santé réelle de bout en bout du système |
Évaluation de l’adéquation d’une architecture microservices
Le choix du modèle d’architecture adapté détermine à la fois la vélocité de vos équipes d’ingénierie et vos coûts opérationnels. Le Microsoft Development Podcast revient régulièrement sur cette tension et met en lumière une tendance croissante : des organisations regroupent à nouveau des microservices trop fragmentés en monolithes modulaires, plus faciles à gérer.
Matrice de décision
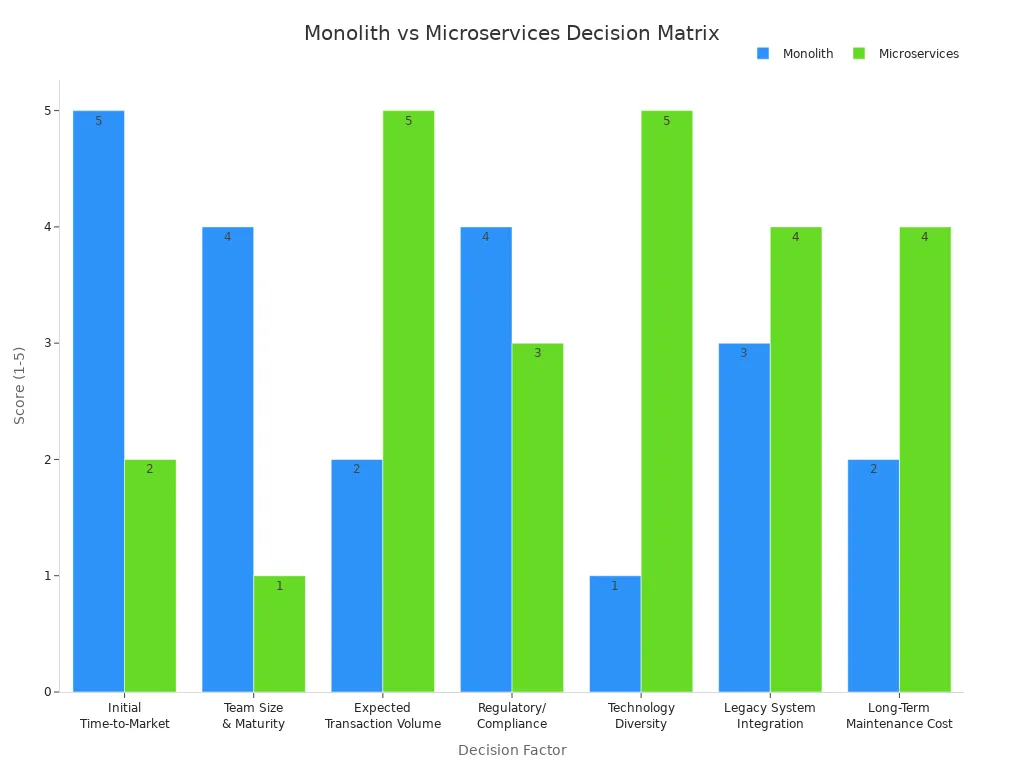
Utilisez une matrice de décision structurée pour évaluer si les microservices correspondent réellement à la maturité de votre organisation :
| Facteur de décision | Score monolithe (1-5) | Score microservices (1-5) | Justification stratégique |
|---|---|---|---|
| Délai de mise sur le marché initial (vitesse) | 5 | 2 | Un monolithe nécessite une configuration d’infrastructure initiale minimale. |
| Taille et maturité de l’équipe (DevOps) | 4 | 1 | Les microservices exigent des pipelines CI/CD avancés, de l’automatisation et une observabilité poussée. |
| Volume de transactions attendu (montée en charge) | 2 | 5 | Les microservices permettent de mettre à l’échelle, de manière précise et indépendante, les goulots d’étranglement gourmands en ressources. |
| Complexité réglementaire et de conformité | 4 | 3 | Un artefact unique simplifie l’audit de sécurité initial et les contrôles de conformité. |
| Diversité technologique et expérimentation | 1 | 5 | Les microservices permettent à chaque équipe d’adopter des piles technologiques spécialisées pour chaque domaine de service. |
| Intégration des systèmes existants | 3 | 4 | Les microservices sont particulièrement adaptés pour encapsuler et moderniser les composants hérités. |
| Coût total de possession à long terme (TCO) | 2 | 4 | Les microservices réduisent le coût des évolutions fonctionnelles dans le temps, au prix d’une charge opérationnelle plus élevée. |
Questions d’évaluation clés
- Votre équipe d’ingénierie maîtrise-t-elle solidement les compétences DevOps, l’ingénierie de plateforme et le SRE ?
- Êtes-vous confronté à des exigences de montée en charge extrêmes qui justifient la complexité des systèmes distribués ?
- Avez-vous besoin de persistance polyglotte et de diversité technologique ?
- Votre culture d’entreprise est-elle prête à absorber les lourds coûts de coordination entre équipes ?
Signes indiquant qu’il faut revoir votre approche
Surveillez ces signaux d’alerte qui indiquent que votre architecture microservices doit être restructurée :
- La vitesse de livraison s’effondre en raison de dépendances constantes entre équipes.
- Les dépenses d’exploitation cloud augmentent plus vite que la croissance du chiffre d’affaires.
- Les pannes se propagent facilement à plusieurs domaines.
Monolithe ou microservices
| Type d’architecture | Taille d’équipe recommandée | Caractéristiques principales |
|---|---|---|
| Monolithique | < 8-10 développeurs | Déploiements simples, faible charge opérationnelle |
| Microservices | > 10-15 développeurs | Grande autonomie des équipes, coordination distribuée complexe |
La mise en place d’une architecture microservices fait apparaître une complexité cachée et des risques de performance. Les goulots d’étranglement surgissent invariablement dans des couches réseau et données inattendues. Le Microsoft Development Podcast souligne qu’une livraison rapide exige une discipline architecturale rigoureuse. Pour maintenir vos systèmes .NET en bonne santé, pensez à :
- gérer avec soin les requêtes inter-services et les stratégies de délai d’expiration.
- Mettre en œuvre un équilibrage de charge élastique et une mise à l’échelle automatisée.
- Découpler les magasins de données afin que chaque service possède sa propre base de données.
- Mettre en cache de façon agressive les requêtes API et base de données répétitives.
Vous devez également appliquer une gouvernance architecturale, utiliser des passerelles API robustes et organiser des revues d’architecture régulières. Une évaluation continue garantit que votre pile technologique évolue efficacement avec votre activité.
Questions fréquentes
Qu’est-ce qu’un monolithe distribué ?
Un monolithe distribué est un anti-patron dans lequel une application est physiquement découpée en plusieurs microservices, mais reste logiquement couplée par des appels HTTP synchrones, des bases de données partagées et des dépendances de déploiement étroites, ce qui fait perdre les avantages fondamentaux des microservices.
Comment repérer les goulots d’étranglement de performance dans les microservices ?
Surveillez les temps de réponse p99, les taux d’erreur et le débit des requêtes. Exploitez des outils de traçage distribué pour suivre les requêtes à travers les frontières des services et identifier les sauts réseau lents ou les requêtes base de données coûteuses.
Pourquoi la latence réseau est-elle importante dans une architecture microservices ?
La latence réseau ajoute quelques millisecondes à chaque appel inter-services. Contrairement aux appels mémoire instantanés en processus dans un monolithe, les sauts réseau distribués s’accumulent rapidement et dégradent la réactivité globale de l’application.
Comment réduire les frais de coordination entre les équipes ?
Définissez des frontières claires de responsabilité pour chaque domaine, automatisez les contrôles de gouvernance des API, réduisez les réunions de suivi inutiles et adoptez des modes de communication asynchrones pour permettre aux équipes de travailler en autonomie.
Quels outils facilitent l’observabilité dans les microservices .NET ?
Parmi les outils d’observabilité les plus utilisés figurent Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin et les plateformes de journalisation centralisée comme la pile ELK, qui collectent ensemble les métriques, les journaux et les traces distribuées.
Quand faut-il envisager de regrouper des microservices ?
Envisagez un regroupement si la vitesse de livraison des fonctionnalités ralentit, si les coûts de l’infrastructure cloud deviennent incontrôlables ou si des pannes en cascade compromettent régulièrement votre capacité à garantir la disponibilité.
Quelle est la meilleure façon de gérer les données partagées dans les microservices ?
Donnez à chaque microservice sa propre base de données privée. Évitez de partager des bases de données entre services afin d’éliminer le couplage des schémas et de rétablir une mise à l’échelle indépendante des bases de données.
En quoi la communication asynchrone améliore-t-elle les performances des microservices ?
La communication asynchrone reposant sur des courtiers de messages permet aux services de traiter les événements à leur propre rythme, de mettre en mémoire tampon les pics de trafic et de supprimer les goulots d’étranglement liés aux appels synchrones bloquants.
🎧 Écoutez cet épisode
Vous souhaitez une explication pratique et approfondie de Why Microservice Architecture Slows Software Delivery ? Cet épisode détaille ces sujets d’architecture essentiels en termes clairs et montre pourquoi ils comptent pour Microsoft 365, Azure, Power Platform, la sécurité d’entreprise, l’IA et l’ingénierie logicielle moderne.
Écoutez cet épisode si vous souhaitez :
- Comprendre les concepts fondamentaux expliquant pourquoi les microservices peuvent ralentir la livraison logicielle
- Voir comment l’architecture s’inscrit dans l’écosystème technologique plus large de Microsoft
- Identifier où elle peut apporter une valeur concrète et mesurable à votre organisation
Vous pourriez aussi apprécier ces épisodes connexes de M365 FM :
- Le mythe du monorepo : pourquoi votre architecture est fragmentée
- Microsoft Graph Automation Architecture: Beyond Scripts
- Agents IA s’appuyant sur Graph : guide d’architecture d’entreprise
- Extensibilité .NET et Clean Architecture avec Miguel Castro [MVP]
- Enterprise AI Agent Fabric: Architecture Beyond Chatbots
Découvrez d’autres échanges pratiques sur l’ingénierie Microsoft sur M365 FM.