 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Unikanie pułapki rozproszonego monolitu w mikrousługach .NET
By Mirko Peters ·
Kiedy zespoły inżynierskie przechodzą z aplikacji monolitycznej na architekturę mikrousług, zwykle gonią za bardzo konkretnym zestawem obietnic: szybszym dostarczaniem funkcji, niezależnym skalowaniem, lokalizacją awarii i swobodą eksperymentowania z nowoczesnymi stosami technologicznymi. Wiele organizacji korzystających z .NET trafia jednak na ścianę, bo tempo rozwoju gwałtownie spada. Zamiast zw
Automatically translated with AI from the original post. Read the English original
Kiedy zespoły inżynierskie przechodzą z aplikacji monolitycznej na architekturę mikrousług, zwykle gonią za bardzo konkretnym zestawem obietnic: szybszym dostarczaniem funkcji, niezależnym skalowaniem, lokalizacją awarii i swobodą eksperymentowania z nowoczesnymi stosami technologicznymi. Wiele organizacji korzystających z .NET trafia jednak na ścianę, bo tempo rozwoju gwałtownie spada. Zamiast zwinnego, luźno powiązanego ekosystemu zarządzają rozproszonym monolitem — architekturą, która łączy złożoność operacyjną systemów rozproszonych ze ścisłym sprzężeniem typowym dla tradycyjnego monolitu.
Ten problem rzadko wynika ze złej woli czy świadomej decyzji. Zwykle wkrada się przez subtelne wybory architektoniczne, takie jak współdzielenie bazy danych przez wiele usług, silne uzależnienie od synchronicznych wywołań HTTP czy przekształcenie zarządzania API w administracyjne wąskie gardło. W tym wpisie przyjrzymy się objawom pułapki rozproszonego monolitu, odkryjemy ukryte problemy wydajnościowe czające się w warstwach sieciowych, wskażemy wąskie gardła architektoniczne za pomocą nowoczesnych narzędzi obserwowalności i omówimy praktyczne strategie odzyskania niezależnego skalowania w mikrousługach .NET. Jeśli twój zespół odczuł spowolnienie dostarczania, nie jesteś sam — a zrozumienie tych wzorców to pierwszy krok do odzyskania zwinności.
Architektura mikrousług: ukryta złożoność
Rozproszone monolity
Objawy
Możesz sądzić, że podział aplikacji na mikrousługi automatycznie rozwiąże problemy z wydajnością. Łatwo jednak dojść do rozproszonego monolitu. Dzieje się tak, gdy usługi zależą od siebie w takim stopniu, że tracisz prawdziwe korzyści z separacji. Mogą wystąpić następujące typowe objawy:
- Usługi polegają na wywołaniach synchronicznych przy każdej standardowej operacji biznesowej.
- Zespoły mają trudności z wdrażaniem pojedynczych zmian bez ryzyka przestojów lub uszkodzenia usług zależnych.
- Współdzielone bazy danych zmuszają do ścisłej koordynacji zmian schematu między wieloma odrębnymi zespołami deweloperskimi.
- Komponenty pozostają ściśle sprzężone, mimo że fizycznie działają w osobnych procesach lub kontenerach.
Wpływ na szybkość
Rozproszony monolit może spowalniać system w sposób, którego początkowo się nie spodziewasz. Zauważysz wzrost opóźnień sieciowych, ponieważ każde wywołanie między usługami dokłada czas oczekiwania. W odróżnieniu od aplikacji monolitycznej, gdzie wywołania odbywają się natychmiast w pamięci, architektura mikrousług przenosi wąskie gardła wydajności z bazy danych lub procesora do warstwy sieciowej. Synchroniczne wywołania między mikrousługami sumują opóźnienia, podczas gdy monolit obsługuje te wywołania wewnątrz procesu. W efekcie tracisz zdolność do niezależnego skalowania usług i skutecznej izolacji awarii, a problemy z wydajnością narastają wraz z rozrostem drzewa zależności.
Gdy próbujesz rozproszyć aplikację monolityczną bez odpowiedniego zaprojektowania granic, często napotykasz poważne problemy z wydajnością. Komponenty pozostają silnie zależne od siebie, a ty nie zyskujesz korzyści w postaci niezależnego skalowania ani izolacji awarii, które zapewniają dobrze zaprojektowane mikrousługi.
Narzut koordynacji
Zarządzanie API
Architektura mikrousług wymaga solidnego zarządzania API. Każdą zmianę trzeba przejrzeć i zatwierdzić, aby uniknąć narastania długu technicznego i powielania prac. Jeśli zarządzanie jest zbyt restrykcyjne, rozwój niemal staje w miejscu. Jeśli jest zbyt luźne, niemal z dnia na dzień zaczynasz budować dług techniczny w strukturze systemu.
Gdy zarządzanie jest zbyt luźne lub zbyt restrykcyjne, może prowadzić do długu technicznego, powielania prac i poważnego spowolnienia procesu wytwórczego.
W gruncie rzeczy bardzo szybko budujesz ogromny dług techniczny. A na koniec musisz wydać więcej pieniędzy i czasu, żeby to wszystko usunąć i zacząć od nowa.
Modele zarządzania trzeba projektować tak, aby aktywnie służyły deweloperom. Automatyzacja pomaga poprawiać jakość, bezpieczeństwo i spójność API bez dodawania obciążenia administracyjnego.
Gdy zarządzanie zasobami projektowane jest z myślą o programistach i wspierane automatyzacją, staje się katalizatorem poprawy jakości, bezpieczeństwa i spójności interfejsów API.
Interfejsy API odgrywają kluczową rolę w szerszej strategii biznesowej. Musisz traktować je jak obywateli pierwszej kategorii.
W najnowszym raporcie dotyczącym stanu integracji interfejsów API 84 procent firm stwierdziło, że interfejsy API mają kluczowe lub bardzo istotne znaczenie dla ich podstawowej strategii biznesowej.
Współpraca zespołów
Mikrousługi wymagają stałej koordynacji między zespołami. Spędzasz godziny na przygotowywaniu spotkań, przełączaniu kontekstu między domenami i wyjaśnianiu ról w ramach wielu zespołów. Te czynności mogą łatwo pochłonąć dużą część Twojego tygodnia pracy.
| Czynniki kosztów koordynacji | Opis |
|---|---|
| Opóźnienie decyzji | Opóźnienia wynikające z udziału wielu interesariuszy i uciążliwych łańcuchów zatwierdzeń |
| Przełączanie kontekstu | Rozproszona uwaga w wielu punktach koordynacji międzyfunkcyjnej |
| Utrata informacji | Utrata lub zniekształcenie kluczowej wiedzy na kolejnych szczeblach organizacji |
| Niejednoznaczne role | Niejasna odpowiedzialność prowadząca do luk i zdublowanych prac programistycznych |
| Działanie koordynacyjne | Czas poświęcony |
|---|---|
| Przygotowanie spotkań | Ponad 8 godzin tygodniowo |
| Działania koordynacyjne | 35–80% czasu pracowników wiedzy |
Musisz mieć świadomość, że narzut koordynacyjny może po cichu podkopać tempo dostarczania. Jasno określone granice odpowiedzialności i usprawnione kanały komunikacji są konieczne, aby uniknąć luk i zdublowanych prac.
Wyzwania ekosystemu .NET
Inżynieria platformy
Architektura mikrousług w ekosystemie .NET wiąże się z unikalnymi wyzwaniami inżynierskimi. Często mierzysz się z duplikacją kodu i redundancją, które zwiększają nakład pracy związany z utrzymaniem i ryzyko niespójności danych. Programiści często zmagają się z nadmierną ilością kodu szablonowego, który jest potrzebny jedynie do uruchomienia infrastruktury. Organizowanie kodu źródłowego staje się wyjątkowo trudne, gdy niewłaściwie współdzielisz modele domenowe między usługami. Antywzorce kopiuj-wklej opóźniają naprawy błędów i znacząco komplikują długoterminowe utrzymanie.
- Duplikacja kodu prowadzi do wyższych bieżących kosztów utrzymania.
- Współdzielone modele między usługami sprawiają, że aktualizacje schematów są ryzykowne.
- Programiści mogą kopiować i wklejać logikę usług, co spowalnia krytyczne naprawy błędów.
Granice domen
Musisz precyzyjnie zdefiniować granice domen podczas budowy mikrousług w .NET. Jeśli tego nie zrobisz, drastycznie zwiększysz obciążenie poznawcze programistów. Zbyt wiele równoczesnych wymagań architektonicznych przytłacza zespół. Utrzymanie standardów i zgodności staje się trudne, co może prowadzić do problemów z niezawodnością i osłabiać ogólną postawę bezpieczeństwa.
- Obciążenie poznawcze gwałtownie rośnie, gdy programiści jonglują wieloma powiązanymi usługami.
- Standardy i zgodność z wymogami przedsiębiorstwa stają się trudniejsze do konsekwentnego egzekwowania.
- Niezawodność i bezpieczeństwo cierpią, gdy granice domen są słabo zdefiniowane.
Choć architektura mikrousług oferuje przekonujące korzyści, musisz proaktywnie zmierzyć się z jej ukrytą złożonością. Uważaj na objawy rozproszonego monolitu, zarządzaj narzutem koordynacyjnym i zdecydowanie rozwiąż specyficzne dla .NET wyzwania platformy.
Bomba zegarowa: problemy z wydajnością
Możesz zakładać, że mikrousługi same z siebie przyspieszą system, ale bez rygorystycznego projektu mogą stać się bombą zegarową dla Twojej infrastruktury. Wiele zespołów inżynierskich odkrywa typowe problemy z wydajnością dopiero po wdrożeniu na środowisko produkcyjne. Te problemy kryją się pod powierzchnią, czekając, by pogrążyć aplikację pod szczytowym obciążeniem. Musisz zrozumieć, jak opóźnienia sieciowe, kaskadowe punkty awarii i rywalizacja o bazę danych zamieniają Twoją architekturę w źródło chronicznych frustracji produkcyjnych.
Opóźnienie sieciowe
Wywołania w procesie a wywołania sieciowe
Gdy rozbijasz monolit na mikrousługi, przechodzisz od wywołań funkcji w procesie do wywołań sieciowych. Ta zmiana architektoniczna wprowadza nieuniknione opóźnienie. W aplikacji monolitycznej wywołanie funkcji zostaje zrealizowane niemal natychmiast. W mikrousługach każde wywołanie między usługami musi przejść przez sieć, dodając opóźnienie liczone w milisekundach.
| Typ architektury | Średnie opóźnienie |
|---|---|
| Wywołanie funkcji w procesie (monolit) | 0,001 ms (1 mikrosekunda) |
| Wywołanie HTTP w tym samym centrum danych (mikroserwisy) | 1–5 ms (1000–5000 mikrosekund) |
Wywołania sieciowe są wolniejsze o rzędy wielkości niż wywołania funkcji w ramach tego samego procesu. Ta różnica narasta szybko wraz ze skalowaniem systemu. Każda nowa usługa dodana do łańcucha żądań zwiększa opóźnienie i zamienia proste operacje w powolne, frustrujące doświadczenia użytkowników końcowych.
Zużycie zasobów
Wywołania sieciowe nie tylko zwiększają opóźnienia – zużywają również cenne zasoby systemu. Każde wywołanie obciąża cykle procesora, bufory pamięci i przepustowość sieci. Wraz z dodawaniem kolejnych mikroserwisów ruch sieciowy rośnie wykładniczo. Dodatkowe obciążenie prowadzi do wyższych kosztów infrastruktury chmurowej i wolniejszych czasów odpowiedzi.
Wydajność można poprawić, agresywnie ograniczając niepotrzebne wywołania między usługami. Niektóre zaawansowane zespoły stosują inteligentne zarządzanie ruchem, aby obniżyć opóźnienia i zwiększyć odporność:
- Podejście MCG poprawiło czasy odpowiedzi o 15% przy wzroście opóźnień sieciowych dzięki skróceniu opóźnień w komunikacji między usługami.
- W warunkach szczytowego obciążenia konfiguracja z MCG wykazała lepszą odporność i mniejszą liczbę błędów niż standardowe konfiguracje service mesh.
- Oceny wydajności wykazały, że inteligentne strategie rozmieszczania ruchu ograniczały narzut proxy typu sidecar, skracając czasy odpowiedzi i stabilizując przepustowość.
Należy stale monitorować, jak ruch sieciowy wpływa na wydajność systemu. Niewielkie, kumulujące się opóźnienia łatwo przeradzają się w poważne wąskie gardła.
Punkty awarii
Ryzyko propagacji
Mikroserwisy zasadniczo zmieniają profil awaryjności systemu. Ponieważ każda usługa zależy od innych, pojedyncza awaria może rozprzestrzenić się na całą infrastrukturę.
| Typ architektury | Ryzyko propagacji awarii | Izolacja awarii | Odporność systemu |
|---|---|---|---|
| Monolit | Wysokie | Nie | Niska |
| Mikroserwisy | Niskie | Tak | Wysoka |
W systemie monolitycznym jeden krytyczny błąd może zatrzymać cały proces aplikacji. Mikroserwisy oferują znacznie lepszą izolację awarii – jeśli usługa niekrytyczna ulegnie awarii, pozostałe mogą nadal działać. Wzorce odporności, takie jak wyłączniki automatyczne (circuit breakers), pomagają zapobiegać globalnemu rozprzestrzenianiu się awarii.
- W monolicie pojedynczy błąd może spowodować całkowitą niedostępność, tworząc pojedynczy punkt awarii.
- Mikroserwisy umożliwiają prawdziwą tolerancję błędów, dzięki czemu awarie komponentów niekrytycznych nie pogrążają całej platformy.
- Wzorce takie jak wyłączniki automatyczne (circuit breakers) zwiększają odporność, izolując awarie zależnych komponentów znajdujących się niżej w łańcuchu.
Wyzwania związane z obserwowalnością
Potrzebna jest kompleksowa obserwowalność, aby wykrywać i usuwać problemy z wydajnością w rozległej siatce mikroserwisów. Odnalezienie przyczyny źródłowej opóźnień lub sporadycznych błędów staje się wykładniczo trudniejsze wraz z mnożeniem się usług. Trzeba agregować logi, metryki infrastruktury i rozproszone śledzenia (traces) ze wszystkich uruchomionych instancji. Bez solidnych narzędzi do obserwowalności niezliczone godziny zostaną zmarnowane na szukanie źródła spowolnień w środowisku produkcyjnym.
Typowe wąskie gardła wydajności często ukrywają się w złożonych, asynchronicznych łańcuchach wywołań. Warto wykorzystać rozproszone śledzenie, aby podążać za żądaniami przez granice usług i wykrywać wąskie gardła, zanim wpłyną na użytkowników.
Uważaj na te klasyczne antywzorce:
- God Service (zbyt duża odpowiedzialność): usługa obsługująca wiele różnych domen biznesowych, co narusza podstawowe zasady architektoniczne.
- Ścisłe powiązanie między usługami: bezpośrednie, zakodowane na sztywno zależności, które psują systemy zależne przy każdej zmianie schematu.
Rywalizacja o bazę danych
Wspólne magazyny danych
Wiele zespołów popełnia krytyczny błąd, współdzieląc jedną bazę danych między wieloma mikroserwisami. Takie podejście tworzy silne powiązanie na poziomie schematu. Zmiana struktury bazy danych staje się ryzykowna, ponieważ może zepsuć działanie usług zewnętrznych, niszcząc szybkość prac zespołu i niezależną skalowalność.
Główny problem współdzielonych baz danych polega na tym, że tworzą one powiązania na poziomie schematu. Koszt zmian gwałtownie rośnie, ponieważ trudno przewidzieć, kiedy można bezpiecznie wprowadzić zmianę, nie psując działania innej usługi. Ma to dalsze konsekwencje dla skalowalności systemu. Nie da się skalować usług indywidualnie, jeśli wszystkie opierają się na wspólnym magazynie danych. Skoro skalowalność usługi ogranicza jej najwolniejszy element, współdzielona baza danych szybko staje się poważnym wąskim gardłem.
Współdzielone magazyny danych należy całkowicie wyeliminować. Każda mikrousługa powinna mieć własną, dedykowaną bazę danych, dzięki czemu warstwy danych zostaną rozprzężone, a wydajność wróci do właściwego poziomu.
Problemy ze skalowalnością
Rywalizacja o bazę danych to prawdziwa bomba zegarowa w aplikacjach przedsiębiorstw. Gdy wiele mikrousług konkuruje o ten sam silnik bazy danych, powstaje poważne wąskie gardło wydajnościowe. Najwolniejsze zapytanie lub usługa ogranicza przepustowość całego systemu, prowadząc do wyczerpania puli połączeń, rosnących opóźnień i katastrofalnych awarii podczas skoków ruchu.
Wykrywanie wąskich gardeł w architekturze mikrousług
Narzędzia monitorujące
Metryki
Należy śledzić właściwe metryki operacyjne, aby wcześnie wychwycić spadek wydajności. Metryki dają natychmiastowy obraz kondycji systemu i pomagają wychwycić trendy, zanim wpłyną na środowisko produkcyjne. Duży nacisk należy położyć na wskaźniki istotne dla biznesu obok metryk technicznych: śledź czasy odpowiedzi p99, wskaźniki błędów i przepustowość żądań.
Widoczność
Widoczność jest w systemach rozproszonych warunkiem koniecznym. Nie da się naprawić tego, czego nie widać. Wdróż narzędzia monitorujące, które zbierają telemetrię z każdej instancji usługi:
- Prometheus, Datadog i Grafana do monitorowania infrastruktury i aplikacji w czasie rzeczywistym.
- Elasticsearch, Logstash, Kibana (ELK) lub Graylog do scentralizowanego agregowania logów.
- Narzędzia APM (Application Performance Monitoring), takie jak New Relic lub Dynatrace, do profilowania wywołań na poziomie kodu.
- Kubernetes lub inne orkiestratory kontenerów do obserwowalności klastra na poziomie infrastruktury.
- Bramy API, takie jak Kong lub Zuul, do analityki ruchu na brzegu systemu.
Śledzenie rozproszone
Przepływy żądań
Śledzenie rozproszone pozwala podążać za żądaniem HTTP przez całą architekturę mikrousług. Narzędzia do śledzenia, takie jak OpenTelemetry, Jaeger i Zipkin, łączą te wywołania w całość, pokazując pełną ścieżkę wykonania od początku do końca i wskazując dokładne punkty największych opóźnień.
- Śledzenie rozproszone zapewnia szczegółową widoczność na granicach usług.
- Ujawnia ukryte wąskie gardła i znacznie przyspiesza procesy debugowania.
- Zespoły inżynierskie wykorzystują ślady (traces) do wykrywania źródeł opóźnień i poprawy niezawodności.
Źródła opóźnień
Opóźnienia kumulują się, gdy żądania przechodzą między usługami. Standardowe logi i metryki infrastruktury same w sobie nie pokażą tego poziomu szczegółowości transakcji. Śledzenie zachowuje kontekst żądania przy każdym przeskoku sieciowym, dzięki czemu można precyzyjnie wskazać metodę lub zapytanie do bazy danych, które spowalnia działanie.
Rozpoznawanie ukrytych spowolnień
Objawy
Ukryte spowolnienia mogą pogarszać doświadczenia użytkowników, nawet gdy nie ma całkowitych awarii. Zwracaj uwagę na rosnące czasy odpowiedzi, podwyższone wskaźniki błędów i większe zużycie pamięci. Używaj identyfikatorów korelacji, aby śledzić żądania w systemach, i skonfiguruj proaktywne alerty oparte na rygorystycznych celach poziomu usług (SLO).
Przypadki z praktyki
Rzeczywiste studia przypadków z obszaru inżynierii pokazują, jak ważne jest proaktywne wykrywanie wąskich gardeł. Na przykład wysoko obciążona mikrousługa oparta na Spring Boot doświadczyła poważnego spadku wydajności. Dzięki zaawansowanym narzędziom APM i profilowania zespół wykrył nieoptymalną pętlę zapytań. Po dodaniu odpowiedniej klauzuli grupującej operacje na bazie danych zmniejszono liczbę zapytań na sekundę z 300 do 30, co natychmiast ustabilizowało wykorzystanie procesora i wyeliminowało narzut związany z garbage collection.
Wskazówka: Zawsze łącz metryki, logi i ślady w jednolity potok obserwowalności. Takie połączenie daje natychmiastowy, całościowy obraz kondycji systemu.
Rozwiązania problemów z wydajnością mikrousług
Komunikacja asynchroniczna
Korzyści z kolejkowania wiadomości
Wiele problemów ze skalowaniem w architekturze mikrousług można rozwiązać, stosując komunikację asynchroniczną. Dzięki rozprzęgnięciu żądań za pomocą kolejek komunikatów usługi przetwarzają pracę we własnym tempie, bezpiecznie absorbując skoki ruchu bez odrzucania żądań.
| Poprawa wydajności | Opis |
|---|---|
| Skalowalność | Asynchroniczne przesyłanie komunikatów umożliwia masowe skalowanie dzięki wykorzystaniu kolejek do buforowania skoków ruchu. |
| Niezawodność | Brokery asynchroniczne obsługują ponawianie wiadomości oraz kolejki martwych liter, co zapewnia brak utraty wiadomości podczas przestojów. |
| Testowalność | Testowanie staje się prostsze, ponieważ usługi odbiorcze potrzebują jedynie kolejki próbnej (mock) do weryfikacji ładunku. |
Wdrożenie
Wdróż komunikację asynchroniczną, korzystając z niezawodnych brokerów komunikatów, takich jak RabbitMQ, Azure Service Bus lub Apache Kafka. Stosuj wzorce publikuj-subskrybuj, aby czysto rozgłaszać zdarzenia domenowe między niezależnymi usługami.
Grodzie i wyłączniki automatyczne
Strategie izolacji
Chroń mikrousługi przed kaskadowymi awariami, stosując grodzie (bulkheads) i wyłączniki automatyczne (circuit breakers). Grodzie dzielą pule zasobów tak, aby awaria jednej usługi nie mogła wyczerpać wątków ani połączeń w całym systemie.
Grodzie są zaprojektowane do izolowania domen awarii poprzez tworzenie oddzielnych pul zasobów lub limitów dla różnych usług, co zapobiega temu, że lokalne awarie położą całą aplikację.
Ograniczanie skutków awarii
Wyłączniki automatyczne monitorują wskaźniki błędów i natychmiast odrzucają żądania kierowane do niesprawnych zależności, zapobiegając kaskadowym przestojom w całej sieci.
Wzorzec grodzi w architekturze mikrousług służy do zapobiegania przenoszeniu się błędów z jednej części systemu na całą platformę, skutecznie izolując awarie w miejscu ich powstania.
Buforowanie i skalowanie
Wybór magazynu danych
Buforowanie jest kluczowym narzędziem dla wysokowydajnych mikrousług. Odciążaj powtarzane odczyty z bazy danych oraz kosztowne obliczenia API, przenosząc je do szybkich pamięci podręcznych w pamięci operacyjnej, takich jak Redis lub Memcached.
| Korzyść | Opis |
|---|---|
| Precyzyjna kontrola | Buforuj fragmenty domeny w zależności od zmienności i częstotliwości aktualizacji. |
| Ograniczenie unieważniania pamięci podręcznej | Minimalizuje narzut czyszczenia, odświeżając wyłącznie dotknięte segmenty danych. |
| Lepszy współczynnik trafień w pamięci podręcznej | Umożliwia tworzenie mniejszych, silnie zoptymalizowanych wpisów w pamięci podręcznej, co zapewnia wyższy odsetek trafień w pamięci operacyjnej. |
| Obsługa hybrydowa danych dynamicznych i statycznych | Umożliwia buforowanie rekordów statycznych przy jednoczesnym dynamicznym pobieraniu statystyk w czasie rzeczywistym. |
Niezależne skalowanie
Buforowanie i wydzielone magazyny danych pozwalają skalować poszczególne usługi niezależnie, eliminując wąskie gardła wynikające z rywalizacji o zasoby.
- Zwiększona skalowalność systemu
- Większa zwinność w rozwoju i szybsze wprowadzanie produktów na rynek
- Solidna izolacja awarii i odporność systemu
- Opłacalne wykorzystanie zasobów chmurowych
- Lepsza integracja z DevOps i ciągłe wdrażanie w potokach
Ograniczanie zależności
Rozprzęganie
Prawdziwe mikrousługi wymagają radykalnego rozprzęgnięcia. Gdy usługi działają niezależnie, bez blokujących wywołań synchronicznych, eliminujesz sztuczne wąskie gardła.
Rozprzęgnięcie oznacza, że każda mikrousługa obsługuje swoje wewnętrzne obciążenie bez synchronicznego czekania na zewnętrzne procesy. Ta niezależność eliminuje wąskie gardła i pozwala platformie działać płynnie.
Kluczowe korzyści architektoniczne wynikające z ograniczania zależności obejmują:
- Niezależne skalowanie usług w zależności od obciążenia w czasie rzeczywistym.
- Zminimalizowane ryzyko kaskadowych awarii na granicach zespołów.
- Autonomia zespołów programistycznych w wydawaniu kodu według własnego harmonogramu.
- Szybsza identyfikacja przyczyny źródłowej podczas reagowania na incydenty.
Uproszczenie
Uproszczenie grafu zależności zmniejsza obciążenie poznawcze i znacznie ułatwia testowanie, monitorowanie i zabezpieczanie architektury.
| Podejście | Co to oznacza | Dlaczego to ważne |
|---|---|---|
| Indywidualne SLO | Śledzenie niezawodności każdej mikrousługi osobno | Może pomijać pogorszenie ogólnosystemowego doświadczenia użytkownika |
| Złożone SLO | Łączenie celów niezawodności w ramach współzależnych usług | Odzwierciedla rzeczywistą kondycję systemu od końca do końca |
Ocena przydatności architektury mikrousług
Wybór właściwego modelu architektonicznego determinuje tempo prac inżynierskich i koszty operacyjne. Podcast Microsoft Development często analizuje to napięcie, podkreślając rosnący trend, w którym organizacje konsolidują nadmiernie rozdrobnione mikrousługi z powrotem w łatwe w zarządzaniu modularne monolity.
Macierz decyzyjna
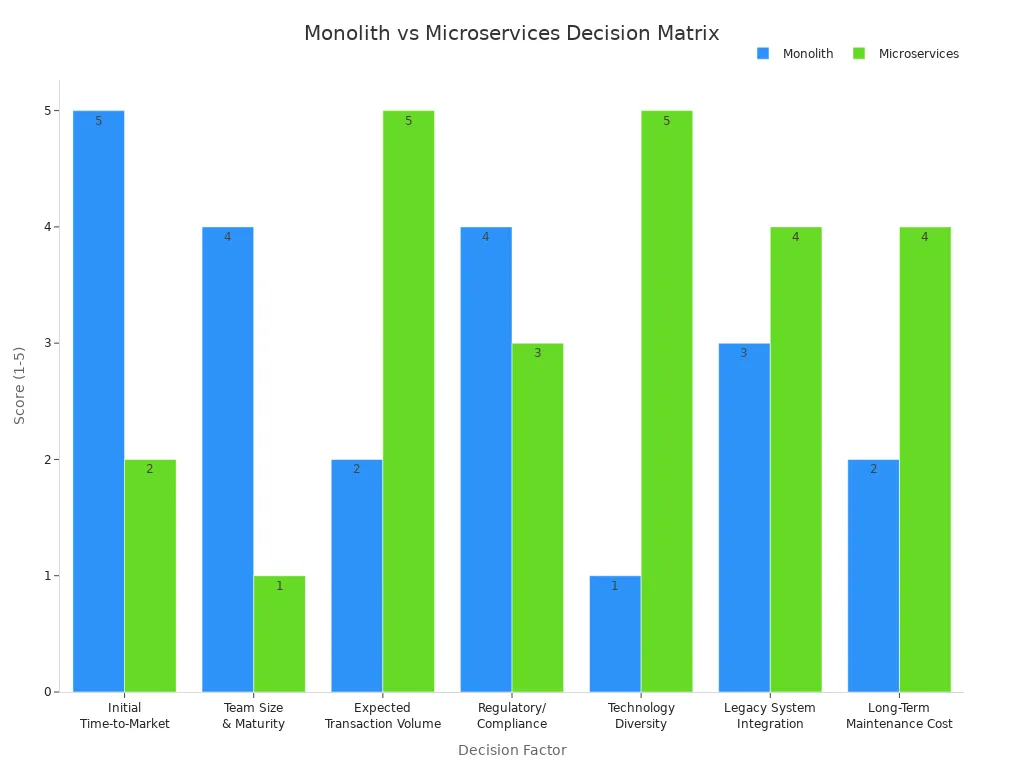
Skorzystaj z ustrukturyzowanej macierzy decyzyjnej, aby ocenić, czy mikrousługi naprawdę pasują do dojrzałości Twojej organizacji:
| Czynnik decyzyjny | Wynik monolitu (1–5) | Wynik mikrousług (1–5) | Uzasadnienie strategiczne |
|---|---|---|---|
| Początkowy czas wprowadzenia na rynek (szybkość) | 5 | 2 | Monolity wymagają minimalnej początkowej konfiguracji infrastruktury. |
| Wielkość zespołu i dojrzałość (DevOps) | 4 | 1 | Mikrousługi wymagają zaawansowanych procesów CI/CD, automatyzacji i obserwowalności. |
| Oczekiwana liczba transakcji (skala) | 2 | 5 | Mikrousługi umożliwiają precyzyjne, niezależne skalowanie zasobochłonnych wąskich gardeł. |
| Złożoność regulacyjna i zgodności | 4 | 3 | Pojedyncze artefakty upraszczają wstępny audyt bezpieczeństwa i kontrole zgodności. |
| Różnorodność technologii i eksperymentowanie | 1 | 5 | Mikrousługi pozwalają zespołom stosować wyspecjalizowane stosy technologiczne dla poszczególnych domen usług. |
| Integracja z systemami legacy | 3 | 4 | Mikrousługi doskonale nadają się do opakowywania i modernizacji komponentów legacy. |
| Długoterminowy koszt utrzymania (TCO) | 2 | 4 | Mikrousługi obniżają koszt funkcjonalności w czasie, kosztem wyższego narzutu operacyjnego. |
Kluczowe pytania oceny
- Czy Twój zespół inżynierski posiada solidne umiejętności DevOps, platform engineering i SRE?
- Czy masz wymagania dotyczące skrajnej skali, które uzasadniają narzut rozproszenia?
- Czy potrzebujesz poliglotycznej trwałości danych i różnorodności technologii?
- Czy kultura Twojej organizacji jest gotowa na intensywne koszty koordynacji między zespołami?
Sygnały ostrzegawcze
Zwróć uwagę na poniższe czerwone flagi wskazujące, że architektura mikrousług wymaga restrukturyzacji:
- Tempo dostarczania zwalnia do zera z powodu ciągłych zależności między zespołami.
- Koszty operacyjne chmury rosną szybciej niż przychody firmy.
- Awarie łatwo kaskadowo przenoszą się na wiele domen.
Monolit kontra mikrousługi
| Typ architektury | Rekomendowana wielkość zespołu | Kluczowe cechy |
|---|---|---|
| Monolityczna | < 8–10 programistów | Proste wdrożenia, niski narzut operacyjny |
| Mikrousługi | > 10–15 programistów | Pełna autonomia zespołów, złożona koordynacja rozproszona |
Przy wdrażaniu architektury mikrousług napotykasz ukrytą złożoność i zagrożenia wydajnościowe. Wąskie gardła nieuchronnie pojawiają się w nieoczekiwanych warstwach sieci i danych. Podcast Microsoft Development podkreśla, że szybkie dostarczanie wymaga rygorystycznej dyscypliny architektonicznej. Aby utrzymać systemy .NET w dobrej kondycji, pamiętaj, aby:
- Starannie zarządzać żądaniami między usługami oraz zasadami limitów czasu.
- Wdrożyć elastyczne równoważenie obciążenia i automatyczne skalowanie.
- Rozdzielić magazyny danych tak, aby każda usługa posiadała własną bazę danych.
- Agresywnie buforować powtarzalne zapytania do API i baz danych.
Powinieneś także egzekwować zarządzanie architekturą, korzystać z solidnych bram API i regularnie przeprowadzać przeglądy architektury. Ciągła ocena zapewnia, że stos technologiczny skaluje się skutecznie wraz z Twoim biznesem.
Często zadawane pytania
Czym jest rozproszony monolit?
Rozproszony monolit to antywzorzec, w którym aplikacja jest fizycznie podzielona na wiele mikrousług, ale pozostaje logicznie sprzężona poprzez synchroniczne wywołania HTTP, wspólne bazy danych i ścisłe zależności wdrożeniowe, tracąc kluczowe korzyści mikrousług.
Jak wykryć wąskie gardła wydajności w mikrousługach?
Monitoruj czasy odpowiedzi p99, wskaźniki błędów i przepustowość żądań. Wykorzystaj narzędzia śledzenia rozproszonego, aby śledzić żądania na granicach usług i identyfikować wolne przeskoki sieciowe lub zapytania do bazy danych.
Dlaczego opóźnienia sieciowe mają znaczenie w architekturze mikrousług?
Opóźnienie sieciowe dodaje milisekundy opóźnienia do każdego wywołania między usługami. W przeciwieństwie do natychmiastowych wywołań w pamięci procesu w monolicie rozproszone przeskoki sieciowe szybko się sumują, pogarszając ogólną responsywność aplikacji.
Jak zmniejszyć narzut koordynacji między zespołami?
Wyznacz jasne granice odpowiedzialności za domeny, automatyzuj kontrole zarządzania interfejsami API, ogranicz zbędne spotkania statusowe i stosuj komunikację asynchroniczną, aby zespoły mogły pracować samodzielnie.
Jakie narzędzia pomagają w obserwowalności mikrousług w .NET?
Popularne narzędzia do obserwowalności to Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin oraz scentralizowane platformy logowania, takie jak stos ELK, które łącznie zbierają metryki, logi i rozproszone ślady.
Kiedy warto rozważyć konsolidację mikrousług?
Rozważ konsolidację, jeśli tempo dostarczania funkcji spada, koszty infrastruktury chmurowej wymykają się spod kontroli albo kaskadowe awarie regularnie utrudniają utrzymanie dostępności.
Jaki jest najlepszy sposób obsługi współdzielonych danych w mikrousługach?
Każda mikrousługa powinna mieć własną, prywatną bazę danych. Unikaj współdzielenia baz danych między usługami, aby wyeliminować sprzężenie na poziomie schematu i przywrócić niezależną skalowalność baz danych.
W jaki sposób komunikacja asynchroniczna poprawia wydajność mikrousług?
Komunikacja asynchroniczna z użyciem brokerów komunikatów pozwala usługom przetwarzać zdarzenia we własnym tempie, buforować nagłe skoki ruchu i usuwać blokujące wąskie gardła synchronicznych wywołań.
🎧 Posłuchaj tego odcinka
Szukasz praktycznego, szczegółowego wyjaśnienia tematu Dlaczego architektura mikrousług spowalnia dostarczanie oprogramowania? Ten odcinek omawia kluczowe zagadnienia architektoniczne prostym językiem i pokazuje, dlaczego mają znaczenie dla usług Microsoft 365, Azure, Power Platform, bezpieczeństwa w przedsiębiorstwie, AI i nowoczesnej inżynierii oprogramowania.
Posłuchaj tego odcinka, jeśli chcesz:
- Zrozumieć podstawowe koncepcje wyjaśniające, dlaczego mikrousługi mogą spowalniać dostarczanie oprogramowania
- Zobaczyć, jak architektura wpisuje się w szerszy ekosystem technologii Microsoft
- Dowiedzieć się, gdzie może przynieść praktyczną, mierzalną wartość dla Twojej organizacji enterprise
Może Cię również zainteresować, odcinki M365 FM:
- Mit monorepo: dlaczego Twoja architektura jest rozdrobniona
- Microsoft Graph Automation Architecture: Beyond Scripts
- Agenci AI oparci na Graph: przewodnik architekta po rozwiązaniach dla przedsiębiorstw
- Rozszerzalność .NET i czysta architektura z Miguelem Castro [MVP]
- Enterprise AI Agent Fabric: Architecture Beyond Chatbots
Odkrywaj więcej praktycznych rozmów inżynierskich o Microsoft na M365 FM.