 RU
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Українська
 العربية
 עברית
 日本語
 한국어
Избегаем ловушки распределённого монолита в микросервисах .NET
By Mirko Peters ·
Когда инженерные команды переходят от монолитного приложения к архитектуре микросервисов, их обычно привлекают вполне конкретные обещания: быстрее выпускать функции…
Automatically translated with AI from the original post. Read the English original
Когда инженерные команды переходят от монолитного приложения к архитектуре микросервисов, их обычно привлекают вполне конкретные обещания: более быстрая поставка функций, независимое масштабирование, локализация сбоев и свобода экспериментировать с современными технологическими стеками. Однако многие организации, работающие на .NET, упираются в стену: скорость разработки резко падает. Вместо гибкой, слабо связанной экосистемы они получают распределённый монолит — архитектуру, которая сочетает операционную сложность распределённых систем с жёсткой связностью традиционного монолита.
Обычно это происходит не по злому умыслу. Проблема незаметно возникает из-за тонких архитектурных решений: например, когда несколько сервисов используют одну базу данных, сильно полагаются на синхронные HTTP-вызовы или когда управление API превращается в административное узкое место. В этом посте мы разберём симптомы ловушки распределённого монолита, выявим скрытые проблемы производительности в сетевом уровне, найдём архитектурные узкие места с помощью современных инструментов наблюдаемости и рассмотрим практические стратегии, которые помогут вернуть независимое масштабирование в ваших микросервисах .NET. Если ваша команда ощущает, как замедляются поставки, вы не одиноки, а понимание этих паттернов — первый шаг к возвращению гибкости.
Архитектура микросервисов: скрытая сложность
Распределённые монолиты
Симптомы
Вы можете думать, что разбиение приложения на микросервисы автоматически решит проблемы с производительностью. Однако легко получить распределённый монолит. Это происходит, когда сервисы зависят друг от друга настолько сильно, что вы теряете реальные преимущества разделения. Вы можете заметить следующие типичные симптомы:
- Сервисы полагаются на синхронные вызовы для каждой стандартной бизнес-операции.
- Команды с трудом развёртывают отдельные изменения, не рискуя простоем или поломкой зависимых сервисов.
- Общие базы данных вынуждают жёстко согласовывать изменения схемы между несколькими командами разработки.
- Компоненты остаются тесно связанными, даже если физически работают в отдельных процессах или контейнерах.
Влияние на скорость
Распределённый монолит может замедлять систему так, как вы поначалу не ожидаете. Задержки в сети будут расти, потому что каждый вызов между сервисами добавляет задержку. В отличие от монолитного приложения, где вызовы происходят мгновенно в памяти, архитектура микросервисов переносит узкие места производительности из базы данных или процессора в сетевой уровень. Синхронные вызовы между микросервисами накапливают задержку, тогда как монолит обрабатывает такие вызовы внутри процесса. В результате вы теряете возможность независимо масштабировать сервисы и эффективно изолировать сбои, а проблемы с производительностью усугубляются по мере роста дерева зависимостей.
Когда вы пытаетесь распределить монолитное приложение без продуманного проектирования границ, вы почти неизбежно сталкиваетесь с серьёзными проблемами производительности. Компоненты остаются сильно зависимыми друг от друга, и вы не получаете тех преимуществ независимого масштабирования и изоляции сбоев, которые дают хорошо структурированные микросервисы.
Накладные расходы на координацию
Управление API
Архитектура микросервисов требует сильного управления API. Вы должны проверять и согласовывать каждое изменение, чтобы не накапливать технический долг и не дублировать работу. Если управление слишком строгое, разработка замедляется почти до нуля. Если же оно слишком мягкое, структурный технический долг может появиться почти за одну ночь.
Когда управление слишком мягкое или слишком строгое, это может привести к техническому долгу, дублированию усилий и серьёзному замедлению процесса разработки.
По сути, вы очень быстро наращиваете технический долг. А в итоге приходится тратить больше денег и времени на то, чтобы всё это выпилить и начать заново.
Модели управления нужно проектировать так, чтобы они активно помогали разработчикам. Автоматизация повышает качество, безопасность и согласованность API без лишней административной нагрузки.
Когда управление построено так, чтобы приносить пользу разработчикам, и подкреплено автоматизацией, оно становится катализатором повышения качества, безопасности и согласованности API.
API играют ключевую роль в общей бизнес-стратегии. Относиться к ним нужно как к объектам первого класса.
В последнем отчёте о состоянии интеграции API 84 процента компаний заявили, что API имеют критическое или очень важное значение для их основной бизнес-стратегии.
Командное взаимодействие
Микросервисы требуют постоянной координации между командами. Вы тратите часы на подготовку к собраниям, переключаетесь между контекстами доменов и уточняете роли на стыке команд. Всё это легко может занимать значительную часть вашей рабочей недели.
| Факторы стоимости координации | Описание |
|---|---|
| Задержка решений | Задержки из-за большого числа заинтересованных сторон и громоздких цепочек согласования |
| Переключение контекста | Распыление внимания между множеством межфункциональных точек координации |
| Устаревание информации | Потеря или искажение критически важных знаний при прохождении через организационные уровни |
| Неопределённость ролей | Неясная ответственность, приводящая к пробелам и дублированию разработки |
| Активность координации | Затрачиваемое время |
|---|---|
| Подготовка к собраниям | Более 8 часов в неделю |
| Действия по координации | 35–80 % рабочего времени специалистов по знаниям |
Важно понимать, что издержки на координацию могут незаметно подрывать скорость поставки. Чёткие границы ответственности и налаженные каналы коммуникации обязательны, чтобы избежать пробелов и дублирования усилий.
Проблемы экосистемы .NET
Platform Engineering
Архитектура микросервисов в экосистеме .NET создаёт специфические инженерные задачи. Вам часто приходится сталкиваться с дублированием кода и избыточностью, что увеличивает затраты на поддержку и повышает риск несогласованности данных. Разработчикам часто приходится писать избыточный шаблонный код только для того, чтобы поднять инфраструктуру. Организация исходного кода становится крайне сложной, если доменные модели неправильно разделяются между сервисами. Антипаттерн «копировать и вставить» задерживает исправление ошибок и существенно усложняет долгосрочную поддержку.
- Дублирование кода приводит к росту постоянных затрат на поддержку.
- Общие модели между сервисами делают изменения схемы рискованными.
- Разработчики могут копировать и вставлять логику сервисов, что замедляет исправление критических ошибок.
Границы доменов
При построении микросервисов на .NET необходимо задавать максимально чёткие границы доменов. Если этого не сделать, вы значительно увеличите когнитивную нагрузку на разработчиков. Слишком много одновременных архитектурных требований перегружают команду. Соблюдение стандартов и требований соответствия становится сложнее, что может привести к проблемам с надёжностью и ослабить общую защищённость.
- Когнитивная нагрузка резко растёт, когда разработчики одновременно работают с множеством взаимосвязанных сервисов.
- Стандарты и корпоративные требования соответствия становится труднее последовательно соблюдать.
- Надёжность и безопасность страдают, когда границы доменов определены плохо.
Несмотря на весомые преимущества микросервисной архитектуры, её скрытую сложность нужно решать заранее. Следите за признаками распределённого монолита, управляйте издержками на координацию и прямо решайте специфические для .NET платформенные задачи.
Бомба замедленного действия: проблемы производительности
Можно предполагать, что микросервисы сами по себе ускорят систему, но без тщательного проектирования они могут стать бомбой замедленного действия для вашей инфраструктуры. Многие инженерные команды обнаруживают типовые проблемы производительности только после развёртывания в продуктиве. Эти проблемы скрыты до поры и могут затормозить приложение под пиковой нагрузкой. Важно понимать, как сетевая задержка, каскадные точки отказа и конкуренция за базу данных превращают архитектуру в источник хронических проблем в продуктиве.
Сетевая задержка
Вызовы в процессе и сетевые вызовы
Когда вы разбиваете монолит на микросервисы, вы переходите от вызовов функций в рамках процесса к сетевым вызовам. Этот архитектурный сдвиг неизбежно вносит задержку. В монолитном приложении вызов функции выполняется почти мгновенно. В микросервисах каждый вызов между сервисами проходит через сеть, добавляя миллисекунды задержки.
| Тип архитектуры | Средняя задержка |
|---|---|
| Вызов функции в процессе (монолит) | 0,001 мс (1 микросекунда) |
| HTTP-вызов в пределах одного дата-центра (микросервисы) | 1–5 мс (1 000–5 000 микросекунд) |
Сетевые вызовы медленнее обращений к функциям внутри процесса на порядки. Эта разница быстро растёт по мере масштабирования системы. Каждый новый сервис в цепочке запроса добавляет задержку и превращает простые операции в медленный и раздражающий опыт для конечных пользователей.
Использование ресурсов
Сетевые вызовы делают больше, чем просто добавляют задержку: они потребляют ценные системные ресурсы. Каждый вызов расходует такты процессора, буферы памяти и пропускную способность сети. По мере добавления микросервисов сетевой трафик растёт по экспоненте. Эта дополнительная нагрузка приводит к росту затрат на облачную инфраструктуру и замедлению отклика.
Производительность можно улучшить, существенно сократив ненужные межсервисные вызовы. Некоторые продвинутые команды используют интеллектуальное управление трафиком, чтобы снизить задержки и повысить отказоустойчивость:
- Подход MCG сократил время отклика на 15% при повышенной сетевой задержке благодаря уменьшению задержек межсервисного взаимодействия.
- При пиковой нагрузке конфигурация с MCG показала более высокую устойчивость и меньше ошибок по сравнению со стандартными конфигурациями service mesh.
- Оценки производительности показали, что стратегии интеллектуального размещения трафика смягчали накладные расходы sidecar-прокси, снижая время отклика и стабилизируя пропускную способность.
Необходимо постоянно отслеживать, как сетевой трафик влияет на производительность системы. Небольшие накапливающиеся задержки быстро превращаются в серьёзные узкие места.
Точки отказа
Риски распространения сбоев
Микросервисы принципиально меняют профиль отказов системы. Поскольку каждый сервис зависит от других, один сбой может распространиться по всей инфраструктуре.
| Тип архитектуры | Риск распространения сбоя | Изоляция сбоев | Устойчивость системы |
|---|---|---|---|
| Монолитная | Высокий | Нет | Низкая |
| Микросервисная | Низкий | Да | Высокая |
В монолитной системе одна критическая ошибка может обрушить весь процесс приложения. Микросервисы обеспечивают гораздо лучшую изоляцию сбоев: если некритичный сервис выходит из строя, остальные могут продолжать работу. Паттерны устойчивости, например «автоматические выключатели» (circuit breakers), помогают не допустить глобального распространения сбоев.
- В монолите одна ошибка может привести к полной остановке работы и стать единой точкой отказа.
- Микросервисы позволяют добиться настоящей отказоустойчивости: сбои некритичных компонентов не топят всю платформу.
- Паттерны вроде circuit breaker повышают устойчивость, изолируя неисправные зависимости «нижестоящих» сервисов.
Проблемы наблюдаемости
Для выявления и устранения проблем производительности в разросшейся сетке микросервисов необходима комплексная наблюдаемость. Поиск первопричины задержек или периодических ошибок становится экспоненциально сложнее по мере роста числа сервисов. Нужно агрегировать логи, метрики инфраструктуры и распределённые трассировки от каждого работающего экземпляра. Без надёжных инструментов наблюдаемости вы потратите бесчисленные часы на поиск источника замедлений в продуктивной среде.
Типичные узкие места производительности часто скрыты в сложных асинхронных цепочках вызовов. Используйте распределённую трассировку, чтобы отслеживать запросы через границы сервисов и выявлять узкие места до того, как они повлияют на пользователей.
Остерегайтесь этих классических антипаттернов:
- God Service (слишком много ответственности): сервис, который обрабатывает несколько разных бизнес-доменов, нарушая базовые архитектурные принципы.
- Жёсткая связанность сервисов: прямые захардкоженные зависимости, которые ломают смежные системы при каждом изменении схемы данных.
Конкуренция за базу данных
Общие хранилища данных
Многие команды совершают критическую ошибку, используя одну базу данных сразу в нескольких микросервисах. Такая практика создаёт серьёзную связанность на уровне схемы. Изменение структуры базы становится опасным, поскольку может сломать внешние сервисы, что подрывает скорость разработки и независимое масштабирование.
Главная проблема общих баз данных в том, что они создают связанность через схему. Стоимость изменений резко растёт, потому что становится трудно понять, когда можно безопасно что-то менять, не сломав другой сервис. Это влияет и на масштабируемость системы: нельзя масштабировать сервисы по отдельности, если все они зависят от общего хранилища данных. Поскольку масштабируемость сервиса ограничена его самым медленным компонентом, общая база быстро превращается в серьёзное узкое место.
От общих хранилищ данных стоит отказаться полностью. Выделите каждому микросервису собственную базу данных, чтобы развязать уровни данных и вернуть производительность.
Проблемы масштабируемости
Конкуренция за базу данных — это бомба замедленного действия для корпоративных приложений. Когда несколько микросервисов борются за один и тот же движок базы данных, возникает серьёзное узкое место в производительности. Самый медленный запрос или сервис ограничивает пропускную способность всей системы, что приводит к исчерпанию пула соединений, росту задержек и катастрофическим сбоям во время пиков нагрузки.
Выявление узких мест в архитектуре микросервисов
Инструменты мониторинга
Метрики
Чтобы заметить деградацию производительности на ранней стадии, нужно отслеживать правильные эксплуатационные метрики. Метрики дают моментальный срез состояния системы и помогают заметить тренды до того, как они повлияют на продуктив. Делайте упор на бизнес-показатели наряду с техническими: отслеживайте время отклика p99, частоту ошибок и пропускную способность запросов.
Наблюдаемость
Наблюдаемость обязательна для распределённых систем. Нельзя исправить то, что не видно. Внедрите инструменты мониторинга, которые собирают телеметрию с каждого экземпляра сервиса:
- Prometheus, Datadog и Grafana для мониторинга инфраструктуры и приложений в реальном времени.
- Elasticsearch, Logstash, Kibana (ELK) или Graylog для централизованного агрегирования логов.
- Инструменты APM (Application Performance Monitoring), например New Relic или Dynatrace, для профилирования вызовов на уровне кода.
- Kubernetes или другие оркестраторы контейнеров для наблюдаемости базового кластера.
- API-шлюзы, например Kong или Zuul, для аналитики трафика на периферии.
Распределённая трассировка
Потоки запросов
Распределённая трассировка позволяет проследить HTTP-запрос на всём пути через архитектуру микросервисов. Инструменты трассировки, такие как OpenTelemetry, Jaeger и Zipkin, связывают эти вызовы воедино и показывают сквозной путь выполнения, выделяя точные места наибольших задержек.
- Распределённая трассировка даёт глубокую видимость на границах сервисов.
- Она выявляет скрытые узкие места и заметно ускоряет отладку.
- Инженерные команды используют трассировки, чтобы находить источники задержек и повышать надёжность.
Источники задержек
Задержки накапливаются по мере того, как запросы переходят от сервиса к сервису. Обычных логов и метрик инфраструктуры недостаточно для такой детализации по транзакциям. Трассировка сохраняет контекст запроса на протяжении сетевых переходов, поэтому можно точно определить метод или запрос к базе данных, который вызывает замедление.
Выявление скрытых замедлений
Симптомы
Скрытые замедления могут ухудшать пользовательский опыт, даже когда полных отказов нет. Следите за ростом времени отклика, повышением частоты ошибок и увеличением потребления памяти. Используйте идентификаторы корреляции для отслеживания запросов по системам и настройте проактивные оповещения на основе строгих целевых показателей уровня обслуживания (SLO).
Реальные кейсы
Реальные инженерные кейсы показывают, насколько важно проактивно выявлять узкие места. Например, высоконагруженный микросервис на Spring Boot сильно деградировал по производительности. С помощью глубоких инструментов APM и профилирования инженерная команда обнаружила неоптимизированный цикл запросов. Введя специальное выражение для пакетной обработки операций с базой данных, они снизили количество запросов в секунду с 300 до 30, что сразу стабилизировало загрузку ЦП и устранило нагрузку сборки мусора.
Совет: всегда объединяйте метрики, логи и трассировки в единый конвейер наблюдаемости. Такое сочетание даёт целостное представление о состоянии системы в режиме реального времени.
Решения проблем производительности микросервисов
Асинхронное взаимодействие
Преимущества обмена сообщениями
Многие проблемы масштабирования в микросервисной архитектуре решаются за счёт асинхронного взаимодействия. Разделяя запросы через очереди сообщений, сервисы обрабатывают работу в собственном темпе и безопасно справляются со всплесками трафика, не теряя запросы.
| Повышение производительности | Описание |
|---|---|
| Масштабируемость | Асинхронный обмен сообщениями позволяет масштабироваться на больших объёмах за счёт использования очередей, которые буферизуют всплески трафика. |
| Надёжность | Асинхронные брокеры поддерживают повторные попытки доставки и очереди недоставленных сообщений (dead-letter), что гарантирует отсутствие потери сообщений во время простоев. |
| Тестируемость | Тестирование упрощается, так как потребляющим сервисам нужна только имитация очереди (mock) для проверки полезной нагрузки. |
Внедрение
Внедряйте асинхронное взаимодействие с помощью надёжных брокеров сообщений, таких как RabbitMQ, Azure Service Bus или Apache Kafka. Используйте шаблоны публикации и подписки, чтобы аккуратно рассылать доменные события между независимыми сервисами.
Переборки и предохранители
Стратегии изоляции
Защитите свои микросервисы от каскадных сбоев с помощью переборок (bulkheads) и предохранителей (circuit breakers). Переборки разделяют пулы ресурсов так, что сбой одного сервиса не может исчерпать потоки или соединения во всей системе.
Переборки предназначены для изоляции доменов отказа: для разных сервисов создаются отдельные пулы ресурсов или квоты, что не позволяет локальным сбоям вывести из строя всё приложение.
Снижение последствий сбоев
Предохранители отслеживают частоту ошибок и быстро отклоняют запросы к неработоспособным зависимостям, предотвращая каскадные отказы в сети.
Шаблон переборок в микросервисной архитектуре используется для того, чтобы предотвратить распространение сбоев из одной части системы на всю платформу, эффективно изолируя отказы в месте их возникновения.
Кэширование и масштабирование
Выбор хранилища данных
Кэширование является важным инструментом для высокопроизводительных микросервисов. Переносите повторяющиеся обращения к базе данных и дорогостоящие вычисления API в быстрые кэши в оперативной памяти, такие как Redis или Memcached.
| Преимущество | Описание |
|---|---|
| Тонкий контроль | Кэшируйте фрагменты данных с учётом их изменчивости и частоты обновления. |
| Меньше инвалидации кэша | Снижает накладные расходы на очистку, обновляя только затронутые сегменты данных. |
| Более высокий процент попаданий в кэш | Позволяет использовать небольшие, хорошо оптимизированные записи кэша для более высокого процента попаданий в оперативной памяти. |
| Гибридная обработка статических и динамических данных | Позволяет кэшировать статические записи, а статистику в реальном времени получать динамически. |
Независимое масштабирование
Кэширование и разделённые хранилища данных позволяют масштабировать отдельные сервисы независимо друг от друга, устраняя узкие места из-за конкуренции за ресурсы.
- Повышенная масштабируемость системы
- Большая гибкость разработки и более быстрый выход на рынок
- Надёжная изоляция сбоев и устойчивость системы
- Экономически эффективное использование облачных ресурсов
- Лучшая интеграция с DevOps и конвейеры непрерывной доставки
Снижение зависимостей
Разделение
Настоящие микросервисы требуют радикального разделения. Когда сервисы работают независимо, без блокирующих синхронных вызовов, вы устраняете искусственные узкие места.
Разделение означает, что каждый микросервис обрабатывает свою внутреннюю нагрузку, не дожидаясь синхронно внешних процессов. Такая независимость устраняет узкие места и помогает платформе стабильно работать.
Ключевые архитектурные преимущества снижения зависимостей включают:
- Независимое масштабирование сервисов в зависимости от нагрузки в реальном времени.
- Снижение риска каскадных сбоев за пределами границ команд.
- Автономность команд разработки, которые выпускают код по собственному графику.
- Более быстрое выявление первопричины во время реагирования на инциденты.
Упрощение
Упрощение графа зависимостей снижает когнитивную нагрузку и делает архитектуру значительно проще в тестировании, мониторинге и защите.
| Подход | Что это означает | Почему это важно |
|---|---|---|
| Индивидуальные SLO | Отслеживание надёжности каждого микросервиса отдельно | Может не заметить общего ухудшения пользовательского опыта системы |
| Составные SLO | Объединение целевых показателей надёжности для взаимозависимых сервисов | Отражают реальное состояние системы «из конца в конец» |
Оценка пригодности микросервисной архитектуры
Выбор правильной архитектурной модели определяет скорость разработки и операционные расходы. Microsoft Development Podcast часто разбирает это противоречие и отмечает растущую тенденцию: организации объединяют чрезмерно фрагментированные микросервисы обратно в управляемые модульные монолиты.
Матрица решений
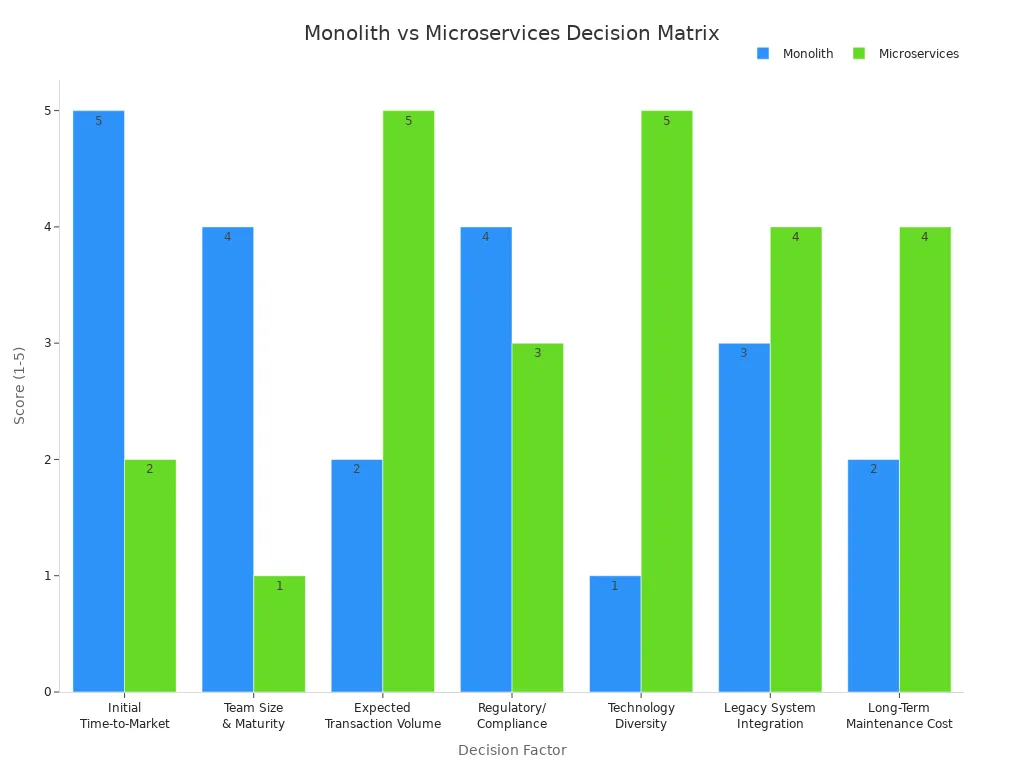
Используйте структурированную матрицу решений, чтобы оценить, действительно ли микросервисы подходят вашей организации с точки зрения её зрелости:
| Фактор решения | Оценка монолита (1–5) | Оценка микросервисов (1–5) | Стратегическое обоснование |
|---|---|---|---|
| Начальное время выхода на рынок (скорость) | 5 | 2 | Монолитам требуется минимальная начальная настройка инфраструктуры. |
| Размер команды и зрелость (DevOps) | 4 | 1 | Микросервисы требуют развитых CI/CD, автоматизации и наблюдаемости. |
| Ожидаемый объём транзакций (масштаб) | 2 | 5 | Микросервисы позволяют точно и независимо масштабировать ресурсоёмкие узкие места. |
| Регуляторная и комплаенс-сложность | 4 | 3 | Единый артефакт упрощает первичный аудит безопасности и проверки соответствия. |
| Разнообразие технологий и экспериментирование | 1 | 5 | Микросервисы позволяют командам использовать специализированные технологические стеки для каждой предметной области сервиса. |
| Интеграция с устаревшими системами | 3 | 4 | Микросервисы хорошо подходят для обёртывания и модернизации устаревших компонентов. |
| Долгосрочная стоимость сопровождения (TCO) | 2 | 4 | Микросервисы снижают стоимость развития функциональности со временем, но увеличивают операционные накладные расходы. |
Ключевые вопросы для оценки
- Есть ли у вашей инженерной команды развитые навыки DevOps, platform engineering и SRE?
- Есть ли у вас экстремальные требования к масштабу, которые оправдывают накладные расходы распределённой системы?
- Нужны ли вам polyglot persistence и разнообразие технологий?
- Готова ли ваша организационная культура нести высокие издержки координации между командами?
Признаки, что пора пересмотреть решение
Следите за этими тревожными сигналами, которые указывают на необходимость реструктуризации вашей архитектуры микросервисов:
- Скорость поставки останавливается из-за постоянных зависимостей между командами.
- Операционные расходы на облако растут быстрее, чем выручка бизнеса.
- Сбои легко каскадно распространяются между несколькими доменами.
Монолит против микросервисов
| Тип архитектуры | Рекомендуемый размер команды | Ключевые характеристики |
|---|---|---|
| Монолитная | < 8–10 разработчиков | Простое развёртывание, низкие операционные накладные расходы |
| Микросервисная | > 10–15 разработчиков | Независимая автономия команд, сложная распределённая координация |
При внедрении микросервисной архитектуры вы столкнётесь со скрытой сложностью и проблемами производительности. Узкие места неизбежно появляются в неожиданных сетевом и data-уровнях. Microsoft Development Podcast подчёркивает, что быстрая поставка требует строгой архитектурной дисциплины. Чтобы ваши системы на .NET оставались здоровыми, помните о следующем:
- Внимательно управляйте межсервисными запросами и политиками таймаутов.
- Внедряйте эластичную балансировку нагрузки и автоматическое масштабирование.
- Разделяйте хранилища данных так, чтобы каждый сервис владел своей базой данных.
- Агрессивно кэшируйте повторяющиеся запросы к API и базе данных.
Также важно обеспечить архитектурное управление, использовать надёжные API-шлюзы и регулярно проводить архитектурные ревью. Постоянная оценка помогает вашему технологическому стеку масштабироваться вместе с бизнесом.
Часто задаваемые вопросы
Что такое распределённый монолит?
Распределённый монолит — это антипаттерн, при котором приложение физически разделено на несколько микросервисов, но логически остаётся связанным через синхронные HTTP-вызовы, общие базы данных и жёсткие зависимости при развёртывании, теряя ключевые преимущества микросервисов.
Как выявлять узкие места производительности в микросервисах?
Отслеживайте p99-время отклика, частоту ошибок и пропускную способность запросов. Используйте инструменты распределённой трассировки, чтобы отслеживать запросы на границах сервисов и находить медленные сетевые переходы или запросы к базе данных.
Почему сетевая задержка важна в микросервисной архитектуре?
Сетевая задержка добавляет миллисекунды к каждому межсервисному вызову. В отличие от мгновенных внутрипроцессных вызовов памяти в монолите, сетевые переходы быстро накапливаются и снижают общую отзывчивость приложения.
Как снизить издержки координации между командами?
Четко определите границы ответственности доменов, автоматизируйте проверки управления API, сократите количество ненужных статусных собраний и переходите к асинхронным схемам коммуникации, чтобы дать командам возможность работать самостоятельно.
Какие инструменты помогают с наблюдаемостью в микросервисах .NET?
Популярные инструменты наблюдаемости включают Prometheus, Grafana, OpenTelemetry, Jaeger, Zipkin и платформы централизованного логирования, такие как стек ELK, которые в совокупности собирают метрики, логи и распределенные трассировки.
Когда стоит рассмотреть консолидацию микросервисов?
Рассмотрите консолидацию, если скорость выпуска функций снижается, расходы на облачную инфраструктуру выходят из-под контроля или каскадные сбои регулярно угрожают доступности вашей системы.
Какой лучший способ работы с общими данными в микросервисах?
Выделите каждому микросервису собственную приватную базу данных. Не используйте общие базы данных между сервисами, чтобы исключить связность на уровне схемы и восстановить независимую масштабируемость баз данных.
Как асинхронное взаимодействие повышает производительность микросервисов?
Асинхронное взаимодействие через брокеры сообщений позволяет сервисам обрабатывать события в своем темпе, буферизуя пики трафика и устраняя блокирующие синхронные узкие места.
🎧 Послушайте этот выпуск
Хотите практичное и подробное объяснение темы Why Microservice Architecture Slows Software Delivery? В этом выпуске ключевые архитектурные вопросы разбираются понятным языком и объясняется, почему они важны для Microsoft 365, Azure, Power Platform, корпоративной безопасности, ИИ и современной разработки ПО.
Послушайте этот выпуск, если вы хотите:
- Понять базовые концепции того, почему микросервисы могут замедлять выпуск ПО
- Увидеть, как архитектура вписывается в более широкую экосистему технологий Microsoft
- Узнать, где она может принести практическую, измеримую пользу вашей корпоративной организации
Вам также могут понравиться эти связанные выпуски M365 FM:
- Миф о монорепозитории: почему ваша архитектура фрагментирована
- Архитектура автоматизации Microsoft Graph: за пределами скриптов
- ИИ-агенты на основе Graph: руководство архитектора по корпоративным решениям
- Расширяемость .NET и чистая архитектура с Miguel Castro [MVP]
- Корпоративная фабрика ИИ-агентов: архитектура за пределами чат-ботов
Откройте для себя больше практичных бесед об инженерии Microsoft на M365 FM.